PostgreSQL 基础
PostgreSQL 基础
Chase Pierce
第一版 · PostgreSQL 18 · 2026-10-05
出版者:Flagon
PostgreSQL 性能几乎都归结为一个数字:8,192。这是页的大小,也是 Postgres 读取、写入和缓存的单位。快速查询只访问少量页;慢查询访问的页很多,或者在等待同样要访问很多页的其他操作。一旦看清这些页的访问情况,大多数疑问都会消失。
你可能已经遇到过这些症状:刚上线时响应迅速、如今却慢吞吞的仪表板;看起来“什么也没做”却仍然让网站停摆的迁移;增长速度始终超过其中数据的表;以及总有人提出换一个更大的实例就能解决一切问题。这本书提供了另一条路。
数一数页,然后用数据证明该换更大的机器了
本书从磁盘上的字节开始向上讲:行是怎样存储和变更的,索引和规划器怎样找到它们,怎样在不中断服务的情况下变更模式,以及怎样在生产环境中运行 Postgres。全书会培养两个习惯。在添加索引、调高参数或责怪 ORM 之前,先问问这项工作会访问多少页。在购买更大的数据库或第二个数据库之前,先用完便宜的修复手段,再用数字证明它们已经不够用。
这也包括知道 Postgres 的边界。在同样的两百万条事件数据上,两个列存储系统只用不到五分之一的字节数保存数据,查询速度约为调优后 Postgres 的十倍。本书会展示一个 Postgres 能走多远,以及什么信号说明该考虑别的系统了。
本书写给每天使用 Postgres 的应用开发者,很多人还会通过 ORM 使用它。你只需要掌握基础 SQL,不需要了解内部机制。
每个重要结论都配有检查
每个查询都在 PostgreSQL 18 上运行,使用的是一分钟内就能加载的示例模式;每个重要结论都附有可以在你自己的机器上重新运行的实验检查。每一章都是一篇可以单独阅读的短文;想深入时,再打开包含内部机制和完整测量结果的深入阅读。
免费,并以开放方式写作
你可以在这里逐章阅读,也可以把整本书下载为 PDF。和我们发布的其他内容一样,本书通过 git 进行版本管理;Postgres 发生变化时,书也会随之变化。如果发现错误或难以理解的地方,那就是一个 bug:提交问题或发送修复。
目录
图
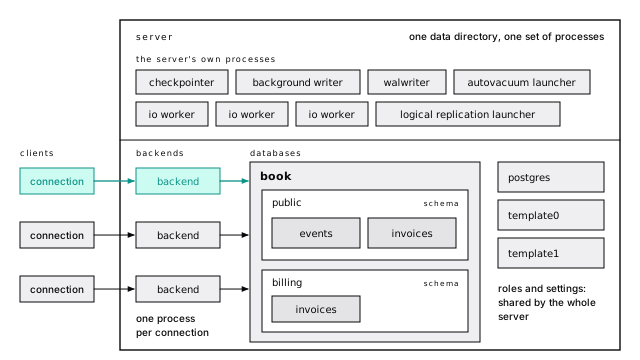
- 图 2-1 — 一台服务器、多个数据库,每个连接对应一个进程。每个连接都有自己的后端进程,在一个数据库中工作;数据库内部由模式容纳表。后端进程之外,服务器还运行自己的进程,角色和设置属于整个服务器。
- 图 3-1 — 一页可能位于三种位置之一。shared_buffers 中的命中是一次内存查找;未命中时,EXPLAIN 称之为“read”,如果内核已经缓存该页,就需要一次系统调用和一次复制;如果没有缓存,就需要访问设备。Postgres 无法区分后面这两种情况。
- 图 4-1 — 行指针从前端开始,元组从后端开始。两者向彼此靠近,碰到一起时页就满了。
- 图 5-1 — 找到一个页只需要一次哈希查找。标签会落入 128 个分别加锁的分区之一。命中后钉住缓冲区即可完成;未命中则必须驱逐一个受害者,必要时先把它写出,再读入目标页。
- 图 5-2 — 指针经过每个缓冲区时都会扣除一个点。它会跳过被钉住的缓冲区,并驱逐找到的第一个计数为零的缓冲区。一个不断读取的页在指针转回来前早已恢复到 5,因此永远不会走到这一步。
- 图 6-1 — 更新就是插入并加上标记。旧版本留在槽位 1,被更新事务的 XID 标记,并带有指向 (0,4) 的 ctid;新版本是槽位 4 中的一份完整副本。现在四个元组承载着三行。
- 图 7-1 — HOT 把新版本留在索引已经能找到的位置。冷更新把新版本放到另一页,并在每个索引中增加一个条目。HOT 更新把新版本写到同一页,通过 t_ctid 从旧版本串起来,不改变索引;页内剪枝后,lp1 会变成指向新版本的重定向。
- 图 8-1 — 提交等待的是日志,而不是数据页。更新先让 shared_buffers 中的页变脏,然后追加一条 WAL 记录。COMMIT 只等待这条记录刷新到连续的 WAL;检查点进程或后台写进程稍后再把页写入数据文件。
- 图 8-2 — 恢复从重做点开始。检查点从其重做点开始,写出脏页,并在完成后记录检查点记录。重做点之前的所有内容都已经在数据文件中,所以崩溃后从那里开始重放。
- 图 8-3 — 每次检查点都会重置镜像状态。检查点后的第一次页变化会携带该页完整的 8 KB 镜像;之后对该页的变化都是小记录。下一次检查点之后,第一次变化又要付出同样的代价。
- 图 11-1 — InnoDB 按键查找行,Postgres 按地址查找行。在 InnoDB 中,表就是主键 B-树,因此二级索引条目保存主键,通过它找到的每一行都要再次沿着这棵树向下查找。在 Postgres 中,每个索引,包括主键索引在内,都直接指向堆中的一个页。
- 图 13-1 — 递增键追加;随机键散落。新的标识列或 UUIDv7 键都落在最右侧叶子上,叶子会留在内存中。UUIDv4 键会落在任意叶子上,满叶子会按 50/50 拆分,页最终大约有 70% 满,而追加写入时是 90%。
- 图 17-1 — 查找每一层读取一个页,然后读取堆。events 的主键有 1 个根页、19 个内部页和 5,465 个叶页,堆共有 35,173 个页,因此查找一行会读取树中的三个页和堆中的一个页。
- 图 21-1 — 找到节点,然后修复估算或工作量。如果估算行数与实际行数相差 10 倍或更多,就修复统计信息或误导统计信息的查询;如果行数正确,就修复索引、查询形状或代价。只有最后才考虑 enable_* 和提示。
- 图 22-1 — OFFSET 从头计数;键集分页从书签开始。OFFSET 1000000 会读取 1,000,020 个索引项和 21,422 个页来显示 20 行。键集查询会跳到上一页结束的位置,在 5 个页中读取接下来的 20 行;每一页都相同。
- 图 25-1 — 第二次写入会悄无声息地获胜。两个事务都读到 100,tx2 等待 tx1 的行锁,然后写入根据那次过时的读取计算出的值。余额最终为 80,tx1 的消费没有报错就丢失了。
- 图 25-2 — 一个等待中的锁会让每个查询停下来。迁移在等待空闲的 reporting 事务,而它之后的每个查询,包括普通读取,也都排在迁移后面等待。reporting 提交后,迁移在一毫秒内运行完,队列随之排空。
- 图 32-1 — 恢复就是基础备份加上重放。恢复基础备份,然后向前重放归档的 WAL,直到 recovery_target_time。重放在 14:02 的错误之前停止,服务器随后以该时点的状态开放访问。
- 图 38-1 — 副本始终重放主库的 WAL。walsender 把 WAL 流传给备库的 walreceiver,startup 进程将其重放到页面中,备库再把自己的 LSN 位置报告给 pg_stat_replication。它接受读取,以 25006 拒绝写入。
- 图 39-1 — 逐行删除一个月是做一番工作;删除一个月分区是移除文件。逐行删除留下了 164,383 个死元组,产生 32 MB WAL,后续清理又产生了 12 MB。分离并删除该月分区会移除它的文件,产生的 WAL 不到 150 KB。
- 图 40-1 — 分片键决定由谁干活。指定 account_id 的查询发往存放该账户的唯一分片,该账户的行集中在那里。没有指定它的查询发往所有分片,再合并结果。
表
- 表 1-1 — 先理解运行机制,再跳到痛点所在
- 表 1-2 — 一套普通的 SaaS 模式贯穿每一章
- 表 2-1 — 几条 psql 命令覆盖本书所需
- 表 3-1 — 内存很便宜,其他一切都很贵
- 表 3-2 — 往返比查询更贵
- 表 4-1 — 一行的成本高于它的列
- 表 5-1 — 你的查询不该负责写出脏页
- 表 5-2 — 大型操作会使用环
- 表 7-1 — 冷更新要为每个索引付费
- 表 7-2 — 索引提到的每一列都算作已索引
- 表 7-3 — 给页留下空间,否则每次更新都会移动
- 表 7-4 — 给页留下空间,否则每次更新都会移动
- 表 7-5 — 长事务会关闭 HOT
- 表 7-6 — 自底向上的索引删除是安全网
- 表 8-1 — wal_compression 花小代价就能见效
- 表 8-2 — 提交意味着刷新
- 表 9-1 — 四项承诺,四种机制
- 表 9-2 — 只有可串行化能排除所有异常
- 表 10-1 — 对大表来说,默认值不对
- 表 10-2 — 回卷会在任何内容损坏前停止写入
- 表 11-1 — 行和旧版本存放在哪里决定了一切
- 表 11-2 — 在 InnoDB 中,二级索引查找要下探两次
- 表 11-3 — 整数除法会截断,NULL 排在最后
- 表 11-4 — 大多数 MySQL 惯用法都有直接的 Postgres 对应物
- 表 12-1 — 整数比你想象中更快耗尽
- 表 12-2 — 选择顺序永不变化的排序规则提供者
- 表 13-1 — 随机键写入的 WAL 几乎是四倍
- 表 13-2 — 随机键写入的 WAL 几乎是四倍
- 表 13-3 — 每种 ID 格式都在顺序和泄露内容之间做权衡
- 表 14-1 — 每个事实只存一处
- 表 14-2 — 每次插入都要为每项检查付费
- 表 14-3 — 历史记录也是你要设计的表
- 表 15-1 — 每种模型各有一种形状,专门为它加速
- 表 15-2 — 实体-属性-值是个陷阱
- 表 15-3 — 闭包表存储每一对祖先关系
- 表 16-1 — Contrib 是最安全的一层,不过其中有些已经过时
- 表 16-2 — 会崩溃的扩展会断开所有连接,因此要审查它
- 表 17-1 — 每个索引都在向写入收税
- 表 18-1 — B-树之外
- 表 18-2 — 对包含查询,jsonb_path_ops 胜过默认类
- 表 18-3 — GIN 过滤三字符组;GiST 按相似度排序
- 表 18-4 — 大小只有千分之一,页数却几乎相同
- 表 18-5 — 操作符决定索引类型
- 表 20-1 — 每个代价都相对于一次顺序页读取
- 表 20-2 — 扩展统计信息联合测量多列
- 表 21-1 — 5% 规则在两个方向上都不对
- 表 21-2 — 连接顺序是一场搜索,而且搜索会变得昂贵
- 表 22-1 — OFFSET 会读取它跳过的每一行
- 表 23-1 — 存储 tsvector;不要索引表达式
- 表 23-2 — 搜索扩展把 BM25 放进索引
- 表 23-3 — ef_search 用延迟换召回率
- 表 24-1 — 主库是你最昂贵的 CPU
- 表 24-2 — 行触发器每行大约花费一微秒
- 表 25-1 — 行锁存在行中,而不在 pg_locks 中
- 表 26-1 — 选择与表流量匹配的索引构建方式
- 表 26-2 — 选择与表流量匹配的索引构建方式
- 表 26-3 — 单独运行并发构建,不设超时,并检查索引是否有效
- 表 26-4 — 扩宽类型没有代价;大多数其他类型变更都会重写
- 表 28-1 — 事务池模式会破坏会话状态
- 表 29-1 — 只问一个问题
- 表 30-1 — 上下文决定重载还是重启
- 表 30-2 — 自动清理的默认值适合小表和慢磁盘
- 表 30-3 — 低开销日志能回答大多数凌晨 3 点的问题
- 表 32-1 — 先写下 RPO 和 RTO
- 表 32-2 — pg_dump 不包含角色;单独转储它们
- 表 32-3 — pg_upgrade --link 快速且只能单向进行
- 表 33-1 — 应用永远不拥有自己的数据表
- 表 34-1 — 无论谁运行这台机器,有些工作仍然是你的
- 表 34-2 — 无论谁运行这台机器,有些工作仍然是你的
- 表 34-3 — 服务商会在 CREATE EXTENSION 上再加一道门
- 表 34-4 — I/O 被节流时,会表现为 IOPS 持平而延迟上升
- 表 34-5 — 故障切换依赖 DNS,你的连接池必须注意到
- 表 35-1 — 了解架构形态,就了解了取舍
- 表 35-2 — 超级用户权限和保留期限可以排除一批服务
- 表 36-1 — 10. 只有相应信号出现时,才横向扩展
- 表 36-2 — 按操作指南的顺序,做八次改动
- 表 36-3 — 按操作指南的顺序,做八次改动
- 表 37-1 — 买任何东西之前,先测量
- 表 37-2 — 预先算好要展示的内容
- 表 38-1 — 同步提交要付出一次往返
- 表 38-2 — 故障切换用流复制,具体任务用逻辑复制
- 表 39-1 — 范围分区适合时间,列表和哈希各有专用场景
- 表 39-2 — 处理过期数据:先分离,再删除
- 表 39-3 — 每个无法剪枝的分区都要花规划时间
- 表 39-4 — 每个无法剪枝的分区都要花规划时间
- 表 40-1 — 每种方案都把难题移到别处
- 表 40-2 — 每种方案都把难题移到别处
- 表 41-1 — 列式存储只占十分之一的字节数
- 表 41-2 — 每条查询,PostgreSQL 都读取了所有页
- 表 41-3 — 列式存储快约十倍,单核上仍然更快
- 表 41-4 — 列式存储快约十倍,单核上仍然更快
- 表 41-5 — 汇总表和列式扩展能大幅缩小差距
- 表 41-6 — 用到之前,先认清信号
部分
关于本版
© 2026 Flagon, Inc. All rights reserved. 本简体中文网页译本译自第一版 Eight Kilobytes: PostgreSQL from the page up,原版出版于 2026-10-05,示例运行在 PostgreSQL 18 上。原书正文和图形可在 Flagon 在线阅读。本书许可证允许在线阅读,并将再发布权保留给 Flagon, Inc.;本项目明确记录所依据的来源和版本。
实验套件及其采用 MIT 许可证的源文件仍可从原始的 Eight Kilobytes lab 获取。
1 开始之前
下面是针对同一张表、在同一台服务器上、相隔几秒执行的两个查询:
第一个只访问了 4 个页,第二个却访问了 35,173 个页。
两个查询几乎都不返回数据,看起来也都很简单,ORM 生成它们中的任何一个都不会有意见。一个让数据库只用 3% CPU 空闲运行,另一个却会让某人在凌晨 2 点被叫起来处理告警。
这就是本书存在的原因。
数一数页面
大多数 PostgreSQL 建议都来自经验之谈。加一个索引。调高 shared_buffers。运行清理。每条建议都有一部分时间是对的;但如果你没有服务器的模型,就无法判断现在是否正好属于那部分时间。
这个模型比你想象的更小。Postgres 把所有东西(表、索引以及它们旁边的簿记信息)都存放在 8 KB 的页中,并以整页为单位读取、写入和缓存。慢查询几乎总是在做两件事之一:访问了远超需要的页,或者进行了远超需要的往返。
因此,本书要培养的第一个习惯只有一句话:数一数页面。
- 设计表时,问问一页能容纳多少行。
- 添加索引时,问问一次查找前后分别会访问多少个页。
- 阅读执行计划时,先看
Buffers:行。它统计的是页数。 - 当表增长速度超过数据本身时,问问那些页里到底放着什么不属于你的东西。
你不需要整天思考字节数。你需要对 8 KB 能装下什么有一个直觉,因为 Postgres 几乎所有性能特征都由此而来。书名也因此得名。
先用数据证明,该换更大的机器了
第二个习惯与钱有关。数据库变慢时,最容易买的是一台更大的机器,而且一开始确实有效。然后数据追上来,你每个月花更多钱,却还是同一个问题。
索引每个月不花钱。重写查询只需要一个下午。连接池代理、清理设置,或者更小的行,只需要读一点材料。所以,本书有一个比其他观点都更坚持的看法:先用完便宜的修复手段,再购买硬件;真的要升级时,用数字证明确实需要升级(先用数据证明,该换更大的机器了)。每一章归根结底都是一个便宜的修复手段,以及证明它有效的证据。
先从一个数据库开始,凭证据离开
不断成长的产品会收集各种数据库:缓存、文档存储、队列、搜索引擎、向量存储。每一种都带来自己的备份、升级、故障模式和告警值班,而且它的数据还必须与其他所有系统保持同步。
Postgres 可以在一台服务器上,与其余数据一起处在同一个事务中,覆盖其中大多数需求。文档放进 jsonb。队列就是一张表,再配合 for update skip locked。全文检索和向量数据与它们所描述的行放在一起。时间序列适合 BRIN 和按月分区,地图则交给 PostGIS。这是一种能满足大多数需求的方案,而“大多数”能覆盖的范围比你猜的更远(你还不需要另一个数据库)。
大多数不等于全部,本书也会说明边界在哪里。在同样的两百万条事件数据上,两个列存储系统只用不到五分之一的字节数保存数据,查询速度约为调优后 Postgres 的十倍;即使只用一个核心,仍然至少快两倍。大规模搜索相关性、流、全局写入以及超大型向量集,都有各自的边界(Postgres 不擅长什么)。
所以,我们让每个产品都从一个 Postgres 开始;只有当我们能说清某项特性,并用数字证明确实需要它时,才添加第二个系统,同时仍然让 Postgres 作为权威数据源。这又回到了更大的机器:应用到架构上,就是从扎实的基础开始,凭证据离开。
每个结论都配有验证
你不该只因为一本数据库书这么说(包括这一本)就接受任何结论。因此,这里每个重要结论都附有证据。
这里的每个查询都在一台真实的 PostgreSQL 18 服务器上运行,使用的是一分钟内就能加载的示例模式。执行计划是真实的执行计划,大小是真实的大小;当某一章说索引有帮助时,还会展示添加索引前后读取的页数。重要结论旁边会放置动手验证框。每个框都包含该章实验脚本中的精确检查,也就是一个声明不成立就会大声失败的 lab.prove(...),这样你可以重新运行证据,而不是相信我们。
这也是本书保持诚实的方式。Postgres 发生变化时,检查会失败,章节就会被修正。
你会 SQL;这里讲的是它的底层机制
你每天都在写应用代码、使用 Postgres,可能通过 ORM,也可能手写 SQL。你知道 select、join、group by、insert 和 update。也许最近因为总得有人负责,你成了“数据库那个人”。
你缺少的是底层机制的模型:为什么一次 update 会让表变大,为什么上个月还很快的查询现在变慢了,为什么规划器不使用你刚建的索引。没有这个模型,调优就只能靠猜。每个内部概念都会在第一次出现时解释。不需要懂 C、不需要读源代码,也不需要有生产经验。
以两种深度阅读
每一章其实是两本书合在一起。简明路线是一篇短文:它的论点、证明论点的一条证据,以及你该怎么做。每章只读这一部分,你就能获得整本书的内容。深入阅读包含内部机制、完整测量结果和边界情况,每一段都紧跟在它所展开的段落之后。
在网站上,章节顶部的简明 / 深入阅读开关会为整本书设置阅读深度;在简明模式下,每个深入阅读块会折叠成一行,你可以单独打开。在纸质版上,每个深入阅读都会打印出来,并单独排版,方便跳过;每个动手验证框也会打印出它所验证的结论,以及保存检查的实验文件。
我为什么写这本书
我是 Chase Pierce。我创办了 Flagon,希望公开地构建软件,也公开地经营一家公司。
我没有什么关于自己如何走到今天的传奇故事。我因为一些朴素的理由选择了 Postgres,然后一直坚持选择它。相较于 MySQL,是因为它能做更多事情:支持事务性的模式变更,拥有更丰富的类型,以及能让数据库成长为你所需形态的扩展系统。相较于 Oracle 和 SQL Server,是因为它开源、可以在任何地方运行,而且没有按核心数量计费的许可证。这些理由在之后的每个项目中都经受住了考验。
真正经不起考验的是围绕它的建议。我想要的那本书并不存在于一个地方。内部机制类书籍默认你想参与服务器本身的开发。调优指南把设置交给你,却不给出解释这些设置的模型。博客文章只对某个人的负载、某个人的版本、某一年成立。我想把模型、证据和观点放在一起,写给那个刚刚接手数据库的人。所以我写了这本书,并让每个结论都带有一个检查,因为无法重新运行的结论,只是又一条经验之谈。
本书其余部分会说“我们”。这是 Flagon 的声音,也是在同一个终端前看着同一份执行计划的你和我。我们持有什么观点,就直说,并展示背后的数字。如果你发现错误,那就是一个 bug:提交问题或发送修复。
先理解运行机制,再跳到痛点所在
| 部分 | 内容 |
|---|---|
| 理解运行机制 | 延迟、页、缓冲区缓存、MVCC、HOT 更新、预写式日志、ACID、清理,以及这些内容与 MySQL 的差异 |
| 数据库设计 | 类型、键、约束、数据模型、扩展 |
| 高效查找数据 | 索引、EXPLAIN、规划器、查询模式、搜索、函数 |
| 变更数据库 | 锁、保持网站运行的迁移、大批量加载 |
| 生产运维 | 连接、基准测试、配置、监控、备份、安全、托管服务,以及处理慢数据库的行动手册 |
| 横向扩展 | 先纵向扩容、复制、分区、分片,以及 Postgres 的短板 |
首先是入门篇先认识这些基本概念:快速认识 SQL 和服务器词汇,包括表、查询、更新、连接、索引、数据库、模式、角色和目录。如果 search_path 和 pg_class 对你来说已经是老朋友,可以跳过这一章。运行机制是基础。如果其他内容都不读,至少读一切都从页说起和更新就是插入;后面几乎每一章都会依赖它们。然后跳到你正在遭遇的问题。慢查询正在毁掉你的一周?从读执行计划,别只看耗时开始。你从 MySQL 转来?Postgres 不是 MySQL会指出哪些习惯不能直接迁移。
每章最后都有“本章要点”和“延伸阅读”。
每个示例都运行在 PostgreSQL 18 上
本书以PostgreSQL 18为目标。几乎所有示例都运行在 18.6 上;少数需要第三方镜像的章节会固定另一个小版本,并明确说明(最后再考虑分片中的 Citus 使用 18.4,Postgres 不擅长什么中的 pg_duckdb 使用 18.1)。其中大多数内容适用于从 13 开始的任何版本;较新的特性会标注引入它的版本,例如 MERGE(PostgreSQL 15+)。页面布局、MVCC、清理、规划器和预写式日志在细节上发生过变化,但形态没有改变。
psql 和 EXPLAIN 的输出紧跟在生成它的查询后面,单独放在代码块中;长输出会用 ... 截短。其中有些内容在你的机器上会不同,这是正常的:
- 事务 ID、OID 和文件名由服务器在运行时分配。你的值会不同,但它们之间的关系不会变。
- 耗时取决于硬件和负载。我们的实验在笔记本电脑上的 Docker 中运行,旁边还有其他负载;有几个写入量很大的实验会打开
synchronous_commit = off以更快完成(实验会明确说明),所以把每一毫秒都视为粗略值。 - 缓冲区数量和行数是证据。 对于给定的数据集和执行计划,它们每次都会相同。完整查询的计数可能会比表本身多访问几十个页,因为还要读取目录和其他小对象:对包含 35,173 个页的
events堆做一次全表扫描,报告的数量约为 35,249。 - 大小是
pg_size_pretty按二进制口径报告的数值:288,137,216 字节的events堆是 275 MB,而不是 288。
提示框会标出你绝对不能错过的内容。每一条警告都描述了一种可能让生产数据库瘫痪的方式。
运行你自己的 PostgreSQL 18
你需要 Docker 和 bash:Linux 或 macOS 终端都可以,Windows 上则可以使用 Git Bash 或 WSL。实验套件是一个小型 Compose 项目:里面有带示例数据的 PostgreSQL 18,以及每章一个将章节结论转为检查的脚本。下载后运行某一章:
章节编号或名称都可以使用(./lab 3、./lab storage),单独运行 ./lab 则会列出全部章节。第一次运行会启动服务器并创建示例数据库,大约需要一分钟。每次运行都会获得一份全新的数据副本,所有成立的结论都会打印 PROVED:,遇到第一个不成立的结论就会停止。实验页面会解释其余内容;运行 ./lab all 会执行所有章节,并列出失败的章节。
如果你更喜欢图形化客户端,服务器只监听本机的 127.0.0.1:5418。有几章(复制、分片、MySQL 对比)需要多台服务器;对于这些章节,./lab 会启动额外容器,并在结束后将其移除。
套件中的 postgres 用户是超级用户。这一点很重要:本书最有用的一些工具(尤其是读取页原始字节的 pageinspect)默认只有超级用户才能使用,而托管服务通常不会给你超级用户权限。完成后,docker compose down -v 会把所有内容彻底删除。
一套普通的 SaaS 模式贯穿每一章
每章都使用同一套小型 SaaS 模式:账户、账户中的用户、它们拥有的项目,以及一张不断增长的大型事件表(部署、构建、评论、告警、登录)。它足够普通,也足够大,能让规划器做出真实决策,让错误变成可以测量的代价:
| 表 | 行数 | 堆大小 | 值得了解的列 |
|---|---|---|---|
| accounts | 1,000 | 72 KB | plan |
| users | 100,000 | 9 MB | account_id、email(组合唯一) |
| projects | 20,000 | 1.5 MB | account_id、owner_id、archived_at |
| events | 2,000,000 | 275 MB | account_id、project_id、user_id、kind、payload(jsonb)、created_at |
每张表都有一个 bigint 类型的 identity id,以及一个 created_at。数据使用固定的随机种子生成,时间从一个固定时刻,即 2026 年 10 月 6 日,向前回溯,因此你的执行计划、计数和日期都会与我们的相同。
有两点是故意这样设计的,所以暂时不要“修复”它们:
events没有任何二级索引,只有主键。索引相关章节会逐一添加索引,让你准确看到每个索引带来了什么。- 只有一个外键列有索引,而且只是碰巧。
users.account_id是unique (account_id, email)约束所建索引的前导列;其他引用列都没有索引。Postgres 不会替你为引用列建立索引,而这正是现实模式中最常见的错误之一。有目的地选择约束会展示它的代价。
套件中的 seed.sql 包含完整种子:五个扩展、四张表,以及每张表一条 insert。有意思的部分是生成器。下面是 events 以及填充它的语句:
setseed 会让 random() 每次返回同一序列,因此相同的项目会得到相同的事件。created_at 均匀分布在 2026 年 10 月 6 日之前的一年中,而 order by 按时间顺序插入行,所以最近的事件会集中在表的末尾(延迟和索引章节会用到这一事实)。数组中重复出现的值会造成分布倾斜:部署和构建很常见,评论、告警和登录各占八分之一,四分之一的状态为 failed。最后的 vacuum analyze 会让每个页都标记为全可见,并让规划器的统计信息保持最新。
套件会把它加载到名为 book 的数据库中(约 345 MB),并将其标记为模板。复制模板比重新运行种子便宜得多,所以请在副本中探索:
许多章节会更新每一行、删除半张表,或者添加并删除索引。永远不要直接操作 book(套件甚至不允许连接到它)。当你把 scratch 搞乱后,执行 drop database scratch,再重新复制一份。
在这里搞坏东西,别在生产环境里搞
有些示例是故意具有破坏性的:它们会更新数百万行、长时间保持事务打开,或者删除半张表来观察清理工作。请在可丢弃的服务器上运行它们,永远不要在任何人依赖的数据库上运行。对于面向生产环境的技术(迁移模式、监控查询、设置),正文会说明这一点,以及它会加什么锁、付出什么代价。
在简要认识这些术语之后,第一站是硬件,因为一个页在你请求它时所处的位置不同,访问它所需的时间也可能有天壤之别。
本章要点
- 几乎每个 Postgres 性能问题都可以归结为访问了多少页、进行了多少次往返。数一数页面。
- 先用完便宜的修复手段,再购买硬件;真的要升级时,用数字证明需要升级。先用数据证明,该换更大的机器了。
- 从一个 Postgres 开始。只有当你能说出某项特性,并用数字证明确实需要它时,才添加第二个系统。
- 先看执行计划的
Buffers:行,再看耗时。缓冲区数量和行数可以复现,毫秒数不行。 - 每个重要结论都有一个动手验证检查。重新运行它,不要只相信我们。
- 只读简明路线来理解论点;想看内部机制或完整测量结果时,再打开深入阅读。
- 获取实验套件,在名为
book的模板中运行带有示例数据、可随时丢弃的 PostgreSQL 18。 - 在套件目录中运行
./lab <chapter>,重新执行任意章节的证据;动手验证框会展示具体检查。 - 在副本中工作(
create database scratch template book),弄乱后将其删除。
延伸阅读
- PostgreSQL 18 documentation,PGDG。整本书都依赖的参考资料;先学会在里面找到所需内容。
- PostgreSQL 18 release notes,PGDG。本书所有“(PostgreSQL 18+)”标签的来源。
- Versioning policy,PGDG。五年的支持窗口,以及你的大版本还剩多长时间支持。
- psql reference,PGDG。每个示例背后的客户端;花一个小时读它的反斜杠命令很值得。
- Set returning functions,PGDG。了解
generate_series如何生成种子,也了解如何生成自己的测试数据。
2 先认识这些基本概念
本书会讨论页、执行计划和锁。这些讨论假设你了解一些 SQL 和少数几个 Postgres 术语。如果你曾经对 Postgres 写过 select、insert 和 update,也知道什么是模式,可以扫一眼下面的标题,然后继续往后读;你不会漏掉什么。如果你还不了解,这一章就是你的速成课:后面每一章都至少需要这些知识。
先提醒你接下来会遇到什么:本书其余部分都会假设你掌握这里的内容,并且很快深入到磁盘上的字节,因为“为什么这么慢?”的答案就在那里。本章的每个结论都在实验服务器上运行验证,和本书其他章节一样,所以连基础知识也有证据。
表由共享相同列的行组成
Postgres 把你的数据放在表中。表有命名且带类型的列,每一行为每一列保存一个值,也可以保存 NULL,它表示“没有值”(不是零,也不是空字符串)。下面是本书最大的表 events:
逐行读一遍,你就认识了模式定义中的大多数内容。bigint 是大整数,text 是长度不限的字符串,jsonb 是 JSON 文档,timestamptz 是一个时间点。not null 禁止 NULL,default 则在你没有提供值时填入默认值。id 是主键:没有其他行与它共享的值,Postgres 会替你为它编号,因此可以通过它找到任意一行。每一条 references 定义都是一个外键:account_id 必须指向 accounts 中已经存在的一行。
events 保存两百万行,每一行都有同样的七列。表是形状,行是数据。
01-basicsSELECT 用来提问,而且什么也不改变
用 select 读取数据。写出你需要的列,写明它们来自 from 后面的表,再用只保留目标行的 where 子句;order by 会排序,limit 会提前停止:
再掌握两个词,就能覆盖大多数报表。count(*) 统计行数,group by 按值分别统计:
select 从不改变任何东西。它甚至不会取得事务 ID(XID),也就是 Postgres 为每次变更分配的编号。但这不代表它没有代价。整本书都在讨论:一个 select 为了回答你的问题,必须读取多少页。
01-basicsINSERT 添加一行,在 Postgres 中 UPDATE 也是如此
有三条语句会改变数据。insert 添加行,update 修改行,delete 删除行。下面是在 notes 上执行的例子;这是一张带有 id 和 body 的试验表:
总要为 update 和 delete 写上 where。没有它们,这两条语句会作用于表中的每一行,而 Postgres 不会问你是不是写错了。
这就是让 Postgres 成为 Postgres 的第一个事实。update 不会修改它所在位置的那一行。它会写出一份完整的新行副本;如果页中有空间,新副本就放在同一个页上,并把旧副本标记为已替换。delete 会把行标记为已死亡,但仍然留在原处。两个旧副本都会留在页上,直到后台清理将它们清除。在一张只有一行的表上,一次 update 会让页上留下两份副本;执行 delete 后,表中已经没有这行了,页上却仍然有两份。
这一个事实解释了表为什么会变大、清理为什么存在,以及繁忙的表为什么可能达到数据大小的两倍。本书把它称为更新就是插入,几乎每一章都会回到它。
01-basicsJOIN 把表重新拼在一起
好的模式会让每项事实只存一次:用户的电子邮件地址放在 users 中,账户的计划放在 accounts 中。连接通过匹配不同表中的行,把它们重新组合起来,而且几乎总是通过外键完成:
u 和 a 是表的短名称,on 说明哪些行相匹配:这里指的是 id 等于用户 account_id 的那个账户。用户 295 属于账户 296。普通的 join 只保留两侧都匹配的行;left join 保留左侧的每一行,对于没有匹配项的行则填入 NULL。
01-basics索引让一次读取变便宜,让每次写入更贵
按电子邮件地址查找一个用户时,如果没有额外帮助,Postgres 必须读取整张 users 表才能找到它:为了找一行,要读取 1,126 个页。(unique (account_id, email) 约束有一个索引,但它先按账户排序,因此通过它查找电子邮件就意味着每个账户都要搜索一次,规划器最终还是直接读取了表。)索引是一种独立的有序结构,指向各行,就像书末的索引。为 email 建一个索引,同样的查找就只读取 4 个页:
索引不是免费的。每次 insert,以及每次修改了索引列的 update,都必须同时更新每个索引。因此,只为查询实际会搜索的列建索引,不要为你拥有的每一列都建索引。B-树挑起大梁会展示索引如何只用几个页找到一行。
01-basics掌握这些 SQL 就足以读懂本书了。本章其余部分讲的是支撑这些 SQL 的服务器。
一台服务器运行多个数据库,而它们不共享表
Postgres 服务器由一个数据目录和运行其中的进程组成。文档把它称为一个集簇,这和多台机器没有关系;它就是一台服务器。一个服务器中可以有很多数据库。实验服务器有四个:
一次连接只选择一个数据库,也只能看到那个数据库。试图读取另一个数据库时,Postgres 会拒绝:
这是设计决定,而不是缺少功能:每个数据库都有自己的表、自己的目录和自己的扩展。角色、表空间和服务器配置文件是例外,它们由整个服务器共享。如果应用的两个部分需要连接各自的数据,它们就应该位于同一个数据库的两个模式中。
除非你指定其他模板,否则 create database 会复制 template1;template0 是一份未经修改的备用模板。实验套件也把 book 标记为模板,所以 create database scratch template book 比再次加载数据便宜得多。
01-basics每个连接都是一个独立进程
应用连接时,服务器会启动一个新的操作系统进程来为它提供服务,这个后端进程会一直存在到连接关闭。十个连接就是十个进程,每个进程都有自己的内存。这个事实解释了连接为什么昂贵、max_connections 为什么是上限而不是容量,也解释了为什么每个生产应用最后都要放在连接池代理之后(连接并非免费)。
服务器自己也会运行进程。在实验服务器上,除了一个客户端进程外,还有:
本书的大部分内容都在讲这些进程做什么:WAL 写入器在后台刷新预写式日志;检查点进程和后台写入器把变更后的页写回各自的文件;自动清理启动器启动清理工作进程;而 I/O 工作进程(PostgreSQL 18+)则代表后端进程执行读取。
01-basics模式是文件夹,search_path 选择你想要的那个
在数据库内部,表位于模式中:模式是命名的文件夹,只有一层。每个新数据库都有一个名为 public 的模式;如果你从未创建过其他模式,那么你拥有的一切都在这里。public.invoices 和 billing.invoices 是两张不同的表。
当你写下不带模式名的 invoices 时,Postgres 会按顺序检查 search_path 中列出的模式,并使用第一个匹配项。把 billing 放在首位,同一个查询就会读取另一张表。这对组织大型模式很方便。它也可能让某个函数最终调用你没有编写的对象,所以安全章节会要求每个以提升权限运行的函数都固定 search_path。
01-basics角色既是用户,也是组,或者两者皆是
Postgres 只有一种身份主体,就是角色。带有 LOGIN 属性的角色就是通常所说的用户;没有该属性的角色就是组;任何角色都可以成为另一个角色的成员,并继承它的权限。每张表都有一个所有者角色,它可以对表做任何事情;其他角色只能使用授予自己的权限。
现在就养成一个习惯:应用应当以一个不拥有任何对象、也不是超级用户的角色进行连接,这样应用中的 bug 就不能删除一张表。不要信任任何租户会展示这种设置。
01-basics每条语句都在事务中运行
Postgres 从不在事务之外运行语句。单独发送一条 update 时,Postgres 会把它包装在一个事务中,并在语句结束时提交;这就是自动提交,除非你执行 begin,否则驱动程序就会这样做。以这种方式发送两条语句,就会得到两个事务,并分别为自己的提交付出代价。
在 begin 和 commit 之间,所有内容要么一起生效,要么一起不生效;在 Postgres 中,“所有内容”还包括模式变更。回滚的 create table 会消失,因此在一个事务中运行、最终失败的迁移不会留下半完成状态(如实看待 ACID)。这也意味着,长事务会一直持有它接触过的所有东西,包括锁,直到事务结束。在本书中,你会一次又一次遇到这种打开的事务。
01-basics服务器在表中描述自己
Postgres 了解的关于你的模式的一切,都存在于可以查询的普通表中,这些表就是系统目录。pg_class 列出每张表和每个索引,pg_attribute 列出它们的列,pg_roles 列出角色,pg_settings 列出每个设置。pg_stat_ 视图会统计服务器一直在做什么。psql 的反斜杠命令(例如 \d events)其实就是对这些表发起查询。
目录已经替你统计了页数:
这是规划器眼中的 events:35,173 个页和约两百万行,由 vacuum 和 analyze 更新。这个页数正是整本书不断回到的那个数字。
01-basics一个设置有值、来源和作用域
Postgres 有几百个设置,例如 work_mem,它是一次排序可以使用的内存(默认 4 MB)。每个设置都有一个值、一个来源和一个作用域。配置文件设置服务器默认值。alter database 和 alter role 可以针对某个数据库或某个角色覆盖它。set 修改当前会话的值,set local 则只在一个事务中修改,事务结束后便恢复原值。
你最常用的是最窄的作用域。某个报表需要更多内存来完成一次大型排序时,应当在自己的事务中执行 set local work_mem,而不是为服务器上的每个连接调高它。show work_mem 读取当前值,pg_settings 则告诉你这个值来自哪里(真正重要的配置)。
01-basics一条命令就能添加扩展
扩展通过 create extension 为一个数据库添加类型、函数、运算符或索引方法。有些扩展随 Postgres 一起提供(即“contrib”模块);另一些则需要先安装到服务器上。实验数据库有本书依赖的五个扩展:pg_stat_statements 用于为查询排名,pageinspect 用于读取页的原始内容,pgstattuple 和 pg_buffercache 用于测量表和缓存,pg_trgm 用于文本搜索。
托管服务只允许使用固定列表,所以在围绕某个扩展设计之前,先检查这个列表(值得了解的扩展)。
01-basics你的数据是你永远不会碰的文件
归根结底,服务器数据目录中的每张表和每个索引都是一个文件,文件名使用数字,而不是你的表名:
288,137,216 字节就是 35,173 个、每个 8,192 字节的页,和目录给出的数量相同。Postgres 一次读写一个页,本书的其余内容也从这里开始。一切都从页说起会把其中一个页打开给你看。
永远不要手动编辑、复制或删除数据目录中的任何内容,尤其是 pg_wal。只有服务器理解这些文件,而从正在运行的服务器中直接复制出来的内容并不是备份。
01-basics几条 psql 命令覆盖本书所需
本书的每个示例都在 psql 中运行,它是随 Postgres 提供的命令行客户端。图形化客户端当然也没问题,但有几条反斜杠命令值得背下来:
| 命令 | 作用 |
|---|---|
\d name | 描述一张表:列、索引、约束 |
\dt、\di、\dn、\du | 列出表、索引、模式、角色 |
\x | 以纵向形式打印宽行,每列一行 |
\timing | 打印每条语句的耗时 |
\e | 在编辑器中打开上一条查询 |
想看其余命令,加上 \?。反斜杠命令显示出有用信息时,执行 \set ECHO_HIDDEN on 会打印它背后的目录查询,这是学习系统目录最快的方法。
本章要点
- 表由共享类型化列的行组成。主键可以找到一行;外键指向另一张表中的一行。
select只读取,不改变任何东西。在 Postgres 中,update会写出一份新的行副本,而delete会把旧行留在原处,直到清理将其清除。- 一个索引把一次查找从 1,126 个页降到了 4 个页,而每次写入都要付出让它保持最新的代价。
- 一台服务器容纳多个不能互相查询的数据库;在一个数据库内部,模式是文件夹,
search_path在其中选择目标。角色由整个服务器共享,应用应当以一个不拥有任何对象的角色连接。 - 每个连接都是一个拥有独立内存的进程,这就是连接成本高的原因。
- 每条语句都运行在事务中。模式变更也会回滚,打开的事务会持有它接触过的内容。
- 系统目录是可查询的表,设置有作用域(使用最窄的那个),表则是由 8 KB 页组成、不能手动碰触的文件。
延伸阅读
- The SQL Language,PostgreSQL 文档。手册自带的教程:表、查询、连接和更新,每项都用一页简短介绍。
- Architectural Fundamentals,PostgreSQL 文档。教程中用两页介绍进程模型。
- Schemas,PostgreSQL 文档。模式、
search_path以及手册建议的使用方式。 - Database Roles,PostgreSQL 文档。角色、属性和成员关系。
- System Catalogs,PostgreSQL 文档。每张目录表的每一列,供
\d不够用时查阅。 - psql,PostgreSQL 文档。每条反斜杠命令和每个变量。
3 时间都花在哪里
生产环境中,一个列出团队项目的端点需要 180 ms。你从日志中复制查询,在 psql 里运行,结果 0.4 ms 就完成了。再来一次:0.3 ms。数据库显然没问题。
然后你开始计数。这个端点并不只运行一个查询。它运行一个查询来获取 100 个项目,为每个项目运行一个查询来获取所有者,再为每个项目运行一个查询来获取最近的部署。总共是 201 个查询,每个查询在服务器上都很快,但每个查询都要经过网络再回来。每次往返只需半毫秒,网络本身却会在数据库开始工作之前就花掉 100 ms。
这个故事中没有什么东西真的慢。只是数错了。大致知道每种操作的成本,你就可以在测量之前估算一个查询、一种访问模式或代码中的一个循环。
内存很便宜,其他一切都很贵
在知道各个部分的成本之前,你无法估算一个查询。下面是数据库的延迟阶梯。标为“实测”的行来自我们笔记本上的实验套件;其余数值只是数量级,不是保证。
| 操作 | 典型延迟 |
|---|---|
| CPU L1 缓存引用 | 约 1 ns |
| 主内存(RAM)引用 | 约 100 ns |
| 从操作系统页缓存读取一个 8 KB 页 | 4 到 5 µs(实测) |
| 从本地 NVMe 随机读取 | 几十 µs |
| 一个可用区内的往返 | 100 到 500 µs |
| 从网络块存储随机读取 | 低于 0.5 ms 到数 ms |
| 跨可用区往返 | 约 0.5 到 2 ms |
| 我们笔记本 SSD 上的持久写入(fsync) | 空闲时 0.65 ms,繁忙时 18 ms(实测) |
| 跨区域往返 | 30 到 150 ms |
三个教训几乎支配着每个数据库决策。内存很便宜,其他一切都很贵,所以面对任何查询时,第一个问题都应该是它访问了多少个页,以及这些页在哪里。网络并非免费,即使距离很近也一样:同一可用区内的一次往返,成本大约和读取一次网络磁盘相当。还有,持久性是每次写入中最慢的部分,这就是预写式日志存在的原因。
CPU、内存、SSD 和网络这些行遵循 Numbers Every Programmer Should Know By Year 中的经典阶梯(1 ns L1、100 ns RAM、16 µs SSD 随机读取、500 µs 数据中心往返、加利福尼亚到荷兰再返回 150 ms)。网络存储这一行来自 AWS 自己的卷类型文档:io2 Block Express 卷每次 I/O 平均低于 500 µs,通用型 gp3 卷承诺“个位数毫秒”的延迟。跨可用区往返取决于服务商和可用区;AWS 只说它的可用区彼此相距不超过 100 km,所以请测量你自己的环境。单块磁盘的延迟也会随负载大幅波动:我们笔记本的 fsync 空闲时测得 0.65 ms,而其他容器猛烈读写同一块磁盘时测得 18 ms。
查询就是页和往返
一个足够应付大多数决策的粗略模型:
对于典型的应用查询,CPU 项很小,前两项占主导。要观察页这一项,拿序言中的两个查询,让 Postgres 报告它做了什么:
这就是查询的执行计划,本书里你会读到数百份执行计划。先掌握四条规则,就足以读懂它们,直到读执行计划,别只看耗时讲完其余内容。每一行都是一个步骤,即一个节点;缩进最深的节点先运行,然后把结果提供给上方节点。actual rows 是某个节点每轮产生的行数。Buffers: 统计它访问的 8 KB 页:hit 表示该页已经在 Postgres 的内存中,read 表示 Postgres 必须向操作系统请求它。还要先读这一行:耗时会随缓存和负载波动,页数不会。(PostgreSQL 18 默认会显示它;18 之前需要写 explain (analyze, buffers)。)
四个页,全都在内存中:三个属于主键索引(B-树章节会展示它的形状),另一个属于保存这行数据的表。
02-latency现在再看一个针对没有索引的列的过滤:
为了找到 85 行,读取了 35,173 个页:也就是表的每一个页。它仍然只花了约 30 ms,因为三个进程分担了工作,而且那些“read”页来自操作系统内存,而不是磁盘。
四个页对 35,173 个页,两者都“很简单”。报表每小时运行一次时,30 ms 没问题。每次页面加载都运行一次时,它就是数据库中最昂贵的操作。这里的本领在于注意这个比例。
一页可能位于三种位置之一
Postgres 需要一个页时,会在三个地方查找,而每个地方都比前一个慢得多:书桌、房间另一边的文件柜、城市另一头的仓库。
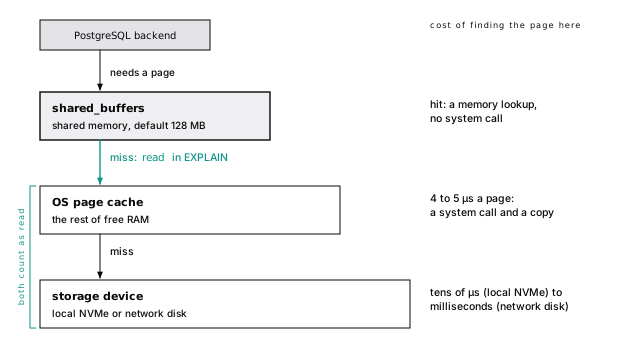
shared_buffers 是 Postgres 自己的页缓存,由每个服务器进程共享。默认值是 128 MB,故意设得很小;生产环境通常从 RAM 的约 25% 开始(真正重要的配置)。缓冲区缓存决定哪些页留下会展示它如何选择要保留的内容。
操作系统页缓存是内核对文件内容的缓存,使用其他地方没有占用的 RAM。Postgres 读取的每个页也会落在那里,所以一个热点页可能同时存在于两个缓存中。这种双重缓冲就是 shared_buffers 不会被设置为 RAM 90% 的原因。
“Read”不等于“来自磁盘”
在执行计划中,read 表示“不在 shared_buffers 中,所以 Postgres 向内核请求了它”。内核是否访问了设备,Postgres 看不见。时钟可以告诉你:实验套件打开了 track_io_timing,它会添加一行 I/O Timings。下面是散布在整张表中的 2,000 次主键查找:
读取 3,139 个页用了 15.0 ms:每页约 5 µs(我们多次运行得到的范围是 4 到 5 µs)。没有任何存储设备能把随机读取做得这么快;这些页来自操作系统页缓存。每页几十 µs 或更久,就意味着访问了设备。
生成这些数字的查询:
不要直接用顺序扫描的数字去除。PostgreSQL 18 中,顺序扫描会通过异步 I/O 预读,并把相邻页合并成更大的读取(默认最大为 io_combine_limit,128 KB),所以大部分 I/O 耗时会与其他工作重叠,平均到每页的数字没有多少意义。随机读取一次只读一个页,才是诚实的测试。
02-latency大型扫描不会冲掉缓存
你可能会以为,对 275 MB 的 events 表做一次全表扫描,就会把其他内容全部挤出 128 MB 的缓存。事实并非如此。大型顺序扫描会循环使用一小块私有缓冲区环(PostgreSQL 18 默认设置下为 2,304 KB),所以一份报表不会把应用正在使用的页赶出去(大型操作会使用环形缓冲区)。
每次提交都要等待磁盘
读取可以缓存。提交不行,前提是提交必须在崩溃后仍然存在。执行 commit 时,Postgres 会向预写式日志写入一条记录,并等待磁盘确认它已经持久化。这个等待就是一次 fsync,硬件决定它的价格:我们安静的笔记本 SSD 上约 0.65 ms,其他容器向同一磁盘写入时为 18 ms,而优质服务器存储上远低于 1 ms。
客户端每次只提交一行,就要为每一行刷新一次。0.65 ms 意味着理论上最多约每秒 1,500 次提交;18 ms 则约为 55 次。因此,10,000 行分成 10,000 个事务,就要刷新 10,000 次;放在一个事务中,则只需一次。
批量写入(快速加载数据),对于写入密集型系统,在购买快速读取的存储之前,先购买 fsync 快的存储。提交意味着刷新会测量提交速率,以及绕过等待的两种方式:多个会话共享一次刷新,或者完全不等待。
Postgres 有一个名为 fsync 的服务器设置。把它设为 off 会让基准测试看起来非常漂亮,却会让任何崩溃或断电都有可能悄悄损坏整个集簇,而不只是最后几次事务。synchronous_commit = off 是这个想法的安全版本,你可以按会话或事务设置它:崩溃可能丢失最近几分之一秒内提交的事务(最多是 wal_writer_delay 的三倍,默认 600 ms),但数据库仍然保持一致。
pg_test_fsync 随 Postgres 一起提供。在保存数据的卷上运行它;在实验套件中,先用 docker compose exec postgres bash 打开 shell:
在 Linux 上,fdatasync 是服务器的 wal_sync_method:这里是 0.65 ms。我们多次运行中,未同步写入的速度为每秒 260 万到 290 万次。这三个数量级的差距,就是持久性的代价。
IOPS 受在途读取限制,而不是由你付费购买的数量决定
每次同时未命中两个缓存的读取,以及每次提交,都会落到存储上。如果你使用托管服务,数据很可能位于网络块存储中:这种存储看起来像本地磁盘,实际上位于走廊另一头的服务器上,因此每次缓存未命中都是一次网络请求。这种存储用三个很容易混淆的数字来销售:延迟(一次 I/O 需要多久)、IOPS(每秒 I/O 次数)和吞吐量(每秒字节数)。
队列深度,也就是在途 I/O 的数量,把它们联系起来:达到的 IOPS = 在途 I/O 数量 / 延迟。一个进程一次等待一个 1 ms 的读取,无论你付费购买了多少 IOPS,得到的都只有 1,000 IOPS。(这就是 Little 定律;邮局排队也遵循它。)大型扫描可以让许多读取同时在途;一次错过缓存的索引查找,则只是到存储服务器的一次往返。
算一算。AWS gp3 的起点是 3,000 IOPS 和 125 MiB/s:对所有连接合计来说,大约是每秒 3,000 次随机冷页读取。只有在测量确认自己受 I/O 限制时,才购买更快的卷,永远不要用它替代索引。在托管服务上,这通常是你遇到的第一个上限(现在瓶颈是存储卷)。
在 gp3 的基线 3,000 IOPS 和 125 MiB/s 下:
- 随机页读取:3,000 IOPS 乘以 8 KB,约为 24 MB/s。对装不进内存的大表做索引查找时,所有连接合计最多约每秒 3,000 个冷页。
- 顺序扫描:275 MB 的
events表冷读时速度为 125 MiB/s,需要约 2.2 秒。100 GB 的表需要超过 13 分钟,而每晚运行一次的报表会让其他所有人都遇到存储卷饱和。
预置 IOPS 卷(io1/io2 风格)以更高价格提供更多 IOPS 和更低、更稳定的延迟。
突发额度也有精确数字。小于 1 TiB 的 gp2 卷可以在一笔至少能以满突发速度维持 30 分钟的余额上突发到 3,000 IOPS;许多较小的实例类型还可以在回落到低几倍的基线之前,将 EBS 最大性能维持至少每 24 小时一次、每次 30 分钟。gp3 卷不会突发,而是保持预置数值。
突发额度会在任务中途用完
gp2 卷和许多较小的实例类型依赖突发额度运行:一开始很快,额度用完后就回到低得多的基线。测试运行正常,繁重任务的前半小时也正常;然后流量没有变化,延迟却开始上升。如果 I/O 悬崖与负载持续时间相吻合,而不是与负载大小相吻合,请先检查突发余额,再检查查询。
本地 NVMe 很快,但主机没了它也没了
本地 NVMe 的读取延迟只有几十 µs,但主机没了它也就没了。只有在配套使用权威数据的副本和未经验证的备份只是传闻,并且它们能应对节点随时丢失时,才使用本地 NVMe(本地 NVMe:快,但主机没了它也没了)。网络卷可以在主机丢失后继续存在,但每次缓存未命中都会让你付出延迟。
根据工作集配置 RAM
对 Postgres 来说,最有效的硬件决策是为你的工作集准备足够的 RAM:比如一个小时内负载会访问的页。不是整个数据库,而是实际会用到的那部分。
events 加上索引后一共是 318 MB。但假设应用主要展示最近一周的数据。事件按时间顺序到达,所以最近 7 天的数据集中在表的末尾:675 个页,约 5 MB,比 users 还小。这是常见的形状:一个很少读取的大尾部,以及一个持续读取的热头部。你的工作集就是每张表的热头部、用于找到它的索引页,以及任何周期性任务会访问的内容。
如果工作集能放进 RAM(shared_buffers 加上操作系统页缓存),几乎每次读取都只需几微秒。如果放不下,每个查询都会变成存储延迟查询,再多 IOPS 也无法让它有内存访问的感觉。RAM 通常比 IOPS 便宜,也远比工程时间便宜。
查看堆和索引的整体大小:
一行的 ctid 是它的物理地址,由页号和槽位组成(行指针让元组移动而不改变地址会将其拆开);把它转换为 point 就能取出页号。示例数据截至 2026 年 10 月 6 日,因此我们从最新事件向前测量,而不是从 now() 开始:
02-latency观察数据库运行会展示如何测量缓存正在提供的内容。
往返比查询更贵
回到开头的端点。用随 Postgres 提供的负载生成器 pgbench 做端到端计时(pgbench 已经安装),一次主键查找耗时78 µs,包括往返,客户端和服务器位于同一台笔记本上。同一可用区中的另一台主机会为每个查询增加约 100 到 500 µs;另一个可用区最多增加几 ms;另一个区域则增加 30 ms 或更多。
现在来算N+1。一个页面展示 100 个项目,并分别加载每个项目的所有者,就会运行 101 个查询:
| 应用运行位置 | 往返 | 101 个查询 | 2 个查询 |
|---|---|---|---|
| 同一主机 | 0.08 ms | 8 ms | 0.2 ms |
| 同一可用区 | 0.5 ms | 51 ms | 1 ms |
| 其他可用区 | 1.5 ms | 152 ms | 3 ms |
| 其他区域 | 60 ms | 6 s | 120 ms |
查询并没有变慢。变的只有距离。这就是为什么 N+1 bug 在笔记本上看不出来,在生产环境中却很痛苦;也是为什么把数据库搬到“更好的区域”却不搬应用,会让一切都变慢。
ORM 版本看起来很无害:
改为一次查询获取它们,可以使用连接或数组参数:
用这种方式按主键获取 100 行,只需一次往返,耗时约一毫秒。大多数 ORM 都能请求这种行为(“eager loading”“includes”“preload”);经得住数据增长的查询会讲 SQL 方面的内容。
100 行,213 个页,一次往返。(written 统计的是在一个被其他实验占用的服务器上,此后端为了复用缓冲区而必须写出的脏页;不要让你的查询负责写脏页会解释这一点。)
02-latency每个查询的数字来自一个两行脚本 lookup.sql(繁忙运行时每个查询 100 µs):
新建一个连接要付出几次往返的成本,之后才会真正运行任何内容,所以请使用连接池(连接并非免费)。事务也会增加往返:begin、每条语句和 commit 都是独立的,除非驱动程序对它们进行流水线处理,因此一个包含五条语句的事务至少需要七次往返。流水线处理会在等待每个结果之前发送多个查询(libpq 从 PostgreSQL 14 起支持它,多个驱动程序也暴露了这个能力),对于频繁交互的负载,它可以在不重构查询的情况下减少延迟。
先估算,再测量
现在,你已经可以不运行查询就估算大多数查询了。三个同可用区往返、访问 50 个缓存页:约 1.5 ms,几乎全是网络成本。网络卷上的 2,000 个未缓存页:2 秒,而且增加 CPU 也没有帮助。在一块 fsync 需要 2 ms 的磁盘上,每行提交一次的批处理任务:每秒 500 行,最多如此。
出现慢操作时,问问哪个项很大:往返次数、页数,还是这些页来自哪里。本书其余内容会逐一缩小它们,从页本身开始。
本章要点
- 查询耗时大致等于往返次数乘以网络延迟,再加上访问页所在位置的每页成本:内存中是几微秒,网络卷上则可能达到数毫秒。
- 先读执行计划的
Buffers:行;页数会重复出现,耗时不会。read表示“没有命中 shared_buffers”,不表示“来自磁盘”。 - 一次提交要等待一次 WAL 刷新,无论事务包含什么内容。把行批量放进事务,并用
pg_test_fsync测量你的 fsync。 - RAM 应按工作集配置,而不是按整个数据库配置。在云卷上,达到的 IOPS 等于在途 I/O 数量除以延迟;要关注突发额度。
- N+1 查询消耗的是往返次数,不是服务器时间。用一次查询获取相关行,并让应用和数据库处在同一个区域、同一个可用区。
延伸阅读
- Resource consumption settings,PGDG。
shared_buffers、work_mem和 I/O 设置(包括io_method)的主要参考资料。 - WAL reliability,PGDG。持久提交要求磁盘做什么,以及写缓存可能如何撒谎。
- pg_test_fsync,PGDG。在选择存储前,测量你自己的 fsync 延迟。
- Amazon EBS volume types,AWS。网络块存储的实际 IOPS、吞吐量和延迟数字;General Purpose SSD page 记录了 gp3 基线和 gp2 突发额度。
- Numbers Every Programmer Should Know By Year,Colin Scott。可以按年份调整的延迟阶梯。
4 一切都从页说起
下面是两张拥有同样六列、保存同样一百万行的表:
唯一的区别是声明列的顺序。其中一张比另一张大 27%:要永久扫描、缓存、备份和复制的页也多 27%。
Postgres 实际上并不存储表。它存储页,而表就是能放进这些页里的东西。想象一下页的样子,你就能说清任意一行占多少字节,以及怎样让它占得更少。我们会从外向内展开,主要通过 pageinspect 这个可以从 SQL 读取页原始内容的扩展。
表是由页组成的文件
服务器数据目录中的每张表和每个索引,都是一个或多个普通文件。你可以查询它们的路径:
16764 是数据库 ID,16644 是表的关系文件节点(relfilenode),也就是它的文件名(你的值会不同)。在容器中的 shell 里(先运行 docker compose exec postgres bash,再执行 cd /var/lib/postgresql/18/docker):
正如先认识这些基本概念所展示的那样,288,137,216 除以 8,192 恰好是 35,173。这个文件除了页什么都没有,页从 0 开始依次编号。(超过 1 GB 后,表会继续写入 16644.1、16644.2 等文件。)
03-storage任何会重写整张表的操作(truncate、vacuum full、某些 alter table)都会用新名字写出一个新文件,所以永远不要假设文件名稳定不变。
表不只有主文件
events 有三个文件,而不是一个。每个文件都是一个有自己用途的分支文件:main 保存行,_fsm 是空闲空间映射,_vm 是可见性映射;下面会分别介绍这两个映射。未记录表还会增加一个空的 _init 分支文件,崩溃后会把它复制到其他分支文件上。
因此,对于“这张表有多大?”这个问题,诚实的答案很少只是主文件的大小:
pg_relation_size 只统计主分支文件。pg_table_size 会加上其他分支文件和表的 TOAST 存储(见下文),pg_total_relation_size 还会加上每个索引。请使用总大小。
每个页都有相同的布局
这 35,173 个页中的每一个都按下面的方式布局。这是本书最重要的一张图:
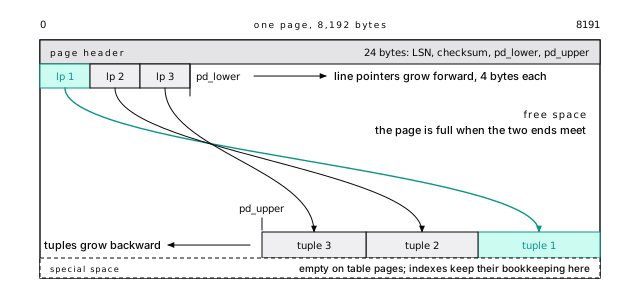
它就像一本笔记本:目录从顶部开始写,条目则从底部向上写。
一个 24 字节的页头记录页最后一次变更、校验和,以及空闲空间的起止位置。每个 4 字节的行指针从前端向后增长;每个行指针都指向一个元组。元组从后端向前增长;元组就是存储在页上的一份行版本。两者碰到一起时,页就满了。(索引会在末尾的特殊空间中保存簿记信息;表页则把这部分留空。)
这个页有 56 行。24 字节的页头加上 56 个、每个 4 字节的行指针,正好到 248:这就是 lower。元组从 384(upper)开始,因此还剩 136 个字节的空闲空间,不足以再放一行。special 是 8192,表示没有特殊空间。flags 是 4,也就是之后介绍可见性映射时会遇到的“全可见”标志。
03-storage行指针让元组移动而不改变地址
行指针允许 Postgres 在页内移动元组,以压缩空闲空间,同时不改变元组的地址。这个地址就是行的 ctid,由页号和行指针编号组成;每张表都有这个隐藏列:
(0,1) 表示第 0 页、第 1 个行指针。索引会存储 ctid:当索引查找到 id = 2 时,它找到的其实是“第 0 页、第 2 个槽位”。沿着 ctid 找到它所在的表页,就是查询就是页和往返中四页查找的第四次读取。
行的 ctid 会在行每次更新时改变(更新就是插入会解释原因),表被重写时也会改变。请用它来检查,但永远不要保存它,也不要把它交给应用程序。
在 InnoDB 中,表本身就是主键 B-树。Postgres 表是一个堆:行会放到有空间的地方,每个索引(包括主键)都指向一个 ctid(Postgres 不是 MySQL)。
8 KB 是编译时选择,应当保持不变
八千字节不是自然法则。它是常量 BLCKSZ,在编译 Postgres 时固定(./configure --with-blocksize,取值为 1 到 32 KB 之间的 2 的幂),数据目录中的每个文件都会按它写入。用 16 KB 页构建的服务器无法打开用 8 KB 页创建的数据目录,pg_upgrade 也不能在两者之间跨越。运行中的服务器可以告诉你它是用什么构建的,而且没有任何设置能改变它:
更大的页听起来像是需要数更少的页,而且对于某些工作确实如此。顺序扫描会进行更少次、更大的读取;每个索引页可以容纳更多键,因此树会稍微更浅;宽行也能更久地保持在行内,因为压缩和移出大值的阈值(见下文的 TOAST)会随页大小变化。
但 Postgres 会读取并缓存整页,有时还会整页记录日志,所以其他方面都会变差。在 32 KB 页上,只需要一行的查找会把四倍的字节加载到内存中。同样大小的 shared_buffers 只能容纳四分之一的页,因此你的热点行会和多四倍的冷邻居共享缓存。而检查点之后第一次修改一个页时,会记录整个页,所以每个整页镜像的大小都可能达到四倍。
所以我们保留 8 KB,你也应该这样做。托管服务反正不让你选择页大小。本书中的每个调节手段都可以在不自定义构建的情况下改变一页能容纳多少行:列顺序、更窄的类型、fillfactor、TOAST 和正确的索引。更大的页主要适合在自己编译的服务器上运行、以扫描为主的分析负载,而这种负载无论如何都更适合列存储(Postgres 不擅长什么)。
03-storage我们没有为本书构建 32 KB 服务器,所以这一框是在根据页的使用方式推理,而不是实验运行结果。会随 BLCKSZ 变化的限制包括:
- TOAST 会在行达到约四分之一页时开始压缩,这里约为 2 KB(大值会先压缩,再移出行外)。
- 索引条目不能超过约三分之一页,这就是为长文本列建立索引时会遇到的错误。
- 可见性映射为每页保留两位,因此每一位覆盖更多行;一个被修改的行会清除其邻居中更多行对应的位。
- WAL 中的整页镜像每个占一页,因此页越大,每次检查点之后的突发写入就越大。
另外两个相关但彼此独立的编译时常量是 wal_block_size(同样是 8 KB)和 1 GB 的文件段大小,这就是大表会继续写入 16644.1 的原因。pg_controldata 会打印数据目录的这三个值,而读取原始页的工具(例如 pageinspect)会从服务器获取它们的大小。
03-storage一行的成本高于它的列
打开一个页,数一数每行实际存储了什么。heap_page_items 会解码页上的每个元组:
元组 1 在偏移量 8048 处,占 144 字节,正好延伸到页尾;元组 2 紧接在它下面。每个元组都从 23 字节的元组头开始。
头部中最重要的两个字段是 t_xmin,即插入这一版本的事务;以及 t_xmax,即删除或锁定它的事务(如果没有则为 0)。它们是 Postgres 并发控制的核心,会在更新就是插入中单独介绍。这里每一行都是由事务 766(种子事务)插入的,没有一行被删除。t_ctid 是元组自己的地址,或者它的新版本的地址。t_hoff 表示列值从第 24 个字节开始,也就是头部和一个用于对齐的字节之后;列值按声明顺序首尾相接。
每行都有 24 字节头部和一个 4 字节行指针。一行如果只有两个整数,大部分空间都是开销。
完整的头部如下:
| 字段 | 大小 | 含义 |
|---|---|---|
| t_xmin | 4 字节 | 插入此版本的事务 ID |
| t_xmax | 4 字节 | 删除或锁定它的事务 ID,或 0 |
| t_cid | 4 字节 | 事务中的命令编号 |
| t_ctid | 6 字节 | 此元组的地址,或其新版本的地址 |
| t_infomask2 | 2 字节 | 列数及少数标志 |
| t_infomask | 2 字节 | 状态标志 |
| t_hoff | 1 字节 | 列数据开始的偏移量 |
第 1 行的 t_infomask 是 2306,pageinspect(PostgreSQL 13+)会对它进行解码:
这行包含可变宽度列,插入它的事务已知已经提交,而且没有有效的删除事务。后两项是提示位,也就是缓存下来的答案;读操作可以写入会解释它们。
接下来是数据。前八个字节是 id,整数 1,最低有效字节在前;任何 x86 或 64 位 ARM 机器都是如此:
接下来的八个字节 a903... 是 account_id:0x03a9 是 937,正好是 select account_id from events where id = 1 返回的值。
03-storageNULL 只占一位
NULL 在数据区不占空间。包含任何 NULL 的行会在头部带有空值位图:每列一位,NULL 对应 0。在 projects 中,未归档项目的 archived_at 是 NULL:
第 1 行和第 3 行没有归档:它们的第五位是 0,比第 2 行短 8 字节,因为第 2 行保存了时间戳。一位换八个字节。(最多 8 列时,位图可以放进头部多出来的一个字节。超过 8 列后,只要行中有 NULL,就需要更长的位图,这可能把数据起点从第 24 个字节推到第 32 个字节。)
03-storage列顺序就是空闲空间
现在回到本章开头的谜题。CPU 在地址为自身大小整数倍的位置读取值最快,所以 Postgres 会让值按这种方式排列:bigint 或 timestamptz 从 8 字节倍数开始,integer 或 date 从 4 字节倍数开始,smallint 从 2 字节倍数开始,而 boolean 可以从任意位置开始。当一个 8 字节列紧跟在结束于奇数偏移的位置之后时,Postgres 会填充中间的空隙。想象一个停车场:卡车只能停在每第八条车位线上;如果让一辆摩托车先占用第一个位置,后面七个位置就会空着。
下面逐列展示本章开头的两张表。pg_column_size 表明 padded 的一行是 72 字节,而 packed 的一行是 52 字节:
这种差异会叠加:每个元组在页上也从 8 的倍数开始(所以 packed 的 52 个字节在页上占 56 个字节),而且每行还需要一个行指针。结果是每页只能放 107 行,而不是 136 行;需要 9,346 个页,而不是 7,353 个页。
由此得到的规则是:
- 先放固定宽度的 8 字节列:
bigint、timestamptz、double precision。 - 然后放 4 字节列:
integer、real、date。 - 再放 2 字节列,最后放 1 字节列:
smallint、boolean。 - 可变长度列(
text、jsonb、numeric)放在最后。短值不需要对齐,因此可以在末尾紧密排列。
几千行时,完全不用在意。对于将要达到数亿行的窄表(事件、日志、连接表、指标),在写 create table 时花五分钟考虑一下;之后再排序就意味着重写表。
两张表使用同样的一百万行数据加载:
每页在扣除页头后有 8,168 个可用字节,每行还要有一个 4 字节行指针:
03-storage每种类型的对齐方式都在 pg_type.typalign 中:c(任意字节)、s(2)、i(4)或 d(8)。uuid 很特别:它占 16 字节,但对齐方式是 c,所以不需要填充。
示例模式表现良好。events 的一行包括页头、四个没有填充的 8 字节 ID、短文本形式的 kind、小型 jsonb 形式的 payload,以及 created_at;两个可变长度列之后可能会产生几个字节的填充。实测行大小为 136 到 144 字节,其中约 66 字节来自 JSON。真正值得关注的是 JSON 的成本;类型是一份契约会讨论什么时候应该把字段从 jsonb 提升为真正的列。
大值会先压缩,再移出行外
一行必须放进 8 KB 的页中,但一个 text 值最多可以有 1 GB。TOAST(The Oversized-Attribute Storage Technique,超长属性存储技术)解决了这两者之间的矛盾。当即将存储的行大于约 2 KB(8 KB 页下为 2,032 字节,因此一页至少能放四行)时,Postgres 会从最大的可变长度列开始处理:
- 在原处压缩这个值。
- 如果行仍然太大,就把这个值移入表自己的 TOAST 表中,切成略小于 2 KB 的块,并在原处留下一个 18 字节的指针。
在一张测试表中,100,000 个重复字符被压缩为 1,156 字节,始终没有离开行。32,000 个随机十六进制字符无法压缩,因此被移出并切成 17 个块,行中只留下一个 50 字节的元组。读回这个值意味着要在 TOAST 表中进行一次索引查找,再读取 17 个元组;这些操作在你的 SQL 中是看不见的。
这对查询意味着:
- 宽表上的
select *不是免费的。 不显示文档正文的列表页不应该读取它,而大多数 ORM 除非你明确告诉它们,否则会读取每一列。 - 修改经过 TOAST 处理的值会重写整个值。 修改一个大型
jsonb文档中的一个键,Postgres 也会再次存储整个文档。把经常更新的计数器移出文档;更好的办法是给它单独建一张窄表(把热点计数器移到窄表)。 - 中等大小的值最棘手。 1 到 2 KB 的值不会经过 TOAST 处理,却会让每行都变大,所以每页只能放下少数几行。
一张只有一个 text 列的表,其中填入短字符串、重复字符(非常容易压缩)和随机十六进制字符串(几乎无法压缩):
第 4、5 行在表页上留下了 50 字节的元组(24 字节头部、id 占 8 字节,以及 18 字节的指针)。它们的块是 TOAST 表中的行,reltoastrelid 在 pg_class 中指向这张表:
这个阈值是精确的:2,028 字节的行会原样存储,2,038 字节的行会被压缩。而 pg_column_toast_chunk_id(PostgreSQL 17+)展示了更新规则:更新另一个列会保留同一个 TOAST 指针,不复制任何内容;修改这个值则会再次存储全部 17 个块。
03-storage03-storage03-storage压缩按列进行。默认算法是 pglz;从 PostgreSQL 14 起可以选择 lz4(前提是服务器编译时启用了它,大多数打包版本都启用了),通常速度快得多,而压缩比相近:
同样的 100,000 个字符,pglz 存储时占 1,156 字节,使用这种算法只占 411 字节。这个设置只适用于之后新存储的值;如果你要存储大量可压缩文本或 JSON,在服务器级别将 default_toast_compression = lz4 作为默认值是合理的选择。
每一列还有一个存储策略(plain、main、external、extended;text 和 jsonb 默认使用 extended,先压缩再移出)。对于已经压缩的数据(例如图像),可以设置为 external,使用 alter table ... alter column ... set storage:再次压缩只会浪费 CPU,而且子串操作可以只读取所需的块。
toast_tuple_target 存储参数决定开始 TOAST 处理后,Postgres 会尝试把一行缩小到多小。它不会改变触发阈值:在 PostgreSQL 18 中,无论该参数是什么,行超过约 2 KB 时仍然会开始 TOAST。(CREATE TABLE 参考手册把它描述为触发 TOAST 的最小长度,但服务器代码检查的是固定阈值。)因此,更低的目标值不会触碰 1.5 KB 的行;一旦行确实超过 2 KB,就会把更多中等大小的列移出行外,用更多 TOAST 查找换取更小的行。
03-storage填充因子为更新留下空间
默认情况下,Postgres 会把表页填满;fillfactor 存储参数让插入更早停止,为每个页留下空间。这些空间是给更新用的:更新会写出行的新版本,如果新版本能放在同一个页上,成本就会低得多,因此选择这个值也是为页留下空间,否则每次更新都会移动的一部分。
插入无需扫描表也能找到空间
插入是怎样找到有空间的页的?不是扫描整张表。_fsm 分支文件大致记录每个页有多少空闲空间,每页一个字节,以 32 字节为步长:events 的第 0 页有 136 个字节空闲,记录值为 128(预留 4 个字节放行指针后)。找到有空间的页只需要几次读取。清理会更新这个映射,这时删除行释放的空间才会重新可用。如果没有页有空间,表就会在末尾增长。
03-storage每页两位让扫描和清理跳过工作
正因为每页有两位,仅索引扫描才能跳过表,而清理一张很大但大部分静态的表也会很便宜。最后一个分支文件 _vm 是可见性映射:表中的每个页有两位。
- 全可见(all-visible):页上的每一行现在以及将来都对每个事务可见。
- 全冻结(all-frozen):页上的每一行都已冻结,可以永久免受事务 ID 回卷影响(旧行必须在 XID 计数器回卷前冻结)。
pg_visibility 扩展可以汇总这些信息:
每个页都是全可见的,因为种子加载最后执行了 vacuum analyze。Postgres 有两个部分会依赖这张映射。仅索引扫描在页全可见时跳过表页,只从索引回答问题(B-树挑起大梁)。清理会跳过全可见的页(清理不可省)。对页的任何修改都会清除对应的位;等到每个事务都能看到这次修改后,清理会再次设置它。
建表前先数页
把这些部分放在一起,你就能在表还不存在时预测它的大小:
8,168 是页的 8,192 字节减去 24 字节页头。events 的行平均约 139 字节,因此每页大约能放 57 行,两百万行需要约 35,100 个页。真实的表有 35,173 个页。下次有人提议建一张每月增长五千万行的表时,在脑中算一算:需要多少页,有多少是热点页,能否放进内存?
页数支配着后面的一切,首先决定哪些页能留在内存中。而且每个 update 和 delete 都会改变它,只是第一次观察时,大多数人都不会想到这些变化。
本章要点
- 表是由 8 KB 页组成的文件,外加保存空闲空间映射和可见性映射的分支文件。用
pg_total_relation_size查看它真正有多大。 - 8 KB 在构建 Postgres 时固定(
block_size只读)。通过模式而不是自定义构建改变一页能容纳多少行。 - 每行都有一个 24 字节头部和一个 4 字节行指针。小行的大部分空间都是开销。
- ctid 是一个物理地址(页、槽位),每次更新都会改变。永远不要保存它。
- NULL 只占一位,而不是占用列的宽度。
- 把列按 8 字节固定宽度类型到 1 字节类型的顺序排列,可变长度列放最后。本例中错误的顺序多占了 27% 的空间。
- 超过约 2 KB 的值会先压缩,再移到 TOAST 表中。不要对不需要的宽列执行
select *。 - 填充因子为每个页的更新留下空间;HOT 章节会讲如何选择它。
延伸阅读
- Database page layout,PGDG。8 KB 页、行指针和每个元组头字段的权威来源。
- TOAST,PGDG。阈值、存储策略和压缩选项。
- Free space map 和 visibility map,PGDG。让插入和清理变快的两个小分支文件。
- pageinspect,PGDG。本章使用的每个函数,以及更多内容。
- Heap table structure,Hironobu Suzuki,《The Internals of PostgreSQL》。用图解方式补充说明同一种布局。
5 缓冲区缓存决定哪些页留下
读一遍一张九页的表,Postgres 会给它的每个页一个点。再读一遍:两个点。到第五次读取时,每个页都有五个点,计数也就到此为止。那些点,以及一只在缓存中转圈、不断扣除点数的手,决定哪些页留在内存中、哪些页离开。这就是整个驱逐策略,可以用一句话说清。
一个页的读取成本取决于它在哪里,可能是几微秒,也可能是几毫秒(一个页有三种位置)。本章讲的就是决定它位于何处的机制。之后还会讲每个连接为自己保留的内存;真正让服务器耗尽 RAM 的就是这部分。下面的所有内容都运行在实验套件默认的 128 MB shared_buffers 上,并通过 pg_buffercache 扩展检查。
shared_buffers 是一个页数组
shared_buffers 是一个由 8 KB 槽位组成的大数组,这些槽位称为缓冲区,在启动时分配到共享内存中。每个进程都通过它读取和写入页。默认的 128 MB 对应 16,384 个缓冲区。
把它想成存包处:一排编号的挂钩,每个挂钩都有一张票。每个缓冲区的票是一份 64 字节的描述符,其中包含标记它所保存页面的标签(文件、分支文件和块号)、当前正在使用它的进程数、使用计数,以及它是否已经在内存中变更但还没有写出(即是否为脏页)。pg_buffercache 会为每个缓冲区显示一行,并解码这些字段;下面的例子通过 cached 读取它。这是一个建立在 pg_buffercache 上的小视图,只保留当前数据库的表,并给它们标上名称。
pg_shmem_allocations(PostgreSQL 13+)会列出其中的组成部分:
Buffer Blocks 是 128 MB 的页(外加 4 KB 的对齐空间)。Buffer Descriptors 正好是 1 MB:16,384 个描述符各占 64 字节,并按一个 CPU 缓存行对齐;这样,两个进程更新相邻描述符时就不会争用同一缓存行。
cached 视图把 pg_buffercache 连接到 pg_class。它除了文件编号,还会按数据库过滤,因为从同一个模板克隆出来的数据库会从相同的文件编号开始:
整个服务器都在使用共享内存:除了 shared_buffers,还有 WAL 缓冲区、锁表和其他部分。show shared_memory_size 在实验套件上报告 152 MB;规划 RAM 和 Linux 大页时要围绕这个数字进行(内存:先做预算,再调参数;PostgreSQL 15+ 的 shared_memory_size_in_huge_pages 在这里报告 76)。
04-buffers找到一个页只需要一次哈希查找
想要访问 users 的 7 号块的后端进程,不会搜索 16,384 个描述符。它会对标签进行哈希,然后在缓冲区映射表中查找;这是一张把标签映射到缓冲区的共享哈希表:
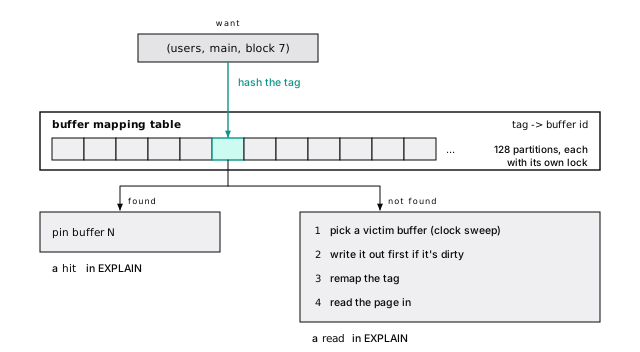
命中只是在 128 个分别加锁的分区之一中快速查找,因此后端进程很少互相等待。未命中则要做真正的工作。当许多会话都在等待 BufferMapping(没有等待事件的活动会话正在 CPU 上运行)时,它们是在同时未命中:这说明工作集装不进缓存,而不是需要调节某把锁。
钉住意味着“正在使用”
后端进程接触一个页之前,会先钉住这个缓冲区。被钉住的缓冲区不能被驱逐,所以在读取期间页会留在原处。钉住的时间通常很短,但只要查询还停留在某个页上,它就会持续存在:打开的游标,或读到一半就停止接收数据的慢客户端,都会让它所在的页保持钉住。这会影响清理。清理只能处理没有被任何人钉住的页,因此一个停放的游标会让清理跳过该页,或在 BufferPin 事件上等待(清理不可省)。
在 accounts 上打开一个游标,取出一行,cached 会显示 0、1、2 号块分别被一个后端进程钉住。游标持有 0 号块,因为它取出的行来自那里。1、2 号块也会被钉住:从 PostgreSQL 17 开始,顺序扫描会通过“读取流”读取数据,提前钉住后面的几个页,让它们的 I/O 可以先行进行。在这些钉住存在期间,pg_buffercache_evict()(PostgreSQL 17+,超级用户专用,仅用于测试)会拒绝驱逐这些缓冲区。提交事务后,同一个调用就会成功。
04-buffers每次读取都会增加使用计数
每次钉住还会增加缓冲区的使用计数,最高为 5:这是缓存记住一个页有多热门的方式。驱逐 accounts(九个页),扫描它,然后计数:
扫描一次,每个页得到一个点。扫描五次,得到五个点,此后就保持不变。
04-buffers时钟扫描挑选受害者
当后端未命中且所有缓冲区都已被占用时,总得有东西离开。Postgres 不维护一个最近最少使用列表(每次命中都维护它,需要一把全局锁)。它运行的是时钟扫描:
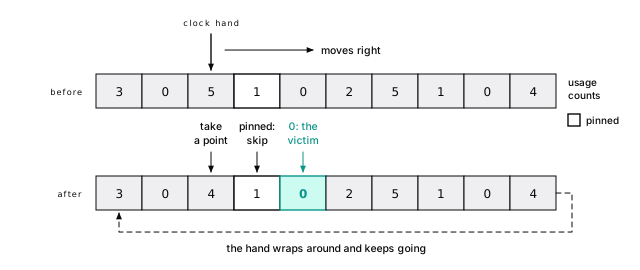
一个页只读取一次,可以撑过指针的一轮经过。持续读取的页早在指针转回来之前就恢复到 5,因此不会降到零。这里有两个后果:
- 冷数据的一次扫描不会挤出热点集合。 冷页进入时计数为 1,最先离开;如果是严格的最近最少使用缓存,所有更早的页都会被驱逐。
- 热门程度取决于更换速度。 指针移动得和后端未命中的速度一样快。未命中很多时,它就会旋转得很快,连热门页也会在两次访问之间掉出去。未命中会造成更多未命中;工作集超过缓存时,就是这样突然跌落的。
从空缓存开始:pg_buffercache_evict_all()(PostgreSQL 18,仅用于测试;永远不要在你在意的服务器上运行)会丢弃所有未钉住的页。读取 accounts 五次,让它的页都处于 5。然后向缓存中灌入数据:pg_prewarm 通过正常路径读取 events 的前 20,000 个页,超过缓存中的 16,384 个缓冲区。
洪流自身已经有 3,600 多个页消失,被后来读入的新页驱逐了;而 accounts 的九个页都存活下来,只是在指针每轮经过时少了一个点。哪些较早的洪流页会消失,取决于指针当时停在哪里(在我们的运行中,有时最前面的一千个全消失,有时一个也没有)。整体形状不会改变。
pg_buffercache_usage_counts()(PostgreSQL 16+)会给出全服务器的分布。在共享实验服务器上,十几个实验同时运行时,16,384 个缓冲区中有 13,578 个处于 0 或 1,只有 295 个处于 5:这说明缓存太小,或者正在被一次性读取全部数据的工作不断扫过。稳定负载下、真正发挥作用的缓存,在 4 和 5 处会有一条较厚的尾部。
04-buffers你的查询不该负责写出脏页
update 会改变缓冲区中的页,并将它标记为脏页;数据文件并没有被触碰。变更已经记录在预写式日志中,而日志必须先到达磁盘,数据页才能写出(检查点限制恢复时间)。之后,页会由三类进程之一写入文件:
| 谁 | 何时 | 理想占比 |
|---|---|---|
| 检查点进程 | 每个检查点写出所有脏缓冲区 | 大部分写入 |
| 后台写入器 | 持续运行,在时钟指针到达之前提前写出 | 一部分 |
| 任意后端进程 | 它选中的受害缓冲区为脏时 | 少量 |
留意最后一行。后端进程选中一个脏受害者后,必须在重新使用缓冲区之前先把它写出,于是查询会等待。如果后端进程持续承担稳定比例的页写入,说明 shared_buffers 对写入负载来说太小了。pg_stat_io(PostgreSQL 16+)会按进程类型统计写入(pg_stat_io 会发现后端写出脏页(PostgreSQL 16+))。
更新 50 个账户后,cached 在我们的运行中显示两个脏页:一个保存旧的行版本,另一个接收新的行版本(更新就是插入解释了为什么会有两个)。
检查点进程会写出检查点开始时所有处于脏状态的缓冲区,这样恢复就可以从那里开始。后台写入器每 200 ms(bgwriter_delay)唤醒一次,找出时钟指针即将到达的脏缓冲区,并写出其中最多 100 个:使用默认值时每秒最多 4 MB。后端进程在别无选择时才写出;pg_buffercache_evict() 展示了这条规则:驱逐脏缓冲区之前,先将它刷新出去:
在我们的共享测试服务器上,其他实验批量加载数据时,一个只运行了一次扫描的后端进程不得不写出其他会话留下的 2,909 个脏页,才能腾出空间。
04-buffers大型操作会使用环
一个每晚通过 128 MB 缓存读取 275 MB 的报告,如果没有任何限制,就会把缓存冲垮。确实有一个限制。访问大量页、但每页只访问一次的操作会得到一个缓冲区环:一小组由操作私有、可以循环使用的缓冲区;操作会从这里反复取用缓冲区,而不是从时钟指针那里拿新的,所以驱逐的是自己的页,而不是你的页。
| 操作 | 环 | 默认大小 |
|---|---|---|
| 大于 shared_buffers / 4 的表的顺序扫描 | bulkread | 256 KB,外加容纳在途 I/O 的空间:PostgreSQL 18 中为 2,304 KB |
| VACUUM 和 ANALYZE | vacuum | vacuum_buffer_usage_limit,2 MB(该设置从 PostgreSQL 16+ 开始;17 将默认值从 256 KB 提高了) |
| COPY FROM 和 CREATE TABLE AS | bulkwrite | 16 MB |
扫描阈值是 shared_buffers 的四分之一,也就是这里的 4,096 个页。在空缓存中分别扫描一次 events(35,173 个页)和 users(1,126 个页),并关闭并行工作进程:
小表会完整留在缓存中。大表通过自己的环,只留下不到 288 个缓冲区;这就是 2,304 KB 环的大小(确切数量会随运行而变化)。
写入会带来一个意外:insert ... select 没有环。用两种方式分别加载同样的两百万个整数;COPY 会在缓存中留下一个 16 MB 的环,即 2,048 个页,并在过程中写出自己的页。insert ... select 则会把全部 8,850 个页留在 shared_buffers 中,占 128 MB 缓存中的 69 MB,并把脏缓冲区留给别人写出。要向新表回填数据,使用 COPY 或 create table as 才是礼貌的做法。
环会阻止一个操作驱逐其他人的页,但对 I/O 毫无帮助:报告仍然要读取全部 35,173 个页,而且因为这些页不会留下来,下一次运行仍然要全部读取。如果大型扫描频繁到值得关注,它需要索引或汇总表,而不是更大的缓存。
环的大小不会超过 shared_buffers 的八分之一。PostgreSQL 18 的批量读取环之所以大于经典的 256 KB,是因为异步读取需要有缓冲区承接数据:在 256 KB 之外,再加上 8 KB 乘以 io_combine_limit(16)乘以 effective_io_concurrency(16)的空间,总共是 288 个缓冲区。后端进程自己的 I/O 计数器 pg_stat_get_backend_io()(PostgreSQL 18)显示,上面的全表扫描在 bulkread 上下文中重复使用了超过 35,000 次缓冲区。开启并行工作进程后,每个工作进程都有自己的环。
写入实验:
copied 多出 62 个页:COPY 一次扩展文件很多个页,最后一批仍然是空的。因为装满新行的环缓冲区是脏的,COPY 会在循环复用缓冲区时写出自己的页。这是有意的:批量加载会自己承担写出成本,而不是把它交给后台写入器和其他后端进程的驱逐操作。
04-buffers临时表使用本地缓冲区
临时表永远不会进入 shared_buffers。每个会话会把它们缓存在私有的本地缓冲区中,默认 temp_buffers 为 8 MB;更大的临时表在每次扫描时都会从自己的文件读取。这个设置只能在会话第一次接触临时表之前提高,所以如果应用会创建大型临时表(报表、导入、暂存),请按角色设置:alter role reporting set temp_buffers = '64MB'。
操作系统页缓存是第二层
在 shared_buffers 中未命中,仍有可能命中内核的页缓存。环使大型扫描每次运行时都要到这一层查找页,因此第二层缓存能让重复运行的报告撑得住;这也是建议把 shared_buffers 保持在 RAM 的四分之一左右,而不是占大多数的原因之一(shared_buffers 从 RAM 的 25% 起步,而不是 80%)。
使用计数为 1 的大表需要索引,而不是内存
SQL 可以观察到上面的一切。下面的查询会按当前数据库各表和索引占用的缓存大小排序:
结合时钟指针来读这个查询。大部分页已被缓存、平均使用计数接近 5 的表就是热点集合,值得占据缓存。一个大表占据了缓存的很大比例,但使用计数只有 1,说明它只被读取了一次就被替换;这时需要的是索引,而不是更多内存。这个查询会遍历每个缓冲区,因此按需运行;pg_buffercache_usage_counts()(PostgreSQL 16+)是便宜的全服务器检查,而大多数缓冲区都在 0 或 1,说明缓存正在不断周转。
重启后预热缓存
重启会清空 shared_buffers,故障切换到缓存了不同页的副本也会如此。在接下来的一个小时里,原本命中内存的每个查询都会转向操作系统缓存或磁盘;在网络存储上,这可能是一周中最慢的一个小时。pg_prewarm(一个 contrib 扩展)按需加载关系:select pg_prewarm('users') 加载了全部 1,126 个页,随后的一次全表扫描全部命中。
autoprewarm 恢复上一次缓存
手工选择表只是猜测。autoprewarm 是同一扩展的一部分,它会记录缓存中的内容,并在重启后将其放回去:
后台工作进程每 5 分钟保存一次缓存块列表,并在关机时保存;服务器接受连接的同时,它会在启动时将这些块重新加载。备库上也会运行它,因此故障切换后,新的主库可以从自己的热缓存列表开始。它每隔几分钟只需写入一个小文件;把它打开吧(托管服务可能不允许你这样做:扩展来自允许列表)。
它也适用于索引(users_pkey 有 276 个页),并接受一个分支文件和块范围。预热的页没有特殊待遇:它们从使用计数 1 开始;预热一张大于 shared_buffers 的表,就是前面所说的洪流。另有两种模式会绕过 shared_buffers:'read' 和 'prefetch',适用于大到装不进它、但仍能放进 RAM 的关系。autoprewarm 的列表是一个小型文本文件 autoprewarm.blocks,每个块占一行;select autoprewarm_dump_now() 可以按需保存它。
04-bufferseffective_cache_size 是提示,不是内存
effective_cache_size 不分配任何东西。它告诉规划器两层缓存中可能已有多少数据,数值越大,索引扫描看起来就越便宜。把它设置为机器 RAM 的 50% 到 75%(effective_cache_size 是一个提示:设置为 RAM 的 50% 到 75%)。
1 MB 时,规划器假设通过索引获取的几乎每个页都是一次新的随机读取,于是改为对顺序扫描排序。4 GB 时,它会遍历索引。内存没有任何变化;任何会话都可以设置这个值。代价模型本身位于规划器也在估算中。
后端内存是私有的
到这里讲的都是共享部分。每个后端进程还有私有内存,随着工作分配,其他进程看不见:空闲时一两 MB,执行查询时达到一百 MB 或更多(内存:空闲 1.5 MB,排序中 109 MB同时测量了两种情况)。其中大部分由两件事决定:查询的工作内存,以及系统目录的缓存。
最大的内存上下文会指出罪魁祸首
Postgres 会在内存上下文中分配内存;这些上下文是按树排列的内存区域,工作结束时会释放整个上下文,例如查询结束时释放该查询的上下文。pg_backend_memory_contexts(PostgreSQL 14+)会显示当前后端进程自己的树;如果要查看另一个后端,比如一个已经增长到 2 GB 的连接池连接,pg_log_backend_memory_contexts(pid) 会把它的树写入服务器日志。最大的上下文会指出罪魁祸首。
work_mem 是按节点计算的,而且可以看到
work_mem(默认 4 MB)限制的是计划中的每个排序或哈希步骤,而不是每个查询。一个归并连接同时包含两个排序,就会同时持有两份额度:我们捕获过一个查询,其中两个 Sort 节点各持有刚刚超过 4 MB。再加一个哈希连接,就是第三份额度,大小是 work_mem 的两倍(使用默认的 hash_mem_multiplier)。乘以连接数,你就知道为什么我们让全局 work_mem 保持适度,并按角色或按事务提高它(work_mem:提高之前先乘一遍)。
把这个连接查询声明为游标并取出一行,这样两个排序都会完成并保留在内存中:
每个排序都达到自己的 work_mem 上限;每个 300,000 行输入的其余部分都溢出到了临时文件。
04-buffers目录缓存只会增长
为了规划查询,后端进程需要表的定义;它会把从系统目录读取的内容缓存起来,并一直保留到连接结束。下面是一条连接在 1,000 张小表上分别运行一个简单查询后的情况:
每张表及其索引在每个访问过它们的后端进程中约占 9 KB;连接池在客户端之间运行的 discard all 并不会把这些内存还回来。10,000 个分区和 200 个连接池连接,就会产生几 GB 的 RAM,而这些内存不会出现在任何计划中。
回收连接:给连接池中的服务器连接设置最长生命周期(PgBouncer的 server_lifetime 默认是 3,600 秒)。一个小时的增长是有上限的,一个月则不是。还有,如果租户映射到模式,不要让每个租户都经过每个连接(不要信任任何租户会介绍共享表租户模型)。
内存上下文的源码 README 说,CacheMemoryContext 从不重置或删除:它持有关系缓存(每个打开的表或索引一个条目)和目录缓存(目录本身的行)。
04-buffers本章要点
- shared_buffers 是一个由 8 KB 缓冲区组成的数组。时钟扫描会驱逐它遇到的第一个未钉住且使用计数为 0 的缓冲区,并从经过的每个缓冲区扣除一个点:热点页会不断得分,只读一次的页一轮之后就会离开。
- 变更会让内存中的缓冲区变脏。检查点进程应该写出其中大多数;写出自己选中的受害者的后端进程是在等待 I/O。检查
pg_stat_io。 - 大型扫描、VACUUM 以及 COPY 或
create table as会使用小环,不会冲刷你的缓存。insert ... select不会,所以批量加载时优先使用 COPY 或create table as。 - 临时表使用每个会话自己的
temp_buffers;如果会创建大型临时表,请按角色设置。 - 用
pg_buffercache查看缓存内容;打开 autoprewarm,重启或故障切换后就能恢复热缓存。 effective_cache_size是一个可能改变计划的规划器提示;它不分配内存。work_mem按每个排序或哈希节点计算;连接接触的每张表都会让目录缓存增长,而且不会缩小。在连接池中限制连接生命周期。
延伸阅读
- src/backend/storage/buffer/README,PostgreSQL 源码。缓冲区管理器自己的设计说明:钉住、内容锁、映射分区、时钟扫描和缓冲区环。
- pg_buffercache,PGDG。每个字段和函数,包括摘要、使用计数、驱逐函数及其版本说明。
- pg_prewarm,PGDG。预热模式和 autoprewarm 设置。
- Resource consumption settings,PGDG。
shared_buffers、temp_buffers、work_mem、vacuum_buffer_usage_limit和后台写入器设置。 - src/backend/utils/mmgr/README,PostgreSQL 源码。内存上下文的工作方式,以及它们各自会存活多久。
6 更新就是插入
示例数据库中的 users 表有 9 MB。对它运行一条语句:
现在它有 18 MB,索引也从 8 MB 增长到 12 MB。你没有改变任何一行的大小,也没有增加任何行,但表却翻了一倍。运行 vacuum 后,它仍然是 18 MB。
这都不是 bug。这是 Postgres 让许多事务在不让读者等待写者的情况下读写同一份数据的方式。这项技术叫作多版本并发控制(MVCC),它的核心规则只有三个词:更新就是插入。一旦你在页中看到了这一点,膨胀、缓慢的更新、跟不上趟的清理,以及事务 ID 回卷,就都不再神秘了。
读者永远不用等待写者
想象一份汇总每个账户余额的报表,它需要运行十秒。运行到一半时,另一个事务把钱从报表还没读到的账户转移到它已经统计过的账户。如果报表每到一页就读取当时页上的内容,这笔钱就会从总数中消失。
一种解决办法是加锁:报表锁住它读到的内容,写者等待。结果正确,却很难受。Postgres 采取了另一条路:它从不原地覆盖一行。更新会写入这一行的一个新版本,并把旧版本留在原处,标记是谁替换了它。在更新之前开始的读者继续看到旧版本;之后开始的读者看到新版本。谁也不用等待。
代价会晚些时候出现:旧版本会不断堆积,直到再也没有人需要它们,然后由清理把它们收走。那堆东西就是膨胀。
每次写入都会取得一个事务 ID
每一行首部的两个数字,是本书后面膨胀、清理工作和回卷问题的起点。它们背后牵连着后面所有这些问题。
每个改变数据的事务,都会在第一次写入时从服务器级计数器取得一个事务 ID(XID);只读事务永远不会取得事务 ID。每个行版本的首部都带着两个事务 ID(一行的成本不止它的列):xmin 是插入它的事务,xmax 是删除、替换或锁住它的事务(没有则为 0)。每一行 events 的 xmin 都是 766,也就是种子数据事务,xmax 都是 0;对任何表运行 select xmin, xmax, * from events 都能看到它们。
(运行本章实验时服务器比较忙,所以下面的 XID 很大,而且会在步骤之间跳跃。你的值会不同。)
更新会写入完整的新行
要观察版本如何产生,我们需要一张小到可以完整读出的页。一项按账户统计使用量的计数器很合适,这正是应用会不断更新的那类行:
三行位于第 0 页的第 1 至第 3 个槽位,由事务 869572 插入。现在递增账户 1 的计数器。RETURNING 配合 old 和 new(PostgreSQL 18+)可以显示两个版本的地址:
这一行移到了新的槽位。现在这一页为三行保留了四个元组:旧版本仍然逐字节位于槽位 1,被更新事务的 XID 标记,并指向 (0,4);槽位 4 中则有一份完整的新副本:
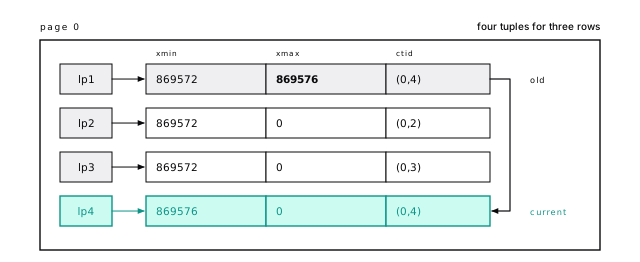
整个机制就是这样:更新插入一个新版本,并在旧版本上盖章:“已被 869576 替换,见 (0,4)”。
每次更新都会写入一份完整的新副本,无论实际改变了多少内容。在一行 1 KB 的记录中递增一个 4 字节的计数器,页上也会落下一条新的 1 KB 元组。这就是为什么宽而且频繁更新的行在 Postgres 中代价高昂,也解释了为什么应该像 account_usage 这样,把热点计数器放进单独的窄表。
只有没有快照能看到的版本才是死版本
再更新账户 1 两次,它的版本链就会依次串起 (0,1)、(0,4)、(0,5)、(0,6):三行对应六个元组,其中三个已经成了无用的死版本。
任何事务都再也看不到的版本,就是一个死元组。“再也”很重要:一个被替换的版本,只有在所有可能仍然读取它的事务都结束后才算死亡。仍在运行的最老快照(它是一个固定的、记录了哪些事务已经提交的视图,见下文)会设置 xmin 清理界限(xmin horizon):在它之前死亡的版本可以移除;其余版本必须留下。清理能清掉多少,就由这条界线决定;长事务一节会说明这一点。
死元组有两种清除方式。页内剪枝会在查询读取一张几乎填满的页时顺手发生:成本低,一次处理一页,也不需要处理索引。清理则做完整的工作,包括索引条目(清理不可省)。
运行 vacuum account_usage 后,账户 1 的三个死版本消失了,槽位 1 变成指向槽位 6 的重定向,因为主键索引仍然指向 (0,1)。元组会移动,地址不会。这正是行指针让元组移动而不改变地址所说明的事情。
在此之前,这一页保存着完整的版本链:
运行 vacuum account_usage 后再次查看页,额外列出 lp_off 和 lp_len:
槽位 1 的 lp_flags 是 2,即重定向;它的偏移字段中存着目标槽位 6。槽位 4 和 5 的值是 0,即未使用:由于它们是堆内元组,没有索引条目指向它们,所以可以直接释放。槽位 6 移到了偏移 8048。第四种状态 lp_flags 3 是死:元组已经消失,但某个索引仍可能指向这个槽位。它会一直保留,直到清理移除索引条目,之后才会变成未使用。
05-mvccHOT 更新会跳过索引
索引指向地址,因此一个位于新地址的新版本,通常需要在表的每一个索引中新增条目。我们的账户 1 更新却没有这样做:它们是 HOT(heap-only tuple,堆内元组)更新,留在同一页中,不改动索引。只有同时满足以下条件才行:没有索引列发生变化,并且新版本能放进同一页。
违反第一个条件,更新就会变成普通更新。给 account_usage.updated_at 建索引,然后更新账户 2 的 updated_at;账户 2 的主键索引会新增第二个条目,指向新版本的槽位,而账户 1 在三次 HOT 更新后仍只有一个条目。
页填得太满则会违反第二个条件。我们加载了两份 users 副本,一份使用默认的 100 fillfactor,另一份使用 85(填充因子为更新留下空间),然后分别更新每十行中的一行。在 100 时,10,000 次更新没有一次是 HOT,表从 1,126 页增长到 1,239 页。在 85 时,10,000 次更新全部是 HOT,表一页也没有增长。让更新保持 HOT会继续讲解。
05-mvcc一个快照选择一个版本
当一行在页上有多个版本时,查询如何选出其中一个?它依据的是一个快照:在语句(或事务)开始时拍下的、记录哪些事务已经提交的照片。如果一个版本在照片拍下之前出生,并且在那时还没有死亡,你就能看到它。一个版本链中最多只有一个版本通过这项检查。
我们从两个会话中观察它。会话 A 使用事务 869588 更新账户 3,并让事务保持打开:
会话 B 读取同一行:
B 看到的是旧版本,尽管 A 的 XID 已经出现在它的 xmax 中。B 拍下快照时 A 还没有提交,所以在 B 看来,旧行还没有死亡,新行也还没有出生。B 没有等待,也没有阻塞 A。
A 提交后,B 的下一条语句就会看到 events_today = 100。如果 A 回滚,页上的内容不会改变:它的版本会带着一个已中止的 xmin,对所有人都不可见(原子性:任何事情都不会被撤销)。
InnoDB 原地更新行,并把旧版本保存在撤销日志中。Postgres 则把旧版本保存在表本身:回滚立即完成,读取当前数据的成本很低,但每次更新都会写入完整的一行,并留下一个死元组等待清理(Postgres 不是 MySQL)。
格式是 xmin:xmax:in-progress list。所有小于 868807 的事务都已经结束。869587 是最近结束事务的下一个事务 ID;大于等于它的任何事务,无论后来发生什么,都会被视为仍在运行、不可见。列表保存了中间那些仍在运行的事务(服务器空闲时通常很短,或者为空)。会话 B 在 A 保持打开时取得了这个快照,所以 A 的 869588 对它不可见。更精确地说:当一个版本的 xmin 在快照之前已经提交(或者它是你自己的事务更早写入的内容),并且它的 xmax 为空、已中止、在快照看来尚未提交,或者只代表一个锁时,这个版本才可见。
那一刻,账户 3 的两个版本都在页上,而 pg_xact_status('869588') 报告的是 in progress:
05-mvcc读取也可能写入
读者如何知道事务 869588 是否提交?它会查询提交日志(pg_xact),每个事务占两个 bit;第一个查到结果的读者,会把答案缓存到元组本身的提示位中。
这意味着读取也可能写入。第一次对刚加载的行执行 select 时,会在它读取的每个元组上设置提示位,把这些页标记为脏页,之后再写回磁盘。批量加载后,运行 vacuum analyze,让这阵写入按你的安排发生,而不是在用户访问时发生(在打开大门前清理并分析)。
执行普通的 select count(*) from hint_demo2 后,同一个元组读出的内容变成 {HEAP_HASVARWIDTH,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}:select 查询了提交日志,并把答案写入它读到的每个元组。开启数据校验和后,这次写入还可能在 WAL 中产生一份整页镜像(启用校验和后,连读取也会写 WAL)。
05-mvcc删除只给行盖章
删除比更新简单:它只设置 xmax,除此之外什么也不做。删除一行后,它仍以完整大小留在页上,xmax 中带着删除者的 XID。它从所有新快照中消失,却仍然占用空间。删除一百万行不会缩小表;它只会产生一百万个死元组,等待清理将其变成可复用的空间。
truncate 是例外。它什么也不盖章:它换入一个新的空文件,所以快照早于它的事务看到的也是空表,而不是原来的内容(TRUNCATE)。不要截断一张仍可能被长时间运行的读者读取的表,例如报表或逻辑备份正在读取的表。
账户 4 的行是在删除之前刚刚插入的,执行插入的这个事务展示了 XID 在何时分配:
删除本身:
槽位 7 仍以完整大小处于使用状态,t_ctid 指向自身(因为没有更新版本),标志位为 HEAP_KEYS_UPDATED;每次删除都会设置它,行锁也会关注它。
05-mvccxmax 不总是表示删除。没有人动过的 accounts 第 42 行,其 xmax 是插入种子事件数据的事务 766,标志位是 HEAP_XMAX_KEYSHR_LOCK 和 HEAP_XMAX_LOCK_ONLY。每个事件都通过外键引用 accounts;为了防止账户在插入过程中被删除,Postgres 在它上面取得了一个轻量级的 for key share 行锁。行锁存放在 xmax 中,因此即使是在插入时执行外键检查,也会写入被引用行所在的页。当多个事务同时锁住一行时,xmax 会改为保存一个多事务 ID(MultiXact),指向 pg_multixact 中的一个列表;MultiXact 也有自己的回卷限制,清理一章也会监视它。关于行锁的一般内容见大家都得排队。
一个可重复读会话先取得自己的快照。另一个会话运行 truncate imports 和 delete from deletes_demo(每张表各有 500 行)并提交。第一个会话再次查看:
delete 遵守快照。truncate 在 ACCESS EXCLUSIVE 锁下换入了一个新的空文件,而旧文件对所有人都消失了。
05-mvcc清理释放表内空间,而不是磁盘空间
现在来测量本章开头的实验。pgstattuple 扩展会读取表的每一页,并报告空间的使用情况:
先对刚加载的种子数据运行这项查询,执行 update users set name = upper(name) 后再查一次,执行 vacuum users 后再查一次:
更新使表翻了一倍。由于没有一次更新是 HOT(页原本已经填满),两个索引也各自新增了 100,000 个条目。清理移除了死元组,留下一个 18 MB、空闲空间占一半的表。清理产生的是页内的空闲空间,而不是磁盘上的空间:它只能把文件末尾的空页交还出去,而这里旧版本填满了前半部分。
这些空间并没有浪费;第二次完整更新复用了它,表仍然是 18 MB,而不是 27 MB。批量更新后的表,会稳定在活跃行加上两次清理之间堆积的死元组所需的大小。多出来的部分就是膨胀。少量膨胀很正常,甚至有用。一张表如果膨胀到活跃数据的 5 倍大小,就有问题:每次扫描都要读取 5 倍的页,缓存中能容纳的有用行也减至原来的五分之一。而它就来自应用代码中看起来无害的一件事:一次触及每一行的回填。
05-mvcc第二次完整更新几乎没有 HOT:pg_stat_user_tables 统计出 100,000 次更新中只有 50 次是 HOT。活跃行被压在表的后半部分,而所有空闲空间都位于其他页上。
如果必须更新一张大表中的大多数行,就用每批几千行的方式进行,并在批次之间运行一次清理(或者确保有足够的 autovacuum),这样后面的批次就能复用前面批次释放的空间。沿主键分批短距离回填给出了这种模式。收缩一张已经膨胀的表需要重写,清理一章会介绍。
长事务会把一切都拖住
清理只有在没有任何快照可能仍然看到一个死元组时,才能移除它。所以数据库中任何地方的一个旧快照,都会拖住每张表的清理。这是失控膨胀最常见的原因之一,而且你可以看着它发生。
会话 A 开启一个可重复读事务(所以它的快照在事务结束前固定不变),读取一些内容,然后停在那里。pg_stat_activity 将它的快照界线显示为 backend_xmin,值为 868917:这是 A 取得快照时仍在运行的最老事务。与此同时,会话 B 删除表的一半数据并执行清理:
60,000 个死元组尚不能移除:其中 50,000 个是刚刚删除的,另外 10,000 个来自 fillfactor 实验。截止点恰好是会话 A 的 backend_xmin。A 从未碰过 users_ff100,这也无关紧要:它的快照早于这次删除,因此它仍可能请求这些行。A 一提交,同样的清理就会移除全部 60,000 个元组,并把表从 1,239 页截断到 1,126 页。
05-mvcc在生产环境中,阻塞者可能是因为漏掉提交而处于idle in transaction状态的连接,运行了六个小时的分析查询,或者某人在午饭前于 psql 中启动后就忘记了的迁移。常见嫌疑包括:长事务(包括打开了 hot_standby_feedback 的副本上的事务)、处于 idle-in-transaction 状态的会话(设置 idle_in_transaction_session_timeout)、未消费的复制槽,以及被遗忘的预备事务。当任意事务打开超过几分钟时就发出告警;清理无法移除旧快照可能需要的内容给出了找出这些对象的查询。
旧行必须在 XID 计数器回卷前被冻结
磁盘上的 XID 是 32 位的,Postgres 会在一个圆环上比较它们,因此如果某一行的 xmin 落后超过大约 21 亿个事务,它突然就会看起来像来自未来,然后消失。清理通过冻结旧行来防止这种情况:把它们标记为永远对所有人可见;如果一页上的所有行都已冻结,后续每次清理都会跳过这一页。如果冻结落后了,通常是因为某些东西把 xmin 界线拖住,Postgres 就会停止接受写入;回卷会在任何内容损坏前停止写入会介绍设置、监控和恢复。
relfrozenxid 是表对“没有未冻结元组比这更老”的保证;account_usage 的值是 869572,比当前事务老 27 个。显式冻结它(账户 4 的已删除行也会在这次清理中移除):
冻结会同时设置“已提交”和“无效”两个提示位;其他情况下这组组合没有意义。两者同时出现就表示已冻结。原始 xmin 仍然保留,便于调试,但之后不再查询它。relfrozenxid 跳到当前值(年龄为 1),可见性映射把第 0 页标记为全可见和全冻结。正常运行时你永远不需要手动执行 vacuum freeze;autovacuum 会在常规工作中完成冻结。
05-mvcc隔离级别主要决定何时取得快照
快照也解释了隔离级别:一个级别改变的主要是取得快照的时机。读已提交是默认级别,每条语句取得一个快照,所以同一事务中的两次 select 可能看到不同的数据。可重复读和可串行化则每个事务取得一个快照,因此更新一行时,如果它在取得快照之后被别人修改过,更新就会因串行化错误而失败,并且应用必须重试(只有可串行化能排除所有异常和大家都得排队会继续介绍)。无论处于哪个级别,打开的事务都会让其快照拖住清理。让事务尽量短。
本章要点
- Postgres 从不原地更新一行。
update写入一个完整的新版本,并用更新者的 XID 标记旧版本;delete只做标记。两者都会留下死元组。 - 快照决定查询看到每一行的哪个版本,因此读者和写者不会互相阻塞。
- 当没有索引列发生变化且新版本能放入同一页时,HOT 更新会跳过所有索引。对于每次更新都会变化的列,不要在没有权衡代价的情况下给它们建索引。
- 清理会把死元组变成表内可复用的空间,很少缩小文件。大型更新要分批执行。
- 一个长时间运行或处于 idle-in-transaction 状态的会话,会阻塞整个数据库的清理。要按事务年龄告警。
- 旧行必须在其 XID 落后大约 20 亿个事务之前被冻结;清理一章会介绍如何监视这一点。
- 第一次读取刚加载的行时会写入提示位;批量加载后,在用户访问数据前运行
vacuum analyze。
延伸阅读
- Concurrency control: introduction和transaction isolation,PGDG。官方模型,以及每个隔离级别究竟保证什么。
- Preventing transaction ID wraparound failures,PGDG。冻结、年龄设置,以及接近限制时会发生什么。
- src/backend/access/heap/README.tuplock,PostgreSQL 源码。行锁和 MultiXact 如何存放在
xmax中。 - Hint Bits,PostgreSQL Wiki。进一步了解为什么读取也可能写入。
- Concurrency control,Hironobu Suzuki,《The Internals of PostgreSQL》。通过图示逐步讲解可见性规则。
7 让更新保持 HOT
复制一份带有六个索引的 users,更新其中 5,000 行,并递增一个没有任何索引覆盖的计数器。Postgres 写入 438 KB 的 WAL。再递增同一个计数器,同时更新 updated_at(它有索引),就像大多数 ORM 每次保存时做的那样;同样的 5,000 行会写入 2.96 MB,几乎是七倍。逐行更新时差距还会扩大:一次更新分别是 127 字节和 15,327 字节,因为其中两张被触及的索引页必须整页记录。区别就在于这次更新是不是 HOT。
每次更新都会把一份完整的新行版本写到新地址(更新会写入完整的新行),而索引指向地址。如果不做任何特殊处理,每次更新都会在每个索引中写入一个新条目。HOT 是 heap-only tuple(堆内元组)的缩写,是一条逃生通道:新版本留在同一页,索引完全不用知道它的存在。
你从来不用打开 HOT。它一直处于启用状态,而模式决定它能多常发挥作用:你给哪些列建索引、页填得有多满,以及事务保持打开的时间。把这三点做好,几乎每次更新都能跳过索引。
冷更新要为每个索引付费
把不是 HOT 的更新称为冷更新。它会写入一个新元组(完整的一行),在每个索引中新增一个条目,即使那些索引覆盖的列没有变化,还要为这一切写入 WAL。HOT 更新只写元组及其 WAL。就这些。
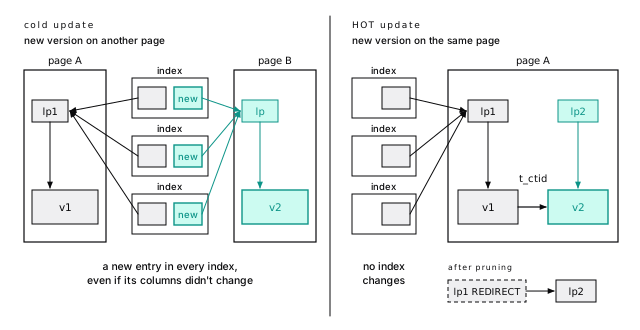
下面是完整的开场实验。我们复制了一份 users,让每一页留下 10% 的空闲空间(下面会讲 fillfactor 90),然后用两种方式更新其中的 5,000 行;表上分别有一个、三个和六个索引,并避开任何检查点。HOT 更新递增 login_count,没有索引覆盖它。冷更新还更新了有索引的 updated_at(只有一个索引时,该索引就是建在 updated_at 上的):
| 索引数 | HOT WAL | 冷更新 WAL | 冷更新 / HOT | HOT 缓冲区 | 冷更新缓冲区 |
|---|---|---|---|---|---|
| 1 | 438 KB | 999 KB | 2.3x | 11,370 | 21,504 |
| 3 | 438 KB | 1.91 MB | 4.5x | 11,370 | 46,906 |
| 6 | 438 KB | 2.96 MB | 6.9x | 11,370 | 87,026 |
先看 HOT 那几列:无论索引数量是多少,都是 438 KB 和 11,370 个缓冲区。HOT 更新看不见你的索引。每增加一个索引,冷更新一侧就大约多出一次 HOT 更新量的 WAL;索引数为六时,冷批次触及的缓冲区是 HOT 的 7.7 倍。
账单还会继续。HOT 更新之后的清理,没有索引条目需要移除;冷更新之后的清理则读取了全部六个索引的每一页。每个副本也都要重放同一份 WAL(Uber 遇到了这种不对称,而且双方都有道理)。
06-hotpg_walinspect 扩展(PostgreSQL 15+)会从日志中读回记录。我们在检查点之后,对这张六索引表运行了四次单行更新,交替执行 HOT 和冷更新:
- **更新 1,HOT:**一条记录携带两份整页镜像(堆和可见性映射),因为自上次检查点以来,这两个页都是第一次被触及(检查点后的第一次变化会记录整页)。
- **更新 2,冷更新:**七条记录,一条堆记录和每个索引各一条,每条都有自己的 8 KB 镜像。共 52,359 字节,约 51 KB。
- **更新 3,HOT:**71 字节,加上一条 56 字节的剪枝记录,共 127 字节。
- **更新 4,冷更新:**七条记录,加上剪枝记录。其中四次索引插入命中了已经有镜像的叶页(64 到 80 字节);另外两次没有命中,每次都付出了 7,400 字节。共 15,327 字节。
冷更新每个索引多出一条记录,而每条记录都有机会带来一份 8 KB 镜像。在检查点后的第一个 5,000 行批次中,镜像主导了两种更新:HOT 写入 10.0 MB,六个索引的冷更新在 35,250 条记录中写入 24.3 MB(每行一条堆记录、每个索引一条记录,此外还有 250 次去重遍历)。每个副本都要接收这 24.3 MB。
06-hotHOT 需要一次未被索引覆盖的变化,以及页上的空间
更新因为两个原因之一而无法成为 HOT,修复方式取决于具体是哪一个。我们先给它们命名,后面整章都会使用这些名称:
- 更新没有改变任何索引列时,我们称它为 HOT-safe(对 HOT 而言是安全的)。(从 PostgreSQL 16 起,只被BRIN索引覆盖的列不计入。)
- 更新同时满足 HOT-safe,且新版本能和旧版本放在同一页上时,它才是 HOT。
索引提到的每一列都算作已索引
“已索引”指的是出现在任何索引定义中的任何位置,而不只是键列。我们给一份 projects 副本建立了五种索引:
然后一次只运行一项更新,并观察 n_tup_hot_upd 在 pg_stat_user_tables 中的变化:
| 更新 | 你可能期待它成为 HOT 的原因 | HOT? |
|---|---|---|
set archived_at = now() | 没有索引存储 archived_at | 否 |
set name = name || ' (old)' | name 只在 INCLUDE 中 | 否 |
set slug = upper(slug) | lower(upper(slug)) 的值相同 | 否 |
set created_at = created_at - interval '1 day' | 只有 BRIN 索引覆盖它 | 是 |
set budget = 1.00(原为 1.0) | 作为数字相等 | 否 |
set name = name, account_id = account_id, budget = budget | 没有任何变化 | 是 |
把这些“否”当作警告。部分索引的谓词也算,所以在部分索引中使用软删除列,会让每次归档和恢复都变成冷更新。INCLUDE 列也算:覆盖索引会让它所携带的列失去 HOT。表达式索引算的是列本身,不是结果。BRIN 指向页范围而不是行,因此不需要新的指针。
发生变化意味着字节不同
“变化”不是 SET 列表,也不是 SQL 相等性:Postgres 会比较每个索引列的新旧字节。因此 set name = name 满足 HOT-safe,这对每次都把所有列写回去的 ORM 是个好消息。而 1.0 变成 1.00 虽然数值相等,却是冷更新,因为字节不同。
HOT 版本永远不会离开它所在的页
第二个条件是物理条件。HOT 版本永远不会离开它所在的页,所以落到该页的查找就能在那里找到它。如果新版本放不下,它就会去别的地方,并在每个索引中取得一个条目。你可以用下面要讲的 fillfactor 控制这部分空间。
HOT 查找会沿着版本链走,不离开所在页
HOT 更新就像贴在旧公寓门上的转交便签。索引保留着旧地址;旧版本写着“搬到了同一栋楼的槽位 3”,查找顺着这张便签走,不必离开这一页。通过 t_ctid 字段连接起来的各个版本,组成一条 HOT 链。lp 编号就是行指针,即页顶端编号的槽位(行指针让元组移动而不改变地址):
- **索引永远不会移动。**查找落到
lp1,然后沿着版本链走到快照可见的版本:无论链有多长,都只需一张索引页和一张堆页。 - **页内剪枝会把版本链变成重定向。**一旦旧版本对每个快照都已死亡,下一个访问者就会剪枝(只有没有快照能看到的版本才是死版本),让
lp1成为指向最新版本的重定向,不触碰索引。这就是 HOT 价值的一半:空间会在正常流量中回来。 - **只有清理才能完成工作。**整条链都死亡后,
lp1仍会作为死存根留下,直到清理移除索引条目。
一张带有 128 行短记录的 counters 表,会把一页填到只剩 488 字节。我们让另一个会话保持可重复读快照,然后把第 1 行更新了三次:
HEAP_HOT_UPDATED 表示“我的后继版本是堆内元组,沿着我的 t_ctid 跟过去”;HEAP_ONLY_TUPLE 表示“没有索引指向我”。bt_page_items 显示键 1 只有一个索引条目,仍指向 (0,1);索引扫描读取两个缓冲区。沿着链接走时,扫描会检查下一个版本的 xmin 是否与前一个版本的 xmax 匹配,因为两次访问之间槽位可能已经被释放并复用:ctid 是地址,不是身份。
另一个会话提交后,同一个 select 打印出 WAL: records=1 bytes=64。一次读取剪枝了这一页:槽位 1 现在是指向 131 的重定向(lp_flags 2),129 和 130 未使用(lp_flags 0)。一页最多容纳 291 个行指针,这可以防止小行用存根把页填满。
06-hot页接近填满时才进行页内剪枝
同时满足两个条件时,任何触及这张页的查询都会进行剪枝,包括 select。页上带有由更新或删除设置的提示,表示页中可能有死版本。并且页上的空闲空间小于其 fillfactor 预留空间和页大小 10%(819 字节)两者中的较大值。空间充裕的页不会在访问时剪枝;清理最终会处理它。
剪枝会记录 WAL,所以读取会写入。只读负载产生 WAL 不必惊讶(启用校验和后,连读取也会写 WAL讲的是另一个原因)。
三行数据,对第 1 行更新两次,然后执行一次索引扫描:没有 WAL,page_header() 显示有 7,988 字节空闲空间,并且已经设置了剪枝提示。五个版本全部留下。counters 页一开始有 488 字节空闲空间,低于 819 字节的界线,所以第一次访问时就剪枝了。源码中的规则是 heap_page_prune_opt。
还有两个细节。剪枝需要清理锁(不能有其他人钉住该页),并且不会等待清理锁;因此非常繁忙的页可能跳过剪枝,让一次原本 HOT-safe 的更新转移到其他地方。另外,update 当时不能剪枝它正在更新的行所在的页,所以下一次 HOT 更新所需的空间,通常来自更早的一次访问。
06-hot给页留下空间,否则每次更新都会移动
刚加载的表是挤满的。填充因子是每页在继续使用下一页之前允许插入填满的百分比;剩余空间留给更新。它默认是 100,因此刚加载的页没有多余空间,第一次更新无论是否 HOT-safe,都会变成冷更新。你可以按表设置它:
我们制作了三份 users 副本,都带有 login_count 列,各有两个索引,分别将 fillfactor 设为 100、90 和 70;然后从四个 pgbench 客户端随机更新用户,合计执行 200,000 次单行更新(pgbench 是随 Postgres 提供的负载生成器),并保持自动清理开启:
| 填充因子 | HOT | 移到新页 | 更新前 / 后页数 | 更新后索引大小 |
|---|---|---|---|---|
| 100 | 92.2% | 15,542 | 1,137 / 1,311 | 8,336 KB 到 8,624 KB |
| 90 | 100% | 0 | 1,266 / 1,266 | 8,336 KB,不变 |
| 70 | 100% | 0 | 1,613 / 1,613 | 8,336 KB,不变 |
填充因子为 100 时,有 15,542 次更新变成冷更新;挤满的表最终比填充因子为 90 的表还大,索引也随之增长。它最终还是付出了预留空间的代价,只不过使用了最糟糕的货币。批处理更严苛:在填充因子为 100 的表上,一条更新 10% 行的 update 中 10,000 次更新没有一次是 HOT,写入的 WAL 是同一语句在 90 时的五倍。
06-hot在 pgbench 运行中,填充因子为 100 的表现比你预期的好,这是因为第一次更新把一行移走后,剪枝会在每页释放一两个槽位。并发和自动清理的时机都会改变这些数字,所以实验运行了一个可重复的版本:单个会话随机执行 50,000 次单行更新。填充因子为 90 时 HOT 比例保持 100%;填充因子为 100 时约为 95%,并开始增长。批次无法依赖剪枝,因为一条语句会先更新一页上的多行,之后才有机会剪枝。
批处理运行的是在新副本上的 update ... set login_count = login_count + 1 where id % 10 = 0:
| 填充因子 | HOT | WAL 记录数 | WAL | 触及的缓冲区 |
|---|---|---|---|---|
| 100 | 10,000 次中 0 次 | 40,471 | 3.5 MB | 103,024 |
| 90 | 10,000 次中 10,000 次 | 10,000 | 703 KB | 22,532 |
五个这样的批次之后,填充因子为 100 的表 HOT 比例提高到了 77%,页数恰好达到 1,266,也就是填充因子为 90 的表的大小;为此它付出了 11,365 次冷更新和额外的 43 个索引页。
06-hot预留空间要先付出代价,之后才会回本
第一天这些预留空间是空的:填充因子为 90 让表大了 11%,为 70 让表大了 42%,而膨胀估算器会把这些预留空间也算作膨胀。像 events 这样的只追加表保持 100。更新很多的表从 90 开始;如果行有几百字节,或者 n_tup_newpage_upd 一直上升,可以降到 70 或 80。
之后再设置只会作用于新页。已有页会保持挤满,直到发生重写(不加锁重建膨胀的表);对于一张正在使用的大表,跳过重写,让新页采用这个设置。
填充因子只帮助 HOT-safe 更新。如果索引覆盖了你更新的列,再多的空闲空间也不能让这些更新成为 HOT。在调整表大小之前,先检查你违反的是哪一半规则。
忙碌的表 HOT 比例应高于 90%
Postgres 会替你统计这些数据。pg_stat_user_tables 有 n_tup_upd(所有更新)、n_tup_hot_upd(HOT 更新)和 n_tup_newpage_upd(PostgreSQL 16+:新版本去了另一页,因此这是冷更新)。留在原页的冷更新说明页上有空间,所以改变了索引列;移动了的冷更新则说明没有空间:
index_changed 高:索引覆盖了更新会改变的列,填充因子帮不上忙。no_room 高:页太满了;降低填充因子,或者查找长事务(下一节)。两者都高:先修索引,因为即使索引列发生了变化,只要发生移动,也会计入 no_room。
按一天的变化来观察,而不是看全生命周期累计值。在有真实更新流量的表上,超过 90% 是健康的;忙碌表上的低比例是最应该先修的事情。
在实验数据库中:
churn 每次更新都会改变索引列,其中 127,233 次还发生了页移动,这就是“先修索引”的原因。后端进程会在事务结束后约一秒内刷新统计信息。在脚本中,先调用 select pg_stat_force_next_flush();,或者在事务内部读取 pg_stat_xact_user_tables。对于一条语句,在随后会回滚的事务中执行 explain (analyze, buffers, wal),可以看到 HOT 大约每行一条 WAL 记录,冷更新则是每行一条再加每个索引一条;在整个负载范围内,pg_stat_statements 会按 wal_bytes 给语句排序。
06-hot长事务会关闭 HOT
页内剪枝只能移除对每个快照都已死亡的版本。数据库中任何地方的一个旧快照,都会让比该快照更新的版本无法被剪枝。旧版本堆积,页被填满,原本 HOT-safe 的更新开始移动,并写入索引条目。
我们在一张全新的填充因子为 90 的表上重复了五个批次,同时让另一个会话停留在一个打开的可重复读事务中:
| 50,000 次更新,填充因子 90 | HOT | 堆页 | 索引页 |
|---|---|---|---|
| 没有打开的事务 | 100% | 1,266 到 1,266 | 1,042 到 1,042 |
| 另一个会话持有快照 | 22.8% | 1,266 到 1,755 | 1,042 到 1,429 |
另一个会话从未碰过这张表。它只持有快照几秒钟,HOT 比例就降到了 23%,表和索引却永久增长了三分之一以上。同一个快照也会阻塞清理(清理无法移除旧快照可能需要的内容)。保持事务短小,并设置 idle_in_transaction_session_timeout。
06-hotHOT 是一次性做出的设计决定
本章中的每次冷更新都来自某个索引或某个已填满的页。两者都是模式选择,所以一次修好即可。
不要给 updated_at 建索引
几乎每个 ORM 都会在每次保存时设置 updated_at。给它建索引后,这张表的每次更新都会在每个索引上变成冷更新。在给任何大多数更新都会改变的列(updated_at、last_seen_at、status、计数器、locked_by)建索引前,先说清楚是哪条查询需要它:
- **“自上次同步以来发生了什么变化?”**更适合用只追加的变更日志或 outbox 表来服务。
updated_at上的 BRIN 索引是 HOT-safe 的(PostgreSQL 16+),但 HOT 会把行留在原处,因此这些值很快就会偏离物理顺序。先测量。- 很少运行的管理员查询可以直接扫描。每天十秒钟,总好过让数百万次更新都变成冷更新。
把热点计数器移到窄表
宽行上的计数器每次递增都会复制整行,并为了这 8 个字节把整行拖过缓存。我们把一个 view_count 放到 profiles 表上;这张表包含 416 字节的 bio,共 6,667 页。我们又把同一个计数器放进一张两列的旁表(599 页)。两边的 HOT 比例都保持 100%,但检查点之后立刻递增 10,000 次时,宽表写入 49.3 MB WAL,窄表写入 4.9 MB:页镜像只有十分之一,而且计数器能够留在缓存中。
last_seen_at、login_count、速率限制、心跳都可以这样处理:凡是写入频率远高于所在行的内容都适用。非常频繁的递增要合并成批量更新。也不要在繁忙的表上用触发器维护计数(计数器触发器会让写者串行)。
在稳定状态下,WAL 差距会缩小(第二个批次为 1.06 MB 对 764 KB),因为只要更新留在原页,记录的就只有发生变化的字节,除非 wal_level 是 logical。而且 10% 的预留空间由数量为原来十倍的窄行共享:一条每五行递增一行的语句,在宽表上保持了 67% 的 HOT,在窄表上保持了 54%。
06-hot让 ORM 少写一些
无条件更新 updated_at 会产生一个新的行版本;如果 updated_at 有索引,这就是冷更新。一次没有真实变化的保存虽然是 HOT-safe,仍然会写入版本和 WAL,并增加未来的清理工作。使用脏检查;在普通 SQL 中则加上保护条件:
自底向上的索引删除是安全网
从 PostgreSQL 14 开始,如果 B-树的键没有变化,它会在冷更新之后自行清理:分裂叶页之前,删除其中指向死版本的条目。这是一张安全网,不能代替 HOT。每次冷更新仍然写入并记录了这些条目,而键发生变化的索引要一直等到清理才会处理自己的垃圾。
churn 表(id、email 和 updated_at 都有索引;不运行清理)分 30 个批次执行了 300,000 次冷更新,每次都改变 updated_at:
| 索引 | 键是否改变? | 持有的堆指针 | 更新前 / 后页数 |
|---|---|---|---|
churn_updated_at_idx | 是 | 400,000 | 276 / 1,098 |
churn_pkey | 否 | 196,685 | 276 / 551 |
churn_email_idx | 否 | 189,244 | 499 / 975 |
updated_at 索引保留了每个活跃条目和过期条目。另外两个索引在运行过程中分别删除了 68% 和 70% 的过期条目。
06-hot这就是 Postgres 做出的取舍
Postgres 索引指向物理地址:查找直接,但每次冷更新都会写入每个索引。MySQL 的 InnoDB 做了相反的选择:那里的更新只触及发生变化的列所属的索引,所以给 updated_at 建索引,每次更新只需写一个索引,而在这里可能要写每一个索引(一次更新写一行,或者写每个索引)。HOT 缩小了这道差距,所以代价如此依赖你的模式。几乎总能重新塑造造成问题的表。在责怪数据库之前,先做这个。
本章要点
- 冷更新会在每个索引中写入条目,还要付出 WAL、清理以及每个副本上的同等代价:六个索引时,WAL 是 HOT 更新的 6.9 倍。
- HOT-safe 表示没有索引列发生变化;HOT 还要求页上有空间。要知道自己违反的是哪一半。
- 已索引表示出现在索引的任何位置:键、
INCLUDE、表达式或部分谓词(仅被 BRIN 索引覆盖的列例外,PostgreSQL 16+)。 - 不要在没有明确查询需求的情况下给
updated_at或其他大多数更新都会改变的列建索引。 - 更新很多的表设置
fillfactor = 90(宽行使用更低的值);只追加表保持 100。 - 用
n_tup_hot_upd和n_tup_newpage_upd对照n_tup_upd,判断应该修索引还是增加页内空间。 - 一个被持有的快照把我们的 HOT 比例从 100% 降到 23%,并让每个索引都增长。保持事务短小。
- 把不断变化的计数器移到窄表,并且不要写入没有变化的行。
延伸阅读
- src/backend/access/heap/README.HOT,PGDG 源码。设计文档:版本链、重定向、剪枝,以及
CREATE INDEX如何处理已有版本链。 - Heap-Only Tuples (HOT),PostgreSQL 文档。两个官方条件,包括汇总索引例外。
- B-tree bottom-up index deletion,PostgreSQL 文档。PostgreSQL 14+ 如何限制冷更新造成的索引膨胀。
- HOT updates in PostgreSQL for better performance,Laurenz Albe,CYBERTEC。简洁的实践者视角,讲解条件和填充因子。
- The Part of PostgreSQL We Hate the Most,Andy Pavlo 和 Bohan Zhang。研究者对追加式版本机制的批评,以及关于更新有多大比例是 HOT 的集群数据。
8 先记日志,再写数据
在一台磁盘刷新需要 7.7 ms 的笔记本虚拟机上,每个事务插入一行的循环每秒大约只能提交 130 次。改一个会话设置,同一个循环就能达到 16,500 次。保持原来的设置,并行运行八份循环时,它们不会互相拖慢,合计大约能做到 1,240 次。
这些都与行本身无关。插入一行真正做的工作只有几百字节。全部差异来自一个文件:预写式日志,以及 Postgres 等待它到达磁盘的那个时刻。
了解这个文件里写入什么、什么时候必须落盘,以及为什么检查点之后它会膨胀,你就能在不牺牲安全性的情况下让写入变便宜。
先写日志,而不是写数据页
Postgres 在 shared_buffers 中修改页。被修改的页是脏页,迟早必须回到磁盘(不该由你的查询来写脏页)。
每次提交都写入所有脏页会很慢:文件位置分散,20 字节的变化也要完整写入 8 KB,热点页还会被一遍遍写回。因此 Postgres 做的事,就像商店收银台的做法:先把每笔交易记入账簿,打烊后再给货架补货。每次变化都会进入一条紧凑记录,追加到一份连续日志中,这就是预写式日志(WAL)。提交只需等待日志到达磁盘;数据页稍后批量写回。如果服务器先崩溃,日志中包含重做这些变化所需的一切信息。
名字本身就是规则:描述某个页的日志记录,必须在该页到达磁盘之前到达磁盘。
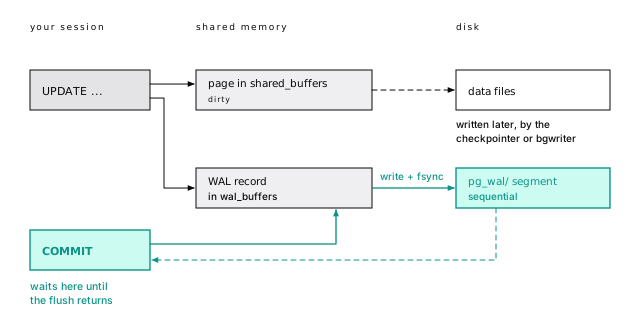
顺序追加是代价最低的持久化写入方式,而并发事务可以共享一次刷新。后一项事实解释了开头那些数字。
ACID 的四项承诺中,WAL 保证的是持久性:一旦提交记录安全地进入日志,事务就算提交了(如实看待 ACID会把这四个字母逐一拆开)。
WAL 记录很小,页镜像却不是
一条 WAL 记录会说“在关系 R 的 N 号块上执行这个操作”,它本身很小。更新 wal_demo 中的一行——这张表是含有 200,000 行的 events 副本——日志就会得到两条记录:一条携带完整行变化、150 字节的 HOT_UPDATE,以及一条 34 字节的 COMMIT,你的 COMMIT 等待的就是后者。
这是安静时的情况。如果该页自上次检查点以来还没有记录过(检查点会定期写出每个脏页,见下文),同一次更新还会带来一份 8 KB 的页镜像。在大多数写入负载中,WAL 的主要来源不是记录,而是镜像。
LSN 是字节偏移量
每条 WAL 记录都有一个地址,即日志序列号(log sequence number,LSN):它是无尽数据流中的字节偏移量,写作 2/8BE4C8B0。将两个 LSN 相减(pg_wal_lsn_diff()),就能得到 WAL 字节数,这正是我们测量 WAL 的方式。
LSN 也会强制执行预写规则。每个数据页都会记住最后一条修改它的记录的 LSN,Postgres 不会在 WAL 刷新到那个位置之前写出该页。在磁盘上,这条数据流被切成位于 pg_wal/ 中、每个 16 MB 的 WAL 段文件。
三个十六进制字段分别是:时间线(00000001,故障切换或时间点恢复后会改变)、LSN 的高半部(00000002),以及其中的段(00000060,即 0x60C91650 除以 16 MB)。Postgres 随附的 pg_waldump 可以在命令行中打印这些文件里的记录,每个块显示为 rel tablespace/database/relfilenode blk N。
pg_current_wal_lsn() 是当前位置。在一个批处理作业前后各读一次再相减,就测出了这一时间窗口内整个集簇写入的 WAL:下面的 10,000 行插入在我们空闲的实验机器上“测得” 1,901 KB,而其他数据库繁忙时曾达到 5 MB。
07-walEXPLAIN 会显示一条语句写入的 WAL
explain (analyze, wal)(PostgreSQL 13+)会运行一条语句,并报告它生成的 WAL。与 LSN 差值不同,它只统计这条语句,因此其他会话不会干扰结果:
10,000 行、20,027 条记录:每行一条堆插入和一条主键插入,外加几条用于新页的记录。约每行 193 字节,这是只有一个索引的表在稳定状态下的价格。每增加一个索引,每行就会多一条记录。explain analyze 确实会运行语句,所以要把写入包在 begin; ... rollback; 中。
对于整个批处理作业,或者生产环境的 60 秒样本,则改为相减两次 LSN 读数。它测量的是整个集簇,而不是一条语句;这就是你的 WAL 速率:用于确定副本带宽、备份存储和 max_wal_size 大小的数字。
检查点为恢复设定上限
如果没有检查点,崩溃恢复就必须从最初的起点重放 WAL。一次检查点会把所有脏缓冲区写入数据文件,并对这些文件执行 fsync。检查点开始的位置称为重做点(redo point)。检查点完成后,这个位置之前的所有变化都已安全地写入磁盘,因此恢复可以从那里开始:
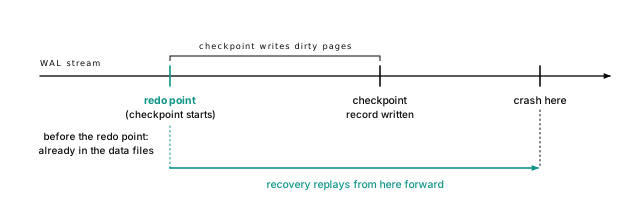
checkpoint_timeout 到期时会开始检查点(默认 5 分钟);如果 WAL 堆积得太多,也会更早开始。max_wal_size(默认 1 GB)是 Postgres 尝试让两次检查点之间保持的 WAL 大小。由于检查点的写入会分散进行,同时还会有更多 WAL 到达,所以它在略高于该值一半时就会请求下一次检查点:默认约为 540 MB。
pg_stat_checkpointer(PostgreSQL 17+)把第一类计为 num_timed,其他全部计为 num_requested,其中包括由 WAL 触发的检查点和每一条手动 CHECKPOINT 命令(本章实验会运行多次)。开启 log_checkpoints 后,服务器日志会为每次检查点写出原因:time、wal,或者手动检查点的 immediate force wait。健康系统中,定时检查点占主导。批量加载期间出现 wal 检查点是预期行为。在稳定的生产负载上,提高 max_wal_size,直到这种检查点变得罕见。
检查点进程会在间隔的 90% 时间内分散写入(checkpoint_completion_target,默认 0.9),这样不会猛击磁盘。保持这个值不变。
这是我们的实验服务器在一轮批量加载和手动 CHECKPOINT 之后的状态;它从未运行足够长的时间来触发定时检查点。num_timed 还会统计因为没有任何变化而跳过的定时检查点;PostgreSQL 18 的 num_done 则只统计实际运行的检查点。
重做点早于检查点记录,因为检查点需要一段时间:它从重做点开始,写出脏页,最后才记录完成。PostgreSQL 17 之前,这些计数器位于 pg_stat_bgwriter。从 PostgreSQL 15 起,log_checkpoints 默认开启;当由 WAL 触发的检查点间隔短于 checkpoint_warning(30 秒)时,日志中会出现“checkpoints are occurring too frequently”(检查点发生得过于频繁)的提示。
检查点后的第一次变化会记录整页
Postgres 的页大小是 8 KB,但存储通常只保证 4 KB 的原子写入。断电发生在写入中途时,一个页可能只留下半个新版本和半个旧版本:这就是撕裂页(torn page),任何“把这个元组放到偏移量 46”的小记录都无法修复它。
因此 Postgres 采取了简单而可靠的做法:检查点之后,页第一次发生变化时,它的 WAL 记录会包含该页的完整镜像。恢复会先还原这份整页镜像(FPI),再在其上应用后续记录。这由 full_page_writes 控制,默认开启。保持开启。
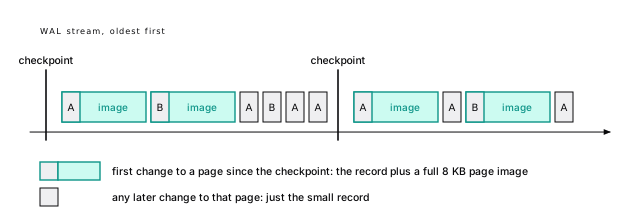
一个实验展示了这项代价:先执行检查点,在 wal_demo 的 3,759 个页上分散更新 1,100 行,然后再次运行同一更新:
同样的行,同样类型的变化。刚执行完检查点时:17.1 MB WAL,几乎全部来自 2,204 个页镜像。第二次运行时,每个页都已经有镜像:384 KB。
同样的工作,WAL 只有原来的四十五分之一。
07-wal在线上系统中,这会形成锯齿形:每次检查点之后,热点页开始写入第一份镜像,WAL 随之跳升,然后逐渐下降。由此得到三条规则:
- **检查点越频繁,WAL 越多。**每次检查点都会重置每个页“已经有镜像”的状态。把间隔减半,可能让随机更新负载的 WAL 接近翻倍,这也是写入繁忙的系统应该提高
max_wal_size和checkpoint_timeout的主要原因。 - **分散写入比集中写入更贵。**在 1,000 个页上执行 1,000 次更新,可能意味着 1,000 个镜像;在 20 个页上执行,则是 20 个。随机 UUIDv4 键(慎选键,少后悔)以及冷更新中的每个索引(冷更新要为每个索引付费)都会付出这项代价。
- **检查点越少,崩溃恢复越久。**这就是下文要说的取舍。
启用校验和后,连读取也会写 WAL
页甚至不必发生普通意义上的变化也可能被写入镜像。读取者会在页上设置提示位,缓存它们从某行事务中了解到的信息(读取可以写入)。启用数据校验和后(从 PostgreSQL 18 起默认开启),检查点后第一次改变页上提示位时,会被记录为整页镜像,否则撕裂页会导致校验和失败。(wal_log_hints = on 在没有校验和时也会做同样的事。)
因此读取也可能写 WAL:刚加载完一张 1,667 页的表后,第一次 count(*) 写入了 1,667 个页镜像,约 13 MB。承担这项代价,因为校验和能捕获静默损坏;但可以安排好这次突发写入的时间(开门营业前先清理并分析)。
插入操作让每一行的提交状态在页上都处于未知状态。select 会查明每一行的提交状态,设置提示位;由于这是检查点之后每个页的第一次变化,它会为每个页记录一份镜像。
07-walwal_compression 花小代价就能见效
如果页镜像占了 WAL 的大头,就把它们缩小。wal_compression 会在整页镜像进入日志前压缩它们(不会压缩普通记录)。它默认关闭。我们在检查点之后运行同一条会产生大量镜像的更新语句,每种设置各运行一次。每次运行前都先做一次预热,使表每次都处于相同布局;这个布局触及的页少于上面的第一次运行,所以镜像也更少:
| wal_compression | fpi | WAL 字节数 | 相对于 off |
|---|---|---|---|
| off | 621 | 4,990,834 | 100% |
| lz4 | 619 | 2,927,214 | 59% |
| zstd | 620 | 1,723,491 | 35% |
镜像数量相同,只是每个镜像更小。代价是写入端压缩以及副本和恢复过程解压缩所需的 CPU。在任何有真实写入流量的服务器上,都打开其中一个:更少的 WAL I/O、更少的副本网络流量、更小的归档。页能压缩到什么程度取决于其中的内容,所以测量自己的数据。
取值可以是 off、pglz(也接受 on),以及 lz4 和 zstd(PostgreSQL 15+,前提是服务器构建时包含它们)。超级用户可以按会话设置它,所以你可以在一个会话中尝试每个值。先运行一次预热,让每次运行都从相同的表布局开始:
07-wal提交意味着刷新
现在回到开头的数字。默认 synchronous_commit = on 时,COMMIT 只有在截至其提交记录的 WAL 全部写出并执行了 fsync 后才会返回。这次刷新就是每个写事务的延迟下限。以下是 pgbench 中每次插入一行的循环,每次运行十秒:
| synchronous_commit | 客户端数 | 每秒提交数 | 平均延迟 |
|---|---|---|---|
| on | 1 | 130 | 7.7 ms |
| on | 8 | 1,243 | 6.4 ms |
| off | 1 | 16,507 | 0.06 ms |
| off | 8 | 91,740 | 0.09 ms |
这些数字来自那台 7.7 ms 的虚拟机;优秀服务器的存储刷新时间远低于一毫秒(时间都花在哪里)。但整体形状到处都成立:
- 只有一个客户端时,每秒提交数大致等于 1 除以 fsync 时间。CPU 工作只是噪声。
- 八个客户端时,吞吐量增至近十倍,而延迟没有上升。这就是组提交(group commit)。
- 不等待刷新时,一个客户端就快一百多倍。
07-wal许多提交可以共享一次刷新
一个后端进程等待 fsync 时,其他进程会把自己的提交记录排在它后面;下一次刷新就会覆盖所有这些记录。一次 fsync,许多次提交,不需要打开任何开关。
对你的代码而言,提交次数比行数更重要。10,000 次自动提交插入要付出 10,000 次刷新;放在一个事务中只需一次(每次提交都等待磁盘)。因此 ORM 导入可以在用事务包住它之后,从二十分钟降到二十秒(每批提交一次,而不是每行提交一次)。
synchronous_commit = off 可能丢失约 600 ms 内的提交
设置 synchronous_commit = off 时,COMMIT 会在提交记录进入 WAL 缓冲区后立即返回,WAL 写进程会在最多 wal_writer_delay 的三倍时间内刷新它:默认 200 ms 时约为 600 ms。如果机器崩溃,这个时间窗口内报告成功的提交可能消失(一次真实崩溃带走了三个已确认的提交会观察其中三个提交消失)。数据库会一致地恢复到稍早一点的状态,不会因此损坏。
这个设置可以按事务调整:支付事务保持开启,记录分析事件的事务则可以关闭:
适合的候选包括:遥测、在别处留有副本的日志、缓存、心跳。凡是已经告诉用户“完成”的事情,都不要这样做。也不要把它和 fsync = off 混淆,后者可能损坏整个集簇(fsync = off 和 full_page_writes = off 只能用于 CI)。
有副本时,synchronous_commit 还接受 local(不等待任何同步备库)、remote_write、on 和 remote_apply;它们分别等待同步备库到达更进一步的阶段。没有同步备库时,它们的行为都像 local(同步提交要付出一次往返)。
组提交能帮上多大忙取决于磁盘:在一台繁忙的共享服务器上,我们见过的提升更接近 2.5 倍,而不是 10 倍。commit_delay 和 commit_siblings 试图让每次刷新聚集更多提交;在现代硬件上它们很少有帮助。
恢复只做重做
假设机器断电。启动时,Postgres 找到上一个检查点的重做点(上面的图),然后从那里向前重放 WAL。页镜像会被直接恢复,从而修复撕裂写入。提交记录成功落盘的事务会被视为已提交;其余事务算作已中止,它们的行版本保持不可见,留待清理。
恢复不会撤销任何东西。它只做重做,这也是它可靠的部分原因。
恢复时间取决于重做点到崩溃之间的 WAL 量,而这段 WAL 的量大致受 max_wal_size 限制。重放 1 GB 通常只需几秒;几十 GB 则需要几分钟。这就是取舍:检查点越少,页镜像越少,重启越久。每 15 到 30 分钟一次检查点适合大多数系统。
- 读取
pg_control,找到上一个检查点及其重做点。 - 从重做点读取 WAL。用每份整页镜像覆盖磁盘上的现有内容。对于其他记录,如果页的 LSN 已经比该记录更新,则跳过;否则应用该记录。
- 在有效 WAL 末尾停止;每条记录上的校验和会识别这个位置,即使最后一次写入只完成了一部分。
- 把重放过提交记录的事务视为已提交,其余视为已中止。
- 运行一次检查点,然后接受连接。
WAL 是其他一切的基础
一份记录每个变化的有序日志,几乎不增加额外成本就能给你:
- **流复制。**副本是一台永久处于崩溃恢复状态的服务器,随着主库写入 WAL 而重放它(权威数据的副本)。
- **时间点恢复。**基础备份加上其后的每个归档段,就能恢复到任意时刻(未经验证的备份只是传闻)。
- **逻辑解码。**设置
wal_level = logical后,WAL 携带足够的信息,可以为其他数据库或队列解码行变化。更改wal_level需要重启,所以要尽早决定。
MySQL 有重做日志、二进制日志和双写缓冲区。Postgres 用一份日志承担这三项工作;整页镜像发挥了双写缓冲区的作用(Postgres 不是 MySQL)。
三件事会让旧 WAL 留到磁盘塞满
有三件事会让 Postgres 保留旧段,而且每一件都曾填满生产环境的磁盘:
- **归档失败。**如果
archive_command持续失败,段文件就会堆积。 - **无人消费的复制槽。**复制槽会一直保留 WAL,直到消费者收到它;废弃的复制槽会永远保留 WAL(复制槽是保留 WAL 的承诺)。
max_slot_wal_keep_size可以限制它;默认无限制。 - 有意设置得很高的
wal_keep_size。
一个不活跃且 retained_wal 不断增长的复制槽,就是正在发生的磁盘耗尽事故。复制槽也会阻止清理(清理无法移除旧快照可能需要的内容)。
当 WAL 填满磁盘时,不要从 pg_wal 删除旧文件。如果其中有文件仍是恢复所需,数据库将无法再启动。修复原因(修好归档命令、删除废弃的复制槽或增加磁盘),Postgres 会在下一个检查点自行移除这些段。
先找出 WAL 的来源,再削减它
当 WAL 量成为瓶颈(副本延迟、归档增长、pg_wal 填满磁盘)时,先测量:pg_stat_wal 提供包括 wal_fpi 在内的集簇总量。如果页镜像占主导,就修检查点和压缩;否则就检查索引和更新。大致按影响排序,手段如下:
- 用更大的
max_wal_size拉开检查点间隔。 - 打开
wal_compression。 - 删除未使用的索引(idx_scan 为零是嫌疑,不是判决)。
- 让更新保持 HOT(让更新保持 HOT)。
- **使用具有局部性的键:**用 bigint identity 或 UUIDv7,不要用随机 UUID。
- **不要更新没有变化的行。**无操作更新仍然会写入一个行版本。
- 可丢弃的数据使用不记日志表(unlogged table),它们跳过 WAL,并在崩溃后被清空(先不记日志,再 SET LOGGED,只是转移 WAL 的写入时机)。
同样插入 10,000 行到 wal_demo 的不记日志副本中,写入的 WAL 不到记日志表的 1%。而 update wal_demo set kind = kind where id <= 1000 什么都没有改变,却仍然写入了超过 50,000 字节:每行一个新版本,并且写入了日志。
07-wal本章要点
- 每次变化都会先进入 WAL,再写入数据页。提交记录刷新后,提交就具有持久性;这次刷新是每次写入的延迟下限。
- 用
explain (analyze, wal)测量一条语句的 WAL;LSN 差值测量的是整个集簇。 - 检查点后的第一次页变化会写入完整的 8 KB 镜像:同一个更新 1,100 行的操作,刚过检查点时花费 17.1 MB,片刻后只花费 384 KB。
- 使用数据校验和(PostgreSQL 18 默认开启)时,设置提示位也可能写入页镜像,所以连读取也可能生成 WAL。
- 优先使用定时检查点:提高
max_wal_size,直到 WAL 触发的检查点变得罕见,并接受更长的崩溃恢复时间。 - 打开
wal_compression = lz4或zstd;在这里它把镜像密集型 WAL 降到了 59% 和 35%。 - 减少提交次数,而不是减少行数。对可丢弃的写入,按事务设置
synchronous_commit = off是合理取舍:可能丢失最近约 600 ms 的提交,但不会失去一致性。 - 监控复制槽和归档,永远不要手动删除
pg_wal中的文件。
延伸阅读
- Write-Ahead Logging (WAL),PostgreSQL 文档。关于预写规则及其作用的官方说明。
- WAL configuration,PostgreSQL 文档。检查点如何触发和调度,以及检查点日志行的含义。
- Write Ahead Log settings,PostgreSQL 文档。本章中的每个开关:
full_page_writes、wal_compression、synchronous_commit和检查点。 - Asynchronous commit,PostgreSQL 文档。准确说明
synchronous_commit = off可能丢失什么,以及它与fsync = off的区别。 - src/backend/access/transam/README,PostgreSQL 源码。开发者对 WAL、检查点和预写规则的自述。
- ARIES: A Transaction Recovery Method,Mohan 等,ACM TODS,1992 年。关于预写式恢复的经典论文;Postgres 选择了它所描述的设计空间中“只做重做”的一角。
9 如实看待 ACID
我们提交了三行,三次都收到 COMMIT 返回,然后杀掉服务器,再把它启动起来,结果那些行不见了。Postgres 的工作方式完全符合配置。一个会话设置 synchronous_commit = off 用这些行换来了速度,而这项取舍从头到尾都写在文档里。
ACID 常被当成一枚徽章:数据库“是 ACID 的”,所以数据就是安全的。其实它是四项彼此独立的承诺,每项都由一种具体机制兑现,都有代价,都有可以关闭它的开关,也都有它止步的边界。Postgres 支持的系统中,大多数数据丢失发生在这些边界上,而不是四项承诺的内部。
四项承诺,四种机制
下面这张表概括了整章。后文会逐行证明它。
| 字母 | 由什么保证 | 代价 | 由什么关闭 | 止于 |
|---|---|---|---|---|
| 原子性 | 行版本、pg_xact 状态 | 每次中止留下死元组 | 自动提交 | 你的事务边界 |
| 一致性 | 你的约束 | 每次写入都要检查 | 不声明约束 | 跨行规则 |
| 隔离性 | 快照、锁、SSI | 等待、重试 | 读已提交 | 你选择的级别 |
| 持久性 | 提交时刷新的 WAL | 每次提交都要刷新 | synchronous_commit、fsync、会撒谎的磁盘 | 这台机器的磁盘 |
它们彼此独立地失效,所以我们一次讲一项。
原子性:从来没有真正撤销什么
原子性意味着事务要么完整发生,要么完全不发生。你可能会想象一份撤销日志:回滚时,数据库把旧值放回去。
Postgres 没有撤销。回滚根本不碰表。
回滚会让行留在页上
每个行版本都带有创建它的事务 ID(xmin),而它是否计入结果,取决于提交日志 pg_xact 对该事务的记录(更新就是插入)。它就像支票登记簿:一张被取消的支票不会被擦掉,而是盖上 VOID 印章。
向一个保存账户余额的小型 credits 表插入三行,然后回滚。pageinspect 仍然能在页上找到这三个元组,逐字节都和插入时写入的一样,而 pg_xact_status() 会说它们的事务是 aborted。pg_xact 中的两个位是唯一把它们藏起来的东西。每个读取它们的查询都会检查这个状态并跳过它们;在清理移除它们之前,它们会一直留在那里。
回滚就是这么回事:翻转一个状态,把残局留给以后处理。这就是为什么回滚一行和回滚一千万行耗时相同。
失败的语句什么也没改变,却仍然要付出代价
原子性也适用于每条语句。给每个账户扣 10 个积分,而最后一行的账户 1000 只有 5 个积分:
什么都没有改变:999 个余额仍然是 100。但这条更新在碰到第 1000 行之前,已经写入了 999 个新行版本,而它们全都还在表里,成了死元组:
表从 6 页增长到 11 页,一条什么也没改变的语句还写入了超过 100,000 字节的 WAL。一次失败的批量更新,其 I/O 成本大致和成功更新相同,并留下相当于整张表数据量的死元组,等待 清理。一个在最后一行失败、每五分钟重试一次的批处理任务,就是一台制造膨胀的机器。
很可能失败时,应在写入前先验证(例如使用 where balance >= 10,或先执行检查查询);大规模变更要分批执行,这样失败浪费的是一个批次,而不是整张表。在事务内部,保存点可以在更细的粒度上提供同样的全有或全无效果(保存点可以把损失控制在局部)。
08-acid手工运行失败的更新时,死元组数量可能略低于 999:之后读取一个几乎填满的页时,可能会提前剪枝掉一些已中止的行版本(页内剪枝要等到页接近填满)。实验会保持一个更早的快照打开,从而让数量精确。第一次读取已中止事务的元组的查询还会把判定缓存为提示位 HEAP_XMIN_INVALID,后续读取者就会跳过 pg_xact 查询(读取也可能写入)。
08-acid提交只是一个很小的记录
那么,是什么让一个事务变成已提交?是 WAL 记录很小,页镜像却不是中的 34 字节 COMMIT 记录:写入它,让 WAL 刷过它,在 pg_xact 中把事务标记为已提交,然后让它变得可见。刷新返回的那一刻,就是提交发生的时刻。刷新后一微秒服务器崩溃,恢复会重放这条记录,提交仍然成立;早一微秒,事务就从未发生过(恢复只做重做)。回滚的 ABORT 记录甚至不会刷新:没有提交记录的事务本来就会被视为已中止。
一致性是由你写出的部分
C 是四个字母中最特殊的一个。原子性、隔离性和持久性是数据库负责提供的东西。一致性意味着“事务把数据从一个有效状态带到另一个有效状态”,而“有效”由你定义:not null、check、unique、外键和排他约束(有目的地选择约束是它们的归宿)。Postgres 只会严格执行你声明的规则,不会多执行一条。
约束按语句触发,或在提交时触发
Postgres 在写入每一行时检查大多数约束,并在每条语句结束时检查外键。声明为 deferrable initially deferred 的唯一约束、主键、外键或排他约束会改为等到 COMMIT 时才检查,因此一个事务可以先插入发票明细,再插入发票。如果发票始终没有出现,COMMIT 就会失败。(check 和 not null 不能延迟检查。)
所以 COMMIT 可能失败。延迟约束、串行化失败和连接丢失都可能在这里暴露;而在之前已经出现过任何错误后,COMMIT 会悄悄返回 ROLLBACK(一个错误会中止整个事务)。忽略 commit 返回结果的代码会告诉用户数据已经保存,实际却没有。
插入成功了;COMMIT 失败,什么也没有保留下来。在提交前插入发票 777,同一个事务就能顺利提交。
跨行规则对约束不可见
大多数真实业务规则都跨越多行:“免费账户最多有 3 个席位”“借方等于贷方”。check 约束只能看到正在写入的那一行,所以通常下一步是写一个触发器,统计该账户的席位数,在达到 3 个时抛出异常。
一次只处理一个请求时,它确实有效。现在,两个请求同时给一个已有 2 个席位的账户添加席位。因为另一个插入还没有提交,两个触发器各自看到的都是 2。两边都提交后,账户有了 4 个席位,而触发器从未抛出异常。
代码没有错。一个会读取其他行的规则,其保证强度不会超过所用隔离级别的保证。 有三种修复方式,按强度从高到低排列:
- 把它变成约束。“不能有两行冲突”可以用排他约束表达(排他约束让重叠变得不可能);数量上限也可以改成约束:用
seat_number表示席位编号,用check (seat_number between 1 and 3)约束它,再用unique (account_id, seat_number),就能把席位数封顶为 3。 - 让写入者在可串行化级别下运行,这样其中一个会因为可重试错误而中止。
- 在父行上串行化:在触发器开头执行
perform 1 from accounts where id = new.account_id for no key update。使用for no key update,不要使用for update:for update还会阻塞向任何表插入且引用该账户的行时所进行的外键检查,而且会一直阻塞到触发器所在的事务结束。
触发器,以及实验用来与它制造竞态的代码:
08-acidCHECK 中的子查询会直接被拒绝(cannot use subquery in check constraint)。把它包进函数可以绕过解析器,但随后它会欺骗你。Postgres 假定一行的检查结果不会改变,因此不会在其他行发生变化时重新检查;之后的转储和恢复可能会因为某些行不再通过检查而失败。
在分布式系统里,“一致性”还指另一件事。在 CAP 和复制语境中,它说的是每个副本是否都返回最新写入;ACID 中的 C 说的是你的规则是否成立。一个副本完全符合 ACID 的一致性,却仍然可能落后数秒(写入之后,副本可能显示旧值)。
隔离性是一个旋钮,不是一项保证
隔离性决定你能看到并发事务的哪些影响。理想情况是,事务表现得仿佛它们是一个接一个运行的。Postgres 能提供这种效果,但要付出代价,而且默认设置更弱。下面是这个模型;有目的地选择隔离级别会从实践角度展开。
只有可串行化能排除所有异常
异常是指某个结果不可能由这些事务的任何串行顺序产生。SQL 标准用其中三种异常定义了各个级别;Berenson 等人在 1995 年指出,这份清单并不完整。Postgres 在各级别下的行为如下:
| 异常 | 读已提交 | 可重复读 | 可串行化 |
|---|---|---|---|
| 脏读:看到未提交的数据 | 从不 | 从不 | 从不 |
| 不可重复读:两次读取之间一行发生变化 | 会 | 从不 | 从不 |
| 幻读:出现新的匹配行 | 会 | 从不 | 从不 |
| 丢失更新:读取、计算、覆盖 | 会,且悄悄发生 | 错误(40001) | 错误(40001) |
| 写偏差:两边读取,各自写入不同的行 | 会 | 会 | 错误(40001) |
| 只读异常:读取者看到不可能的状态 | 会 | 会 | 错误(40001) |
- 任何级别都没有脏读。 Postgres 接受
read uncommitted,但给你的实际是读已提交。 - 读已提交每条语句取一个快照,可重复读每个事务取一个快照(快照会选定一个版本)。请求处理器需要前者。运行五条查询再把结果相加的报表,则需要后者,否则各项合计无法对上。
- 只有可串行化能捕获表格最后两行所说的异常,做法是让你重试。丢失更新和写偏差在读已提交会丢失在应用中计算的更新和可串行化能捕获可重复读漏掉的写偏差中演示。最后一种异常放在这里讲。
只读事务也可能看到不可能的状态
这是最让人意外的一种异常,因为受害者从头到尾没有写入任何东西。计费按周期运行。一行控制记录保存当前周期;费用都记录在这个周期上;月底有人通过递增周期号来关闭当前周期,报表则汇总已关闭的周期。这里有三个事务:
在可重复读级别下,一切都会成功。T3 报告说周期 1 最终有 3 笔费用,总额为 600。随后 T1 把自己的费用提交到周期 1;此时周期 1 已经有 4 笔费用,总额为 700。没有任何串行顺序能产生这个结果:如果 T1 在 T2 之前运行,报表就会包含它的费用;如果在 T2 之后运行,这笔费用就会落到周期 2。
在 serializable 下,报表仍然得到相同的 3 笔费用,但 T1 的提交会失败,并提示 could not serialize access due to read/write dependencies among transactions。T1 重试,读取到周期 2,费用也就落在了应该在的地方。没有任意两个事务写入同一行,所以只有会追踪读取的隔离级别才能捕获它。
08-acidPostgres 用可串行化快照隔离(serializable snapshot isolation)实现可串行化级别(Ports 和 Grittner,2012)。每个事务都在一个快照上运行,与可重复读完全相同,同时还会把它读取的内容记录为不阻塞的 SIReadLock 条目。当一个事务写入并发事务读取过的东西时,就形成了读写依赖。每个串行化异常都需要一个“枢轴”:它既有传入依赖,又有传出依赖的事务。Postgres 发现这种情况时,会以 SQLSTATE 40001 中止一个事务。没有人被阻塞,但有人必须重试。这里 T1 就是枢轴:报表在 T1 添加费用前读取了周期 1 的费用,这是进入 T1 的依赖;T1 读取了之后被 T2 改动的周期,这是离开 T1 的依赖。被取消的是 T1,错误消息也明确这样说:Reason code: Canceled on identification as a pivot, during commit attempt.
这套记账比较粗:它可能跟踪整页或整个关系,而不是具体行,因此会有误报;代价确实存在,但通常不算大。对于长时间运行的报表,begin isolation level serializable read only deferrable 会等待,直到它能取得一个不可能参与任何异常的快照,然后在不进行追踪的情况下运行,也就不再会因这类串行化异常而失败。
持久性就是一次 fsync
持久性意味着已提交的事务能在崩溃后存活:提交记录在 COMMIT 返回前已经到达磁盘。提交意味着刷新已经测量过这项代价:每次提交都要一次 fsync;在刷新耗时 7.7 ms 的磁盘上,单个客户端每秒大约只能提交 130 次。现在我们故意把它破坏掉。
synchronous_commit = off 会丢失一个窗口
设置 synchronous_commit = off 后,COMMIT 会在记录刷新前返回,因此一次崩溃最多可以带走大约 600 ms 内已经确认的提交(synchronous_commit = off 可能丢失约 600 ms 内的提交)。风险是丢失,绝不是损坏。微妙之处在于:事务在持久化之前就已经可见。其他会话可以读取它的行,根据这些行采取行动,甚至发送相关邮件,然后崩溃会把这些行抹掉。
一次真实崩溃带走了三笔已确认的提交
本章实验会启动自己的服务器,这样就能杀掉它。实验把 wal_writer_delay 设为 10 秒(最大值),以扩大这个窗口,在 synchronous_commit = off 下提交三行,并确认它们的 WAL 仍然只在共享内存中。然后向容器发送 SIGKILL:不会有关闭检查点,也不会有最后一次刷新。重启时,恢复会重放到有效 WAL 的末尾,执行 select count(*) from crash_test 得到 0。
三笔已经确认的提交,就这样消失了。用默认的 synchronous_commit = on 做同样的插入,再执行同样的杀进程操作,重启后会看到三行都回来。把 wal_writer_delay 设为 1 秒时,在杀进程前超过 3 秒就已经提交的行也能存活。这个窗口确实存在,而且宽度正如文档所说。
所以,只在事务级别使用它,而且只用于可以丢失的写入。
重启日志说明了一切:
“got 0” 表示有效 WAL 的末尾,不是错误。实验知道提交仍在内存中,因为 pg_current_wal_lsn()(WAL 已写出的距离)落后于 pg_current_wal_insert_lsn()(WAL 已生成的距离)。
杀掉容器杀掉了 Postgres,而宿主机的内核仍在运行。Postgres 已经通过 write() 交给操作系统、但还没有用 fsync() 强制刷到磁盘的内容,仍然停留在内核的页缓存中,并因此存活下来。这就是为什么实验要检查 WAL 在杀进程前甚至还没有被写出。
真正的断电还会带走页缓存,随后也会带走磁盘自己的缓存。要测试这一点,需要拔电源,或使用可以硬重置的虚拟机,以及为此设计的工具(文档指向 diskchecker.pl)。我们的测试展示的是 COMMIT 返回与 WAL 离开 Postgres 内存之间的窗口。低于这条线的部分属于操作系统和硬件的职责,而它们也可能在这里失效。
08-acid.shfsync = off 和 full_page_writes = off 只能用于 CI
两个设置会移除整台服务器的持久性。fsync = off 会停止让 Postgres 强制把任何东西写入磁盘,电源故障可能让数据文件和 WAL 彼此不一致,造成文档所说的“unrecoverable data corruption”(不可恢复的数据损坏)。full_page_writes = off 会丢弃用于修复撕裂页的页镜像(检查点后的第一次变化会记录整页),只有在不会撕裂 8 KB 写入的存储上才安全,例如 ZFS。两者都会让基准测试看起来很漂亮。把它们用于一次性的 CI 数据库,除此之外不要使用。
fsync 只有在磁盘诚实的时候才可靠
fsync 只有在磁盘说“完成”时确实说了实话才有用。许多消费级磁盘在写入自己的易失缓存后就确认写入,而断电会把该缓存抹掉。使用带掉电保护的存储,在该卷上运行 pg_test_fsync,并对快得超过硬件物理能力的刷新保持怀疑(时间都花在哪里)。
还要保持数据校验和开启(从 PostgreSQL 18 起,这是 initdb 的默认设置)。磁盘或控制器翻转的一位会变成错误,而不是静默地产生错误的行。校验和能检测损坏;备份负责修复它(有校验和时,连读取也会写 WAL解释了它们的 WAL 成本)。
2018 年,Postgres 开发者发现,在 Linux 上失败的 fsync() 可能只报告一次错误,随后却把脏页标记为干净;于是重试会在数据尚未到达磁盘时“成功”。从那以后,Postgres 会把数据文件上的 fsync 失败当作崩溃(PANIC),并从 WAL 恢复,而不是相信重试;这一改动随 PostgreSQL 12 发布,并回移到了当时仍受支持的版本(Fsync Errors)。
pg_upgrade 要求校验和设置一致,因此,把一个没有校验和的旧集簇迁移到全新的 18 集簇,需要使用 initdb --no-data-checksums,或者先在旧集簇离线时用 pg_checksums 启用校验和。校验和只保护数据页,不保护内存或内部结构。
这里持久,不等于处处持久
前面讲的所有内容都只涉及一台机器的磁盘。使用默认的异步复制时,提交会在主库刷新完成后返回,副本稍后才收到它。在这段时间内故障切换,用户已经看到成功的提交就会消失,而新的主库仍然完全一致(异步是默认设置,而且可能丢失提交)。同步复制会用每次提交一次网络往返的代价关闭这个窗口(同步提交的代价是一次往返)。
在事故替你决定之前,先用一个数字决定:你最多能承受丢失多少笔已经确认的提交。
ACID 止于一个数据库中的一个事务
上面的每项保证都有同一个边界:一个数据库中的一个事务。你的业务操作却很少尊重这个边界。
自动提交会把一个操作拆成两个
从账户 1 向账户 2 转移 30 个积分,是一个业务操作。如果不写 begin,而是直接写两条语句,那就是两个事务;许多 ORM 默认就是这样工作的:每个 save() 都是一次独立提交。若应用在两条语句之间崩溃:
sum(balance) 恰好减少了 30。30 个积分消失了,但没有任何数据库保证被破坏:每条语句都具备原子性、一致性、隔离性和持久性。出问题的是这个操作,因为没人告诉数据库它们属于同一件事。把它们包在 begin 和 commit 中,同样的崩溃会让全部操作回滚。
每个业务操作都要放进一个显式事务,并弄清你的 ORM 默认做什么。事务要保持短小:不要在其中执行 HTTP 调用,也不要在其中等待用户,因为打开的事务会持有锁,并且拖住清理。
08-acid两阶段提交很少是答案
当一个操作跨越两个数据库时,教科书式的答案是两阶段提交。Postgres 支持其中属于自己的一部分(prepare transaction,然后 commit prepared),但一个已准备事务不属于任何会话:如果协调器死亡,它会在重启后继续存在,持有锁,也拖住清理。这就是 max_prepared_transactions 默认值为 0 的原因。而消息代理、支付 API 或邮件服务根本不支持两阶段提交。
SIGKILL 并重启后,transfer-42 仍然位于 pg_prepared_xacts 中,它插入的行仍然不可见,对第 1 行的更新仍然会等待它持有的锁。如果启用这一功能,就要对 pg_prepared_xacts 中存在超过一分钟的任何行设置告警(清理无法移除旧快照可能需要的内容)。
08-acid.sh把消息和订单放进同一个事务
这里有一个几乎每个应用都会踩到的情况。下订单会写入订单,并为其他服务发布一条“订单已下达”消息。因为涉及两个系统,无论先做哪一个,两个动作之间的崩溃都会让它们互相矛盾:订单没有任何人知道,或出现了一条关于不存在订单的消息。
解决办法是停止向两个系统写入。把消息写进一张表,并让它和订单处于同一个事务中,再由另一个进程负责投递:
现在,原子性同时覆盖了订单和消息:两者要么一起提交,要么都不提交。中继进程在同一个事务中,用for update skip locked认领一批消息,发布它们,再删除已经发送的消息。这个事务是“不要在事务中进行网络调用”这条原则唯一有意保留的例外:批次要小,并为中继角色设置 idle_in_transaction_session_timeout,这样卡住的代理就不会让事务一直打开。
如果中继在发布消息后、delete 提交前死亡,下一个中继会再次发送这些消息。这就是至少一次投递,代价是消费者要按消息 ID 去重。它总好过“消息有时会丢”。邮件和扣款也可以使用同样的形状:在事务中记录意图,提交后执行动作,并让动作可以安全地重复(重试整个事务)。
skip locked 让多个中继可以并行运行,而不会重复认领(Postgres 队列和业务写入一起提交)。实验中,两个中继同时各请求 5 条消息,会得到 10 条不同的消息。在非常高的吞吐量下,逻辑解码可以直接从 WAL 读取 outbox 插入,而不是轮询;但对大多数应用来说,轮询中继已经足够走很远。
08-acid本章要点
- 回滚什么也不会撤销:已中止事务的行版本会留在页上,直到清理。失败的语句仍然会写入它处理过的行和 WAL,并留下膨胀。
- 事务在提交记录刷新完成的那一刻提交。检查每一次
COMMIT的结果。 - 一致性只包含你声明的规则。读取其他行的检查存在竞态;应使用约束、可串行化级别,或锁住父行。
- 读未提交实际上是读已提交。只有可串行化能捕获写偏差和只读异常,而且需要重试。
synchronous_commit = off可能丢失约 600 ms 内已经可见且已确认的提交。按事务使用它,而且只用于可以丢失的数据。- 生产环境永远不要使用
fsync = off或full_page_writes = off。使用带掉电保护的存储,并保持校验和开启。 - 一次提交只在一台机器上持久。使用异步副本时,故障切换可能丢失已确认的提交;在事故替你做决定前,先选定可以丢多少。
- 每个业务操作都放进一个显式事务。要通知另一个系统,就在同一个事务中写入 outbox 行,再由中继投递。
延伸阅读
- Transaction isolation,PostgreSQL 文档。各隔离级别的确切保证,包括可串行化级别的只读可延迟模式。
- Reliability,PostgreSQL 文档。持久提交对磁盘、缓存和控制器的要求,以及测试方法。
- Asynchronous commit,PostgreSQL 文档。
synchronous_commit = off的风险窗口,使用开发者自己的表述说明。 - A Critique of ANSI SQL Isolation Levels,Berenson、Bernstein、Gray、Melton、O’Neil 和 O’Neil,SIGMOD 1995。指出标准异常清单不完整,并定义快照隔离的论文。
- Serializable Snapshot Isolation in PostgreSQL,Ports 和 Grittner,PVLDB 2012。由实现者说明 Postgres 的可串行化级别如何工作。SSI wiki 页面中有本章改写的批量关账示例。
10 清理不可省
迟早你会看到一张表不断变大,而 pg_stat_user_tables 却显示自动清理一小时前才运行过。你已经知道增长从哪里来:每次更新和删除都会留下一个死行版本(更新就是插入)。本章讲的是本该清理这些遗留物的进程,以及它为什么有时做不到。
清理跟得上时,没有人会注意。表不断变化,却保持原来的大小。清理还会防止事务 ID 耗尽,让仅索引扫描正常工作,并保持统计信息新鲜。清理落后时,表会膨胀,查询会读取不该读取的页;最糟糕的情况下,数据库会停止接受写入。
清理是 Postgres 中唯一一个所有人都会忽略、直到它成为所有人唯一谈论的事情的部分。趁还没到那一步,先弄懂它。
用 pgstattuple 测量死元组
先测量,从同一个 pgstattuple 开始;它曾观察到 清理释放表内空间、而不是磁盘空间中的 users 变成两倍大。这次的表是 vac_demo,它是前 500,000 行 events 的副本,并且关闭了自动清理。更新每两行中的一行,然后查看:
同样是 500,000 个活行,另外还有占表 31% 的 250,000 个死行。原本紧密排列的页没有空间容纳新版本,所以新版本被写到末尾的 4,807 个新页中。现在每次顺序扫描都会多读取 55% 的页。
pgstattuple 很精确,但会读取整张表。对于大型生产表,使用会跳过全可见页的 pgstattuple_approx(),或者使用 n_live_tup 和 n_dead_tup 这两个低成本估算值,它们位于 pg_stat_user_tables 中。
09-vacuum清理要做五件事
清除这 250,000 个死行只是清理工作的第一项。普通 VACUUM(不是 VACUUM FULL)会在原地工作,只取得一个 SHARE UPDATE EXCLUSIVE 锁,既不会阻塞读取,也不会阻塞写入。它沿着固定路线运行:遍历表,然后遍历每个索引,再次遍历表。
InnoDB 的后台清理线程会从撤销日志中清除旧行版本。Postgres 的旧版本存在表中,因此清理要在堆和每个索引上完成清除工作;还有一个 InnoDB 没有的风险:事务 ID 回卷(Postgres 不是 MySQL)。
1. 移除死行版本
当删除或替换该行的事务已经提交,并且没有仍在运行的事务可能还需要它时,一个行版本就是死亡的。清理会计算这个边界,也就是只有没有快照能看到版本时,版本才算死亡中介绍的 xmin 清理界限(xmin horizon);清理输出把它称为可移除截点(removable cutoff):任何当前快照可能还会关心的最老事务 ID。记住“已死亡但尚不可移除”这句话。这是清理输出中最重要的一行。
索引按位置指向堆元组(TID,即一个 (page, slot) 地址),所以清理会分阶段移除死版本。它先剪枝每个堆页,并把死 TID 收集到内存中;然后完整扫描每个索引,删除指向这些 TID 的条目;最后释放堆槽位。每个索引都会放大清理成本。(普通查询经过页时也会剪枝页:页内剪枝要等到页接近填满。)
死 TID 存放在 maintenance_work_mem(或 autovacuum_work_mem)中。如果放不下,清理就执行一次索引遍历,清空这份列表后继续,因此内存太少意味着要对每个索引执行多次完整扫描。详细输出中的 index scans: 1 表示扫描一次。PostgreSQL 17 用紧凑得多的结构替换了 TID 数组,并取消了 1 GB 上限,所以在 17+ 上这种情况很少见。在更早的版本中,要给清理分配足够的内存,让 index scans: 保持为 1。
2. 记录空闲空间
释放的空间会进入空闲空间映射(FSM),这样后续写入会填充已有页,而不是扩展文件(插入会找到空间,而不用扫描表)。清理让空间变得可复用,而不会让文件变小。
清理之后,vac_demo 仍然有 13,601 页,但死元组变成了零,空闲空间从 0.6% 上升到 31.7%。随后我们插入了 100,000 行。一页都没有增加;空闲空间降到了 19.3%。
这就是你想要的稳态:表不断变化,却保持相同的大小。这个循环一旦断开,得到的就是膨胀。
09-vacuum3. 截断末尾的空页
只有在末尾的整页都为空时,普通清理才会缩小文件;它会短暂取得一个 ACCESS EXCLUSIVE 锁,把这些页截掉。删除按时间排序的表中最新的一半行,再运行清理,文件会缩小一半。删除最老的一半行时,空间会留在文件前部:可以复用,却永远不会归还给操作系统。
events 按时间排序,因此最新的一半位于文件末尾。截断锁持续时间很短,但副本会重放它,这可能造成可见的停顿。可以按表通过存储参数 vacuum_truncate 禁用,也可以在单次运行中使用 vacuum (truncate false) 禁用;PostgreSQL 18 还新增了服务器级别的 vacuum_truncate 设置。
09-vacuum4. 冻结旧元组
事务 ID(XID)存储在 32 位中,大约有 43 亿个值,计数器会像里程表一样回卷。因此 Postgres 会在一个圆环上比较 XID:对于任意一个 XID,大约 21 亿个在“过去”,21 亿个在“未来”。如果某个元组的插入 XID 比计数器落后超过 21 亿,它突然就会看起来像来自未来,并从所有查询中消失。这就是事务 ID 回卷。
冻结可以防止它。一旦元组的插入事务老到每个快照都能看到它已经提交,清理就会把元组标记为已冻结:对所有人可见,永久如此,不受计数器当前值影响。每张表的 relfrozenxid 表示其中所有更老的 XID 都已被冻结,而 age(relfrozenxid) 表示它落后了多少个 XID,这个值绝不能接近 20 亿。清理不会费心冻结比 vacuum_freeze_min_age 更年轻的行(5,000 万个事务);vacuum (freeze) 会立即冻结当前能冻结的一切。元组全部冻结的页会在可见性映射中标记为全冻结,因此后续清理再也不用读取它。
这是 更新就是插入中那个三行的 account_usage 表,只是这次显式冻结了它:
HEAP_XMIN_FROZEN 是“已提交”和“无效”两个提示位同时设置的状态,这种组合在其他情况下没有意义。原始 t_xmin 仍然保留,便于调试,但之后不再查询它;relfrozenxid 跳到当前值,可见性映射把该页标记为全可见和全冻结。正常运行时永远不需要 vacuum (freeze);下面的设置会决定自动清理何时完成冻结。
5. 维护可见性映射
可见性映射(VM)为每个堆页保留两位:全可见和全冻结(每页两位,让扫描和清理跳过工作)。清理设置它们;对页的任何修改都会清除它们。仅索引扫描会跳过全可见页的堆,清理会跳过全可见页,冻结清理会跳过全冻结页。
所以只追加的表也需要清理。它们不会有行死亡,但没有清理,它们的页就永远不会变成全可见(无法进行仅索引扫描),也不会变成全冻结(于是某天一次巨大的防回卷清理会同时冻结整张表)。而且 vacuum (analyze) 会在这里顺便刷新规划器统计信息。
tuples: 是工作 1;其中 dead but not yet removable 的数量是需要关注的那一行;index scan needed 是工作 1 的索引遍历;pages: 0 removed 表示工作 3 没有找到可截断的内容;frozen: 是工作 4;visibility map: 是工作 5。工作 2 的空闲空间只会出现在 pgstattuple 中。
自动清理会因死行、插入或年龄而触发
自动清理启动器每分钟唤醒一次(autovacuum_naptime),并在任何一张表超过以下三个阈值之一时启动一个工作进程;工作进程最多为 autovacuum_max_workers 个(默认 3 个):
- 死元组。
n_dead_tup超过autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * reltuples:50 加上活行的 20%。PostgreSQL 18 会把它限制在autovacuum_vacuum_max_threshold(1 亿)以内。 - 插入(PostgreSQL 13+)。
n_ins_since_vacuum超过 1,000 加上表的 20%。这会让只追加的表以小剂量获得可见性位和冻结。在 PostgreSQL 18 中,按比例计算的部分只统计尚未冻结的那部分。 - 年龄。
age(relfrozenxid)超过autovacuum_freeze_max_age(2 亿)。这是防回卷清理,即使关闭了自动清理也会运行。
当变更行数超过 50 加上表的 10% 时,ANALYZE 会触发。
对大表来说,默认值不对
0.2 的比例因子意味着“表中有五分之一的行死亡时才清理”:
| 活行数 | 自动清理前的死行数 | 含义 |
|---|---|---|
| 1,000 | 250 | 尚可 |
| 2,000,000 | 400,050 | 今天的 events:先积累 400k 个死行 |
| 100,000,000 | 20,000,050 | 20m 个死行造成的膨胀 |
| 1,000,000,000 | 100,000,000 (PostgreSQL 18 cap) | 没有上限时为 200m |
对大表来说,20% 的死行意味着每个查询都要扫描数 GB 的死行,最终启动的清理还要运行数小时。ANALYZE 也有同样的问题:比例为 10% 时,一张像 events 这样的年度时间序列表可能一个多月都不分析,因此统计信息会漏掉最新的行,而查询最常问到的正是这些行。修复方法是设置表级参数:
现在 events 大约积累 21,000 个死行就会清理,而不是等到 400,000 个。频繁的小清理在各方面都胜过罕见的大清理。我们的规则是:超过几百万行后,使用 0.01 到 0.05 的比例因子,或者使用 0 和固定阈值(自动清理的默认值适合小表和慢磁盘介绍全局设置)。
09-vacuum关闭自动清理从来不能修复任何问题:死元组会堆积,统计信息会腐烂,而防回卷清理仍然会在表膨胀到最糟时才到来。如果自动清理成本很高,就让它更频繁地运行,每次少做一些工作,并增加 I/O 预算,让它能够完成。
自动清理按预算运行,而默认预算很小
自动清理用点数预算限制自身:在共享缓冲区中找到的每页 1 点,从外部读取的每页 2 点,使其变脏的每页 20 点。当一个工作进程花完 vacuum_cost_limit(200)点时,就会休眠 autovacuum_vacuum_cost_delay(2 ms)。手动执行的 VACUUM 不受此限制。
这相当于每秒 100,000 点:读取 50,000 页(约 390 MB/s,绰绰有余),但只能弄脏 5,000 页(约 39 MB/s),而且这笔预算由三个工作进程共享。在真正有大量写入的 SSD 上,清理会落后,膨胀会增长,无论比例因子设得多低。把 autovacuum_vacuum_cost_limit 提高到 1,000~2,000,是最有效的改动之一。(清理还会通过一个小型缓冲区环读取,大小由 vacuum_buffer_usage_limit 决定:大操作会获得一个环。)
清理无法移除旧快照可能需要的内容
仍可能需要旧版本的最老对象决定了可移除截点。长事务会拖住一切已经说明了原因:一个从未接触这张表的空闲 repeatable-read 会话,在提交前一直让其中 60,000 个死行无法被移除。下面从清理的角度看看这是什么样,以及如何找出每种持有者。
症状是 vacuum (verbose) 的一行:0 removed,以及一个很大的已死亡但尚不可移除数量;除了持有截点的快照之外,所有人都看不到这些行。清理会运行、消耗 I/O,却什么也移除不了,这通常就是“自动清理在运行,但表仍然不断膨胀”的答案。持有截点的会话会在 pg_stat_activity 中以非空的 backend_xmin 出现,通常状态是 idle in transaction。
代价有多大,取决于它背后的写入量。在安静的表上,几秒钟没有代价;但在每秒接收数千次更新的表上,几秒钟就足以让更新失去 HOT,并永久扩大表(长事务会关闭 HOT)。繁忙的表被拖住三小时,就会产生数百万个死行,而膨胀会比事务活得更久。
会拖住截点的对象包括:
- 长时间运行的事务和查询,包括只读事务和查询。
- 处于事务中空闲的会话:应用运行了
BEGIN,随后等待网络调用,或泄漏了连接。这是现实中最常见的原因;idle_in_transaction_session_timeout是解决办法(连接并非免费)。 - 复制槽。备库启用了
hot_standby_feedback的物理槽会为每张表保持截点,即使备库消失后仍会继续保持。逻辑槽只为系统目录保持截点。两者都会保留 WAL。 - 启用
hot_standby_feedback = on的副本,其中运行时间很长的副本查询会拖住主库。 - 被遗弃的预备事务(两阶段提交很少是答案)。
复制槽和预备事务永远不会出现在 pg_stat_activity 中,而备库反馈只会在那里显示为 walsender 的 backend_xmin(或者显示在它的槽上),所以还要检查 pg_replication_slots 和 pg_prepared_xacts(四个查询告诉你清理是否跟得上)。
一个会话整个周末都处于 idle in transaction,就可能拖住整个数据库的清理;一个被遗弃的物理复制槽,则可能拖住整个集簇。为应用角色设置 idle_in_transaction_session_timeout,对最老的 backend_xmin 和不活跃槽设置告警,并设置 max_slot_wal_keep_size,这样一个死亡的槽就不会顺便填满磁盘。
清理的 SHARE UPDATE EXCLUSIVE 锁会与大多数 DDL 冲突,包括 ALTER TABLE、CREATE INDEX(甚至 CONCURRENTLY)以及另一次清理。普通自动清理如果阻塞了冲突的锁请求,会在 deadlock_timeout 之后自行取消,因此频繁的 DDL 或 LOCK TABLE 可能让一张表永远无法完成一次清理(log_autovacuum_min_duration 会记录这些取消)。防回卷清理不会让步;这也是一次迁移最终排在它后面的原因之一。
索引膨胀通常比表膨胀代价更大
查找会在索引中逐页进行,因此膨胀的索引会拖慢所有经过它的查询。膨胀是既不是活数据、近期也不会被复用的空间;一些空闲空间是健康的,因为下一次更新会落在那里。对于表,pgstattuple 会给出 dead_tuple_percent 和 free_percent。对于 B-树索引,pgstatindex 会报告叶子密度。
新的 B-树会把叶子打包到大约 90%。本章的更新每次都会为新行版本添加一个主键条目,因为没有任何一次更新能让新版本留在原来的页上;之后 vac_demo 的主键密度降到了 49%。REINDEX CONCURRENTLY(PostgreSQL 12+)会在线重建索引:创建一份新副本,再把它交换进来:
从 23.6 MB 降到 12.9 MB,小了 45%,而且没有阻塞写入。无需读取每一页的更便宜的膨胀估算见观察它运行。
09-vacuum大表执行 VACUUM FULL 会造成停机
VACUUM FULL 会把表重写到一份只包含活行的新文件中,然后重建所有索引。在 vac_demo 上,它从 13,601 页降到了 10,961 页。代价是:整个重写期间都要持有 ACCESS EXCLUSIVE 锁,阻塞所有读取和写入,还要额外占用一份副本大小的磁盘空间。对大表来说,这就是一次事故。(CLUSTER 是同一种操作,只是按索引对行排序。)把它留给小表和维护窗口;大表要在线重建(无锁重建膨胀的表)。
但首先要问,表为什么膨胀。如果清理被阻塞或太慢,重建只是把时钟拨回去。修复原因后,新写入会像插入测试所展示的那样复用已有的空闲空间。
回卷会在任何内容损坏前停止写入
数据库会拒绝新的写入,日志会说它这样做是为了防止数据丢失。没有任何东西损坏。你已经用掉了大部分 XID 空间,Postgres 在计数器回卷前停了下来。
每个写事务都会消耗一个 XID(只读事务不会)。每秒 1,000 个写事务就是每天 8,600 万个,因此繁忙系统每月会消耗数亿个。防线分成几层:
| XID 年龄 | 设置或限制 | 发生什么 |
|---|---|---|
| 150 million | vacuum_freeze_table_age | 清理变得激进:处理所有不是全冻结的页 |
| 200 million | autovacuum_freeze_max_age | 防回卷自动清理,即使自动清理已关闭 |
| 1.6 billion | vacuum_failsafe_age(PostgreSQL 14+) | 清理放弃节流和索引清理,以便完成 |
| 距离末尾 40 百万 | 在日志和客户端处发出警告 | |
| 距离末尾 3 百万 | 不再有新的 XID:完全不能写入 |
“末尾”就是回卷点,大约是 21 亿个 XID。
通常,防回卷清理每隔几亿个事务运行一次,没有人会注意。只有当某些东西阻止它完成时,才会出现紧急情况:有阻塞者拖住截点(清理不能冻结比它更新的元组)、节流太慢导致大表永远做不完,或者一次运行反复被阻塞或杀掉。
这发生在真实公司身上:Sentry 在 2015 年停机了大半个工作日,Mandrill 在 2019 年停机了大约 40 小时。两次事故的模式相同:大而繁忙的表早就让清理落后了,只是没人查看。
两起事故都以相同方式结束。Sentry 的高写入数据库在自动清理跟不上时停止接受写入;经过数小时清理后,截断一张巨大且不重要的表恢复了写入。Mandrill 在一个分片上发生了回卷,因为哈希让它比其他分片更热;清理的最高估计时间是 40 天,而截断最大的表(以 TB 计,其中大多数表只有 MB)让它在大约一小时后完成。
要避免这种情况:
- 监控每个数据库的
age(datfrozenxid),以及最大表的age(relfrozenxid)。 要在防故障保护阈值之前很久就告警,比如到 5 亿至 10 亿时。 - 控制清理阻塞者。 几乎每起回卷事故背后都有它们。
- 让由插入驱动的自动清理以小剂量冻结只追加的表。
- 不要为了让迁移通过而杀掉防回卷清理。 只有一次运行完成时
relfrozenxid才会前进,因此杀掉它会丢失已经做的工作,而自动清理会立即再启动一次。
如果写入已经被拒绝:移除阻塞者(终止旧会话、处理预备事务、删除死亡的槽),然后在最老的表上不节流地运行普通 VACUUM(不是需要 XID 的 VACUUM FULL)。当前文档建议使用普通多用户模式,而不是旧的单用户步骤;关于你的版本的确切步骤,见 Routine Vacuuming。
多事务 ID用于多个事务锁住同一行的情况(例如,许多会话的外键检查取得 FOR KEY SHARE),它们有自己的计数器、年龄(mxid_age(relminmxid))和冻结设置,也可能以同样方式回卷(共享行锁会产生多事务 ID,多事务 ID 也会回卷)。
PostgreSQL 18 还会在普通清理期间提前冻结一小部分全可见页(详细输出中的 eagerly scanned 数量,由 vacuum_max_eager_freeze_failure_rate 调整),把原本会由激进清理一次性承担的成本摊开。
四个查询告诉你清理是否跟得上
调查问题时运行下面这些查询,并把重要的结果做成图表和告警(观察它运行会把它们和其他指标放在一起)。它们回答四个问题:
- 哪些表最接近触发自动清理,它最近运行过吗? 如果一张表的
n_dead_tup长期远高于阈值,它要么被阻塞,要么跟不上。 - 每张表距离强制冻结还有多远? 比较
age(relfrozenxid)和autovacuum_freeze_max_age。 - 是什么拖住了截点? 会话(
pg_stat_activity)、槽(pg_replication_slots)和预备事务(pg_prepared_xacts):三者都要检查。 - 清理现在正在做什么? 看
pg_stat_progress_vacuum。
还要让自动清理报告自身:log_autovacuum_min_duration(默认 10 分钟)会为每次更长的运行记录包含 VACUUM VERBOSE 细节的日志。设为 1s 后,你就会得到清理历史,知道清理了什么、用了多长时间,以及哪些内容已死亡但尚不可移除。
哪些表最接近触发自动清理,它最近运行过吗? 在更新了 6,000 个事件和 300 个账户的新样本数据副本上:
300 个变更跨过了 accounts 的 250 行阈值,自动清理在一分钟内就把它们清掉了。events 的 6,000 个死行离 400,052 还远得很。这个查询使用全局设置,因此有表级覆盖设置的表会比 vacuum_at 显示的时间更早触发。
每张表距离强制冻结还有多远?
是什么拖住了截点?
清理现在正在做什么?
上面 index_vacuum_count 在大表上如果超过 1,意味着清理存不下所有死 TID,因而不止一次扫描索引。第一个查询中的 vacuum_at 使用的是 reltuples 这个采样估计值,因此会接近精确 2,000,000 行得到的 400,050,而不会正好等于它。
本章要点
- 更新和删除会留下死行版本;清理会移除它们,并记录空间以便复用。普通清理不会缩小文件,除非末尾存在空页。
- 用
pgstattuple(精确)或n_dead_tup(便宜)测量;用pgstatindex测量索引,并用REINDEX CONCURRENTLY修复索引膨胀。 - 清理还会冻结旧元组并设置可见性映射位。只追加的表也需要清理。
- 默认情况下,自动清理在 50 + 20% 死行时触发。对于超过几百万行的表,把表级比例因子设为 0.01 到 0.05。
- 在 SSD 上把
autovacuum_vacuum_cost_limit提高到远高于 200;默认预算由所有工作进程共享。 - “已死亡但尚不可移除”意味着有什么东西拖住了截点:长事务或处于事务中空闲的会话、复制槽、启用了反馈的副本,或预备事务。找出它并结束它。
VACUUM FULL会在整个重写期间阻塞表;在线重建大表,并先修复造成膨胀的原因。- 在 16 亿的防故障保护阈值之前很久就对
age(datfrozenxid)告警,永远不要关闭自动清理,也不要杀掉防回卷清理。
延伸阅读
- Routine vacuuming,PostgreSQL 文档。关于冻结、回卷,以及服务器停止接受写入时恢复步骤的参考资料。
- Vacuuming settings,PostgreSQL 文档。所有自动清理、成本和冻结设置,包括 PostgreSQL 18 的新增设置。
- pgstattuple,PostgreSQL 文档。精确和近似的膨胀测量,以及每个输出列的说明。
- src/backend/access/heap/vacuumlazy.c,PostgreSQL 源码。文件头注释介绍清理阶段以及 PostgreSQL 18 的提前冻结。
- VACUUM won’t remove dead rows: 4 reasons why,Laurenz Albe,CYBERTEC。简明介绍会拖住截点的所有因素。
- Transaction ID Wraparound in Postgres,Sentry;以及 What We Learned from the Recent Mandrill Outage,Mailchimp。两篇事务 ID 回卷事故复盘,最好在你需要它们之前读完。
11 Postgres 不是 MySQL
下面是一个包含四条语句的事务。它先插入一行,再插入一行违反唯一约束的重复行,然后插入另一行,最后提交。在 MySQL 和 Postgres 上分别运行它,再看看之后表里有什么。
MySQL 8.4 保留两行。PostgreSQL 18 一行也不保留。
10-not-mysql.sh谁也没有错。它们是两台碰巧说着相似 SQL 的不同机器。MySQL(使用 InnoDB,这正是今天大家说 MySQL 时所指的东西)和 Postgres 对两个问题做了相反的选择:一行存在哪里,以及修改一行时,旧版本要去哪里。你感受到的几乎所有差异都由这两个选择推导而来;看懂另一种设计,是理解当前设计最快的方法。
每个例子都在 MySQL 8.4.11 和 PostgreSQL 18.6 上运行,两边使用默认设置,并加载了相同的数据。
行和旧版本存放在哪里决定了一切
| 问题 | Postgres | MySQL(InnoDB) |
|---|---|---|
| 一行存在哪里? | 堆中:任何有空间的页 | 主键 B-树中,按键排序 |
| 索引指向什么? | 物理地址(ctid) | 主键值 |
| 旧版本去哪里? | 作为死元组留在表中 | 表外的撤销日志 |
| 谁来清理? | 清理 | 清理线程 |
| 页大小 | 8 KB | 16 KB |
主键选择、更新成本、膨胀,以及长事务会带来的后果,都源自表格的前四行。
在 InnoDB 中,表就是主键
在 InnoDB 中,表就是一棵按主键排序的 B-树,完整的行存放在叶子中:这就是聚簇索引。可以把它想成一本字典:词条按顺序排列,词条本身就是这本书。Postgres 更像一座图书馆:书放到任何有空间的书架上(堆),而每个索引,包括主键索引在内,都是指向书架地址 ctid 的卡片目录(一切都从页说起)。
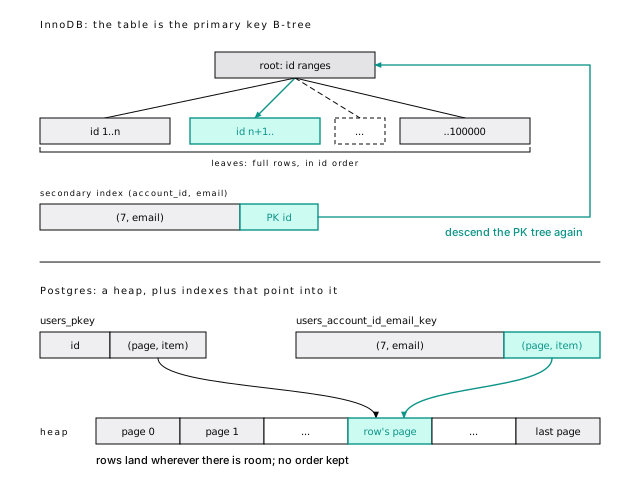
在 InnoDB 中,二级索引查找要下探两次
InnoDB 的二级索引条目保存的是主键值,不是地址,因此通过它找到的每一行都要再次下探主键树。我们在 MySQL 上统计页请求(Innodb_buffer_pool_read_requests),在 Postgres 上统计缓冲区:
| 查询(100 行) | MySQL 页请求 | Postgres 缓冲区 |
|---|---|---|
主键范围,id between 5000 and 5099 | 15 | 7 |
二级索引查找,account_id = 7 | 307 | 106 |
InnoDB 在通过二级索引读取时付出代价;Postgres 则如你马上会看到的,在写入时付出代价。 而 Postgres 这次 7 个缓冲区的范围扫描,还是插入顺序带来的偶然结果:我们的行按 id 顺序插入(pg_stats.correlation 中 id 的值为 1)。在 InnoDB 中,相邻的键总是物理相邻;在 Postgres 中,只有你按这种方式插入时才是如此。
10-not-mysql.shPostgres 有一个 CLUSTER 命令,它的名字会误导 MySQL 老用户。它会在 ACCESS EXCLUSIVE 锁下,按某个索引的顺序重写表一次,然后就不再管它。执行 cluster users using users_account_id_email_key 后,账户 7 的 100 个用户从 106 个缓冲区降到 6 个;主键范围扫描从 7 个变成 102 个(表只能按一种顺序排列);账户 7 的五个新用户则落在堆的末尾 (1123,58),离第 6 页上的同伴很远。只在批量加载后、基本只读的表上偶尔使用它,绝不要把它安排成定期维护。
10-not-mysql.sh在 MySQL 一侧,列类型会改变范围扫描数字:name 使用 TEXT 而不是 varchar(255) 时,同样的扫描大约需要 107 个页请求,因为 InnoDB 不再批量提取行。
在 InnoDB 中,覆盖索引几乎是免费得到的
每个 InnoDB 二级索引都带有主键,因此 select id, email from users where account_id = 7 从不接触表:只需 15 个页请求。Postgres 的索引不带主键,所以同一查询会访问 100 个堆页。建立 (account_id) include (id, email) 索引,让清理把页标记为全可见,成本就会降到 7 个缓冲区(覆盖索引:覆盖热点查询,而不是每个查询)。
递增键仍然重要;短键大多不重要
在 InnoDB 上,主键就是物理布局,所以 MySQL 团队会保持键短小且递增。在 Postgres 上,堆不在意这些,其他索引无论键多宽都只保存 6 字节的 ctid;只有主键索引会感受到随机键(慎选键,少后悔)。“递增”仍然重要;“短小”则没那么重要,其他表的外键列除外,因为它们会把键复制到每个引用行及其索引中。
保留:递增键(identity 或 UUIDv7)。舍弃:“表按主键排序,所以对它做范围扫描很便宜”;请检查 pg_stats.correlation。还要舍弃:“只要列不变,额外索引就很便宜”。下一节会解释原因。
一次更新,要么写一行,要么写每个索引
Postgres 更新时会在新的 ctid 上写入一个完整的新行版本;除非这是 HOT 更新(没有索引列发生变化,而且页上有空间),否则每个索引都会得到一个新条目,包括没有发生变化的列上的索引(冷更新会为每个索引付出代价)。InnoDB 会原地更新行,把更新前的镜像复制到撤销日志中,并且只触碰列发生变化的二级索引。其余索引指向没有移动的主键。
回读 WAL 可以确认左栏内容:名称变化是一条 86 字节的 HOT_UPDATE,而电子邮件变化是一次堆 UPDATE 加两次索引插入,其中一次插入了 users_pkey。MySQL 会再写一份自己的副本:名称更新让二进制日志增长了 414 字节,电子邮件更新增长了 422 字节;这两次都包含完整的更新前和更新后镜像,而且还要叠加重做日志。
两行都位于表的最后一页,而那一页有空闲空间;刚加载完的表中其他每一页都已填满,因此其中的更新无法成为 HOT。二进制日志大小来自更新前后执行 show binary log status 的结果。
10-not-mysql.sh两种设计都会在某处为写入付出代价
那么,哪种设计写得更少?这取决于你的负载;不问索引情况就给出答案的人,都是在推销某种东西。对于有很多索引、更新又无法使用 HOT 的表,Postgres 会在写入和清理时付出代价,因为死版本会一直留在表及其索引中,直到清理完成。InnoDB 会在通过二级索引读取时付出代价,并在每次更新时写撤销日志。对 Postgres 来说,实践上的教训是:保护 HOT(HOT 是一次性做出的设计决定)。
Uber 遇到了这种不对称,而双方都有道理
2016 年 7 月,Uber 发布了 Why Uber Engineering Switched from Postgres to MySQL。它的核心抱怨正是这种不对称:它们的更新触碰了索引列,因此每次更新都会在每个索引中写入条目;而且因为 Postgres 复制发送的是物理 WAL,所有这些内容都会跨网络传给每个副本。多年后的公平解读是:随后争论的双方针对不同负载都说对了一部分;在需要换数据库之前,你可以先重塑大多数遇到最坏情况的表。
旧版本留在表中,或留在撤销日志里
两个数据库都使用 MVCC,因此读取者看到的是快照时刻的行,而写入者可以同时修改它。Postgres 把旧版本作为死元组留在表中,这让回滚立即完成,却把账单留给清理。InnoDB 把当前版本保留在表中,把旧版本放进撤销日志;需要旧版本的读取者会沿着撤销链向回走,而后台的清理线程会在没有快照需要它们后丢弃撤销内容。
Purge(清理)是 InnoDB 对应的清理机制,而大多数 MySQL 用户从来不用思考它。把 Postgres 的清理也当成同一种东西,是 MySQL 团队在第一年使用 Postgres 时会犯的代价最高的错误。而且 Postgres 的清理还有一项 Purge 没有的工作:冻结旧行,让 32 位事务计数器安全回卷。InnoDB 的 48 位 ID 在实践中永远不会回卷,因此回卷没有对应的 MySQL 概念(回卷会在任何内容损坏前停止写入)。
长事务会伤害两者
我们在一个会话中保持快照打开,同时让另一个会话执行 5,000 次单行更新。在 InnoDB 上,历史列表长度(等待清理的撤销日志)从 2 增长到 5,000;快照结束后,后台清理跟上进度,列表就排空了(每次运行可能从 1 秒到超过 1 分钟)。在 Postgres 上,清理报告有 5,000 个版本“已死亡但尚不可移除”。InnoDB 的问题是撤销表空间增长,以及版本链越长读取越慢;Postgres 的问题是比事务活得更久的膨胀。解决办法相同:保持事务短小。(在 MySQL 上,历史列表长度来自 information_schema.innodb_metrics。)
10-not-mysql.shMySQL 默认使用可重复读;Postgres 不是
MySQL 默认是 REPEATABLE-READ,Postgres 默认是 read committed,在两者之间迁移的代码会悄悄改变含义。会话 A 读取用户 10,暂停,然后再次读取;与此同时会话 B 重命名用户并提交:
一个依赖 MySQL 稳定快照的多语句报表,在 Postgres 上会看到不断移动的目标;给它使用 begin isolation level repeatable read。反过来,读—改—写也会带来意外:读取一行,在应用中计算新值,再写回去。在可重复读隔离级别下,如果另一个会话在你的快照之后修改并提交了这一行,Postgres 会用串行化错误(40001)拒绝你的写入,你需要重试。InnoDB 的可重复读隔离级别则会在最新提交的版本之上写入,因此你根据旧快照计算出的值会悄悄覆盖另一个会话的提交。普通的 update ... set n = n + 1 在两者上都是安全的,因为 InnoDB 的更新会读取最新版本。只有可串行化隔离能排除所有异常给出了完整矩阵,Hermitage 套件则记录了两种行为。
在 MySQL 的可重复读隔离级别下,会话 A 把用户 11 的姓名读入变量,暂停,然后把姓名追加 +A 后写回。同时,会话 B 把用户重命名为 B 并提交。A 的写入成功且没有报错,行最后变成 User 11 +A,B 已提交的重命名消失了。在 Postgres 上采取同样的步骤(A 读取行,B 提交更新,A 更新行),A 的更新会失败,并提示 could not serialize access due to concurrent update。
10-not-mysql.sh你只能锁住已经存在的行
为了防止幻读,InnoDB 会锁住锁定读取所扫描的索引条目之间的间隙,而不只是它找到的行。会话 A 使用 for update 查询一个不存在的用户;会话 B 插入另一个不存在的用户,却超时并得到 ERROR 1205,因为被 A 的 X,GAP 锁阻塞。
在 Postgres 上,会话 B 的插入立即成功。行锁位于元组首部,因此你只能锁住已经存在的行。这样消除了一类 InnoDB 死锁,也意味着,要阻止两个会话创建同一个缺失的行,需要唯一约束、on conflict 或可串行化隔离。
performance_schema.data_locks 显示 A 的锁,就在下一个真实条目 8, 'user10007@example.com', 10007 之前。最后那个值是主键,存储在二级索引条目中,正如图中所示。
10-not-mysql.sh错误会中止整个事务
回到开头。在 MySQL 中,失败的语句只回滚自己,事务继续进行。在 Postgres 中,任何错误都会中止整个事务:后续语句会得到 current transaction is aborted, commands ignored until end of transaction block,而 commit 会返回 ROLLBACK。
这会破坏最常见的迁移模式:“尝试插入,捕获重复错误,继续执行”。使用 on conflict do nothing 并检查是否返回了行,或者使用保存点(保存点可以把损失控制在局部)。
有些框架会把每个请求或测试包在事务中。在 Postgres 上,其中被吞掉的一个错误会毒化后面的所有操作,而你最终看到的错误会指向错误的语句。要找事务中的第一个错误,不要只看最后一个。
进程比线程更早变得昂贵
Postgres 为每个连接派生一个进程;MySQL 为每个连接运行一个线程。两者在连接数达到几千时都会变得昂贵,但 Postgres 更早:每个后端进程都保留自己的缓存,而且每个快照都会查看其他每个会话。如果你的集群向 MySQL 直接打开了 2,000 个连接,就应该在 Postgres 前面放一个连接池,并按 CPU 核心和磁盘数量来确定真实连接数(连接并非免费)。
一份日志,而不是两份
Postgres 只有一份日志,即 WAL,负责崩溃恢复、副本和时间点恢复(先记日志,再写数据)。MySQL 有一份用于崩溃恢复的重做日志,以及一份用于复制的二进制日志,并通过内部两阶段提交保持两者一致。
更大的差异在于副本收到什么。MySQL 副本应用逻辑行事件,因此可以拥有额外的索引或更新的版本。Postgres 副本逐字节重放 WAL:它们是同一主版本上磁盘的副本,而不是数据的副本。重大升级要围绕 pg_upgrade 或逻辑复制规划,而不要通过提升一个更新版本的副本来完成。
DDL 具有事务性
在 Postgres 中,下面的操作不会留下痕迹:插入、表和列都会回滚。
在 MySQL 中,DDL 以语句为单位具有原子性,但会隐式提交已经打开的事务。同样的序列会在表中留下账户 1024 | Before DDL:create table 提交了插入,而 rollback 没有任何东西可回滚。
10-not-mysql.sh两者的风险相同:模式变更会排在长查询后面,而后面的所有操作又会排在它后面。使用较短的 lock_timeout 并重试,迁移要保持小,因为事务性迁移会一直持有所有锁,直到提交(变更模式,服务照常)。
小小的方言差异会不断累积
剩下的是 SQL 本身的一些小差异。它们加在一起,就是直接迁移的代码会在十几个地方无法通过测试的原因。
字符串按精确字符比较
MySQL 8.4 的默认排序规则 utf8mb4_0900_ai_ci 不区分重音和大小写。Postgres 比较精确字符:'abc' = 'ABC'、'Bob@x.com' = 'bob@x.com' 和 'resume' = 'résumé' 在 MySQL 上都为真,在 Postgres 上都为假。这在唯一约束中影响最大。MySQL 会拒绝 USER1000@Example.com,认为它与 user1000@example.com 重复;Postgres 会接受它,于是一个账户有了两个“相同”电子邮件地址的用户。
在模式中为每一列决定相等意味着什么。对于电子邮件,通常的选择是对 lower(email) 建立唯一索引(索引恰好保存你交给它的东西);citext 和 ICU 排序规则是替代方案(类型是一份契约)。
10-not-mysql.sh是 identity,而不是 auto_increment
AUTO_INCREMENT 对应 generated always as identity。两者都会在事务之外发放值,因此都会留下间隔。本章已经制造了一些间隔:MySQL 批量插入 100,000 个用户后,计数器到了 131,071(它会以不断增长的批次预留值),失败的重复插入消耗了 131,072;Postgres 回滚的事务消耗了 100,001 和 100,002。
永远不要用序列构造无间隔编号。LAST_INSERT_ID() 对应 returning id;批量加载显式 ID 后,使用 setval 重置序列(慎选键,少后悔)。
插入或更新(upsert)要指明冲突目标
MySQL 的 on duplicate key update 会在与任何唯一索引发生冲突时触发;它自己的文档警告不要在拥有多个唯一索引的表上使用它。Postgres 要求你指明仲裁索引:
excluded 是你试图插入的行;省略冲突目标,Postgres 就会拒绝。on conflict do nothing 可以替代 INSERT IGNORE,又不会顺便忽略数据转换错误。Postgres 还有 SQL 标准的 MERGE(PostgreSQL 15+),MySQL 没有;但对单行“插入或更新”,优先使用 on conflict:它在并发下是原子的,而两个会话对同一个新键运行 MERGE 仍可能发生冲突(经得住数据增长的查询)。
整数除法会截断,NULL 排在最后
| 表达式 | MySQL | Postgres |
|---|---|---|
7/2、3/5 | 3.5000、0.6000 | 3、0 |
1/0 | NULL,并给出警告 | 错误:division by zero |
'a' || 'b' | 0(逻辑或) | ab |
order by x 且 x 为 NULL | NULL 在前 | NULL 在后 |
Postgres 中的整数除法会截断,因此在 MySQL 上为 0.6 的百分比在这里是 0;把一侧转换类型(3::numeric / 5)。
NULL 比所有值都大,因此按 completed_at desc 排序的“最新优先”列表会突然以所有未完成行开头。写上 nulls last,并在服务这个排序的任何索引中保持一致(sorting rows)。
把 concat() 迁移为 || 时,有一条规则仍然成立:NULL 操作数会让整个结果变成 NULL,因此没有姓氏的人执行 first_name || ' ' || last_name 会得到 NULL。concat_ws(' ', first_name, last_name) 会跳过 NULL。反向迁移时也要小心:Postgres 自己的 concat() 会把 NULL 当作空字符串,这一点与 MySQL 不同。
10-not-mysql.sh外键不会自动创建索引
InnoDB 会为每个外键列创建索引。Postgres 在子表一侧什么也不创建:同一张 projects 表在 MySQL 上有 account_id、owner_id 和 PRIMARY 索引,在 Postgres 上却只有 projects_pkey。没有索引时,每次删除父行都会扫描子表(每次删除父行都会扫描整张子表),读取全部 2,000,000 个事件。除非你已经测量过并确认不需要,否则要为外键列建立索引。
Postgres 修正估算,而不是采纳提示
MySQL 有 /*+ ... */ 提示和 FORCE INDEX。核心 Postgres 遵循长期政策,不提供这些东西。规划器选错时,原因几乎总是估算错误;修复方法是提供更好的信息:analyze、更高的统计目标、扩展统计信息或重写查询(规划器也在估算)。pg_hint_plan 扩展可以在紧急情况下使用。
还有一些习惯不能迁移
- 标识符会折叠为小写。 双引号使其区分大小写(MySQL 使用反引号,并把双引号当作字符串)。创建为
"Users"的表必须永远加引号。使用不加引号的 snake_case,并在第一次迁移前设置 ORM 的命名策略(identifiers)。 - **GROUP BY 就是它字面表达的含义,**和 MySQL 的
ONLY_FULL_GROUP_BY一样:每个选出的列都必须被分组、聚合,或依赖于已分组的主键。若要“取组中的任意值”,PostgreSQL 16 增加了any_value()。 - 用 jsonb,不用 json。
jsonb是 MySQL 用户期待的二进制类型。Postgres 用GIN为整个文档建立索引,并且每次更新都会重写整个行版本,因此要把快速变化的字段从大文档中移出去。 - 没有
UPDATE ... LIMIT。 在子查询中先选出键。 - 类型。 没有
UNSIGNED,有真正的boolean,而DATETIME对应timestamptz(类型是一份契约)。
大多数 MySQL 惯用法都有直接的 Postgres 对应物
| MySQL | Postgres |
|---|---|
AUTO_INCREMENT | generated always as identity |
LAST_INSERT_ID() | insert ... returning id |
INSERT ... ON DUPLICATE KEY UPDATE | insert ... on conflict (cols) do update |
INSERT IGNORE | insert ... on conflict do nothing |
`backticks` | 不加引号(或使用 "double quotes") |
IFNULL(a, b) | coalesce(a, b) |
GROUP_CONCAT(x) | string_agg(x, ',') |
TINYINT(1) | boolean |
DATETIME | timestamptz |
JSON | jsonb |
utf8mb4_0900_ai_ci equality | lower(col) 索引、citext 或 ICU 排序规则 |
FORCE INDEX、/*+ ... */ | 修复统计信息 |
SHOW PROCESSLIST | select * from pg_stat_activity |
OPTIMIZE TABLE | vacuum,或在线重建以缩小空间 |
| 清理、历史列表长度 | vacuum、n_dead_tup |
mysqldump | pg_dump |
本章要点
- InnoDB 按主键顺序存储表,并让二级索引指向主键。Postgres 把行存储在堆中,让每个索引指向物理地址。
- Postgres 的主键范围扫描只有在行按键顺序插入时才便宜(检查
pg_stats.correlation)。 - 不属于 HOT 的 Postgres 更新会在每个索引中写入一个条目。频繁更新的列要少建索引。
- 旧版本会留在 Postgres 表中,直到清理移除它们。要把清理当作一等工作,并了解回卷。
- Postgres 默认是读已提交,没有间隙锁;它的可重复读会抛出错误,而不是丢失更新。
- Postgres 中任何错误都会中止整个事务。用
on conflict替代“插入并捕获重复”。 - 字符串按精确字符比较,整数除法会截断,NULL 排在最后,外键也不会自动为你建立索引。
- DDL 具有事务性,但迁移要保持短小,并设置
lock_timeout。
延伸阅读
- Concurrency control,PostgreSQL 文档。Postgres 的隔离级别与锁,可以和下面的 MySQL 页面对照阅读。
- Clustered and Secondary Indexes,MySQL 8.4 手册。聚簇索引、隐藏行 ID,以及二级索引为什么携带主键。
- InnoDB Multi-Versioning,MySQL 8.4 手册。隐藏列、撤销日志、清理,以及二级索引条目如何被标记删除。
- Transaction Isolation Levels,MySQL 8.4 手册。InnoDB 的可重复读隔离级别做什么,以及 next-key 锁从哪里来。
- Hermitage,Martin Kleppmann 和贡献者。一个精确展示每个数据库的“可重复读”允许哪些异常的测试套件。
- Why Uber Engineering Switched from Postgres to MySQL,Evan Klitzke,Uber,2016 年。完整的写放大论证;与上面链接的回应一起阅读。
12 类型是一份契约
这个错误已经让不止一位值班工程师从睡梦中惊醒:
这是 4 字节 integer 能容纳的最大值。当 integer ID 的序列达到它时,每次插入都会失败。不是部分失败:每一次都失败。修复它要重写这张表、它的索引,以及所有外键指向它的表。背后的决定只花了两秒,却是在多年以前、一次没人记得的迁移中做出的。
类型是你做出的最便宜的决定,却是最昂贵的修改对象。类型是一份契约:每行要花多少字节、哪些值根本不能存在,以及比较和算术如何运作。对于文本,排序规则也是这份契约的一部分,而且它是其中唯一可能在你毫无迁移的情况下自行改变的部分。
每个字节都要按行付费
查询的成本大致取决于它触碰的页数,而一页容纳 8 KB。把一行从 125 字节缩小到 100 字节,每次扫描触碰的页数就大约少 20%。pg_column_size() 会告诉你任意值占多少空间,而对齐可能会把一个窄列填充到 8 字节(列顺序就是空闲空间)。
保持比例:先保证正确,再保留改变主意的自由,最后才考虑字节数。
整数比你想象中更快耗尽
| 类型 | 字节数 | 范围 |
|---|---|---|
smallint | 2 | 约正负 32 千 |
integer | 4 | 约正负 2.1 十亿 |
bigint | 8 | 约正负 9.2 百京 |
ID 使用 bigint
每个主键以及引用主键的每个列都使用 bigint。回滚的插入、on conflict 尝试和丢弃的批量加载都会消耗序列值;相比之下,省下的 4 字节还不如 23 字节的元组头重要。以后把 integer 改成 bigint,要重写每个引用表;在大型系统上,这是一个持续数周的项目(integer 改 bigint 的问题)。
运行示例中的 events 表有 2,000,000 行,integer 还剩 2,145,483,647 个可用值。这听起来很安全,直到你算一算:一个每秒写入 1,000 行、还要把重试算进去的流水线,大约 25 天就会用完它。
拿不准时,选择更大的类型。没有人会因为列太宽而被叫醒。bigint 的唯一例外,是必须由数据库之外的系统预先生成的键,也就是 uuid(数据库不总能生成 ID)。
金额用 numeric,绝不用浮点数
浮点类型(real、double precision)存储的是二进制近似值,而大多数十进制小数都没有精确的二进制表示。把一百万个一角硬币加起来:
11-types那个多出来的 0.00000133288,就是发票对账出现一分钱差异的起点。使用 numeric(p, s),让其中的小数位数对应货币的最小单位,或者使用以分为单位的 bigint;无论选哪一种,都要有一个货币列。浮点数适合传感器读数、评分和坐标,因为这些场景可以接受很小的相对误差。
numeric(12, 2) 会在输入时舍入,但声明的小数位数只在存储或转换值时生效,不适用于算术运算:
何时舍入、如何舍入由你决定,这对金额来说是正确的:银行家舍入、按行还是按发票舍入,都属于业务规则。numeric 是变长类型(pg_column_size 对 1 返回 8 字节,对 123456789.12 返回 14 字节),速度比整数运算慢;只有在汇总数亿行时,这才重要。到了那种规模,以分为单位的整数更合适。
使用 text,把长度写进检查约束
text 和 varchar(n) 的存储方式相同:'hello' 无论哪一种都占 9 字节。char(n) 会填充空格,char(50) 会占 54 字节。varchar(n) 就是附加了长度检查的 text,而问题就在这个附加检查上。长度规则会改变,写进类型的规则看起来像存储决策,实际上却是验证规则。把它写成约束:
检查约束有名字,可以在不触碰列类型的情况下替换,可以先以 not valid 添加、之后再验证而不持有长时间锁(添加 CHECK NOT VALID,再验证它),还可以表达长度无法表达的事情,比如“不能为空”。varchar(255) 是带有 MySQL 理由的 MySQL 习惯(索引前缀限制),而这里不存在这种限制。
比较时会忽略尾随空格,拼接时会剥掉尾随空格。即便是 ISO 国家代码,也应该使用 text,并加上 check (length(code) = 2)。公平地说,很多年来,提高 varchar(n) 的 n 一直只需修改元数据;降低它仍然需要实际处理。
排序规则决定什么算相等
排序规则是比较和排序文本的一组规则。它决定 'a' < 'B' 是否成立、'_draft' 排在哪里,以及 'Ada@Example.com' 是否等于 'ada@example.com'。每个文本索引都按排序规则的顺序建立,因此排序规则和数据一样,都会牢牢写入索引。
同一台服务器上,六个相同的词在四种排序规则下的排序结果:
(横放后才能容纳。)C 和 builtin 按代码点排序:大写字母在前,é 排在 z 后面。glibc 的 en_US 几乎忽略标点;ICU 把标点放在最前面。四种排序规则,三种顺序:同一份数据,却对“接下来是什么”给出三种答案。
选择顺序永不变化的排序规则提供者
| 提供者 | 规则来自 | 何时变化 |
|---|---|---|
| libc | 操作系统 C 库(glibc) | 升级操作系统时 |
| ICU | ICU 库 | 升级 ICU 时 |
| builtin | Postgres 自身 | 排序顺序永不变化 |
除非有人另行选择,你的数据库使用 libc,因为 initdb 会复制操作系统区域设置(本例是在 glibc 2.41 上使用 en_US.utf8)。builtin 提供者在 PostgreSQL 17 中加入。我们新数据库的默认设置是 builtin C.UTF-8,按代码点排序,永不变化:
字节比较、能经受每次操作系统升级的排序顺序,以及一个能服务于 like 'abc%' 的普通B-树(前缀搜索需要正确的操作符类)。人们会阅读排序结果的地方,就明确要求它:order by name collate "unicode"。需要时使用语言学排序,其他地方保持稳定。
PostgreSQL 18 增加了 pg_unicode_fast,它还会执行完整的 Unicode 大小写映射(ß 会折叠为 ss)。实验会检查排序示例中的全部四种顺序。
11-types对电子邮件,用 lower() 作为唯一键
上面的每种排序规则都是确定性的:只有字节相同的字符串才相等。因此,where email = 'USER1@EXAMPLE.COM' 在 user1@example.com 已经存在时什么也找不到;unique (account_id, email) 也会欣然接受 Ada@x.com 和 ada@x.com,于是用户以为相同的账户就变成了两个。四种工具可以解决它:
lower()加唯一表达式索引。 到处都能用;查询必须像索引一样准确写出lower(email)(索引恰好保存你交给它的东西)。citext。 一个会替你调用lower()的 contrib 类型。- 非确定性 ICU 排序规则(PostgreSQL 12+),不同字节可以比较为相等。它最正确,但只有从 PostgreSQL 18 开始
like才能用于它,而且永远不能通过 B-树使用。 casefold()(PostgreSQL 18+),符合 Unicode 规则的lower()。在 ICU 或pg_unicode_fast排序规则下,STRASSE和Straße会匹配;在 libc 或 builtinC.UTF-8下,ß仍然是ß。
对于电子邮件和用户名,我们的默认选择是使用带唯一表达式索引的 lower():无聊,但可预测。
MySQL 的默认排序规则忽略大小写和重音;Postgres 的确定性排序规则不会。导入前,为每个列选择工具(字符串按精确字符比较)。
ks-level2 忽略大小写;ks-level1 连重音也忽略。相等判断会使用索引,这次大写查询只需要 7 页。从 PostgreSQL 18 开始 like 才能工作,而且只能进行扫描:
为了找一行,却要读取全部 834 页。正则表达式和 ilike 则会直接失败。
11-types操作系统升级可能破坏索引
文本上的 B-树会按照插入当天排序规则认定的顺序保存键。规则改变后,搜索会用新规则沿着旧顺序行走,走进错误的分支。不会报错,只是再也找不到那些行。
这不是假设。glibc 2.28(2018 年)重写了大多数区域设置的排序规则数据,而随之发布的操作系统版本(包括 Debian 10、RHEL 8 和 Ubuntu 18.10)可能会重新排列任何使用 libc 排序规则的索引中的键(C 或 POSIX 除外),无论该索引是原地升级还是作为物理副本恢复的。位于更新操作系统镜像上的物理副本也有同样的问题。
我们在一个临时数据库中模拟了这个问题。主键不再能找到表中仍然存在的 'Zebra'。接着它又接受了第二个 'Zebra'。然后,通常的修复办法 reindex 在这个重复值上失败了。先是漏掉行,然后是破坏修复过程的重复值。
让目录中的排序规则指向另一套规则,这正是从 Postgres 一侧看操作系统升级的样子(仅限临时数据库):
在新会话中,name = 'Zebra' 什么也不返回,name >= 'Tag1' and name < 'Tag2' 的计数为 0;关闭索引扫描后,则分别找到 Zebra 和 1,111 行。然后:
11-types在它造成伤害前发现问题
Postgres 会记录每个排序规则对应的库版本(从 PostgreSQL 15 开始,还会记录数据库默认排序规则的版本),并在使用时发现版本变化就发出警告。应用不会把这个警告显示给任何人,所以每次操作系统或镜像发生变化后都要主动检查:
把任何不匹配都当作“在信任之前先重建”。修复重复值,在该排序规则下对每个文本索引执行 reindex(并发执行),用 amcheck 检查(它会按今天的规则验证每个索引的顺序),然后用 alter collation ... refresh version 记录新版本。
refresh version 什么也修复不了,它只会让警告消失。把操作系统升级、基础镜像更新和新副本镜像都当成排序规则事件;或者使用 builtin 提供者,从此不再操心。
对于数据库默认排序规则,比较
datcollversion与pg_database_collation_actual_version(oid)。从 PostgreSQL 15 开始,数据库会在每次新连接时发出警告;我们修改了一个临时数据库的目录行,让它声称使用了较旧的 glibc:执行
alter database w_edges refresh collation version后返回NOTICE: changing version from 2.31 to 2.41,除此之外什么也没有修复。先按提示重建,再刷新。动手验证 · lab11-types受影响的索引,是那些使用 libc 或 ICU 排序规则的文本索引:
默认排序规则显示为提供者
d,因此即便在使用 builtin 的数据库中,这个查询也会列出默认排序规则的索引。接着用amcheck按今天的规则验证索引顺序,只需持有轻量锁:在升级切换前,对恢复出的副本运行一次;升级后,再对大型文本索引运行一次。
时间戳:始终使用 timestamptz
用 timestamptz 存储时间点;凡是已经发生的事情,都不要使用不带时区的 timestamp。本章几乎没有哪条规则的例外比它更少。
名称会误导人。timestamptz 不存储时区;两种类型都是 8 字节。timestamptz 表示一个绝对时刻,以 UTC 保存。timestamp 表示挂钟读数:“22:51”是哪个城市的时间?两个应用服务器在同一时刻插入,一个会话使用纽约时间(连接池配置错误,或某台 cron 机器忘了设置),另一个会话使用 UTC:
timestamptz 两次记录的是同一个时刻。timestamp 记录的是相隔四小时的两个读数,而所有基于它的“最近一小时”仪表盘现在都悄悄错了。你无法修复它:时区从未被存储。
让每个连接都使用 timezone = UTC,发送时间戳时带上明确的偏移量,在边界处完成转换。
now() 是事务开始的时刻,因此一个持续一小时的批处理会给每一行盖上相同的时间。clock_timestamp() 才是挂钟时间(日期/时间函数)。
唯一诚实的例外,是必须经受时区规则变化的未来本地时间(“2027-03-01 当地时间 09:00 开门”):存储 timestamp 加时区名称。
2026 年 3 月 8 日,纽约从 02:00 跳到了 03:00:
1 day 保持挂钟时间;24 hours 增加 86,400 秒。这只对命名的会话时区有效,对固定偏移量无效。普通 timestamp 对第一个结果会给出 02:30,而这个时间在纽约根本不存在。
11-types在一个事务中两次读取 now() 和 clock_timestamp(),中间执行两秒的 pg_sleep:
statement_timestamp() 是第三种选择:当前语句开始的时刻。
11-types时间戳胜过布尔值;检查约束胜过新类型
date 用来表示真正的日期,比如生日,而不是“创建于何时”这种你只是在展示时转换为日期的时间点。查询时间范围时使用半开区间:>= '2026-10-01' and < '2026-11-01'(日期范围是半开的),并记住 '2026-01-31'::date + interval '1 month' 是 2 月 28 日。
在增加一个布尔值前,先问问自己是否将来会想知道它何时变成了真。archived_at timestamptz 用 is not null 回答“它已归档吗?”,还能回答“何时归档”,代价是多 7 个字节。对于审计关心的状态(已验证、已归档、已取消),时间戳更好。
要把列限制在一组值中,我们的默认选择是 text 加检查约束,比如运行示例中的 check (plan in ('free', 'team', 'enterprise'))。每个工具都理解它,而且可以在线替换。如果值本身还携带数据,就使用查找表。
枚举很难收回
枚举占 4 字节,并按声明顺序排序:这对于真正稳定且有序的集合(比如日志严重性)很合适。但有两个陷阱。没有 drop value,所以要废弃一个值,就得创建新类型并重写表。而且,在事务中添加的值要等事务提交后才能使用;这会破坏那些在同一事务中添加值并填充行的迁移工具(ERROR: unsafe use of new value "audit" of enum type event_kind)。
用 uuid 存储 UUID
uuid 占 16 字节;作为 text 要占 40 字节,每个索引也会随之变大(慎选键,少后悔对此有测量)。
所有了解自身领域的类型也是如此。inet 和 cidr 会验证地址,并用一个操作符回答“这个 IP 是否在那个网络中”。范围类型(tstzrange、daterange)让“不能有两个预订重叠”成为一个排他约束。而 create domain email_address as text check (...) 则把反复出现的规则只写一次。
数组适合随行生灭的列表
数组适合属于一行的小列表:标签、通知渠道。当元素其实是伪装成列表的行时,数组就不合适:它们引用其他表(元素上没有外键),你一次只更新一个元素(每次更新都会重写整行),或者列表会无限增长。项目上的用户 ID 数组,其实就是一张尚未创建的成员关系表。
使用 jsonb,把要查询的键放进独立列
json 存储文本,每次访问时都要重新解析;jsonb 只解析一次,并支持GIN索引。使用 jsonb,只在需要精确保留输入时使用 json,比如要验证签名的 webhook 请求体。
jsonb 不是免费的。每一行都会重复保存每个键:events.payload 每行要花 63 到 69 字节来拼出 "status"、"duration_ms" 和 "region",大约是类型化列所需空间的五倍。而且规划器几乎没有文档内部的统计信息(大多数文档都应该放在 jsonb 列中)。要用于过滤、连接、排序或约束的键,都应该有自己的列。
它也不更小:{"status":"ok","duration_ms":120,"region":"iad"} 作为 json 占 52 字节,作为 jsonb 占 68 字节。
11-types生成列默认是虚拟的(PostgreSQL 18+)
PostgreSQL 18 默认让生成列成为虚拟列:读取时计算,不占空间,也不可能建立索引。存储列在写入时计算。展示用的简单值使用虚拟列;需要过滤或排序的值使用存储列,比如 tsvector(存储 tsvector,不要给表达式建索引)。PostgreSQL 18 之前,语法必须写 stored,因此已有迁移和升级后的列都安全;现在新增的变化是,不写关键字的新 DDL 会得到虚拟列。需要存储列时,就明确写出 stored。
四种类型得不偿失
serial 是序列,不是类型
serial 不是类型。它是一个序列,加上一个 nextval() 默认值,作用于 4 字节 integer;这正是本章开头用到的类型,而这个序列永远不会知道手工插入的 ID:
相反,bigint generated always as identity 会拒绝手工指定的 ID(让数据库为行编号,永远不要相信顺序)。
此外还要避免 money(由服务器区域设置格式化,不知道货币种类)、char(n)(见上文)和 timetz(没有日期的偏移量无法知道夏令时;文档本身也不推荐它)。
本章要点
- 每个 ID 以及每个引用 ID 的列都使用
bigint。 - 金额使用
numeric或以分为单位的bigint,并另设货币列。绝不用浮点数。 - 使用带检查约束的
text,不要使用varchar(n)。绝不用char(n)。 - 默认排序规则区分大小写。对于电子邮件,使用基于
lower(email)的唯一索引。 - 把每次操作系统、glibc 或 ICU 升级都当作排序规则事件:检查版本,重建文本索引,然后
refresh version。或者使用 builtinC.UTF-8(PostgreSQL 17+)。 - 每个时间点都使用
timestamptz,会话使用 UTC,输入带明确的偏移量。 - 优先使用
archived_at而不是is_archived,使用带检查约束的text而不是枚举,使用jsonb而不是json,并为要查询的 JSON 键建立独立列。 - 使用 identity,不使用
serial。在 PostgreSQL 18 中,除非写出stored,否则生成列都是虚拟的。
延伸阅读
- Data Types,PostgreSQL 文档。所有内置类型及其存储大小和输入规则。
- Collation Support,PostgreSQL 文档。提供者、确定性和非确定性排序规则。
- amcheck,PostgreSQL 文档。
bt_index_check验证什么,以及它持有的锁。 - Locale data changes,PostgreSQL Wiki。哪些 glibc 和发行版版本改变了排序顺序。
- How To Correct and Identify Indexes Affected by the GNU C 2.28 Update,Crunchy Data。实践者关于如何查找并重建受影响索引的过程。
- Case-insensitive pattern matching in PostgreSQL,Laurenz Albe,CYBERTEC。深入比较
lower()、citext和非确定性排序规则的取舍。 - Don’t Do This,PostgreSQL Wiki。社区列出的类型错误清单,以及每种错误何时可以接受。
13 慎选键,少后悔
取三张各有一百万行的表,它们的差别只有主键;再向每张表插入第二百万行,沿途像真实服务器一样执行检查点。使用随机 UUID 键时,这一百万行写入了 551 MB 的预写式日志。使用按时间排序的 UUIDv7 时是 143 MB。使用普通 bigint 时是 130 MB。
WAL 总量几乎是四倍,原因全在于每个新键落在索引的什么位置。而这还只是键设计发生在数据库内部的一半。另一半是你展示给世界的 ID;如果它是一个计数器,就会告诉陌生人你的规模有多大。
键是以后无法低成本更换的列。一次性、分开决定两件事:你用什么连接,以及你发布什么。
自然键会变;代理键不会
**自然键(natural key)**标识现实世界中的事物,比如电子邮件。**代理键(surrogate key)**由数据库发明,比如标识列(identity column)。自然键会变化(而改变主键意味着更新每一行子记录),它们很宽,还会把个人数据泄露到 URL 和日志中。
我们的规则是:每张表都使用代理主键,自然键变成 unique 约束,例如 unique (account_id, email) 约束用于 users。例外是永远不会改变的代码('USD')以及连接表;连接表的复合键(composite key)(primary key (project_id, user_id))就是那一对外键(连接表需要在两个方向上都有索引)。
让数据库为行编号,永远不要相信顺序
Postgres 用序列生成整数键。序列是一个发放递增数字的小型关系,并通过标识列与表关联起来:id bigint generated always as identity primary key。generated always 会拒绝手工指定、以后可能与序列冲突的 ID(serial展示了这个 bug),而且每个外键列都使用与它匹配的 bigint(ID 使用 bigint)。
这些数字用于标识,而不是排序。序列会有间隔,因为 nextval() 从不回滚。它们也不按提交顺序排列:A 取到 100,B 取到 101 并先提交,而一个执行 where id > last_seen_id 的轮询器会永远跳过 100。不要用它们建立发票编号,也不要用它们建立变更流。
回滚的事务不会归还它的序列值,因 on conflict 跳过的插入也不会(序列函数)。缓存的值会随会话一起消失,崩溃也可能跳过一些值。无间隔计数器是另一行数据,在锁下更新。
导入保留旧 ID 的行(overriding system value)会让序列落后,因此下一次普通插入会在 ID 1 上发生冲突。每次批量加载后执行 select setval(pg_get_serial_sequence('imported', 'id'), (select max(id) from imported));。而且逻辑复制不会复制序列状态(截至 PostgreSQL 18),所以做逻辑复制升级后要重置每个序列(及时采用小版本,演练大版本)。
12-keys递增键追加;随机键落在任何位置
UUID 是存储在 16 字节中的 128 位数字。其中一位十六进制数字表示它的版本:4 版有 122 个随机位,7 版以 48 位毫秒时间戳开头,后面跟着随机位。下面是各四个:
左边的 v7 值共享前缀,并且递增。右边的 v4 值会落在任何位置。故事就是这么简单,因为 B-树会在 8 KB 的叶子页之间保持键的顺序(B-树挑起大梁),所以新键落在哪里只取决于它的值。
递增键(标识列、UUIDv7)总是落在最右侧叶子上,而最右侧叶子会留在内存中,就像只能追加的账本。随机键(UUIDv4)会落在任意位置,就像把每一页新纸随机塞进活页夹。由此产生三件事:
- 半满的页。 中间的满页会按 50/50 拆分;页最终大约有 70% 满,而追加写入时是 90%。
- 巨大的热点集合。 下一次可能写入任何叶子,因此整个索引都必须留在缓存中。
- 整页写入。 检查点之后第一次修改某个页时,会记录整页的镜像(检查点后的第一次修改会记录整页)。追加写入在每个检查点只需为右边缘的少数几个页付出这个代价。随机键则要为自上次检查点后首次触碰的每一个叶子付出这个代价,而在大型索引中,每个检查点就是数千个叶子:一个 16 字节键最多要写入 8 KB 的 WAL。
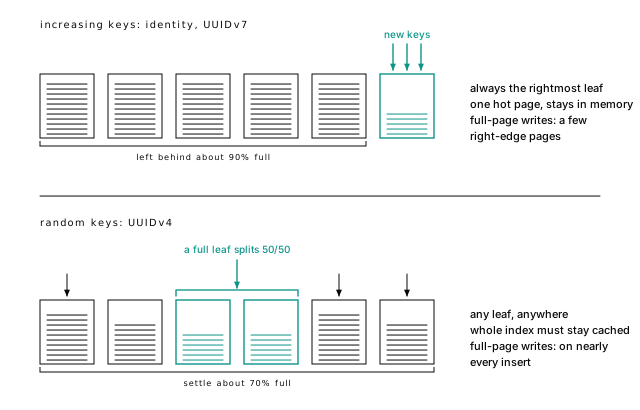
RFC 9562(2024)定义了这些版本;除了 4 和 7 之外,1 版会泄露 MAC 地址,3 和 5 版会对名称进行哈希。gen_random_uuid() 生成 v4;PostgreSQL 18 增加了 uuidv7() 和别名 uuidv4(),PostgreSQL 17 增加了查看 UUID 内部信息的函数:
对 v4,它返回 null:其中没有时间。Postgres 会用 v7 版本数字之后的 12 位填入亚毫秒时间,并保证每个值都比该后端上一个值前进一小步,因此紧密循环永远不会倒退。一个语句中的一百万次调用跨越大约 500 毫秒,大约每个毫秒有 2,000 个 ID,而且每一个都比前一个大。
12-keys随机键写入的 WAL 几乎是四倍
三张除了键以外完全相同的表。我们先向每张表插入一百万行,再分十批插入另一百万行,每批前执行一次 checkpoint,模拟繁忙服务器的 5 分钟 checkpoint_timeout,并从 explain (analyze, wal, buffers) 中读取每批产生的 WAL。第二百万行的结果是:
| 第二组 1,000,000 行 | bigint | UUIDv4 | UUIDv7 |
|---|---|---|---|
| 产生的 WAL | 130 MB | 551 MB | 143 MB |
| 整页镜像 | 43 | 72,753 | 40 |
| 脏缓冲区 | 8,199 | 84,058 | 10,259 |
每个 bigint 和 UUIDv7 批次大约写入 4 个整页镜像,也就是堆和索引的右边缘。每个 UUIDv4 批次则写入数千个:WAL 是 v7 的 3.8 倍,脏缓冲区是 8 倍。在服务器上还有其他工作时,我们测到了 590 到 630 MB。UUIDv7 的表现几乎和 bigint 完全一样。
对于 v4 列上的每个索引,代价都会重复,包括每个指向它的、已建立索引的外键。读取也会受影响:应用最常读取的最新行分散在整个索引中,而不是集中在少数几个缓存叶子上。
三张表分别使用 id bigint generated always as identity、id uuid default gen_random_uuid() 和 id uuid default uuidv7(),每张表旁边还有一个 n int。在一次检查点之后,每张表用一条语句插入第一个百万行:
| 1,000,000 行 | bigint | UUIDv4 | UUIDv7 |
|---|---|---|---|
| 主键索引大小 | 21 MB | 38 MB | 30 MB |
| 平均叶子密度 | 90.0% | 72.0% | 90.0% |
| 插入产生的 WAL | 130 MB | 157 MB | 143 MB |
在这里,WAL 差距并不大,而这正是基准测试欺骗你的方式:两次检查点之间只有一条语句,整个索引都在 128 MB 的共享缓冲区中,因此每个随机叶子最多只产生一个整页镜像。差异会在稳定状态下出现:索引变大、定期执行检查点、内存小于数据(60 秒的基准测试可能错过每个检查点)。在执行检查点的批次中,WAL: 行里的 fpi(整页镜像)对于 bigint 和 v7 每批都是 4 个,而随着索引变大,随机插入会命中更多页,v4 的这个数字从第一批的 4,818 上升到最后一批的 9,443。
两百万行之后,pgstatindex 给出的主键大小分别为 43、76 和 60 MB;叶子分别有 90%、71.6% 和 90% 的填充度;leaf_fragmentation 分别为 0%、50% 和 0%,这意味着 v4 有一半叶子在磁盘上不按顺序排列。对于相同的键宽,UUIDv4 仅仅因为半页拆分,就需要比 UUIDv7 多约 25% 的叶子页。实验会以五分之一的规模重跑全部内容并检查比例。
12-keys数据库不总能生成 ID
标识列之所以有效,是因为只有一个写入者负责计数:数据库,而且是在插入时计数。所有需要 ID 的东西都等待 returning id,而这大多数时候不需要付出代价。当某个东西必须在行到达数据库之前知道 ID 时,这种等待就不再免费:
- 离线和本地优先客户端。 飞机上的手机创建一个项目和三个指向它的任务。落地之前没有数据库可以询问。
- 乐观 UI。 请求返回之前,应用就显示新评论并链接到它。
- 一次请求中的图。 一次导入创建父行和子行,而每个子行都需要父行的 ID。使用标识列时,每一层都要一次往返,或者通过
returning来回匹配各层的行。 - 重试。 生成 ID 的客户端可以安全地再次发送同一行,因为 ID 同时也是幂等键。
- 多个数据库写入。 区域、分片或将要合并的两个数据库各自有一条序列,每个数据库都会发放 42(不同环境中的计数器会冲突)。
“UUID 很现代”不在列表中,“它能隐藏我们的行数”也不在。隐藏数量是公开 ID的职责,无论键是什么。
如果其中一种情况确实存在,你有两条路。先试便宜的那一条。
保留 bigint 键,在旁边接受一个客户端 ID。 客户端生成一个 uuid,表把它存为 client_id uuid not null,并建立 unique (account_id, client_id);服务器用 on conflict do nothing 插入,这样重试时什么也不会插入。连接仍然使用 8 字节。这适用于没有其他未同步对象会在客户端新行到达之前指向它的情况:评论、表单提交、设备发来的日志行。
当引用跨过边界时,把键设为 uuid。 如果离线子行指向离线父行,或者行在数据库之间移动且引用保持不变,那么在同步时把客户端 ID 转换为服务器 ID,会变成一张你要永远维护的映射表。让客户端的 ID 成为键。把它做成 UUIDv7,让插入表现得像序列(每百万行 143 MB WAL,而 bigint 是 130 MB),并接受每个指向它的外键都是 16 字节而不是 8 字节。对于这些应用,这是值得付出的价格。
12-keys需要 UUID 时,使用 UUIDv7
如果需要 UUID,PostgreSQL 18 已经能在数据库中生成正确的 ID:id uuid primary key default uuidv7()(在较早版本中,在应用中生成 v7)。有两个注意事项。UUIDv7 会向持有它的人泄露行的创建时间,精确到毫秒。它的顺序只在每个生成器内部成立,所以两台机器生成的 ID 不会给出精确的事件顺序。
把它存为 uuid,绝不要存为 text。一百万个 UUID 作为文本会让主键大 87%;而且文本会通过排序规则区分大小写,因此同一个 ID 的大写副本会成为一个新的“唯一”值。
一百万个 UUIDv7 值,按排序顺序分别复制到 text 主键和 uuid 主键中,因此只有类型不同:
作为 uuid 时,大写 UUID 与小写形式相等;作为文本时则不相等。
12-keys客户端的 UUIDv7 是输入,不是时钟
Postgres 保证一个会话生成的 uuidv7() 值不会倒退。对于客户端生成的 ID,它什么也不保证,因为 UUIDv7 携带的是生成设备自己的时钟,而设备时钟取决于拥有者如何设置。
一部快了五年的手机生成的 ID,会排序在服务器未来五年生成的所有 ID 之后。
一台笔记本同步一周的离线工作时,会把一周积累的旧 ID 插入索引中间,像随机键一样拆分页。在实验中,两个索引都从同一批分布在一周内的 100,000 个 UUIDv7 开始;然后一个索引获得了现在生成的 20,000 个 ID,另一个获得了在这一周中随机时刻生成的 20,000 个 ID,相当于离线客户端追赶进度。这 20,000 个迟到的 ID 让叶子填充度降到 54%,索引有 767 个叶子页;而同样的 ID 如果按时到达,叶子会保持 90% 的填充度,只占 460 页。少量迟到的同步只是噪声。如果一个应用的大多数写入都迟到,它会为这些写入付出 UUIDv4 的代价。
三条规则:
- 保留服务器时间戳。
created_at timestamptz not null default now()表示行何时到达。客户端 ID 中的时间只是一个声明。按(created_at, id)对信息流和键集游标排序,绝不要只按客户端生成的 ID 排序。 - 像验证任何输入一样验证它。 接受格式正确的 UUID。拒绝不在允许范围内的版本,以及比你能容忍的时钟偏差更超前的时间戳。
- 冲突就是冲突,绝不能覆盖。 ID 会出现在 URL 中,因此客户端可能发送一个并非自己生成的 ID。使用
on conflict (id) do update会重写别人的行,而且是在别人的账户中重写。改用on conflict (id) do nothing插入;如果没有返回任何行,就带着调用者的account_id查询该 ID。找到意味着这是重试:返回那一行。找不到意味着 ID 被别人持有:拒绝,并且错误消息不要暴露它属于谁。
12-keys账户 1 拥有一条笔记。账户 2 通过同步端点通常一开始就执行的插入或更新(upsert),发送了一行具有同一 ID 的数据;这个 ID 是它从 URL 中看到的:
行中的 account_id = 1 仍然没有改变,但它的 body 已被账户 2 的内容覆盖。没有任何操作失败,因此也没有记录日志。使用 do nothing 时,插入不会返回行,笔记保持不变,而在账户 2 下进行的后续查询找不到这条笔记,这就是拒绝请求的信号。
安全的同步插入完整写法如下:
12-keys永远不要发放计数器
大多数脚手架都会把主键放进 URL。教程生成 /invoices/10442,这会告诉任何看到它的人一些你原本没打算透露的信息。顺序 ID 是一个计数器,而计数器会回答一些问题:有多少、增长多快、下一个是什么。
把计数器留给连接。给世界另外的东西。
计数器是在邀请攻击
把 URL 中的一位数字改掉,看看返回什么。这就是全部攻击,而且它有一个名字:不安全的直接对象引用(IDOR),也就是端点加载传入的任意 ID,却不检查调用者是否有权看到它。使用顺序 ID 时,攻击者不需要猜。他只需计数:10443、10444,然后循环遍历剩余 ID。
修复办法不是换一个 ID,而是每次查询都检查授权(where account_id = $1 and id = $2),或者使用行级安全替你加上检查。OWASP 的指导很直接:不可猜的 ID 是纵深防御,而无论如何都必须有访问控制。
那为什么还要做?因为纵深防御是真实存在的。两百个端点中漏掉一个检查,是普通的 bug。使用顺序 ID 时,这个 bug 到下午结束就能泄露整张表。使用不可猜的 ID 时,它只会泄露那些已经出现在日志和截图中的 ID。
ID 会进入浏览器历史、分析系统和支持工单。对于“拿到链接的任何人都能访问”的分享场景,发放一个带有作用域和过期时间的独立随机令牌,并像凭证一样检查它。
五个 ID 就能泄露总量
第二次世界大战期间,盟军统计学家根据缴获坦克上的序列号估算德国坦克产量。传统情报认为每月约 1,400 辆。序列号给出的数字是 246。战后找到的生产记录是 245(德国坦克问题)。
估算器只有一行:看到 k 个 ID,其中最大值是 m,就猜 m + m/k - 1。账户 42 收到带有事件 ID 的 webhook,并保留了五个:
来自一个客户的五个 ID,就能把整个服务平台的事件量估算到约 2% 以内(1,958,825 对 2,000,000)。如果拿到他们自己的全部 2,084 个 ID,误差会在 0.1% 以内。
12-keys两个 ID 就能泄露增长速度
一个 ID 是数量。两个相隔已知时间的 ID 就是增长速度:今天注册一个用户,下周再注册一个用户,减去用户 ID。在本书的事件表上,这个结果是精确的:
每月重复一次,你就有了别人的增长曲线。有时这无关紧要,有时这正是竞争对手想知道的事情。
12-keys计数器会在不同环境之间冲突
每个环境都有一个项目 1234,因此关于它的 bug 报告没有说明到底是哪一个。合并两个数据库意味着给每个键及其引用重新编号(按租户路由,永远不要按 ID)。离线客户端无法生成 ID。而且 42 既可以是项目 ID、用户 ID,也可以是发票 ID,因此错误的那个会返回错误的行,而不是报错。
每种 ID 格式都在顺序和泄露内容之间做权衡
按时间排序的 ID,插入时表现得像序列;随机 ID,插入时表现得像 v4。根据你能承受泄露的内容来选择。
截至 2026 年 10 月的详情。
UUIDv4 隐藏创建时间,但 WAL 是 3.8 倍
122 个随机位。作为主键,它就是上面测得的 3.8 倍 WAL;作为键旁边的公开 ID,它可以隐藏创建时间。URL 中占 36 个字符,base32 中占 26 个字符。
UUIDv7 是默认选择,而且会泄露创建时间
对于任何必须在一个数据库之外保持唯一的新 ID,这是默认选择。任何持有它的人都能读出创建时间,因此用户的 ID 会说明他何时注册。固定的 uuidv7(interval ...) 偏移什么也隐藏不了,而每行使用一个随机偏移,则会破坏你选择 v7 的顺序性。
ULID 与 uuid 列逐字节匹配
ULID spec 采用 v7 的形状(48 位的毫秒时间戳、80 个随机位),没有版本位,写成 26 个 Crockford base32 字符。它与 uuid 列逐字节匹配,而实验中的 200,000 个 ULID 形状值让叶子页保持 90% 的填充度。添加原生类型的扩展来自第三方:先审查它们。
KSUID 对 uuid 来说太宽
KSUID 是 160 位(32 位秒数,然后是 128 个随机位),对于 uuid 太宽:存为 bytea,或者存为在 C 排序规则下比较的文本,因为 base62 需要把大写排在小写之前。
Snowflake ID 需要每个写入者都有唯一的机器 ID
Twitter 的原始 Snowflake 把 41 位毫秒时间戳、10 位机器 ID 和 12 位序列打包进一个 bigint。每个写入者都需要唯一的机器 ID,而 JavaScript 在 2 的 53 次方以上会丢失精度,因此 API 会把这些值作为字符串发送。高位携带分片信息的变体见按租户路由,永远不要按 ID。
NanoID 的长度就是它的冲突预算
NanoID 是 21 个 URL 安全的随机字符,存为 text。长度就是你的冲突预算:根据生日界限,8 个字符在约 750 个 ID 后达到十亿分之一的碰撞概率,而 21 个字符要到 410 万亿个 ID。适合邀请代码和短链接,放在唯一索引后面;不适合作为键。
前缀让 ID 说明自己的类型
前缀会标出类型(cus_、prj_)。人可以看出 ID 是什么;把客户 ID 粘贴到账户 ID 应在的位置,会一眼被发现;扫描器也可以匹配 sk_live_,捕捉泄露的密钥(Stripe 的说明)。TypeID spec(0.3.0)对其进行了标准化:小写前缀、下划线,以及 26 个小写 Crockford base32 字符组成的 UUIDv7。
Sqids 和 Hashids 会解码回计数器
Sqids 把整数转换成短字符串,也能转换回来。该项目明确说明它不是加密;一旦解码,计数器就再次泄露。
用 bigint 连接,发布 uuid
两列:
- 键是
bigint generated always as identity,紧凑,连接成本低。如果 ID 必须在数据库之外生成,而且其他行会在它到达之前指向它,就把键改成uuidv7()(数据库不总能生成 ID)。 - 公开 ID 是一个独立的
uuid,凡是其中的行会出现在 URL、API 或 webhook 中的表,都默认使用uuidv7()。应用用类型前缀渲染它,例如prj_01j6b7yh69fq2vyabwvmba4nr5,再把它解析回来。
连接仍然只需 8 字节,公开 ID 只需一个按顺序建立的索引,而且以后可以改变它的格式,不必触碰外键。创建时间敏感时,公开 ID 使用 v4。只有管理员使用的表不需要公开 ID;每个项目的 issue 编号则没问题:它们限定在租户范围内,只统计租户已经知道的内容。
在应用中编码;报告可以交给 SQL
在应用中编码,因为大多数语言都有 TypeID 库。对于视图或报告,可以用两个短 SQL 函数完成:b32_encode(uuid) 返回 26 个小写 base32 字符,b32_decode(text) 把它们转回 uuid;如果字符串格式错误,则返回 null。两者都是 immutable。
编码器先给 128 位前面加上两个零位,变成 130 位,然后每次读取 5 位:
它符合 TypeID 规范的测试向量;使用升序字母表和固定长度时,字符串的排序顺序与 UUID 完全相同。格式错误的输入会解码为 null,因此损坏的 URL 会变成 404,而不是 500。这并非没有代价:在列默认值中使用 b32_encode 插入 200,000 行大约需要 6 秒,而使用普通 uuidv7() 不到 1 秒。在写入热点路径上,应在应用中编码。
12-keys存储 uuid,打印前缀
把完整的 prj_... 字符串作为 text 存储,每个值占 31 字节,而 uuid 只占 16 字节,还让唯一索引平白大了 57%。存储 uuid。写入时,检查 cus_ 前缀是否匹配端点(这种 ID 发送给 /projects 应该返回 404),去掉前缀,解码,再执行查询:
这是一次 3 页的索引扫描:b32_decode 是不可变函数,因此规划器会把它折叠成常量。把租户也加入同一个 where 子句。公开 ID 让行难以猜测;account_id 检查让越权读取变得不可能。
接受两种形式,让 API 脱离整数 ID
/projects/4242 已经发布了吗?要摆脱它,就是一次普通的扩展与收缩迁移。先添加没有默认值的 public_id uuid,再设置默认值 set default uuidv7(),让每个新行都得到一个 ID。接着用 uuidv7(created_at - clock_timestamp()) 分批回填旧行,让每个 ID 都嵌入自己的创建时间。然后添加并发唯一索引和 not null:
在一段对外公布的弃用期内,应用同时接受两种形式,但只发出新形式;按客户端统计旧形式的使用次数;当次数归零时,停止接受整数。在此之前,授权检查会像过去一样保护你。
如果随列添加一个易变的默认值,就会重写整张表,所以要分开执行;单独执行 set default 只会修改系统目录,而且要先执行它,这样回填期间插入的行就不会出现 null。批次遵循沿主键走短批次回填;索引在回填之后建立,因为回填按键顺序写入 ID,而不是按时间顺序;not null 则先通过 CHECK。项目 4242 创建于 01:00:08.77786,变成了 prj_01j6b7yh69fq2vyabwvmba4nr5,其中嵌入了 01:00:08.777。因此每个创建日期都能从 ID 中读出;如果日期敏感,就使用普通的 uuidv7()。在应用中,全数字的 ref 会增加 legacy_id 指标,并按 id 查询;其他任何形式都会被解析并按 public_id 查询,而且始终把 account_id 放进 where。
12-keys把租户放进键里
在多租户应用中,无论模式是否这样写,租户都是每个键的一部分。把它明确写出来。
让租户无处不在
在每张租户拥有的表上都放 account_id,即使通过连接也能推导出它。每行的 8 字节可以换来无需连接的过滤条件、以 account_id 开头的索引(让一个租户的行挨在一起)、一行就能写出的行级安全策略,以及一个已经无处不在的分片键(从第一天就为未来留门)。
让跨租户引用不可能发生
运行示例中有一个隐蔽漏洞:没有任何东西阻止账户 1 的项目把属于账户 296 的用户 295 指定为自己的 owner_id。一个有 bug 的端点写入这个值,之后信任该值的查询就会泄露跨租户数据。把租户放进外键:
12-keys额外的唯一约束看起来多余,因为单独的 id 已经唯一,但正是它让外键能够检查两列。为每张被引用表保留一个索引,是多租户系统可以买到的最便宜的保险之一;即使你删除了表上的其他外键,也值得保留它(在客户能看到孤儿时保留外键)。
本章要点
- 使用代理主键
bigint generated always as identity;自然键变成unique约束。绝不要依赖序列无间隔或按提交顺序排列。 - 在定期检查点下,随机 UUIDv4 键产生的 WAL 是 UUIDv7 的 3.8 倍(每百万行 551 MB 对 143 MB),脏缓冲区是 8 倍。
- 需要 UUID 时,使用
uuidv7(),并存为uuid。它的插入表现得像序列,而且会泄露创建时间。 - 当某些东西必须在数据库生成 ID 之前知道它时,标识列就不够用了:离线客户端、乐观 UI、一次请求中构建的图、多个写入者。可以在
bigint键旁接受客户端 ID,或者在引用跨越边界时把键设为 UUIDv7。 - 把客户端 UUIDv7 当作输入:保留服务器的
created_at,验证 ID,绝不让该 ID 上的冲突更新另一个账户的行。 - 永远不要把计数器放进 URL:五个 ID 就能把 2,000,000 行的总量估算到约 2% 以内;两个相隔一周的 ID 能给出精确的周总量。
- 用
bigint连接;发布单独的uuidv7()公开 ID,以prj_加 base32 的形式渲染,并存储为uuid。这是纵深防御;每次查询上的授权检查仍然是修复办法。 - 在每张租户表上放
account_id,让索引以它开头,并使用复合外键,让跨租户引用不可能发生,即使你删除了表上的其他外键。
延伸阅读
- RFC 9562: Universally Unique IDentifiers (UUIDs),IETF。定义 UUIDv7、单调性方法,以及 UUID 为什么不是安全能力的标准。
- UUID Functions,PostgreSQL 文档。
uuidv7()及其shift参数、uuidv4()和提取函数。 - Insecure Direct Object Reference Prevention Cheat Sheet,OWASP。可猜的 ID 为什么会把一次漏检变成数据泄露。
- TypeID specification,Jetify。base32 UUIDv7 上的类型前缀,以及我们的 SQL 编码器所检查的测试向量。
14 有目的地选择约束
在我们的运行示例中,删除一个项目大约需要 100 毫秒。单看这个数字还好,直到你看清它做了什么:为了从另一张表中删除一行,它读取了 events 的全部 35,173 页,也就是 275 MB。一个缺失的索引造成了这一切。
约束不是文书工作。每一项约束都是数据库对每个写入者永远执行的保证,包括某人在凌晨 2 点手工运行的脚本。应用验证只是建议,约束才是事实。
不过,事实也有代价,外键(foreign key)会在每次写入时收取这笔费用。所以先把话说在前面:我们并不特别喜欢外键。数据就是业务本身的地方,我们会保留外键;写入像水流一样涌来的地方,我们会移除外键。本章会测量其中的原因。
每个事实只存一处
规范化(normalization)只是同一条规则换了几种名字:每个事实只存放在一个地方。一个事实存了两份,迟早会和自己不一致,只要写入者足够多就一定如此。把每个账户的 plan 复制到它的 20 个项目上,然后通过其中一行项目升级账户,账户就会同时处于两种方案。在规范化的模式中,方案只存在 accounts 的一行里。
| 范式 | 直白的规则 | 它阻止的 bug |
|---|---|---|
| 1NF | 每列一个值,不打包列表 | 无法约束或编辑单个项 |
| 2NF | 列依赖整个键 | 半个键的事实被复制到多行 |
| 3NF | 列依赖键,而不是彼此依赖 | 父项的事实被复制到子项 |
| BCNF | 决定某列的因素必须是一个键 | 列之间一条没人检查的规则 |
把 plan 复制到项目上会破坏 3NF,这是最常见的违反形式;它还会让新账户的方案无处安放,直到这个账户拥有一个项目。
13-relationships规范化到难以忍受,再测量
一次连接要付出几页的代价;一次复制则可能带来几个月后才发现的 bug。只有测量结果说明应该复制时才复制:汇总值(预计算你要展示的内容)、冻结在某个时刻的事实(例如发票行的价格),以及租户 ID(让租户无处不在)。
每份副本都必须只有一个写入者
每份副本都必须有唯一的维护者,负责让它与原始事实保持相等:如果它是键的一部分,就用约束;如果它是派生值,就用一个触发器或一个任务。永远不要依赖“每个调用方都记得”:有人第一次从 psql 写入,这份副本就会漂移。events.account_id 复制了 project_id 所隐含的账户,而复合外键(composite foreign key)能证明这份副本始终相等。其他外键都移除后,events 保留的就是这一项外键(在孤儿记录会成为客户可见 bug 的地方保留外键)。
整个修复只需要两条语句:
这个唯一约束看起来多余,因为单独的 id 已经唯一;但外键引用的列必须与某个唯一约束覆盖的列恰好一致。not valid 会跳过现有的两百万行,只检查之后的新行;稍后可以在不阻塞写入的情况下验证它们(先添加 NOT VALID 外键,再验证)。现在,把事件移动到另一个账户,或让它指向另一个账户的项目,都会在试图执行的那一行失败。
13-relationships外键要从两个方向检查,代价各不相同
projects.account_id bigint not null references accounts (id) 是一个外键:如果账户不存在,Postgres 会拒绝这个项目;如果删除账户会留下项目孤儿,Postgres 也会拒绝删除。这个约束会从两个方向检查,但代价完全不同。
插入子行时,数据库会查找父表的主键,读取几页,并在父行上取得一个 FOR KEY SHARE 锁,一直持有到提交。删除父行时,数据库会执行 select 1 from events where project_id = $1;没有任何机制要求你为 events.project_id 建索引。没有索引时,每删除一个父行,就要完整扫描一次子表。
也要检查 ORM 生成的内容。那些从 MySQL 迁移来的模式会缺少这个索引,因为 MySQL 会静默创建它(外键不会自动创建索引)。
删除每个父行都会扫描整张子表
运行示例没有为外键列建立索引。在一个我们会回滚的事务中删除一个项目:
把它读两遍。这个计划非常好:索引扫描只用了 10 个缓冲区。然后看触发器那一行:外键其实是内部触发器,而这个触发器几乎占用了全部 99 毫秒。pg_stat_xact_user_tables 显示它做了什么:顺序扫描全部 2,000,000 行事件数据,以确认没有任何一行引用这个项目。
13-relationships一条语句删除 50 个项目时,触发器行会显示 time=4214.089 calls=50:每个项目都完整扫描一次 events。代价随着子表增长,而子表正是增长最快的那张表。
一个索引把 35,173 页变成 3 页
这是一个 14 MB 的索引。现在检查只读取 3 页,而不是 35,173 页;删除 50 个项目时,触发器耗时从 4,214 毫秒降到约 1 毫秒。除非外键引用的是永远不会删除的行,否则不为外键列建索引就是一个错误。
auto_explain 配合 log_nested_statements = on(再加上 log_analyze、log_buffers 和 log_level = notice)会记录触发器自己的查询:
全部 35,173 页。建立索引后,查询会执行 Bitmap Index Scan on events_project_id_idx,只读取 3 页。删除 50 个项目时,没有索引约读取 1,760,000 页,有索引约读取 150 页。
13-relationships一条系统目录查询列出未建索引的外键
你不必手工寻找它们。每次迁移和每创建一张新表后,都运行下面的查询:
在当前加载的运行示例中,在建立上面的索引之前,它会列出五项:account_id 和 owner_id 在 projects 上,以及 events 上的三项外键。
这个查询会列出其列没有出现在某个非部分索引前导位置的每个外键。indkey 保存索引列的编号,从位置 0 开始;切片会取出与键列数相同的前导列,而 @> 会询问这些列是否包含键的每一列,顺序可以不同。(a, b) 上的键由 (b, a, c) 上的索引覆盖,却不会由 (c, a, b) 上的索引覆盖:删除时的查找需要先出现键列。部分索引不算,因为检查查询可能不满足它的谓词。
users.account_id 没有出现在列表中,因为 unique (account_id, email) 背后的索引以它为前导列。
13-relationships决定删除父行时如何处理子行
默认的 no action 会拒绝删除仍有子行的父行。cascade 会连同子行一起删除;set null 会清空子行的列(从 PostgreSQL 15 开始,只清空你点名的列,这一点对复合租户键很重要)。
谨慎使用级联
当子行没有父行就没有意义时,on delete cascade 是合适的:例如成员关系和设置行。在大型表上它很危险:通过级联删除一个大型账户,会在一个事务中删除数百万行,对每行加锁并记录日志。级联只是替你执行它所替代的 delete 语句;它只是把工作藏起来。对于大型子表,应由任务分批删除。
外键并非免费,也不总是你的朋友
下面是大多数模式建议跳过的一半事实。每个外键都会在每次向子表写入时执行一次查找、锁住一行父表,并通过你将经历的每次迁移、加载和拆分把两张表绑在一起。我们逐项测量过;正是这些测量结果,让我们只在数据本身就是业务、写入速度接近人们点击速度的地方保留外键。
外键能消除应用无法避免的竞态
它的优点确实存在。外键的锁会让父行的删除等待子行插入,从而消除应用检查无法避免的竞态。它会在传入错误 ID 的那条语句上捕获错误,而不是几周后等报告发现。它还会为规划器提供信息:在复合外键存在时,events 与 projects 按两列连接,估算结果是正确的 2,000,000 行;没有外键时则是 1,999 行。
没有外键时,规划器会把两个条件的选择率当作相互独立,然后将它们相乘。低估一千倍,就会让一个嵌套循环最终处理两百万行。你可能听到的一个优点并不成立:仅凭父表上的唯一索引,Postgres 就会删除一个未使用的左连接,无论有没有外键;但它从不会因为有外键而删除内连接。(PostgreSQL 18 的自连接消除可以移除通过唯一键连接到自身的一张表;它同样不需要外键。)
13-relationships每次插入都要为每项检查付费
我们向表的两份副本各插入了 100,000 行,一份没有外键,另一份带有 events 的三个外键:
| 插入 100,000 行 | 无外键 | 三个外键 |
|---|---|---|
| 我们机器上的耗时 | 约 100 毫秒 | 约 1,000 毫秒 |
| 触碰的缓冲区 | 305,467 | 2,103,290 |
| WAL | 22 MB | 35 MB |
在我们的机器上,耗时大约是十倍(耗时会变化,所以实验只检查是否超过四倍)。WAL 才是这里的意外之处:FOR KEY SHARE 锁存在父行的元组头中,所以获取它会产生日志;每个不同的父行只记录一次。向 events 插入数据也会写入 users。
13-relationships公平地说,要看清它在哪些地方造成影响。16 个客户端每次只提交一个事件时,磁盘把两张表的吞吐量都限制在每秒 2,300 到 2,800 次插入。设置 synchronous_commit = off 后,外键会让吞吐量降低三分之一:没有外键时每秒 88,000 到 99,000 次,有外键时每秒 60,000 到 62,000 次。它们会拖慢写入行的场景:流式写入、批量加载和回填。
每行的检查大约多触碰 18 个缓冲区,即每个外键多 6 个。插入额外写入了 40,698 条 WAL 记录,每个被锁定的父行对应一条(1,000 个账户、19,849 个项目、19,849 个用户);这些锁让几乎每个父页都变脏,所以检查点之后的第一次变更会记录整页(检查点后的第一次变化会记录整页):1,330 个页面镜像,这构成了额外 13 MB 的大部分。
一个热点父行会制造多事务 ID
一行的元组头可以容纳一个加锁者;第二个加锁者到来时,Postgres 会换成一个多事务 ID(MultiXact),也就是一份加锁者列表;每个新的加锁者又会创建一份新列表(共享行锁会制造多事务 ID,多事务 ID 也会回卷)。16 个客户端为同一个项目插入事件 10 秒,会产生大约 400,000 个多事务 ID;如果分散到随机父行上,则大约只有 500 个。
按这个速度,多事务 ID 的冻结限制(也就是 Postgres 强制清理整张表时的多事务 ID 年龄)会在不到三小时后到达,而最大客户的行会决定你的防回卷清理计划。
针对项目 7 的十个未提交插入,在它的行上留下了十个 FOR KEY SHARE 成员;为了达到这个状态,它创建了九个多事务 ID,共保存 54 个成员:存储量会随同一行上并发数的平方增长。完整运行产生了 389,000 到 441,000 个多事务 ID,以及大约一百万个成员。删除这个项目时,必须等待每个加锁者。
13-relationships添加一个外键会锁住两张表
alter table ... add foreign key 会在子表和父表上取得 SHARE ROW EXCLUSIVE 锁,即使使用 not valid 也是如此:锁持有期间,新项目会等待。可以把过程拆成 not valid 和 validate 两步,并在 lock_timeout 下运行(先添加 NOT VALID 外键,再验证)。但它仍然是一项迁移:每添加一张子表,都要触碰父表。
外键止步于数据库边界
外键不能引用另一数据库或服务;在分片之间也只有共置的表才能使用外键(约束必须包含分布列)。任何跨越你终有一天要拆开的边界的外键,都会在压力下被移除。批量加载本来就会移除外键(外键:NOT VALID,然后 VALIDATE),这等于承认:加载期间,是别的机制在保持数据正确。
在孤儿记录会成为客户可见 bug 的地方保留外键
在账户、用户、项目、成员关系和金钱上保留外键:那里出现孤儿记录,就是客户能看到的 bug。在事件、日志、指标、审计轨迹、跨边界引用和导入数据上移除外键,或声明为 not enforced。在运行示例中,events 之所以还保留外键,只是因为演示需要它们。
要谨慎选择关键字。not valid 仍会检查每一行新数据。PostgreSQL 18 的 not enforced 只是文档声明:\d 和图表工具仍会显示它,但不会运行触发器,孤儿记录可以进入,规划器也会忽略它。之后用 alter constraint ... enforced 可以重新启用它;启用时会检查所有现有行,并在遇到第一个已经进入的孤儿时失败,因此先清理它们。
即使在写入洪流上,也有一项外键要保留:复合租户键,即 (project_id, account_id) 引用 projects (id, account_id)。保留它不是为了整洁,而是因为它构成安全边界,使跨租户引用不可能发生(让跨租户引用不可能);几分钟后才运行的孤儿检查无法挽回一次数据泄露。
它并非没有代价,而且应该把这一点说清楚。它引用 projects,所以要承担前面在这个父表上测量到的一切代价:每行一次查找;每个事务中每个不同项目一次写入日志的 FOR KEY SHARE 锁;以及许多写入者集中到一个繁忙项目上时产生的多事务 ID。最大客户的项目行,正是这些代价落下的地方。我们仍然付出这笔费用,因为泄露无法挽回;要监控 projects 上的多事务 ID 年龄,别让账单出人意料。
每项结论都是这样检查的。关于锁:在一个添加 not valid 外键的未提交事务中,pg_locks 会显示 ShareRowExclusiveLock 同时存在于子表和 projects 上;另一个通过 dblink 打开的会话尝试插入项目时,会在 200 毫秒的 lock_timeout 后放弃。关于边界:postgres_fdw 外部表指向另一个数据库中的 projects,但不能被引用,视图也不能;两者都会以 42809 失败。关于关键字:一份子表副本把它的键声明为 not enforced,另一份声明为 not valid,然后分别向它们提供同一个孤儿。
13-relationships检查你不再强制执行的规则
删除约束只是转移了工作,并没有消灭它。一条写入路径会检查它为授权请求而读取过的父行。一个定时运行的孤儿检查会从高水位标记(high-water mark)开始,把事件表左连接到每个父表,每隔几分钟检查一次;每晚再做完整检查,发现行时通知值班人员。完整检查读取了 36,500 页;只检查最新 10,000 行时读取了 1,534 页。ID 并不是按提交顺序发放的(让数据库为行编号,永远不要相信顺序),所以要让标记落后于最新 ID 几分钟,并让每晚的完整运行捕获任何漏网之鱼。
这就是取舍:永远在每次写入时执行一次查找并加一把锁,或者按计划运行一条查询。数据是业务本身的地方,我们支付查找的代价;写入洪流上,我们运行查询。
只有在本次运行干净结束后,才推进标记;而且只能推进到几分钟前的某个 ID。因为它从不写入,所以副本可以运行它。我们植入两个孤儿后,它恰好返回了这两个。
13-relationships一对一拆分要付出一次连接代价,先让它值得
一对一关系会把外键设为子表的主键,例如 account_billing (account_id bigint primary key references accounts (id))。只有在一组列作为整体可选、列很大且很少读取、写入频率不同,或权限不同的情况下,才这样拆分表。每次拆分都要付出一次连接。
连接表需要在两个方向上都有索引
用户和项目通过**连接表(join table)**相遇:
主键防止重复,并服务于“这个项目的成员”查询。第二个索引服务于“这个用户参与的项目”查询,也服务于删除用户时的检查;主键无法胜任这两项用途,因为 user_id 是它的第二列。
替换多态关联
ORM 中多态关联(polymorphic association)的 commentable_type 加 commentable_id 模式无法建立外键,因此没有任何东西能阻止一条评论指向不存在的项目。为每种父对象使用一个可空外键(project_id、event_id),再加上 check (num_nonnulls(project_id, event_id) = 1)。每个引用都真实有效;要支持新的父对象类型,就新增一列。
CHECK 约束陈述一条任何代码路径都不能跳过的规则
让每一列都使用 not null,除非你能说清楚 null 对它意味着什么。除此之外,check 会陈述一条关于单行数据的规则,例如 check (status <> 'failed' or failure_reason is not null);任何代码路径都不能跳过它。CHECK 不能看到其他行(跨行规则对约束不可见),并且表达式为 null 时也会通过,因此要把 CHECK 与 not null 配对使用。
默认情况下 NULL 彼此不同
null 永远不等于 null,因此 unique 约束允许其约束列中包含 null 的行有任意多条。当这不是你想要的行为时,写成 unique nulls not distinct(PostgreSQL 15+)。
排他约束让重叠变得不可能
**排他约束(exclusion constraint)**是对 unique 的泛化:“不允许两行满足这组运算符的组合”。同一时间只能有一个部署持有某个项目的锁:
同一项目的时间范围发生重叠,就会被拒绝。应用代码无法安全完成这件事,因为“先检查是否重叠,再插入”会产生竞争。PostgreSQL 18 的 primary key (project_id, valid_during without overlaps) 是时态键的简写,并能阻止“同时生效的两个方案”。
实验构建的、用于阻止“同时生效的两个方案”的时态键如下:
它在底层与 deploy_locks 使用同一种 GiST 排他约束;因此错误会把主键称为排他约束,也因此需要 btree_gist 来支持 bigint 列。它还会拒绝空范围,这一点对本章末尾的历史触发器很重要。两张表中都已经有项目 42 的一行;向任一表插入重叠范围都会以 23P01 失败。
13-relationships可延迟约束(deferrable constraint)让交换完成
普通 unique 约束会逐行检查,所以在一次 update 中交换两个步骤的位置,会在中途失败。把它声明为 deferrable,就会在语句结束时或提交时检查(约束按语句触发,或在提交时触发)。代价是:外键不能引用它,upsert 也不能以它为目标。
假设表中有两行,位置分别是 1 和 2,交换操作如下:
没有 deferrable 时,同一个 update 会在它先移动的那一行上以 23505 失败。initially immediate 仍会在每条语句结束时检查,所以大多数代码看不出区别;set constraints ... deferred 会把检查推迟到提交时,供需要执行多条语句的事务使用。它会放弃两点:外键不能引用它(55000),on conflict 也不能把它用作仲裁器。
13-relationships一个 NULL 就会让 NOT IN 什么也返回不了
null 表示未知,而 x not in (a, null) 的含义是 x <> a and x <> null,这永远不可能为真。“项目 42 中没有事件的用户”原本统计出 99,999;直到某个事件的 user_id 变成 null,结果就变成了 0,而且没有任何错误。not exists 仍然返回 99,999。始终使用 not exists(NOT IN 是陷阱,请使用 NOT EXISTS)。
13-relationships软删除需要部分唯一索引
软删除会设置 deleted_at timestamptz 列,而不是删除行;这会破坏唯一约束:已删除的“Project 1”仍然会阻止创建新的同名项目。**部分唯一索引(partial unique index)**只在存活行之间强制唯一性:
之后每个查询都必须过滤 deleted_at is null(可以用视图或行级安全策略集中完成),并且应该由任务清理已删除很久的行。
历史记录也是你要设计的表
一次 update 会替换整行,查询看不到旧版本。“这个项目在三月时叫什么?”需要你有意保留历史记录:
| 审计行 | 触发器历史 | 时态表 | |
|---|---|---|---|
| 捕获每个写入者 | 否 | 是,replica 模式除外 | 是 |
| 知道谁以及为什么 | 是 | 只有应用传入的内容 | 只有你添加列时才知道 |
| “某一时刻”查询 | 重放 | 合并两张表 | 一个范围谓词 |
审计行由应用在同一事务中写入,因此知道原因,但只覆盖那些记得这样做的写入者(从服务器日志开始审计,免费)。像 project_plans 这样的**时态表(temporal table)**会把每个版本作为带范围的一行保存;当历史本身就是产品时使用它(例如价格、方案、权益)。
历史触发器捕获每个写入者,每行插入一次
触发器能捕获每个写入者:每次更新和删除时,它都会把旧版本复制到 projects_history,并带上 valid_during 范围,用 without overlaps 键约束它。每次批量更新都会为每行变更付出一次插入代价(行触发器每行大约需要一微秒);但它捕获不到在 replica 模式下运行的写入者,逻辑复制就是如此(COPY 会触发触发器,复制角色不会)。
now() 是事务开始的时间,因此同一事务中的两次更新会产生 tstzrange(t, t),它是 empty;without overlaps 键会拒绝它。这个中间版本从未对外可见,因此触发器会跳过它。应用通过 set local app.user_id 传入用户;使用 local 是为了避免这个值泄露给连接池中下一个借用者(连接池会泄露租户信息)。
还要知道一个边界情况:now() 是每个事务开始的时间,而不是它写入的时间。如果一个较早开始的事务,在一个较晚开始的事务已经提交了对某行的更改之后才更新该行,那么 old.valid_from 会晚于这个事务的 now()。此时触发器会跳过该版本的历史记录,并让 valid_from 向过去移动。如果并发写入下的历史必须精确,应改用 clock_timestamp() 打时间戳,并接受某个版本可能只持续几微秒。
13-relationships本章要点
- 每个事实只存一处;每份有意保留的副本都只交给一个写入者。
- 为引用侧的每个外键列建立索引。没有索引时,删除一个项目会扫描
events的全部 35,173 页。 - 外键会让每次写入付出代价:带三个外键插入 100,000 行时,耗时是无外键时的数倍(我们机器上是十倍);每个父行对应一条写入日志的锁,热点父行会产生多事务 ID,添加外键还会锁住两张表。
- 在核心业务实体上保留外键。在写入洪流、跨边界引用和导入数据上移除外键,或声明为
not enforced,并定时运行孤儿检查。复合租户键到处保留:它是安全边界,值得付出对projects的查找和加锁代价。 - 级联只用于少量依赖行。默认使用
not null;用排他约束表达“不能重叠”;用not exists替代not in;有意保留历史记录。
延伸阅读
- Constraints,PostgreSQL documentation。集中介绍每种约束类型,并说明引用列不会自动获得索引。
- CREATE TABLE,PostgreSQL documentation。介绍所有约束子句、可延迟约束、
not enforced、without overlaps和period。 - A Simple Guide to Five Normal Forms in Relational Database Theory,William Kent,Communications of the ACM,1983。用直白语言介绍各个范式,以及每种范式阻止的异常。
15 你还不需要另一个数据库
这是在一个有 200,000 行的 Postgres 表中查找会话:4 个页,数据库耗时只有几微秒。获取它所需的网络往返成本比查找本身还高;换成专用键值存储,情况也一样。
序言承诺过:产品需要的大多数东西,一个数据库就能满足。本章逐个检查这个承诺涵盖的模型:键值、文档、图、时序、队列、搜索和向量。对每一种模型,我们都会看看 Postgres 能做到多接近、要付出多少页的代价,以及什么信号说明该换另一个系统了。
每种模型各有一种形状,专门为它加速
**数据模型(data model)**是数据库假定你的数据所具有的形状;它的存储引擎就是为让这种形状运行得快而构建的。
| 模型 | 优化目标 | Postgres 工具 |
|---|---|---|
| 键值 | 按键获取和写入一个值 | 主键、不记日志表 |
| 文档 | 整体读写嵌套记录 | jsonb、GIN |
| 图 | 沿关系深入多跳 | 递归 CTE、ltree |
| 时序 | 只追加、按时间排序的范围扫描 | BRIN、分区 |
| 队列 | 把每个任务交给且只交给一个工作进程 | for update skip locked |
| 搜索 | 按相关性给文本排序 | tsvector、GIN |
| 向量 | 最近邻 | pgvector 扩展 |
每种模型都牺牲关系模型的通用性,换取在一种模式上的速度。Postgres 的可扩展性(新类型、操作符、索引方法)正是它把这种速度借回来的方式。
键值就是一次主键查找
键值存储把一个值放在一个键下面,再按键取回它。在 Postgres 里,这就是一张带主键的表;而主键查找几乎是数据库读取能做到的最便宜的操作:
一张有 200,000 行的表只需读取 4 个页:几个 B-树页和一个堆页;数据库耗时只有几微秒。网络往返才是主要成本,任何联网存储都是如此。
崩溃后,不记日志表会被清空
上面有意思的词是 unlogged。不记日志表(unlogged table)跳过预写式日志:同样插入 200,000 个会话,普通表写入了 41 MB 的 WAL,这张表则一条也没有。代价很严重:
- 崩溃后,不记日志表会被清空。 不是回滚,而是截断。正常关机会保留它;崩溃或故障切换不会。
- **它不会被复制,**物理基础备份也会跳过它的数据。
因此,只把它用于缓存可以保存的东西:用户可以重新创建的会话、限流计数器、可重新计算的结果。凡是不能丢的数据,都绝不能放进去。它没有 TTL:分批删除过期行,读取时用 expires_at > now() 过滤,并为这张表设置积极的自动清理策略(清理不可省)。
数据库内部的缓存保护不了数据库本身
当你需要在亚毫秒延迟下维持极高的操作速率、更丰富的数据结构(有序集合、发布/订阅),或者需要一道保护数据库的屏障时,就该使用专用缓存。最后这项工作无法在数据库内部完成:保护数据库的内部缓存并不会降低这个数据库的负载(缓存:数据库不是缓存)。
大多数文档都该放进 jsonb 列
大多数“非结构化”数据载荷都该放进 jsonb 列,与它们所描述的行存放在一起,而不是另用独立的文档存储。文档数据库存储嵌套记录,每条记录都整体读写;jsonb(使用 jsonb,把要查询的键放进独立列)让你在一列内部获得同样的能力:->> 可以深入取值,@> 测试包含关系,SQL/JSON 路径处理数组和嵌套结构。
GIN(广义倒排索引)会为每份文档的每个键和值建立索引,适合处理包含查询;对于包含查询,jsonb_path_ops 胜过默认配置会测量它的两种形式,并说明为什么它对选择性差的查询没有帮助。
规划器看不到 jsonb 内部
Postgres 会为列维护统计信息,规划器据此估算某个谓词匹配多少行。它不会维护 jsonb 值内部各键的统计信息,因此 payload->>'status' = 'failed' 会得到一个硬编码的 10,000 行估计,而实际有 500,420 行。这种偏差足以选错连接方式和内存预算。
建模上的教训是:如果规划器必须按某个 jsonb 字段过滤,就应该把它变成真正的列。如果它仍留在文档中,可以使用表达式统计信息(PostgreSQL 14+,create statistics events_status_stats on ((payload->>'status')) from events)或表达式索引来修正估计;函数会隐藏你的统计信息会演示这个问题和两种修复方式。
需要过滤、连接或排序的字段应该成为一列
真正多变的数据适合放在 jsonb 中:Webhook 请求体、用户定义的属性。某个字段在以下情况下就该成为一列:你要按它过滤、连接或排序;它需要约束(没有外键能指向 JSON 内部);每一行都有它(如果把列名存起来,就要重复存两百万次);或者它会独立更新(只改一个键也会重写整份文档)。存储型生成列可以在不改变写入方的情况下做到这一点,但添加它会重写整张表。
如果你面对的是海量、相互独立、永远不需要连接的文档写入,文档存储就很合适。如果你发现自己开始连接文档,那就是关系模型在要求回来。
实体-属性-值是个陷阱
迟早会有人提出这样一张表:不必迁移,就能容纳任何设置:settings_eav (project_id, attribute, value),每个项目的每项设置占一行。这就是实体-属性-值(entity-attribute-value,EAV):模式从系统目录中移出,进入数据本身。它看起来很灵活,却只是用关系模型的零件造了一个键值存储,同时丢掉了这些零件原本提供的能力。
我们为 20,000 个项目各保存了六项设置,分别采用列、每个项目一份 jsonb 文档和 EAV 三种形式,然后提出每个设置页面最终都会遇到的问题:找出位于 iad 且启用了自动部署的项目。三种形式都准确匹配 1,333 个项目。
| 形式 | 含索引大小 | 读取页数 | 估计行数(实际 1,333) |
|---|---|---|---|
| 列 | 2,376 KB | 211 | 1,333 |
jsonb | 8,504 KB | 548 | 1,414 |
| EAV | 14 MB | 1,833 | 约 35 |
EAV 占用的空间是列形式的六倍,读取的页数是九倍:其他形式为每个项目存一行,它却要存六行,而且每个条件都要做一次自连接。规划器估计会返回 35 行,实际返回了 1,333 行,因为它把 attribute = 'region' 和 value = 'iad' 当成相互独立的条件。
EAV 还会丢掉所有约束:retention_days = 'ninety' 可以写进去,属性名的拼写错误会变成一个新属性,而“每个项目都有区域”这条规则无法约束一行不存在的数据。jsonb 也会丢掉同样的约束,只是你可以手工用检查约束挽回一部分。
列版本的定义如下;六项设置由项目 ID 推导而来,因此每个计数都准确:
EAV 使用 primary key (project_id, attribute),并在 (attribute, value) 上建立索引;它通过 lateral (values ...) 从列版本填充。文档形式则是 to_jsonb(s) - 'project_id',并建立 jsonb_path_ops GIN 索引。三个查询如下:
文档检查必须同时要求键存在且类型正确,因为检查约束遇到 null 会通过,而缺少键得到的就是 null:
14-modelsEAV 已经没有胜出的场景了
EAV 的存在理由是避免迁移,但在 Postgres 中这个理由已经不成立:DDL 具有事务性,添加可为空的列只是一次系统目录变更,不会重写任何内容(常量默认值免费;易变默认值会重写)。如果设置由你的团队定义,就把它做成一列。属性不由你定义时,jsonb 是合适的选择:例如客户创建的字段、Webhook 的数据载荷。大多数真实表最终都会采用混合形式:把需要过滤和约束的内容做成列,再用一列 jsonb 存放长尾属性。
宽表:按列的读取方式拆分
一个空值只占一位(NULL 只占一位),所以 80 个大多为空的列并不昂贵。真正消耗页的是行内宽度(inline width):一个页容纳完整的行,因此只需要三列的查询,也会读取装满所有列的页。大值会移到行外的 TOAST 中;中等大小的值会留在行内。增加一个 500 字节的 description 列后,projects 表会从 192 个页增长到 1,472 个页;于是列出项目名称时,读取的页数会超过原来的七倍,仅仅是为了一个根本不会显示的列。
14-models所以,应该按列的读取方式拆分。用于列表的列留在窄的主表中,详情列移到一张一对一表中,热点计数器则移到一张单独的窄表里(把热点计数器移到窄表)。
Postgres 用三种方式存储图
图由节点和边组成:团队嵌套在团队之中,服务依赖服务。Postgres 有三种标准形状。
邻接表让移动便宜,让遍历递归进行
最简单的形式为每个节点存储 parent_id,再用**递归公用表表达式(CTE)**遍历它:一个起始查询和一个递归查询用 union all 合并起来,不断重复,直到不再出现新行。每一层都是一次连接,因此要为 parent_id 建索引(外键要从两个方向检查,代价各不相同)。移动一棵子树只需一次更新。不是树的图可能有环,而 PostgreSQL 14 的 cycle 子句会在遍历再次访问某个节点时将其停止。
让 Engineering 汇报给 Postgres,普通的递归遍历就永远不会结束。在 CTE 后面加入 cycle id set is_cycle using visited(path 列在上面的查询中已经被占用,因此路径列需要另取一个名字),它会先返回每个团队各一次,再额外返回一行标记为 is_cycle 的 Engineering,然后停止。
14-modelsltree 读取便宜,移动昂贵
contrib 的 ltree 扩展存储每个节点的完整路径,例如 eng.platform.databases,并使用 GiST(广义搜索树)索引。where path <@ 'eng.platform'(“是……的后代”)通过一次索引扫描就能返回整棵子树,不需要递归。代价转移到了写入:移动一棵子树,会重写其中的每条路径。
闭包表存储每一对祖先关系
闭包表(closure table)存储每一对祖先与后代,以及它们之间的深度(7 个团队会产生 18 行)。“Platform 下面的所有内容”只需在 ancestor_id 上做一次索引查找,无论深度是多少,还能使用真正的外键;但每次插入和移动都必须维护这些关系对。
| 形状 | 读取子树 | 移动子树 | 最适合 |
|---|---|---|---|
| 邻接表 | 递归查询 | 一次更新 | 写入密集、层次较浅的树 |
ltree 路径 | 一次索引扫描 | 重写子树 | 读取密集的层次结构 |
| 闭包表 | 一次索引查找 | 重写关系对 | 深树,以及需要双向查询的场景 |
深而密的图,值得使用图数据库
递归 CTE 应付树和几跳关系没有问题。面对大型、稠密数据上的图算法时,图数据库才值得占据一席之地:跨越数百万条边的最短路径、跨很多跳的模式匹配。在 SQL 中,每一跳都是一次连接,而指数增长的候选前沿会让你感受到它的代价(图:每一跳仍然是一次连接)。
时序适合 BRIN 和按月分区
时序数据只追加并按时间排序,就像运行示例中的 events 一样,因此表的物理顺序与 created_at 一致。**BRIN(块范围索引)**利用了这一点:每个页范围只存储最小值和最大值。在 created_at 上,BRIN 只需 24 KB,而 B-树需要 43 MB(BRIN 为每个页范围保留一个摘要)。
按月分区后,执行数据保留策略时只需丢弃一个分区,而不必执行一次巨大的 delete(为了删除而分区)。在极高的摄入速率和列式压缩场景中,时序系统会胜出(时序:写入路径就是极限);而最知名的系统之一 TimescaleDB,本身就是一个 Postgres 扩展(TimescaleDB 是带有主张的分区)。
SKIP LOCKED 把每个任务交给且只交给一个工作进程
队列就是一张表:select ... for update skip locked 让多个工作进程各自领取不同的任务,彼此之间无需等待;在与订单同一事务中入队的任务,也不可能脱离订单单独存在。Postgres 队列与业务写入一起提交会构建一个完整的工作进程,包括工作进程崩溃后任务会发生什么。消息代理或日志适合扇出给多个消费者、重放,以及每秒数万条消息的吞吐量(流:表不是日志)。
搜索不需要从搜索引擎开始
Postgres 会把文本转成由规范化单词组成的 tsvector,所以“failing”能匹配“failed”;GIN 索引让匹配变得快速,结果还能排序,完全用不着 like '%deploy%'。不用搜索引擎,也能搜索会在真实语料上构建这一套,并划出搜索引擎开始值得使用的边界(对大多数应用来说,Postgres 搜索就够了、搜索:Postgres 的排序不使用语料统计信息)。
让向量贴着它们描述的行存放
嵌入表示(embedding)会把文本或图像转换成浮点数数组,让相似的项彼此靠近。pgvector 扩展增加了 vector 类型和近似最近邻索引,因此相似度搜索可以在一条语句中连接你的数据并按租户过滤;对一个完全不了解你权限的独立向量存储来说,这是做不到的(向量搜索能找到近邻点,与文字无关)。
注意页数:一个 1,536 维向量大约有 6 KB,所以会存放在 TOAST 中;2,000 个这样的向量占用了 15 个堆页和 2,000 个 TOAST 页(1,536 维向量会存放在 TOAST 中)。这个扩展不属于 contrib,因此要确认你的托管服务允许安装它(扩展来自允许列表);当向量达到数亿个时,专用系统或许就值得承担它的成本了(向量:建立索引的列最多支持 2,000 个维度)。
第二个数据库必须证明自己值得存在
当某种负载会占去主库的大部分资源,或者你需要 Postgres 不具备的某项能力时,第二个系统才值得存在,例如极高吞吐率下的内存级延迟,或对数十亿行进行列式扫描(用测量结果证明需要第二个系统)。还要权衡它的代价:需要再备份、升级和监控一个系统,数据会发生漂移,而且两个系统之间没有事务。发给消息代理的消息可能宣布一笔随后回滚的订单;进程也可能在提交和发送之间崩溃,导致消息丢失,除非你增加一个事务发件箱(outbox),而它本身就是一张 Postgres 表(把消息和订单放进同一个事务)。
这个选择并不对称。以后把一种负载迁出 Postgres,有成熟的迁移方法可循;把五个数据库重新合并回一个数据库,则没有这样成熟的做法。
本章要点
- 一次主键查找会触碰 4 个页。不记日志表不写 WAL,崩溃会清空它们。
- 规划器看不到
jsonb内部的统计信息(估计 10,000 行,实际 500,420 行)。把你要过滤、连接或约束的字段提升为列。 - 永远不要建立实体-属性-值表:空间是六倍,页数是九倍,而且没有约束。
- 宽度会消耗页,空值不会:让列表查询使用的列保持窄。
- 层次结构可以用邻接表、
ltree路径或闭包表。时序数据使用 BRIN 和分区。队列使用for update skip locked。 - 全文检索和
pgvector都可以贴着你的数据存放;1,536 维向量会存放在 TOAST 中。 - 只有当你能说清 Postgres 缺少什么能力,以及哪项测量证明你确实需要它时,才添加独立系统。
延伸阅读
- JSON Types 和 JSON Functions and Operators,PostgreSQL 文档。
jsonb存储、索引、操作符以及 SQL/JSON 路径语言。 - WITH Queries,PostgreSQL 文档。递归 CTE、
search和cycle子句,以及物化。 - ltree,PostgreSQL 文档。标签路径、相关操作符和索引支持。
- NOTIFY,PostgreSQL 文档。投递语义和通知队列的限制。
- Postgres LISTEN/NOTIFY does not scale,Recall.ai。重度写并发下提交时锁的生产实践记录。
- What Goes Around Comes Around… And Around…,Michael Stonebraker 和 Andrew Pavlo,SIGMOD Record 2024。关系模型为何仍在不断吸收其他模型。
16 值得了解的扩展
在安装了一个扩展的环境中,我们把 200 万条与本书示例相似的事件加载进一张表。一条 alter table 加上一个循环之后,同样的数据连同索引只占 30 MB,而不是 324 MB;一个月的部署时长查询读取大约 300 个页,而不是大约 3,050 个页。在另一台服务器上,“法兰克福 50 km 内有哪些人”的查询,从读取表的每一个页变成了读取 112 个页。
这两者都不是 Postgres 核心功能。它们都是扩展;Postgres 正是通过扩展获得其他数据库作为独立产品出售的能力:新类型和新的索引方法,加载进你已经在运行的服务器(你还不需要另一个数据库)。扩展也是你没有编写、却运行在数据库进程内部的代码。下面介绍截至 2026 年 10 月值得了解的扩展、它们的代价,以及如何审查它们。
扩展是数据库跟踪的一个软件包
扩展是服务器磁盘上的一组文件(控制文件、SQL 脚本,通常还有编译好的库),create extension 会把它们变成某个数据库中的对象,并将它们作为一个整体跟踪,因此 drop extension 和 pg_dump 也会把它们当成一个整体。由此有三件事,而每一件都可能带来麻烦:它只会安装软件包管理器放到磁盘上的内容(这就是托管服务会给你一张清单的原因);它按数据库生效;SQL 对象的版本可能与库文件的版本发生漂移。
有些扩展必须在服务器启动时加载
需要共享内存、后台工作进程或规划器钩子的扩展,必须放进 shared_preload_libraries;修改它需要重启。
如果 shared_preload_libraries 中的任何库缺失或无法加载(列表中有拼写错误、软件包被移除,或者还没有为新的大版本构建),服务器就会拒绝启动,你安排的重启也会变成一次中断。先安装软件包,并在重启主库之前,在预发布服务器或备库上检查这个设置。
pg_stat_statements 则是反过来的经典陷阱:没有预加载时它可以顺利安装,但读取它时会失败,并报 must be loaded via "shared_preload_libraries"。
15-extensions.sh受信任的扩展不需要超级用户
从 PostgreSQL 13 起,被标记为 trusted 的扩展,也就是“不能提供访问数据库外部功能的途径”的扩展,任何拥有数据库 CREATE 权限的角色都可以安装:citext、pg_trgm、btree_gist、ltree 可以;会打开连接的 postgres_fdw 不可以。托管服务根本没有超级用户,因此在围绕某个扩展设计之前,先检查服务商的清单(扩展来自允许列表)。
这是每个扩展的默认版本对应的 pg_available_extension_versions。一个拥有数据库 CREATE 权限的角色安装了 citext 并编写了 PL/pgSQL;但它得到的 42501 错误来自 postgres_fdw 和 PL/Python。
15-extensions.sh版本通过 alter extension update 推进
每次软件包、次版本或大版本升级后,都要在每个数据库中为每个扩展运行 alter extension ... update。没有任何东西会替你做这件事,托管服务也一样(服务商会在 CREATE EXTENSION 上加一道自己的门槛)。而大版本升级要等到每个扩展都为新的大版本构建完成。
扩展会提供名为 extension--from--to.sql 的脚本,Postgres 会把它们串起来。从 hstore 1.4 出发,pg_extension_update_paths('hstore') 给出到 1.8 的路径 1.4--1.5--1.6--1.7--1.8,而 alter extension hstore update 会依次运行这四个脚本。在我们的实验中,同一条命令把 TimescaleDB 从 2.29.2 升到了 2.30.2,因为它的镜像会特意把旧版本的库保留在磁盘上。pg_upgrade 会带着 SQL 对象一起迁移,并为仍待执行的更新写出脚本。
15-extensions.shContrib 是最安全的一层,不过其中有些已经过时
大约 50 个扩展随 Postgres 自己的发布周期和许可证一同发布在 contrib 中。它们是最安全的一批,但其中有些已经过时:
| 模块 | 用途 | 仍然需要吗? |
|---|---|---|
pg_stat_statements | 每查询统计信息 | 到处都需要 |
pg_trgm | like '%x%'、相似度 | 需要 |
btree_gist | 排他约束中的标量值 | 需要 |
pgcrypto | 密码哈希、PGP 加密 | 仅用于 crypt() 和 PGP |
citext | 不区分大小写的文本 | 大多已被 lower() 索引取代 |
hstore | 扁平键值列 | 大多已被 jsonb 取代 |
uuid-ossp | 生成 UUID | 只为 v1, v3, v5 |
核心已经提供 gen_random_uuid()、uuidv7() 和 sha256()。对于不区分大小写的文本,我们默认使用基于 lower() 的唯一索引;citext 自己的文档则把非确定性排序规则指为另一个选择(对于电子邮件,用 lower() 做唯一键)。如果你使用 pgcrypto 的 PGP 函数,请使用 18.6 或更高版本:在此之前,OpenSSL 拒绝的一种加密算法(比如在 FIPS 模式下)会静默地产生极易被破解的数据(18.6 发行说明)。
PostGIS 是许多团队运行 Postgres 的根本原因
PostGIS 增加空间类型、函数和 GiST空间索引。它成熟且广泛提供:3.6.4(2026 年 6 月),支持 PostgreSQL 12 到 18,采用 GPL v2 或更高版本许可证;该许可证约束的是分发它,而不是让它在你的应用后面运行。
类型决定距离的含义
PostGIS 有两类类型,选择哪一类决定了“距离”意味着什么。geometry 在平面上工作,单位取自其空间参考系(SRID):经纬度使用度数(4326),投影使用米。geography 在弯曲的地球表面上工作,单位是米。法兰克福到阿姆斯特丹,有四种结果:
真实答案大约是 364.5 km。4326 中的 geometry 给出 4.4 个“度”,没有意义。大多数网页地图使用的 Web Mercator 给出 582 km,长了 60%。全球范围分布的点使用 geography,区域数据则使用投影后的 SRID 中的 geometry。永远不要用度数计算距离。
(输出已四舍五入。)经度的一度会随着向北移动而缩短,而 Mercator 离赤道越远,距离拉伸得越厉害。所有数据都应使用同一个 SRID;混用 SRID 轻则报错,粗心地使用 st_transform 时最坏会得到错误答案。
15-extensions.shST_DWithin 使用索引,ST_Distance 不使用
给本书的 100,000 个用户各分配一个靠近五个种子区域之一的最近一次出现位置 geography 点,并为它建立 GiST 索引。“法兰克福 50 km 内的用户”:
从底部向上读:一个边界框测试(&& 与扩展 50 km 的框比较)在 48 个索引页中找到 1,615 个候选,随后精确距离检查保留了 955 个。
现在看所有人最先写出的版本 st_distance(last_seen, ...) < 50000:它返回同样的 955 行,却会顺序扫描每个页,因为没有任何信息告诉规划器“低于 50 km”意味着“在这个框内”。与 st_buffer 圆相交会使用索引,但它用 32 条边画圆,漏掉了 6 个用户。使用 ST_DWithin,永远如此。
索引找到行,物理顺序决定页数
再看看缓冲区:从一张有 834 个页的表中读取 955 行,需要 773 个页。附近的用户按 ID 顺序插入,因此分散在 725 个不同的页上。cluster user_locations using user_locations_gist 按空间顺序重写了表,同一个查询只读取 112 个页。cluster 会在重写期间锁住表,而随着行发生变化,物理顺序也会逐渐衰退,因此它适合批量加载的表。
最近邻是空间应用的另一个主要查询,形式为 order by last_seen <-> point limit 5;它按距离顺序遍历索引,只读取 12 个页。
PostGIS 自己的账单会在升级时到期:它链接 GEOS 和 PROJ 库,而 Postgres 大版本升级要等到 PostGIS 为新的大版本构建完成。
15-extensions.sh<-> 索引只有在 order by 中才会使用;对于 geography,它按球面而不是椭球面排序,因此距离接近的结果可能会有轻微的顺序偏差;对返回的行计算 st_distance。
至于升级本身,postgis_extensions_upgrade() 会把 PostGIS 及其伴随扩展一起迁移。它有许多伴随扩展,只安装你实际使用的那些。另外,GiST 索引存储边界框,因此一个铺展开来的多边形,其边界框匹配的内容会远多于多边形本身;文档建议为 ST_Subdivide 切出的片段建立索引。
15-extensions.shTimescaleDB 是带有主张的分区
TimescaleDB 会把一张表变成超表(hypertable),按时间动态创建子表(分块(chunks)),为较旧的分块提供列式格式,并增量维护汇总。我们在 PostgreSQL 18 上运行了当前版本 2.30.2;它背后的公司过去叫 Timescale,现在叫 Tiger Data。
超表就是自动分区
原生分区(为了删除而分区)要求你在行到来之前创建每个分区。超表则按需创建分块:create table events (...) with (tsdb.hypertable, tsdb.partition_column = 'created_at', tsdb.chunk_interval = '7 days'),插入本书示例中的一年事件后,不需要额外 DDL 就创建了 53 个周分块。
列存储:324 MB 变成 30 MB
列存储会把一个分块重写成每批最多 1,000 行的批次;每个批次的每一列都作为一个压缩数组存储,数据按 segmentby 列分组,并按 orderby 排序:
一个月的部署时长查询从行分块读取大约 3,050 个页,从列存储读取大约 300 个页;列存储跳过了月份之外的批次,只解压查询点名的列。我们的按时间排序数据正是这种格式所针对的形状;你的数据可能压缩得少一些。代价转移到了写入:更新已压缩的行会解压并重新压缩批次,因此它适合几天后就主要只追加的数据。
15-extensions.sh在生产环境中,call add_columnstore_policy('events', after => interval '7 days') 会完成这件事,并让最新的分块继续以行存储形式存在,以便快速插入。压缩比来自 hypertable_columnstore_stats('events')。下面是月份查询涉及的一个分块:
(这个功能在 2.18 之前叫“压缩”;旧的函数名仍然有效。)
连续聚合要等刷新才会跟上
连续聚合(continuous aggregate)是建立在超表上的物化视图,TimescaleDB 会增量刷新它,只重新计算发生行变化的时间桶。自 2.13 起的默认行为会让人吃惊:它们是仅物化的(materialized only)。我们插入了一条日期为 10 月 5 日的事件,直到刷新覆盖那一天之后,它才出现在每日汇总中。设置 timescaledb.materialized_only = false,让新行合并进来,或者用策略安排刷新。
它包含 1,826 行,每天每种事件类型一行。再加入一条 10 月 5 日的部署事件后,视图显示 1,431,而表显示 1,432,直到下一次刷新。
15-extensions.sh离开 Tiger Data 的云服务,最多期待超表
在基于它构建之前,先读清这一点。LICENSE 将仓库拆成两部分:tsl 目录之外的代码采用 Apache 2.0,目录内的代码则采用可查看源码的 Timescale License(TSL)。你可以随意把它用于自己的产品,但不能把它作为托管数据库出售。列存储、连续聚合、保留策略和任务调度器都属于 TSL(版本),所以在 Tiger Data 自己的服务之外使用其他托管服务时,最多期待超表。
当列存储改变了你所需机器的规模时,TimescaleDB 才值得使用。如果你的时序数据只有一张 events 表,保留策略是“丢弃旧月份”,那么原生分区配合 pg_partman 和 BRIN 更简单,也没有许可证问题。
pg_cron 和 pg_partman 帮你把时间掌握在自己手里
pg_cron(PostgreSQL 许可证;1.6.8)从预加载的后台工作进程中按 cron 计划运行 SQL,间隔最低可到一秒。任务会随数据库一起故障切换,不需要另一个调度器主机来运行。每次运行都会进入 cron.job_run_details,而没有任何东西会清理它,因此也要为这个表安排删除任务。
pg_partman(PostgreSQL 许可证;5.5.0)管理原生分区:它预先创建分区,并在每次 run_maintenance() 运行时删除超出保留期限的分区;可以从 pg_cron 或它自己的工作进程运行(在需要之前创建分区)。
重建膨胀的表而不锁住它们
vacuum 让死空间可以重新使用,但很少把空间还给操作系统;vacuum full 则通过在 ACCESS EXCLUSIVE 锁下重写表来归还空间(大表执行 VACUUM FULL 会造成停机)。有两个扩展做同样的重写,同时允许你继续使用这张表。
我们把三张完全相同的表膨胀到 85 MB,大约是其存活数据的三倍,然后在使用它们的同时分别重建。vacuum full 把它的副本缩小到三分之一;运行期间,哪怕普通的 select 也会遇到它的lock_timeout。pg_repack(BSD;1.5.3)把副本缩小了同样的幅度,同时插入可以直接通过。pg_squeeze(PostgreSQL 风格许可证;1.9.4)也做到了同样的事。
两者都会把整张表写入WAL,副本和备份都会感受到这笔代价。先修复导致膨胀的原因。
pg_repack 通过触发器把每次变更记录到旁边的表中,复制原表,建立索引,重放日志,再交换文件;它只在开始和交换时持有 ACCESS EXCLUSIVE。它需要主键或非空唯一索引,以及容纳完整副本的空间。在复制之前,它会等待所有更早的事务:一个被遗忘的事务中空闲会话会无限期地拖住它。
pg_squeeze 改用逻辑解码,因此写入者不承担触发器代价。它需要 shared_preload_libraries;在 PostgreSQL 19 之前,它还需要 wal_level = logical;从 18.6 起,还要把它的名称加入 output_plugin_libraries,也就是新的解码插件允许列表;否则 squeeze_table 会失败并报“may not be used as an output plugin”。截至 2026 年 10 月,处于 beta 阶段的 PostgreSQL 19 会把 REPACK CONCURRENTLY 带进核心。
15-extensions.shpgaudit 记录谁做了什么,代价是日志量增加
pgaudit(PostgreSQL 许可证;18.0)按类别(read、write、ddl、role 等)以审计员要求的固定、可解析格式记录语句,也可以通过角色授权将范围缩小到特定表。它必须预加载。代价是日志量:广泛审计写入和 DDL,窄范围审计读取(先用服务器日志开始审计;它是免费的)。
向规划器提出假设问题
HypoPG(PostgreSQL 许可证;1.4.3)创建假设索引(hypothetical indexes),普通 explain 能看到它们,但磁盘上并没有它们。一次对 users.email 的查找读取了全部 1,126 个页;有了假设索引后,explain 在我们真正创建任何东西之前就选中了它。几秒钟就能测试列顺序或部分索引的谓词。pg_hint_plan(BSD;1.8.0)则反过来,通过注释指定计划;把它留给事故场景(pg_hint_plan 适合计划翻车的夜晚)。
explain analyze 会忽略假设索引,因此真实运行仍然读取了 1,126 个页;建立真实索引后,读取量降到 5 个页以下。hypopg_relation_size() 对索引大小的估计误差在 25% 以内,而 hypopg_hide_index() 会把真实索引从你的会话中隐藏,让你可以询问“如果我删掉它会怎样?”。
15-extensions.shPGroonga 搜索内置解析器无法切分的文本
pgvector 和BM25搜索扩展在搜索章集中介绍,那里会说明它们各自的许可证和运行位置(搜索扩展把 BM25 放进索引)。这里还要介绍一个:PGroonga(PostgreSQL 许可证;4.0.9)可以搜索日文和中文文本,而内置解析器按空格寻找单词,无法处理这类文本。
Apache AGE 用更好的语言表达同样的连接
Apache AGE(Apache 2.0;1.8.0)在普通表之上增加 openCypher 图查询语言。像 -[:PARENT_OF*1..]-> 这样的匹配,就是用更顺手的语言表达递归 CTE;每一跳仍然是一次连接,因此性能上的理由仍然成立。每个会话都必须 load 'age',这会与连接池发生冲突;项目从 2024 年 9 月到 2025 年 5 月一度沉寂(董事会报告)。
它返回 "Platform"、"Databases"、"Postgres",类型为 agtype。图按每个标签一张表存放,例如 org."Team" 和 org."PARENT_OF"。
在副本上运行分析引擎,永远不要在主库上运行
行存储会读取完整的行,这也是 Postgres 在大范围扫描中处于劣势的原因(汇总和列式扩展可以弥合大部分差距)。pg_duckdb(MIT;1.1.1)嵌入 DuckDB 的列式引擎,并读取 Parquet 和 Iceberg;pg_lake(Apache 2.0)让数据湖文件可以通过表访问。有些项目正在淡出:ParadeDB 已归档 pg_analytics,而 pg_mooncake 最近一次发布是在 2025 年 2 月(同年 12 月随后又出现了 v0.1.3 标签)。每一个都是进程中的第二个引擎;把它运行在副本上,永远不要运行在 OLTP 主库上。
pgmq 仍然是一张 Postgres 表
pgmq(PostgreSQL 许可证;1.13.0)把 SKIP LOCKED 队列(Postgres 队列与业务写入一起提交)包装成云队列 API:send()、带可见性超时的 read()、archive()。它仍然是一张 Postgres 表,需要同样的清理。
不受信任的语言需要超级用户
PL/pgSQL 是受信任的:它不能做 SQL 做不到的事(数据库中的代码)。不受信任的语言(plpython3u、plperlu)以服务器操作系统用户的身份运行,因此只有超级用户能用它们编写函数,托管服务也会把它们排除在外。受信任的 JavaScript 可通过 PL/v8 和 PLJS 获得。数据库中的 Python 通常应该放在应用中。
会崩溃的扩展会断开所有连接,因此要审查它
扩展代码运行在后端进程内部,而后端崩溃时,服务器会结束其他每个会话:一次糟糕的函数调用,就能断开所有连接。在依赖某个扩展之前,先问:
- 它有人维护吗? 看发布日期、它支持上一个大版本的速度,以及提交代码的人数。
- 许可证是什么,分别适用于哪些部分? 阅读完整的 LICENSE:有些项目按目录拆分许可证。
- 下一个大版本还会有它吗? 你的升级要等每个扩展构建完成。
- 你运行 Postgres 的地方能运行它吗? 看服务商清单,以及它是否需要预加载或超级用户。
- 它会对你的进程做什么? 工作进程、共享内存、每条语句上的钩子,以及 WAL。
- 退出路径是什么? 一个定义了你数据类型的扩展(PostGIS、pgvector)是长期承诺。
然后在预发布环境测试它的升级路径。
截至 2026 年 10 月。“预加载”指 shared_preload_libraries。
| 扩展 | 增加的能力 | 许可证 | 来源 |
|---|---|---|---|
| PostGIS 3.6.4 | 空间类型、GiST 空间搜索 | GPL v2+ | 第三方 |
| TimescaleDB 2.30.2 | 超表、列存储、汇总 | Apache 2.0 + TSL | 第三方,需预加载 |
| pgvector 0.8.7 | 向量、HNSW 和 IVFFlat | PostgreSQL | 第三方 |
| Apache AGE 1.8.0 | openCypher 图 | Apache 2.0 | 第三方 |
| pg_cron 1.6.8 | 按计划运行 SQL | PostgreSQL | 第三方,需预加载 |
| pg_partman 5.5.0 | 创建分区和管理保留期 | PostgreSQL | 第三方 |
| pg_repack 1.5.3 | 在线重建、基于触发器 | BSD 3-clause | 第三方 |
| pg_squeeze 1.9.4 | 在线重建、逻辑解码 | PostgreSQL 风格 | 第三方,需预加载 |
| pgaudit 18.0 | 分类、可解析的审计日志 | PostgreSQL | 第三方,需预加载 |
| HypoPG 1.4.3 | 假设索引 | PostgreSQL | 第三方 |
| pg_hint_plan 1.8.0 | 注释中的规划器提示 | BSD 3-clause | 第三方,load 或预加载 |
| PGroonga 4.0.9 | 支持所有语言的全文检索 | PostgreSQL | 第三方 |
| pg_duckdb 1.1.1 | DuckDB 引擎、数据湖文件 | MIT | 第三方 |
| pgmq 1.13.0 | 基于表的消息队列 API | PostgreSQL | 第三方 |
| PL/v8 3.2.5, PLJS 1.0.5 | 受信任的 JavaScript | PostgreSQL 风格 | 第三方 |
Contrib(预加载的 pg_stat_statements,以及 auto_explain、pg_prewarm、hstore、ltree、citext)采用 PostgreSQL 许可证,并随服务器发布。
本章要点
- 扩展是服务器上的文件,加上某个数据库中的 SQL 对象。有些需要
shared_preload_libraries和重启;所有扩展在升级后都需要运行alter extension ... update。 - 删除
uuid-ossp以及大部分pgcrypto和citext:核心函数与lower()索引已经够用。 - 在 PostGIS 中,使用
geography或投影后的 SRID,并用能使用索引的ST_DWithin过滤,永远不要用会读取每个页的ST_Distance。 - TimescaleDB 的列存储把我们的事件从 324 MB 变成 30 MB,把一个月的查询从大约 3,050 个页降到大约 300 个页。这是 Timescale License 下的代码:可以免费自托管,但不能转售。
pg_repack和pg_squeeze可以在线重建膨胀的表,而vacuum full连读取都会阻塞。- 建立索引之前,先用 HypoPG 测试它。
- 从维护情况、许可证、下一个大版本支持、可用性和崩溃风险几个方面审查每个扩展。
延伸阅读
- Packaging Related Objects into an Extension,PostgreSQL 文档。控制文件、受信任的扩展、更新脚本,以及如何编写自己的扩展。
- Additional Supplied Modules and Extensions,PostgreSQL 文档。所有 contrib 模块,以及哪些模块受信任。
- PostGIS manual: spatial queries,PostGIS 项目。索引使用、
ST_DWithin和最近邻搜索,以及每项选择背后的原因。 - TimescaleDB editions,Tiger Data。哪些功能采用 Apache 2.0,哪些功能采用 Timescale License。
- pg_repack documentation,reorg 项目。在线重建的要求、锁和选项。
- HypoPG documentation,HypoPG 项目。假设索引和隐藏索引,以及它们的限制。
17 B-树挑起大梁
大多数慢查询并没有做什么难事。它们只是每次都读取整张表去找少数几行,因为没人告诉 Postgres 应该去哪里找。
这是每当有人打开项目页面时都会运行的一条查询:
它读取了 35,249 个页才返回 20 行:每次打开页面时,都要读取这张表的 35,173 个页中的每一个(events 整整 275 MB),再加上规划和排序所需的几十个页。在我们的笔记本上,表已经在内存中,所以只花了 26 ms,这就是没人注意到它的原因。在缓存是冷的生产机器上,如果同时有 50 个人打开仪表板,这条查询就能让整个数据库停摆。
16-btree运行正确的 create index 之后,它只读取 23 个页。这是你能买到的最便宜的加速方式,而本章讲的是如何有目的地购买这种收益,同时拒绝那些只会增加成本的索引。在每个计划中,都要看 Buffers: 这一行,它统计的是 8 KB 页。页是证据;毫秒只是天气(Buffers 才是证据)。
B-树是一棵由页组成的浅树
想象一个图书馆的卡片目录:柜子上的标牌告诉你该找哪个抽屉,标签告诉你该找哪张卡片,卡片再告诉你书架在哪里。你不需要读完整个目录。B-树(B-tree)就是用 8 KB 页构成的这类目录,而书架就是堆(heap):也就是表本身,一堆无序的页(一切都从页说起)。下面是 events 的主键:
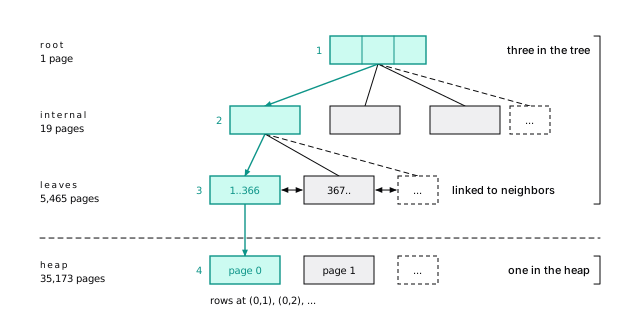
叶页按顺序保存每个键,每个键都带有一个元组标识符(TID),也就是该行在堆中的 (page, item) 地址(它的 ctid),并且还链接到相邻叶页,让范围扫描可以横向遍历。上面的页只负责说明下一步该访问哪个子节点。
关键就在这棵树的形状。每个内部页大约指向 300 个子节点,因此三层可以容纳约 3,000 万个键,四层可以容纳约 100 亿个键。让表扩大到原来的 300 倍,查找也只多读取一个页。在 查询就是页和往返中,一个主键查找读取了四个页:树中三个,堆中一个。记住这一点:
一次索引查找的成本,是树的深度加上每个匹配行对应的一个堆页。
查找在树上花费的只有三四个页,而且这个开销几乎不会增长。真正花钱的是堆页,本章剩下的内容都在讲如何少读一些堆页。
Postgres 没有聚簇索引:每个索引,包括主键在内,都指向无序堆中的位置(在 InnoDB 中,表就是主键)。
每棵 B-树的 0 号块都是记录根位置的元页面(metapage)。pageinspect 会读取它,并汇总每个页(bt_multi_page_stats 在 PostgreSQL 16+ 中可用):
根位于 412 号块,层级为 2:整棵树有三层。19 个内部页各自指向大约 289 个叶页,5,465 个叶页各自存放约 367 个 16 字节条目(一个 8 字节键,加上一个携带 TID 的 8 字节头部)。每个叶页有一个槽位是高键(high key),也就是该页的上界(第一个叶页的高键是 367,即下一个叶页的第一个 ID),因此 5,465 个每页 366 行的叶页就是两百万行。
16-btree第一个索引:35,249 页降到 91 页
先从最直观的索引开始,在 where 使用的列上建立索引:
从 35,249 个页降到 91 个页。自下而上读:
- **索引:**读取 3 个页,找到这个项目的全部 85 行。
- **堆:**读取 85 个页,每行一个(
Heap Blocks: exact=85)。这些事件在一年中随机到达,因此每一行都落在了不同的页上。 - **排序:**保留最新的 20 行。
读取 3 个页来查找,再读取 85 个页来取数据。这个比例很正常。
16-btree索引能帮多少忙,取决于匹配行有多集中
在索引中找到行很便宜。从堆中取出它们才是账单,而 Postgres 有三种方式来支付这笔账。**索引扫描(Index Scan)会在遍历索引时逐行取出数据,因此行会按顺序返回;上面计划中的位图扫描(bitmap scan)**会先收集所有匹配项,再按物理顺序每个堆页访问一次;**仅索引扫描(index-only scan)**则完全跳过堆。
这里有个不太舒服的事实:匹配行在堆中越集中,索引就越有帮助。 按项目范围请求 events 的 2% 行时,这些行分散在 68% 的页上。超过某个点后,按顺序读取整张表反而更便宜,规划器就会切换到顺序扫描。这不是规划器犯傻,而是规划器在数页。
从项目范围中取出约 40,000 行:
索引只花了 37 个页;堆花了 23,913 个页。Recheck Cond 表示堆扫描会重新检查每一行。如果位图超过 work_mem(一次操作可以使用的内存),它就会变成有损(lossy),只记住整页而不是具体行(Heap Blocks: exact=... lossy=...),然后重新检查这些页中的每一行。
16-btree最好的堆页,是你永远不会读到的
统计项目 4242 的事件不需要索引之外的任何信息,因此堆可以完全不打开:
取出同样的 85 行要付出 91 个页的代价,现在只需 5 个页就能完成计数。
问题在于:索引项不知道它指向的行对你是否可见(更新就是插入)。因此,扫描会检查可见性映射(visibility map):堆中的每个页都有一位,用来表示“这里的每一行对所有人都可见”(每页两位让扫描和清理跳过工作)。如果这一位没有设置,它仍会读取该行。清理会设置这些位。
每当看到 Index Only Scan,都要检查 Heap Fetches。如果它接近返回的行数,说明清理没有跟上,扫描正悄悄变成普通索引扫描。
多列索引:顺序就是设计
仪表板问的不是“哪些行属于项目 4242?”,而是“项目 4242 最新的 20 个事件是什么?”要为问题建索引,而不是为列建索引。
单列索引能回答第一个问题,却要把排序交给 Postgres:对 85 个事件来说没问题,面对 200,000 个事件就很痛苦。把两列都交给索引:
不需要排序。这个项目的条目按时间顺序相邻排列,所以 Postgres 从最新的条目向回走,找到 20 行就停下:3 个索引页加 20 个堆页;无论这个项目有 85 个事件还是 8,500 万个事件,代价都一样。
代价与返回的行数成正比,而不是与存储的行数成正比。这正是你要设计的目标。
16-btree先等值,再范围或排序
按姓、名排序的电话簿,可以连续找到“姓 Smith、名从 A 到 C”的人。“所有名叫 Alice 的人”则意味着要读完整本电话簿。
下面分别是在 (created_at, project_id) 和 (project_id, created_at) 上查询“这个项目,最近 30 天”的结果:
同样是 11 行,前者读取的页数却是后者的 45 倍。把 created_at 放在第一列时,Postgres 会读取最近 30 天内的每一个条目,再逐个检查项目。
两个计划都在 Index Cond 下列出两列,这就是这个错误能通过代码审查的原因。不同之处在于,究竟哪个条件限定了扫描范围。使用 (created_at, project_id) 时,只有 created_at >= '2026-09-06' 决定扫描从哪里开始、在哪里停止,所以它会读取最近 30 天的全部条目,约 164,000 个,再逐个检查 project_id。仪表板查询在这个索引上的表现更差:它反向遍历整个时间范围,寻找项目 4242,读取了 1,399 个页。(示例数据截至 2026-10-06,因此这里把日期直接写出来;在你的应用中,它会是 now() - interval '30 days'。)
16-btree这条规则可以写在便签上:
- 用
=(或in)比较的列放在前面。 - 然后最多放一列用于范围查询或
order by。 - 再往后的列只会被检查,不会缩小读取范围。
在等值列中,把你还会单独查询的那一列放在前面:(a, b) 也能单独服务于 a。PostgreSQL 18 的**跳跃扫描(skip scan)**可以挽救一个查询跳过第一列的索引,但只有在第一列的不同取值很少时才行。不要把希望寄托在它身上。
第一列只有少数几种不同取值时,跳跃扫描才有效:B-树会针对每个值各下行一次。一个 (kind, created_at) 索引统计最近一天的事件,而查询完全没有提到 kind,只读取了 44 个页,而不是 35,173 个:
Index Searches(PostgreSQL 18 的 EXPLAIN 新增)统计从根页下行的次数:普通查找为 1,这里五种事件类型是 6 次——每种类型一次,再加上一次越过索引末端。计划中的其他地方不会写出“skip”。
第一列有几千个值时,规划器会认为跳跃扫描的代价高于顺序扫描。仅按 email 查询时,若使用表上 unique (account_id, email) 背后的索引,就需要下行 1,000 次,每个账户一次,因此实际仍然读取了整张表。
16-btree覆盖索引:覆盖热点查询,而不是每个查询
假设仪表板只显示 created_at 和 kind。最新的 50 行仍然要付出 53 个页的代价,其中几乎全是为了读取 kind 而访问的堆页。把它作为附带列放进索引:
现在它是一个 Index Only Scan,只读取 6 个页。INCLUDE(PostgreSQL 11+)只把额外列存储在叶页中。代价是:索引从 60 MB 增长到 77 MB,每次插入都要写入这些字节。只覆盖每秒运行数千次的两三个查询,其他的都不要覆盖。因为 INCLUDE 列不参与唯一性判断,所以它也是在不改变“唯一”的含义时,给唯一索引增加列的唯一方式。
更新项目的 85 行,这会清除这些行所在页的全可见位,然后在 vacuum events 前后分别运行这个 50 行查询。只有下面几行不同:
计划相同,却是 180 个页对 5 个页。从堆取行的次数(99)比返回的行数(50)还多,因为这次更新在每个新索引项旁边留下了一个死索引项,扫描必须访问堆,才能知道两个版本中哪一个可见。对于 autovacuum 很少造访的只追加表(在 PostgreSQL 13 增加按插入触发的 autovacuum 之前很常见),Heap Fetches 会逐渐接近行数,覆盖索引也会悄悄失去覆盖能力。InnoDB 遵循不同的规则(在 InnoDB 中,覆盖索引几乎是免费得到的)。
16-btree只为要查询的行建索引,而不是整张表
值班页面只需要表中的一部分数据。它列出最近失败的部署,大约占事件的 6%,却要为此读取整张表。**部分索引(partial index)**只保存符合其 where 子句的行:
现在只需读取 11 个页。这个索引只有 2,768 KB,而覆盖所有行的 (created_at) 索引有 43 MB,因此它能常驻缓存,不符合条件的插入也完全不会触碰它。队列和软删除是典型用途。
有一个陷阱:规划器必须在规划时证明,你的 where 条件能推出索引的条件。把谓词中的常量写成字面量。 如果 ORM 把它们变成参数,通用计划(generic plan)就可能忽略这个索引。
通用计划只生成一次,适用于任何参数值,因此无法知道 $1 会是什么(预备语句在运行五次后切换计划)。如果还保留着那个 43 MB 的 (created_at) 索引:
部分索引被忽略了;计划沿着完整索引扫描,再过滤结果。在测试中使用 force_generic_plan,看看查询第六次执行时会怎么做。部分唯一索引可以实现“未删除用户的 email 必须唯一”(软删除需要部分唯一索引)。
16-btree索引只存储你交给它的值
索引保存的是被索引的值,而不是函数处理后的结果。给列套上一层函数,索引就看不见它了:where lower(email) = 'user4242@example.com' 读取了 users 的全部 1,126 个页。给这个表达式建索引:
现在只读取 4 个页。查询必须使用相同的表达式,写法也要相同;之后运行 analyze users,让规划器取得这个表达式的统计信息。
把它设为唯一索引,就能强制执行普通约束无法表达的规则:
现在,USER4242@example.com 会因与 user4242@example.com 重复而被拒绝。唯一索引本来就能服务查询,所以绝不要“为了性能”,在同一组列上再建一个非唯一索引。
索引表达式只接受 immutable 函数:输入相同,输出就永远相同。把 timestamptz 转换成 date 不满足这一条件,因为某个时刻属于哪一天取决于会话的时区,Postgres 会拒绝它,报错 functions in index expression must be marked IMMUTABLE。明确写出时区就可以了:((created_at at time zone 'UTC')::date)。绝不要把这个转换包装在自己标记为 immutable 的函数里来绕过检查:索引中的日期会按写入各行的会话所用的时区计算,而从另一个时区发起的查询会漏掉行。
对普通列,优先使用 unique 表约束,而不是唯一索引:它会显示在 \d 中,可以设为可延迟,也能被 on conflict on constraint 按名称引用。表达式和带 where 子句的情况则使用索引形式。
16-btree去重:重复的键只存一次(PostgreSQL 13+)
project_id 上的索引是 14 MB。主键索引同样针对这些行、同样使用 bigint,却有 43 MB。区别在于去重(deduplication):Postgres 只把重复的键存一次,后面跟上具有这个键的行的列表,这能把外键和状态列上的索引缩小到原来的三分之一左右。
更小不代表有用。kind 的五个值,每个都至少匹配表中八分之一的行,所以这些行几乎散布在每一页上。仅在 kind 上建索引后,查询 kind = 'alert' 读取的页甚至比顺序扫描更多。只有少数几个取值的列,应该放在多列索引或部分索引中,绝不要单独建索引。
重建 project_id 索引时加上 with (deduplicate_items = off),它就会变成 43 MB,和主键索引一样。叶页内部是这样的:
13 个较大的倒排列表(posting list),存下了原本需要 367 个普通条目才能容纳的内容。(kind 索引去重后缩小到 13 MB,但 kind = 'alert' 的位图扫描仍然访问了表的 35,173 个页中的 35,154 个,再加上 213 个索引页。)
只要相等的值可能具有不同的字节表示,就不能去重:包括 numeric、jsonb、float4 和 float8、数组及其他容器类型,以及使用非确定性排序规则的文本。任何包含 INCLUDE 列的索引也不能去重,这也是覆盖索引变大的部分原因。allequalimage(见 bt_metap 的输出)表明索引是否满足条件;通过 pg_upgrade 从 PostgreSQL 12 或更早版本带过来的索引,需要执行 reindex 才能使用去重。
16-btree每个索引都在向写入收税
每个索引都会让某些读取更快,让每次写入更慢,而且一直如此。我们把同样的 200,000 个事件插入了三次,每次增加一些索引:
| 表上的索引 | 缓冲区访问次数 | WAL 写入量 |
|---|---|---|
| 无 | 211,120 | 32 MB |
| 主键 | 561,333 | 45 MB |
| 主键 + 4 个二级索引 | 2,363,118 | 106 MB |
四个普通二级索引让同一次插入的缓冲区访问次数变成约四倍,WAL 量超过两倍(先记日志,再写数据)。
更新也要付费:不改变任何索引列、且新版本能放在原页上的更新是 HOT 更新,会跳过所有索引;其他更新都会向每个索引添加一个条目(冷更新会为每个索引付出代价)。
每次插入、每次非 HOT 更新、每次清理,以及缓存、WAL、副本和备份,都要为每个索引付出代价。为一个明确的查询增加索引,测量前后的差异,删除无人使用的索引。
每轮都用 explain (analyze, buffers, wal) 执行相同的插入;两轮之间执行 truncate events_w 并增加索引:
每个索引项都要单独沿树下行,弄脏自己的页,生成自己的 WAL 记录。各轮的 WAL 量会相差几 MB,取决于插入过程中是否碰上检查点,迫使它生成整页镜像;缓冲区计数则不会变化。UUIDv4 这样的随机键会让这笔税更重,因为每次插入都会落到不同的叶页(递增键追加;随机键落在任何位置)。
16-btreeidx_scan 为零只是疑点,不能据此定案
添加索引只需一行代码,却从来没人删除索引。pg_stat_user_indexes 统计每个索引的扫描次数,因此 idx_scan 为零的索引值得怀疑。在删除它之前:
- 检查计数器已运行多久(
stats_reset,见pg_stat_database)。月末报表用的索引,有 29 天看起来都没人用。PostgreSQL 16+ 的last_idx_scan会显示每个索引上次使用的时间,比重置日期更容易判断。 - 检查每个副本。 计数器按服务器独立统计;主库上闲置的索引,可能在每个副本上都承担着重任。
- 不要动唯一索引和主键索引。 它们负责强制执行约束。
- 用
drop index concurrently删除(变更模式,服务照常),并把create index语句留在手边。
重复索引就没那么难判断了。有人为外键添加 (project_id),后来又有人为仪表板添加 (project_id, created_at),第一个索引现在就只剩写入成本了:较长索引可以服务较短索引所能服务的每一种查找。
未使用的索引,按大小从大到小排列:
第二行是我们故意放进去的 project_id 索引的复制品。第一行是比较部分索引时使用的 (created_at) 索引:我们只对它运行过 explain,没有带上 analyze,这不会执行查询,因此从未计为一次扫描。
键列是另一个索引键列前缀的索引:
它只比较列号(不比较操作符类、排序规则或排序方向),并跳过部分索引和表达式索引,因此行动前要逐项检查查询结果。
16-btree从查询出发设计索引,而不是从列出发
- 从查询出发,而不是从列出发。 从
pg_stat_statements获取真实 SQL(从 pg_stat_statements 开始),记下它的计划访问了多少页。 - 等值列放在前面,然后放一列用于范围查询或
order by,让索引完成排序。 - 针对固定的数据子集,考虑部分索引;只有非常热门的查询才考虑
INCLUDE。 - 检查已有索引中,哪些会因新索引而变得冗余。
- 用
create index concurrently建立索引(根据表的流量选择索引构建方式),并比较页数。没有减少一个数量级?决定保留它之前,先弄清原因。
本章要点
- 一次查找的成本,是树的深度(3 或 4 个页),加上每个匹配行对应的一个堆页。
- 为问题建索引:先等值列,再放一个范围或排序列。错误的顺序会把 14 个页变成 643 个页。
- 仅索引扫描需要及时更新的可见性映射。关注
Heap Fetches。 - 部分索引小而便宜;把它的谓词写成字面量。
- 绝不要为只有少数几个取值的列单独建索引。
- 每个索引都向每次写入收税:多加四个索引,插入的缓冲区访问次数就变成四倍。
- 在足够长的时间窗口内,在每个副本上审查
idx_scan = 0。
延伸阅读
- Indexes,PostgreSQL 文档。官方章节,涵盖多列索引、仅索引扫描、部分索引和表达式索引。
- B-Tree Indexes: implementation,PostgreSQL 文档。结构、去重和自底向上删除。
- src/backend/access/nbtree/README,PostgreSQL 源码。由实现者介绍右向链接、高键和页删除。
- Efficient Locking for Concurrent Operations on B-Trees,Philip L. Lehman 和 S. Bing Yao,ACM TODS,1981。Postgres 兄弟节点链接背后的 B-link 树。
- PostgreSQL 18 release notes,PostgreSQL。跳跃扫描和新增的
Index Searches行。 - Anatomy of an SQL Index,Markus Winand。对叶页链和树深度最清晰的思维模型。
18 B-树之外
在同一张两百万行的表上,对同一列建两个索引。两个索引都能把 35,000 页的顺序扫描降到几百页甚至更少。其中一个的大小只有另一个的一千八百分之一:
小的是 BRIN 索引,而它究竟是绝妙还是毫无用处,完全取决于你的行在磁盘上如何排列。整章都浓缩在这一个例子里。每种索引类型都回答一个问题。问对了,它就是整座楼里最快的东西;问错了,它就是每次写入都要付费的累赘。
B-树回答的是“哪些行具有这个值?按顺序返回这些行?” Postgres 还提供另外五种索引类型:
| 访问方法 | 它回答的问题 |
|---|---|
| GIN | 哪些行包含这个元素?(jsonb 键、数组成员、单词、三字符组) |
| GiST | 哪些行与这个形状重叠、接近或包含它?(范围、几何图形、相似度) |
| SP-GiST | GiST 的同类方法,用于能够干净划分的数据(前缀、点、IP 范围) |
| BRIN | 哪些页范围可能包含这个值?(自然有序的数据) |
| 哈希 | 哪些行等于这个值?只有这个问题。 |
和 B-树一章一样,证据在 Buffers: 这一行:8 KB 页(Buffers 才是证据)。
GIN 搜索很快,更新很贵
B-树每行只有一个索引项;当你要在一个值的内部搜索时,这就没有用了:比如 jsonb 文档中的键、数组中的标签、评论中的单词。GIN(广义倒排索引,Generalized Inverted iNdex)为每个不同的元素存储一个索引项,后面跟着包含它的行,就像书末的索引:
反过来的代价是:一行会产生很多索引项,所以 GIN 搜索很快,更新却很贵。
对包含查询,jsonb_path_ops 胜过默认类
payload 保存这样的文档:{"region": "syd", "status": "failed", "duration_ms": 4242}。找出一个区域中的某个时长:
@> 表示“包含”。GIN 为 jsonb 提供两个操作符类,选择很重要:
| 操作符类 | 索引大小 | 索引部分的页数 | 整个查询的页数 |
|---|---|---|---|
| 无索引 | 35,173 | ||
jsonb_ops(默认) | 20 MB | 987 | 1,068 |
jsonb_path_ops | 14 MB | 121 | 202 |
默认类分别为键和值建索引,因此这个查询要读取 "region" 和 "duration_ms" 的列表,而它们出现在每一行中。jsonb_path_ops(using gin (payload jsonb_path_ops))把每个值连同它的路径一起哈希,因此 duration_ms = 4242 是一个稀有元素。
17-more-indexes代价是:包含查询和 jsonpath(@>、@?、@@)都能使用它,但键存在性查询(? 及其同类操作符)不能。只有当你要问“这个键存在吗?”时,才保留默认类。
没有索引时,包含查询会为 81 行执行并行顺序扫描(Buffers: shared hit=900 read=34273)。建立 events_payload_pathops 后,jsonpath 查询会使用索引:
键存在性测试不能使用它,会退回顺序扫描:
已实测的默认类数据:
17-more-indexespayload 上的 GIN 索引不能服务 payload->>'status' = 'failed' 或 (payload->>'duration_ms')::int > 1000。先提取再比较,需要在该精确表达式上建立 B-树表达式索引。把测试写成包含查询(payload @> '{"status": "failed"}')即可使用 GIN,或者把热点字段提升为真实列(你还不需要另一个数据库)。
GIN 对低选择性的查询没有帮助
索引是通往少数行的捷径。payload @> '{"status": "failed", "region": "syd"}' 匹配约 100,000 个事件,占表的 5%,而这些行分布在 35,173 个页中的 33,343 个上(Heap Blocks: exact=33343)。这次“索引扫描”几乎读取了所有数据,而且比它所替代的顺序扫描还慢。“每个区域的失败数”需要顺序扫描、汇总表,或者在你关心的那部分数据上建部分 B-树索引。
17-more-indexes数组:把它写成包含查询
GIN 对数组的工作方式也一样:对 tags text[] 列(位于 projects 表中),tags @> '{gdpr}' 读取 53 个页,而不是 507 个。陷阱在写法上。'gdpr' = any (tags) 不是 GIN 操作符,因此会执行顺序扫描。写成 tags @> array['gdpr'](如果要表达“任意一个”,则用 &&)。
一次全文 GIN 搜索读取 51 个页,而不是 6,671 个
全文搜索会把文本转换为 tsvector:一个按顺序排列的规范化词语列表(词素(lexemes),例如 “The deploys failed” 会变成 'deploy' 'fail'),然后由 GIN 为这些词素建索引。在一张包含 25 万条短评论的测试表上,搜索“deadlock”读取了 51 个页,而不是全部 6,671 个页。做法是使用一个存储的 tsvector 列、一个 GIN 索引,以及用 @@ 进行匹配。解析用户输入(websearch_to_tsquery)和排序评分(需要读取每个匹配项)属于不用搜索引擎,也能搜索一章。
两个索引页;另外 49 个是每条匹配评论对应的一个堆页。对向量和查询都显式传入配置('english'),这样词干提取才能匹配,生成列的表达式也能满足不可变性要求。
17-more-indexes待处理列表让一次插入承担许多次插入的代价
GIN 会把新索引项暂存在未排序的**待处理列表(pending list)**中,然后批量合并。默认开启(fastupdate),并且会增长到 gin_pending_list_limit,也就是 4 MB。哪次插入把它撑爆,哪次就要为合并全部 4 MB 买单。表现是:插入通常很快,偶尔有一次却要花几百毫秒。解决办法是为这个索引设置更小的 gin_pending_list_limit,或者设置 fastupdate = off,用稳定的代价替代尖峰代价。
插入 5,000 个事件(复制最新的事件),然后查看 jsonb_path_ops 索引:使用 pgstatginindex(来自 pgstattuple):
每次搜索现在还要线性扫描那 37 个页:包含查询读取的索引页从 121 个增加到 158 个。清理会合并这个列表,执行 select gin_clean_pending_list('events_payload_pathops') 也会合并。
17-more-indexespg_trgm 让前置通配符也能使用索引
B-树从字符串开头开始排序,因此它最多服务类似 like 'user42%' 的前缀查询(而且还需要正确的操作符类,下一节会说明),永远不能服务 like '%r4242@%'。pg_trgm 扩展把字符串拆成三字符组(trigrams),即每三个字符组成的序列(show_trgm('user4242')),从而让子串搜索能够使用索引:
包含 r4242@ 的字符串一定包含这个片段的三字符组,因此索引会求出它们列表的交集,再重新检查少数候选项。没有这个索引时,按 email 片段搜索会读取 users 的全部 1,126 个页。有了它:
一共 10 个页,而且这是 ilike(~~*)查询:同一个索引也能服务不区分大小写的匹配和正则表达式。模式中至少要有三个固定字符,才会有三字符组可供查找。
前缀查询需要正确的操作符类
即使 like 'user4242@%' 也不能使用 email 上的普通 B-树。在这个数据库的 en_US.utf8 这样的非 C 排序规则下,B-树顺序不是字节顺序,因此前缀不一定对应一个连续范围。使用 text_pattern_ops(按字节排序)建索引,前缀就变成了一个范围:
这个索引不能在数据库排序规则下服务 <、> 或 order by。两种需求都要?那就两个索引都建,或者在列上使用 C 排序规则。
GIN 过滤三字符组;GiST 按相似度排序
pg_trgm 也提供 GiST 操作符类。对于 like 和正则表达式,GIN 完胜:GiST 索引大小是三倍(11 MB 对 3,504 KB),却读取了 163 个页,而 GIN 只读 10 个。
但 GiST 有一件 GIN 做不到的事:按相似度顺序返回行(order by email <-> 'usr4242@exmaple.com' limit 5),也就是“你是不是想找……”查询。这是一次最近邻搜索,会按距离顺序遍历树(PostGIS 对 geography 也这样做)。GIN 用于过滤,GiST 用于按最近匹配排序。
<-> 是三字符组距离(1 减去相似度):
使用 GiST 索引时,计划是按距离排序的索引扫描:
users.email 上的三字符组索引 | 大小 | 构建时间(我们的机器) | like '%r4242@%' 的页数 |
|---|---|---|---|
GIN(gin_trgm_ops) | 3,504 KB | 140 ms | 10 |
GiST(gist_trgm_ops) | 11 MB | 550 ms | 163 |
没有 GiST 索引时,Postgres 会计算全部 100,000 个距离并排序:在我们的机器上约 90 ms,而有索引时是 15 ms。这个索引访问的页数(1,427)反而多于那张 1,126 页表的顺序扫描,因为这些合成 email 彼此很像;它节省的是 CPU,因为计算相似度才是昂贵的部分。数据越多样,剪枝效果应该越好。
17-more-indexesGiST 为没有顺序的数据建立索引
B-树需要全序,而很多类型并没有全序:到底应该把 9:00 到 17:00 放在 12:00 到 13:00 前面,还是反过来?GiST(广义搜索树,Generalized Search Tree)仍然可以为它们建立索引。每个内部条目都保存一个覆盖其下所有内容的边界值,搜索会进入边界可能匹配的每个子节点。
GiST 最出名的用途,是强制执行“这类对象不能有两个相互重叠”的规则,即排他约束;它会建立 GiST 索引,在每次插入时进行检查。假设项目可以声明部署冻结期,而且每个项目同时最多只能有一个冻结期:
这个索引揭示了一个教训。加载 480,000 个冻结期后,查询“此刻哪些项目处于冻结状态?”通过约束索引读取了 7,188 个页,而这个索引的第一列是 project_id,所以它比顺序扫描的 4,548 个页还差。只在 during 上建立 GiST 索引则需要 460 个页,其中只有 7 个是索引页。约束背后的索引,不会自动成为适合查询的好索引。
GiST 没有严格意义上的“第一列”,但第一列仍然决定条目如何分组到各个页中,因此只查询 during 时,几乎要遍历整个索引。使用 create index deploy_freezes_during_idx on deploy_freezes using gist (during) 后:
GiST 的范围操作符包括 &&(重叠)、@>(包含)、<@(被包含),以及相邻和严格左/右操作符。下面的检查还会确认约束确实起作用:新年冻结期落在已有的假期冻结期内时,会因 exclusion_violation 被拒绝。
17-more-indexes你很少会需要 SP-GiST
SP-GiST 适用的地方,B-树或 GiST 通常也能做得差不多,而它们的行为你已经熟悉了。SP-GiST(空间分区广义搜索树,space-partitioned GiST)用于可以拆分成互不重叠区域的数据(前缀、点、IP 网络),因此搜索只需沿一条路径前进。在 users.email 上,它用一个 4,672 KB 的索引、5 个页就完成了前缀查询(email ^@ 'user4242@'),索引大小与 B-树大致相同。对于 inet 的包含和范围查询,它是 GiST 的一种替代方案;两者都要基准测试。
BRIN 为每个页范围保留一份汇总
回到开头。events 是只追加表:行按 created_at 顺序到达,而且不会移动。pg_stats.correlation 衡量列的顺序与物理行顺序有多一致:created_at 和 id 为 1,project_id 约为 0.003。
BRIN(块范围索引,Block Range INdex)利用了这一点。它为每个 pages_per_range 页组成的范围保存一份汇总(默认是 128 页):最小值和最大值。想象搬家箱子上的标签。查询某一天的数据时,它会跳过标签不可能匹配的箱子,打开一两个可能匹配的箱子,再检查其中的每一行。
每个标签覆盖的事件时间跨度约为一天又三分之一。35,000 个页只需要约 275 个标签,所以大小是 24 KB。
大小只有千分之一,页数却几乎相同
按事件类型汇总一天的事件:
created_at 上的索引 | 大小 | 查询一天数据的页数 |
|---|---|---|
| 无 | 0 | 35,272 |
| BRIN,每个范围 128 个页 | 24 KB | 261 |
| BRIN,每个范围 32 个页 | 48 KB | 133 |
| BRIN,每个范围 8 个页 | 168 KB | 130 |
| B-树 | 43 MB | 115 |
B-树在页数上险胜。但它的大小是默认 BRIN 的 1,800 倍,要和数据争夺缓存,而且每次插入都要沿树下行。每个范围 32 页的 BRIN,大小不到 B-树的九百分之一,页数却只相差不超过 20 个。范围再小就不划算了:每个范围 8 页时,索引自身读取了 26 个页,而每个范围 32 页时只读 5 个,几乎抵消了它省下的 24 个堆页。
这一天是 created_at >= '2026-05-01' and created_at < '2026-05-02',并按 kind 分组。使用 create index events_created_brin on events using brin (created_at),并关闭并行:
BRIN 位图总是有损的(它们只记录页,从不记录行),因此堆扫描会读取 256 个页中的每一行,再由重新检查丢弃 9,078 行。BRIN 节点上的 rows=2560 不是行数:BRIN 会把每个匹配页报告为 10 行的占位值(totalpages * 10,见 brin.c)。pageinspect 会显示标签本身(brin_page_items(get_raw_page('events_created_brin', 2), 'events_created_brin')):
17-more-indexes没有物理顺序,BRIN 就没有用
project_id 的相关性为零,每个箱子里几乎都有每个项目,因此每个箱子都“可能匹配”。强制在它上面使用 BRIN,结果仍会读取整张表的每一页(Buffers: shared hit=50 read=35266)。
BRIN 应用于跟随插入顺序的列:只追加表上的时间戳、序列 ID、日志偏移量(为了删除而分区会把它和按时间分区配合起来)。要保护这种顺序:更新移动的行、回填旧数据,以及重新使用已释放空间的新行,都会让标签覆盖的范围变宽,直到索引不再剪枝。
VACUUM 或 brin_summarize_new_values() 会汇总索引建立后填充的页范围;在此之前,这些范围总会被扫描。在繁忙的只追加表上,创建 BRIN 索引时加上 with (autosummarize = on)。
哈希索引只有在长键等值查询上才占优
对于 令牌和内容哈希这类较长的随机值,等值查询可以使用哈希索引。除此之外,都使用 B-树。
哈希索引为每个键存储一个 32 位哈希值,并且只支持一个操作符:=。它不支持范围、排序、唯一性或仅索引扫描。作为交换,它的大小不取决于键的宽度。对于 128 个字符的 API 密钥,B-树大小为 16 MB,哈希索引为 4,112 KB,一次查找读取 3 个页,而不是 5 个。对于约 20 个字符的 email,哈希索引仍是 4,112 KB,B-树则更小。PostgreSQL 10 起哈希索引就能安全应对崩溃;它的坏名声更早。
17-more-indexes操作符决定索引类型
| 你的查询使用 | 使用 |
|---|---|
=、<、>、order by、前缀 like | B-树(非 C 排序规则中的前缀使用 text_pattern_ops) |
jsonb @>、@? | GIN jsonb_path_ops |
jsonb 键存在性(?) | GIN jsonb_ops(默认) |
jsonb ->> 配合 =、<、排序 | B-树表达式索引,或真实列 |
数组 @>、&& | GIN(不是 x = any (col)) |
全文 @@ | 在已存储的 tsvector 上建 GIN |
like '%x%'、ilike、正则表达式 | GIN gin_trgm_ops |
| “你是不是想找” | GiST gist_trgm_ops |
| 范围重叠、排他约束 | GiST(加上 btree_gist 才能混用 =) |
| 只追加数据中的时间或 ID | 如果相关性接近 1,则使用 BRIN |
长随机键上的 = | 哈希索引 |
无论选择哪种,都要测量前后的页数。这些索引每一个都会增加写入代价,GIN 尤其如此,因此只保留能带来一个数量级收益的索引。
本章要点
- GIN 为值内部的元素建立索引。搜索快,更新贵;插入延迟出现尖峰,通常意味着待处理列表正在起作用。
- 对 jsonb 包含查询使用
jsonb_path_ops:索引读取 121 个页,而不是 987 个。GIN 不能服务payload->>'key' = 'x'。 - 对
like '%x%'使用三字符组 GIN 索引;三字符组 GiST 只用于按相似度排序。 - GiST 处理重叠和距离。约束背后的索引不会自动成为适合你查询的好索引。
- 自然有序的列上的 BRIN 很小(24 KB 对 43 MB 的 B-树),范围查询效果却几乎一样;在没有相关性的列上,它会读取整张表。
- 哈希索引只有在长键等值查询上才值得使用。
- 索引只对有选择性的查询有帮助:GIN 查询即使只匹配 5% 的行,也仍然读取了 95% 的页。
延伸阅读
- Index Types,PostgreSQL 文档。所有访问方法及其操作符的官方概览。
- GIN Indexes、GiST Indexes、SP-GiST Indexes、BRIN Indexes 和 Hash Indexes,PostgreSQL 文档。每种类型各有一页参考文档,包括内置操作符类。
- src/backend/access/brin/README,PostgreSQL 源码。范围映射和汇总的布局方式,以及汇总索引为何可以如此之小。
- pg_trgm,PostgreSQL 文档。三字符组操作符、相似度阈值,以及 GIN 和 GiST 操作符类。
- jsonb Indexing,PostgreSQL 文档。
jsonb_ops与jsonb_path_ops的区别,以及它们各自支持的操作符。 - Operator Classes and Operator Families,PostgreSQL 文档。
text_pattern_ops等操作符类的说明。
19 读计划,不看时钟
这个查询在我们的机器上返回 20 行,大约需要一秒半:
在 explain (analyze, buffers) 下运行它,其中一行就能解释一切:
loops=20。内部部分对每个用户运行一次,每次都读取整张 events 表:为了返回 20 行,进行了 703,463 次页访问,访问量超过 5 GB。读懂这一行之后,修复方法就会显现出来:它能让这个查询的页访问次数从 703,714 次降到 331 次。
大多数人读计划时只盯着毫秒数。不要这样做:计时会随着缓存和负载变化。计划还会告诉你每一步预计有多少行、实际得到多少行、运行了多少次,以及触碰了多少页;这些信息才会指向修复方法。读计划不是一门艺术,而是一份按顺序检查的短清单。
这里的所有计划都来自 PostgreSQL 18,在本书的 events 表上真实运行(2,000,000 行、35,173 页,除非特别说明,否则只有一个主键)。你的页数和行数应当相同或接近,但计时不会相同。计划行很长,因此我们把本节不讨论的部分缩写成 ...;估计值和实际值都重要时,则把它们折成两行。
EXPLAIN 负责猜测;EXPLAIN ANALYZE 负责运行
explain 会询问规划器(planner)“它将会怎么做”:不会运行任何东西,你只能看到估计值。查询需要一个小时才能完成时,这正是合适的工具。其他时候使用 explain analyze,它会运行查询,并把现实放在预测旁边输出。下面是 explain analyze select * from events where kind = 'alert';普通的 explain 只会输出第一个括号和 Filter:
PostgreSQL 18 默认会输出 Buffers:;旧版本需要 explain (analyze, buffers)。本书把这个选项明确写出来,这样各版本都能使用。
explain analyze 用在 insert、update、delete 或 merge 上会真正执行写入。务必把它包在 begin …… rollback 中;还要当心那些会调用带副作用函数的 select 语句。
explain analyze delete from events where created_at < '2025-10-11' 在 rollback 之前确实删除了 27,397 行(并弄脏了 482 个页)。没有任何东西被复制回来:这些行被一个随后中止的事务盖上了标记,因此它们仍然可见(更新就是插入)。回滚撤销的是删除,不是一切:行确实被锁定了,触发器确实触发了,序列确实前进了,WAL 也确实写入了。
18-explain其他选项还包括:costs off 隐藏估计值;timing off 跳过那些运行数百万次的节点的逐节点计时;settings、wal 以及 PostgreSQL 17 的 serialize 和 memory 会添加与名称相符的信息;PostgreSQL 16 的 generic_plan 会像预备语句那样,使用 $1 占位符解释查询(预备语句在运行五次后切换计划);format json 供工具使用。
计划是一棵树;从里向外读取
计划是一棵由**节点(nodes)**组成的树。每个节点完成一项工作(扫描、连接、排序、聚合),从下面的节点取行,再把行交给上层。缩进显示树的结构,-> 标记子节点。行从叶子节点开始产生,所以要从最内层节点向外读取,就像一份把第一步写在最后的菜谱。下面是一个两表连接;每个节点的估计值和实际值都折成两行,中间节点的 Buffers: 行则省略了:
(为了保持简短,捕获时设置了 max_parallel_workers_per_gather = 0。)同一棵树画出来是这样:
从底向上看:扫描 projects,保留已归档的项目,建立哈希表。扫描 events,保留最近一周的数据,再在哈希表中查找每一行。排序,然后按名称计数。
一个节点的数字包含其子节点的数字
每个节点都有相同的组成部分。把那份计划中的 events 扫描拆开来看:
第一行是猜测;其余部分是实际发生的事情。大多数诊断工作就是比较 4 和 8、用 9 相乘,再读取 11。还有两条规则:
- 时间和缓冲区是累积的。 一个节点的数字包含其子节点的数字。减去子节点,才能看到节点自己做了什么。
actual time=A..B表示到第一行(A)和到最后一行(B)分别需要多少毫秒。A很大,说明在输出任何结果之前就做了工作,例如排序或建立哈希表。Hash Join在 82 ms 时才产生第一行,是因为events扫描在找到一行近期数据之前已经读了大部分表。
顶部的 GroupAggregate 报告了 shared hit=2835 read=32532,整棵树一共 35,367 个页。其中 events 扫描占了 35,173 个,Hash 节点处理 projects 占了 191 个。剩下的 3 个页由连接、排序和聚合共同使用:它们都在内存中完成。在慢计划里,用这种减法就能找到大数字从哪个节点开始出现。
18-explain代价是用虚构单位做出的猜测
cost=0.00..60173.43 是估计的启动代价和总代价,单位规定为顺序读取一个页的代价是 1.0。规划器会给它考虑的每份计划定价,然后运行代价最低的那份。代价的用途就这些。它不是毫秒,不能跨查询比较,而且代价高也不一定慢。用代价解释规划器为什么选择了某份计划;用行数、循环次数和缓冲区诊断问题。这些单位价格的解释见规划器是代价计算器。
kind = 'alert' 的扫描代价由页数和逐行 CPU 工作组成,每项都按配置的价格计算:
这与计划中的数字精确到小数点后两位。计数来自 pg_class.relpages 和 reltuples,它们由 vacuum 和 analyze 保持更新。reltuples 是一个估计值(恰好有 2,000,000 行的表被估计为 2,000,034),而每次实验运行都会重新分析自己的副本,所以它会上下浮动几行。这就是上面连接计划中的 created_at 扫描代价为 60173.53 而不是 60173.43 的原因:公式相同,只是 reltuples 略有不同。你的副本可能相差几分钱,但公式仍会精确匹配你的计划。
18-explain乘上循环次数;缓冲区已经是总数
有些节点会运行不止一次。嵌套循环的内侧会对外侧的每一行运行一次,而 loops 就是在统计运行次数。actual time 和 rows 是每次循环的值;缓冲区是总数。
这就是开头那个查询。它的内部 Limit 报告 actual time=70.407..70.408 ... loops=20:70 ms 看起来无害,直到你乘以 20,得到完整的 1.4 秒。它的缓冲区已经是总数:703,463 个页,也就是表的 35,173 页乘以 20。在这棵子树的底部:
没有任何东西能按用户查找事件,所以每次循环都会读取整张表,再丢弃将近两百万行。内部查询要问的是“某个用户最新的事件”,这正是索引应该回答的问题:
仍然是 20 次循环,但现在每次只需四个页(三层索引页和一个堆页)。整个查询从 703,714 页降到了 331 页,在我们的机器上还从 1,409 ms 降到了 0.6 ms。只要 loops 大于 1,就先乘起来,再判断节点是否重要。
计划的其余部分,也就是找出 20 个用户,占 251 个页;内部子树则包含其余全部开销。修复所用的索引还覆盖了未建索引的外键 events.user_id(一条系统目录查询列出未建索引的外键)。
18-explain比较估计行数和实际行数
计划中的每个选择都建立在估计值上,因此这个习惯最有回报:从叶子节点开始,逐个节点比较估计行数和实际行数。 相差 2 倍或 3 倍通常无关紧要;相差 10 倍或更多,往往意味着上层做出了错误选择。
在 kind = 'alert' 的计划中,rows=245404 是估计值,rows=249714.00 是实际结果:误差在 2% 以内,因为规划器的统计信息知道 kind 的全部五个取值。统计信息来自表的随机抽样,因此你的估计会略有不同,但应当接近。这就是好的情况。
现在看一个坏的情况。值班仪表板要列出过去一周失败部署最多的十个项目(kind = 'deploy'、payload->>'status' = 'failed'、一个 created_at 范围,并连接 projects)。它读取了 42,397 个页:整张表,再为每个匹配的事件查找一次 projects。在 created_at 上建立索引后降到了 7,990 个页;这看起来像是胜利,直到你继续看这些页究竟花在哪里:
events 扫描估计为 rows=49,实际得到 2,402:在最低层节点就是 49 倍的误差。49 次项目查找适合用嵌套循环(Nested loop)连接;但对 2,402 次查找来说,它花了 7,206 个页,而把 projects 的全部 191 个页哈希一次更便宜。49 是一个固定猜测:在你要求之前,Postgres 不会为 payload->>'status' 这样的表达式保存统计信息(函数会隐藏你的统计信息)。有了表达式统计信息(PostgreSQL 14+):
估计值变成 2,558,规划器自行切换到哈希连接:从 7,990 个页降到 975 个页。不需要重写查询,只是提供了更好的信息。这就是大多数“规划器怎么这么蠢”的抱怨背后的模式。
18-explain缓冲区才是证据
Buffers: 统计 8 KB 页数,而这正是整本书讨论的对象;它是计划中最诚实的一行。
shared hit 页已经在shared_buffers中;shared read 页是向操作系统请求的页;写入时会出现 dirtied 和 written;temp 表示排序或哈希已经溢出到磁盘。
hit + read 是页访问次数,而且具有确定性:相同查询、相同数据,每次运行的总数几乎相同。命中数取决于还有什么工作运行过。比较计划时看总数;解释某一次运行时再看两者的拆分。
read 不一定意味着磁盘读取:它表示“页不在 shared_buffers 中,所以 Postgres 向内核请求了它”,而内核可能从自己的页缓存中回答(“Read”不等于“来自磁盘”)。不要用大扫描的 I/O Timings 判断它到底来自哪里。在 kind = 'alert' 的计划中,35,079 次读取只显示约 1 ms 的 I/O 时间,也就是每页约 33 纳秒;这比从任何缓存复制一个页还快。这是因为 PostgreSQL 18 会异步预读:后台 I/O 工作进程(io_method = worker,默认值)会在扫描请求之前取回页,而 I/O Timings 只统计查询自身实际等待的时间。在带有网络存储的冷服务器上,同样的计数可能需要几秒钟,那些等待也会显示出来。
大扫描的第二次运行也不会全都变成命中:大扫描使用一个由少量缓冲区组成的环(大型操作会使用环)。而普通读取中的 written,例如上面的 written=3,表示查询为了腾出空间,不得不刷写别人的脏页(你的查询不该负责写出脏页)。
Filter 表示行已经被读出并丢弃
每份计划的叶子节点都会读取表:Seq Scan、Index Scan、Index Only Scan 以及位图扫描这一对节点,索引能帮多少忙,取决于匹配行有多集中一节都解释过。对它们中的任何一个,都要区分 Index Cond 和 Filter。Index Cond 缩小了读取范围;Filter 表示行已经读出,然后又被丢弃,数量记录在 Rows Removed by Filter 中。索引扫描中这个数量很大,说明某个条件没法使用索引:可能是列顺序、列上的函数,或类型不匹配。
每种连接方法只适合某些行数
Postgres 有三种方式连接两个输入,而错误的行数估计会选出错误的方式:
- 嵌套循环(Nested loop): 外侧(第一个)子节点每产生一行,就运行内侧(第二个)子节点一次。外侧很小、内侧是索引查找时非常出色;外侧很大时则糟糕。
- 哈希连接(Hash join): 把内侧子节点装入哈希表(
Hash节点),再让外侧子节点流过它。它适合大型、无序的输入。当表的大小超过work_mem乘以hash_mem_multiplier后,就会在磁盘上拆成多个Batches。 - 归并连接(Merge join): 按连接键的顺序遍历两个输入,就像合并两个已排序列表。两边都从已经排好序的索引中出来时,代价很低。
规划器按代价做选择,因此它的选择好不好取决于行数估计是否准确,前面 49 行的嵌套循环已经展示了这一点。每种方法为什么会在自己的场景中胜出,以及嵌套循环中可能出现的 Memoize 缓存,见每种连接方法都在代价曲线的某处获胜。
在并行查询关闭的情况下,把 30 天的事件连接到用户(where e.created_at >= '2026-09-06'):
Batches: 1 表示哈希表装得下:7,274 KB 超过了默认的 4 MB work_mem,但 hash_mem_multiplier(默认值为 2)允许哈希表使用两倍,也就是 8 MB。批次数会根据规划器对大小的估计预先选定,因此这里的 Batches: 1 也表示规划器预计它能装下。把 work_mem 降到 1 MB 后,就会得到 Batches: 4 和 temp written=474:结果仍然正确,但更慢,并且能在 temp 缓冲区中看到。
18-explain先修页数,再提高 work_mem
排序和哈希每个节点最多获得 work_mem(默认 4 MB),超出后就会溢出到临时文件。一个月度报告按用户排序 30 天的事件(where created_at >= '2026-09-06' order by user_id, created_at):
external merge 加上 Disk:,再加上 temp 缓冲区,说明发生了溢出。诱人的修复方法是增加内存,而且确实有效:使用 set local work_mem = '32MB' 后,排序变成了 quicksort Memory: 12566kB。总时间没有变化(153 ms 对 148 ms,仍在噪声范围内)。
再读一遍计划,你就能看出原因。扫描在 101 ms 时完成;排序只增加了约 43 ms。真正的代价是为表中 8% 的数据读取全部 35,173 个页,而在 created_at 上建立索引就能解决这个问题(即使是一个很小的 BRIN(块范围索引)也行:BRIN 为每个页范围保留一份汇总)。先修页数,再调内存。 确实需要处理溢出时,为该事务提高 work_mem,使用 set local,不要全局提高:每个连接中的每个排序和哈希节点都可能拿到这么多内存(work_mem 是按节点计算的,而且可以看到)。
在内存中排序需要 12.5 MB,而磁盘上的数据只占 5.5 MB:内存中的元组带有额外开销。除了 quicksort 和 external merge,你还会遇到 top-N heapsort(在 limit 下只保留 N 行)和 incremental sort(输入已经按键的某个前缀排好序)。哈希聚合也会溢出(PostgreSQL 13+),像哈希连接一样显示 Batches 和 Disk Usage。
18-explainLimit 押注于尽早找到行
Limit 一旦取得足够的行,就会停止继续拉取,因此规划器偏爱能便宜地产生前几行的计划,赌它不需要把计划跑完。它要是判断错了行在哪里,代价就会很高。请求 user_id 最小的十个事件,再与 users 连接;events.user_id 上没有索引时,计划会读取 35,176 个页,把 events 的副本溢出到磁盘,并耗时超过半秒。
完整的嵌套循环代价超过 40 亿个单位,但 Limit 的代价只有 20,860,因为规划器假定排在前面的用户会有很多事件。它按 ID 顺序遍历用户,每遇到一个用户,就重新扫描包含全部两百万个事件的副本。用户 1 和 2 没有事件,所以前两次循环白白读完了所有数据,直到第三个用户才找到十行。
在 events (user_id) 上建立索引后,只读取 16 个页。(要跟着做吗?先删除循环一节创建的 (user_id, created_at) 索引,否则它也会服务这个查询。)没有支持索引的 order by ... limit 是经典的“开发环境很快、生产环境很糟”的计划:当 Limit 位于昂贵子树的上方时,要问问有没有索引能按顺序把行交给它。
loops=3 乘以 1,418,191 行,就是计划中的 Rows Removed by Join Filter: 4254564 所代表的 425 万行;物化的 events 副本也溢出到了磁盘。有了索引,我们的副本选择了两个索引扫描组成的归并连接;另一份套件的副本因为抽样统计信息略有不同,选择了带 Memoize 的嵌套循环(9 次命中、1 次未命中)。两者的代价相差不到几个百分点,读取的都是同样的 16 个页。
18-explain并行查询更快,但不更便宜
扫描足够大时,Postgres 会把它分给多个工作进程(workers):Gather 节点位于 Parallel Seq Scan 之上,由领导者(leader)加两个工作进程组成,因此 loops=3。这样统计部署数量仍然会读取全部 35,173 个页。并行通过投入更多核心让大扫描更快完成,所以在繁忙的服务器上,如果一个常用查询需要并行顺序扫描,那它就需要一个索引。
每个进程扫描自己负责的一部分页,并统计其中的数量;Gather 收集部分计数,再交给 Finalize Aggregate。rows=166664.00 乘以 3 就是 499,992 个部署。Workers Launched 小于 Workers Planned,表示服务器没有空闲的工作进程槽位;Gather Merge 是保持顺序的变体。计划会得到多少工作进程,见并行计划和其他计划一样按代价定价。
18-explain慢查询的方法
上面的内容可以归纳成一份清单。按顺序执行;大多数问题会在第 4 步暴露出来。
- 取得真实计划。 在生产规模的数据上,使用真实参数值运行
explain (analyze, buffers)。把写入包在begin/rollback中。运行太慢?使用普通的explain,并让 auto_explain 从生产环境记录真实计划(auto_explain 会记录你之后无法复现的计划)。 - 读最上面一行。 问问答案应该花多少代价:20 行应该只需要几十个页,而不是几万个。
- 找出缓冲区花在哪里。 向下走,找到大数字开始出现的地方。减去子节点的数字;乘以
loops。 - 从底向上比较估计行数和实际行数。 最低层节点相差 10 倍或更多时,通常就是根因;上面的所有节点都是按另一种查询规划的。
- 检查常见嫌疑。
Rows Removed by Filter远大于返回行数(索引缺失或无法使用);loops达到几千;出现external merge、大于 1 的Batches或temp缓冲区(发生溢出);Heap Fetches接近行数(清理落后);Limit位于昂贵子树上方。 - 只修一件事。 建索引、重写查询,或提供更好的统计信息。
- 再次测量并比较缓冲区。 把修改前后的计划保留在拉取请求中,这样下一个人就知道为什么要有这个索引。
本章要点
explain (analyze, buffers)会运行查询,并把现实放在估计值旁边。把写入包在begin/rollback中。- 从最内层节点向外读取计划。时间和缓冲区是累积的:减去子节点。
actual time和rows是每次循环的值:要乘以loops。70 ms 乘以 20 次循环,就是完整的 1.4 秒。- 从底向上比较估计行数和实际行数。行数被低估了 49 倍,因而选用了嵌套循环;哈希连接的页访问次数只有它的八分之一。
- 用缓冲区作为证据:
hit + read在多次运行间稳定,毫秒数则不稳定。 - 溢出的实际代价没有看起来那么大。先修扫描,再提高
work_mem,使用set local。 - 每增加一个索引,都保留修改前后的计划。
延伸阅读
- Using EXPLAIN,PostgreSQL 文档。官方演练,至今仍是了解计划输出的最佳一手资料。
- EXPLAIN,PostgreSQL 文档。介绍所有选项,包括
BUFFERS(18 中默认启用)、WAL、SETTINGS、SERIALIZE和MEMORY。 - auto_explain,PostgreSQL 文档。记录生产环境中无法手工重新运行的慢查询计划。
- explain.depesz.com 和 explain.dalibo.com,Hubert Lubaczewski 和 Dalibo。粘贴一份计划,就能看到高亮的时间和行数去向。
20 规划器也在估算
下面是一条查询某个账户内某个项目的 85 个事件的语句:
规划器预计会得到一行:
估算差了 85 倍,但没有任何东西坏了。这张表一分钟前才做过分析,规划器使用的每个数字都是正确的。它做了一个不适用于这份数据的假设;除非你告诉它实际情况,否则它会一直这样假设下去。
大多数糟糕的计划都从这样的差距开始。规划器不了解你的数据。它根据一份很小的数据摘要进行估算,而且通常估得不错。弄清它知道什么、又假设了什么之后,“规划器怎么这么蠢”就会变成一个可以指出并修复的具体估算错误。
规划器是代价计算器
Postgres 不会尝试执行各种计划来看看哪个最快。它会列出候选方案(扫描每张表的所有方式、所有连接方法和连接顺序),用公式为每个方案计算代价,然后运行代价最低的那个。一个计划的代价取决于两件事:每一步会产生多少行,这来自统计信息;每个工作单位的代价是多少,这来自少数几个设置。
行数估得准,哪怕代价估得粗糙,通常也能得到好计划。行数估错了,单靠调整代价无法弥补。所以本章讨论的是估算。规划器如何把这些估算变成扫描、连接和连接顺序的选择,见代价最低的计划胜出。
每个代价都相对于一次顺序页读取
代价是以一个数为基准的任意单位:顺序读取一个 8 KB 页的代价是 seq_page_cost = 1.0。其他一切都相对于它计算代价:
| 参数 | 默认值 | 它计算的代价 |
|---|---|---|
seq_page_cost | 1.0 | 顺序扫描时读取一个页 |
random_page_cost | 4.0 | 无序获取一个页(索引扫描) |
cpu_tuple_cost | 0.01 | 处理一行 |
cpu_index_tuple_cost | 0.005 | 处理一个索引项 |
cpu_operator_cost | 0.0025 | 计算一个运算符或函数调用 |
一次顺序扫描的代价,是页数乘以 seq_page_cost,加上行数乘以 cpu_tuple_cost,再加上每行每个过滤条件对应的一个 cpu_operator_cost(精确到分)。公式本身不是难点。注意其中大部分项目都乘以什么:行数。真正的工作量就在这里。
random_page_cost 是一个比值,不是测量值。默认值 4.0 源自旋转磁盘;使用 SSD 的系统通常设为 1.1 到 2(random_page_cost 假定使用旋转磁盘)。而 effective_cache_size 根本不是代价:它告诉规划器可能有多少数据已经缓存在内存中(effective_cache_size 是提示,不是内存)。
计划看起来不对时,人们的本能反应是不断微调 random_page_cost,直到计划翻转。若把它设为全服务器范围,这样做只是通过让规划器以另一种方式误判其他每条查询来修好一条查询,其中一些查询还会翻到足以拖垮服务器的计划。先修正估算。只有为了描述硬件特性,才应一次性为整台服务器调整代价参数。
pg_stats 是规划器看到的全部信息
行数估算来自 ANALYZE 保存的统计信息,而 pg_stats 视图会按每列一行显示这些信息。对于 events 来说(ANALYZE 会随机抽样,所以你看到的末位数字会不同):
这就是规划器看到的一张两百万行表的全部信息:
null_frac:空值所占的比例。(在projects中,archived_at的空值比例为 0.80445,因此archived_at is null的估算值是 80.4%。)avg_width:每个值的平均字节数,用来估算哈希和排序的大小。n_distinct:不同值的数量。正数表示数量(kind有 5 个);负数表示行数的比例,-1表示每个值都唯一。most_common_vals和most_common_freqs:高频值列表(MCV 列表),也就是出现频率最高的值及其出现频率。histogram_bounds:其他值,被切分成 100 个行数大致相等的桶。correlation:物理行顺序与列值顺序的接近程度,范围从 -1 到 1。它会影响索引扫描的代价(相关性会影响索引扫描的代价)。
下面是 kind 的高频值列表:
因此,where kind = 'deploy' 的估算值是 rows=502927:即这张表 1,999,974 行的 0.25146666 倍。高频值列表中的值使用它自己的频率;其他值则平均分摊剩余部分。范围条件会统计直方图桶:created_at 上 2026 年 9 月 1 日所在的一周估计有 36,613 行,实际为 38,356 行。
每个行数估算都是一个基于 pg_stats 的公式,你可以自行核对。以 events.account_id 为例(有 1,000 个不同值;这次抽样恰好把六个稍微更繁忙的账户放进了高频值列表,它们的频率之和为 0.0091666665):
第二个公式解释了为什么数据倾斜的列会带来问题。如果几百个中等规模的租户各自占有 0.5% 的行数,100 个 MCV 槽位就容不下它们,剩下的每个租户都会被估算为约 2,000 行,而不是 10,000 行。提高统计目标(见下一节)可以让大租户各自拥有一个条目。
范围条件会找到两端所在的直方图桶,并假设桶内的值均匀分布。对于 created_at >= '2026-04-01' and created_at < '2026-04-08':
规划器给出的结果是 38,431(差异来自我们的四舍五入),实际数量是 38,356。没有更好信息时,= 连接会把两个输入相乘,再除以较大的 n_distinct:events 与 173 个企业账户连接时,估算值为 2,000,000 x 173 / 1,000 = 346,000。它假设企业账户产生的事件数处于平均水平,这和下面的独立性假设相同。
19-plannerpg_stats 还会提供 most_common_elems 和 elem_count_histogram,用于数组和 tsvector 列;对范围类型,还会提供范围直方图:其他数据形态也是同样的思路。
ANALYZE 读取样本,而不是整张表
ANALYZE 会抽取 300 x default_statistics_target 行作为样本。默认目标是 100,因此样本有 30,000 行:
统计目标还会把 MCV 列表和直方图分别限制为最多 100 个条目:对大多数列来说足够,但对拥有大量不同值且数据倾斜的列来说太少。如果 account_id 有很长的大租户尾部,100 个 MCV 槽位容不下它们,其余值就只能采用平均估算。应按列提高统计目标,而不是全局提高:
现在,ANALYZE 会为一个 300,000 行的样本读取全部 35,173 个页,1,000 个账户也都会各自得到一个 MCV 条目。代价是 ANALYZE 变慢(在我们的机器上约 2 秒,而不是 0.2 秒),规划也会略微变慢。只有在估算确实有明显错误的地方才使用 500 到 1000,通常是租户 ID 和状态列。如果 ANALYZE 持续把 n_distinct 估错,可以用 alter table ... alter column ... set (n_distinct = 20000) 把它固定下来。
自动清理的分析会漏掉三类变化
自动清理会在大约 autovacuum_analyze_threshold + autovacuum_analyze_scale_factor x reltuples 行发生变化后分析一张表:默认是 50 加上 10%,因此两百万行的表要等到 200,050 行发生变化。以下三种情况会漏过去:
- 批量加载。 规划器使用的是加载前的统计信息,或者根本没有统计信息。每次批量加载或大型回填结束时都运行
ANALYZE(在开门前清理并分析)。 - 不断增长的时间范围。
ANALYZE上次运行是在昨天,而你查询的是“最近一小时”,直方图的末端还没有覆盖新行。Postgres 对有索引的列会部分补偿,但只追加数据的大表需要更低的表级autovacuum_analyze_scale_factor(大表不该使用默认值)。 - 临时表。 自动清理永远不会处理临时表。在把它和其他表连接之前,先对它运行分析。
PostgreSQL 18 的 pg_upgrade 会保留规划器统计信息,消除了过去升级后“要等分析完成才恢复正常速度”的窗口。但它不会保留本章后面讨论的扩展统计信息,因此应随后运行 vacuumdb --all --analyze-only --missing-stats-only(18 中新增),只重建这些统计信息。
规划器假设各列彼此独立
回到开头的查询。规划器从 pg_stats 知道两件事:account_id = 696 大约匹配 1,000 个值中的 1 个,project_id = 4242 大约匹配 20,000 个值中的 1 个。要把它们合并,它会相乘:
只有在项目不能告诉你任何账户信息时,相乘才是正确的。但一个项目恰好属于一个账户,所以第二个过滤条件什么也不会排除。正确答案是“约 100 行”。两个列各有一个单列索引时,计划会显示这一点:
(BitmapAnd 总是报告 0 行:它会合并位图,但从不统计行数。)每个叶节点的估算都很准:项目是 100 对实际 85,账户是 1,990 对实际 1,961。只有合并结果错了。叶节点正确、组合错误:这就是列相关性的特征。
这条查询无论怎样都很快。但这个 1 行的估算会传给它上面的每个节点:如果再和其他东西连接,它就会选择嵌套循环,对 1 行来说很好,对 10,000 行来说却很痛苦。列相关性无处不在:租户和项目、城市和邮政编码、status 和 completed_at。连接也会继承这个假设。多余的 and p.account_id = e.account_id 会让连接估算再除以 1,000(代价最低的计划胜出一开头就展示了这种情况)。
扩展统计信息联合测量多列
让 ANALYZE 联合测量这些列:
这就是 pg_stats_ext,在 psql 中用 \x 可以让它每行显示一列。把 dependencies 读作:“第 3 列(project_id)以 1.0 的程度决定第 2 列(account_id)”:项目每次都能告诉你账户。n_distinct 表示这对列有 19,959 种组合,而不是 1,000 x 20,000 种。再次运行开头的查询,估算值为 rows=100,实际为 85。
扩展统计信息分为三种,分别对应一种相关性:
| 类型 | 修复的问题 | 用于 |
|---|---|---|
dependencies | 一个列决定另一个列时的等值过滤 | 租户 + 项目、邮政编码 + 城市 |
ndistinct | 多列 GROUP BY 和 DISTINCT 的分组数量 | 相关键上的汇总 |
mcv | 部分相关组合上的过滤 | 状态 + 类型、套餐 + 区域 |
省略类型列表就会得到全部三种。它们开销很小,但应在发现估算错误的地方添加,而不是为每一对列都添加。
19-plannerndistinct 会修复分组数量。在有它之前,select account_id, project_id, count(*) from events group by 1, 2 的计划如下:
由于不知道有多少对组合,规划器把输入的 10%(200,005 个组)当作估算值,并为它预计会溢出 work_mem 的哈希表规划了 4 个磁盘分区。之后:rows=19959,没有计划中的溢写,代价只有三分之一。运行时间几乎没变,因为哈希表原本就能放进内存;但在更大的查询中,把分组数量高估 10 倍会让聚合改用排序,或使上方第三层的连接选择错误的一侧来建立哈希表。
mcv 处理部分相关的情况,也就是一列只在大多数情况下能预测另一列。在一份 events 的副本中,status 在 95% 的告警中为 failed,其他类型的事件则只有 5% 为此状态;单独相乘会在两个方向上都估错:失败告警估计为 42,822(实际 237,213,低估 5.5 倍),失败构建估计为 123,067(实际 37,336,高估 3.3 倍)。执行 create statistics event_outcomes_kind_status (mcv) on kind, status from event_outcomes 后,两者的估算误差都落在 10% 以内。存储的列表说明了原因:
frequency 是样本看到的频率;base_frequency 是按每列频率相乘后预测的频率。两者相差接近 6 倍时,独立性假设就严重错误。
19-planner在估算出错的节点上,如果它同时过滤同一张表的两列或更多列,而每列单独的估算都没问题,那就是存在列相关性:只对这几列创建统计信息,运行分析,再次检查。
函数会隐藏你的统计信息
统计信息按列保存。把一列包在函数里,规划器就没有可查的信息,只能退回到源代码中的常量:等值条件使用整张表的 0.5%,范围条件使用 33%。
10,000 行是两百万行的 0.5%;实际数量为 500,420,是估算值的 50 倍。lower(kind) = 'deploy' 得到相同的 10,000 行(实际为 499,992),而 (payload->>'duration_ms')::int > 4000 会得到固定的三分之一,即 666,682 行(实际为 400,064)。这些数字和你的数据根本无关。
这些常量是规划器 selfuncs.h 中的 DEFAULT_EQ_SEL(0.005)和 DEFAULT_INEQ_SEL(三分之一),旁边还有几个用于 like、范围和布尔值的常量。计划的代价也能暴露这个表达式:65,173.71 是普通扫描的 60,173,再加上每行一个 cpu_operator_cost,用于执行 ->> 调用本身。
19-planner你可以用两种方式给规划器提供真实数字。一种是表达式索引:ANALYZE 会像对待一列一样,收集每个已索引表达式的统计信息。另一种是表达式统计信息(PostgreSQL 14+),它收集相同的统计信息,却不需要在每次写入时维护索引:
现在,第一个查询的估算值是 500,670 行,实际为 500,420 行。比较估计行数和实际行数展示了这个修复如何把糟糕的嵌套循环变成哈希连接。(如果一个 jsonb 字段需要统计信息,应问问它是不是应该成为真正的列。)
FROM 中的函数默认估算为 1,000 行
除非规划器能够看穿函数内部,否则 FROM 中的函数就是一个黑盒,估算为 1,000 行:
这是一个返回某个账户最近项目的 PL/pgSQL 函数。若它是单语句的 language sql 函数,规划器会把函数体内联进去,统计信息也一并可见:Seq Scan on projects 的估算值为 1 行。无法内联时,应声明一个符合实际的估算值:alter function recent_projects_plpgsql(bigint) rows 5。什么会阻止内联,以及易变性向规划器作出什么保证,见易变性是给规划器的承诺。
这就是 explain select * from recent_projects(42) 的结果:函数体被内联了。像 generate_series 这样的内置函数带有支持函数,当参数是常量时可以计算出实际数量(结果为 rows=50,对应 generate_series(1, 50))。COST 以 cpu_operator_cost 为单位计算一次调用的代价;在 WHERE 子句中,规划器会先计算代价更低的条件。
预备语句运行五次后切换计划
大多数驱动和 ORM 都使用预备语句:解析一次,执行多次。前五次执行都会获得一个定制计划,根据实际值构建。从第六次开始,Postgres 还会构建一个参数未知的通用计划;如果它看起来不比定制计划的平均代价更高,Postgres 就会永久切换到通用计划并停止规划。对于每秒执行数千次的短查询,这样省下的规划开销确实可观。
危险在于数据倾斜:通用计划看不到具体值,只能按平均值规划。设想 latest($1),它查询某种类型最新的 10 个事件;events (kind) 和 events (created_at) 上都有索引,而一种罕见的新类型 incident 有 20 行,且都来自十个月前。定制计划会随值适配:查询 incident 时,通过 kind 索引取出 20 行再排序(23 个页);查询 build 时,反向遍历 created_at 索引,找到 10 行后停止(5 个页)。
像应用一样再执行几次,第六次执行就会切换到通用计划。此时有人打开 incident 事件页面:
通用计划假定 kind = $1 匹配整张表的五分之一(即 1 除以 n_distinct),因此它认为反向遍历 created_at 几乎立刻就能找到 10 行。实际上,它遍历了 170 万行和 34,536 个页,才找到十个月前的 incident;定制计划只访问了 23 个页:两者相差 1,500 倍,完全由计划缓存造成。
Filter: (kind = $1) 中使用 $1 而不是字面值,就是识别通用计划的方法。
plan_cache_mode 控制这一行为:auto(默认值)、force_custom_plan 或 force_generic_plan。对于数据倾斜列上的查询,可以按角色、函数或会话设置 force_custom_plan;规划只需几分之一毫秒,属于便宜的保险措施,它能让 incident 事件查询回到 23 个页。高频且分布均匀的查找则保持 auto。PL/pgSQL 在函数内部也会以同样方式缓存计划(PL/pgSQL 按会话缓存计划)。
在 psql 中粘贴执行很快,从应用中执行却很慢?先怀疑通用计划。psql 发送的是字面值,所以总会得到定制计划;你的驱动发送的是参数。用 PREPARE 和六次 EXECUTE 重现它,或者在会话中执行 set plan_cache_mode = force_generic_plan。在 PostgreSQL 16+ 中,explain (generic_plan) 会接收原样带有 $1 占位符的查询,直接显示通用计划。
30,000 行的样本通常会漏掉全部 20 个 incident,因此统计信息会记录 5 种类型(如果样本碰巧抽到一个,则记录 6 种),通用计划把 kind = $1 的代价按整张表的五分之一计算:rows=399999。下面列出两个定制计划,供参考:
(generic_plans 和 custom_plans 这两列从 PostgreSQL 14 起才出现在 pg_prepared_statements 中。)
19-planner提示会冻结计划;应该修复估算
Postgres 没有内置的优化器提示:没有 /*+ INDEX(...) */,也没有 FORCE INDEX(Postgres 修复估算,而不是接受提示)。这是有意为之,而且我们认为这样是对的。提示会冻结一个在写下它的那天还正确的计划;随着数据变化,这个计划会悄悄腐化,并掩盖真正的问题:估算错误。
本章介绍的都是替代做法:找到估算出错的节点(慢查询的方法),然后用批量加载后的新统计信息、更好的统计信息、一个可使用索引的查询,或更好的索引,修正规划器掌握的信息。给定规划器当时掌握的信息,糟糕的计划往往已经是它能找到的最佳方案。下一章最后会介绍查看规划器拒绝的计划的工具,以及在你确实需要提示的夜晚可以使用的扩展。
本章要点
- 错误的行数估算导致大多数糟糕的计划。先修估算,再动代价设置。
pg_stats是规划器看到的列的全部信息。估算看起来不对时,读取它。- 对数据倾斜的租户 ID,按列把统计目标提高到 500 到 1000;批量加载后自己运行
ANALYZE。 - 规划器把列当作彼此独立来相乘。对于相关列,
create statistics把估算从 1 行修正到了 100 行,而实际是 85 行。 - 列上的表达式会得到固定的估算值(等值条件为 0.5%,范围条件为 33%)。为它们创建表达式索引或表达式统计信息。
- 预备语句运行五次后切换到通用计划。数据倾斜时,代价会相差 1,500 倍;把
plan_cache_mode = force_custom_plan限定在角色或函数范围内即可修复。 - Postgres 没有提示。修复估算、统计信息、索引或查询。
延伸阅读
- Statistics Used by the Planner,PostgreSQL 文档。介绍
ANALYZE收集的内容,包括扩展统计信息;配合 How the Planner Uses Statistics 阅读行数估算算术的完整示例。 - CREATE STATISTICS,PostgreSQL 文档。介绍每种扩展统计信息及表达式形式。
- Query Planning settings,PostgreSQL 文档。介绍代价常量和
plan_cache_mode。 - PREPARE: notes on custom and generic plans,PostgreSQL 文档。说明预备语句何时在定制计划和通用计划之间切换的确切规则。
- How Good Are Query Optimizers, Really?,Leis 等,PVLDB 2015。使用 PostgreSQL 的证据表明,糟糕的基数估算,而不是代价模型,导致了大多数糟糕的计划。
- OptimizerHintsDiscussion,PostgreSQL Wiki。介绍该项目将提示排除在核心之外的理由。
21 代价最低的计划胜出
这是每个多租户应用迟早都会写的一种连接。每行都带有 account_id,所以为了保险,到处都按它匹配:
租户条件是多余的:项目只属于一个账户,项目所有者也只属于一个账户。它们不会改变答案,却会彻底改变计划:
规划器预计得到 2 行,实际得到 2,000,000 行。它选择了一个适合 2 行的完美计划,却进行了 6,035,364 次页访问。删掉多余条件后,同样的计数只需 36,490 次页访问。
规划器也在估算已经讲过估算。本章讲规划器如何处理这些估算,好消息是:它并不聪明,但始终一致。它在能够计算代价的计划中选择代价最低的那个,而且每个选择都可以用算术核对。计划不对时,要么代价错了,要么行数错了;你可以找出究竟是哪一个。
计划来自 PostgreSQL 18;除非某节专门讨论并行或 JIT,否则它们都关闭了这两项功能。
你的查询在计算代价之前就已被重写
在计算任何一个代价之前,你的查询已经被重写了两次:
每次重写都会让搜索面对一个更简单的问题,而且每次重写都会显示在 EXPLAIN 中。因此,不要手动优化预处理器已经完成的工作。 IN (subquery) 会变成规划器可以重新排序的连接,而只使用一次的 CTE 会被内联(CTE:内联还是物化)。
视图和策略只是文本替换
视图就是粘贴到你的查询中的已保存查询,因此在运行时不产生额外开销。行级安全策略也会以同样方式粘贴进来,成为又一个 WHERE 条件:你从未写过的策略会出现在 Index Cond 中,这就是租户列需要索引的原因(RLS 性能:策略就是谓词)。“不产生额外开销”有一个例外:策略和 security_barrier 视图不会让你自己的条件先于它们执行,除非你自己的条件中的函数标记为 leakproof;因此,本来可以下推到索引中的过滤条件,最后可能变成逐行检查。
常量会被折叠
不包含列的表达式会在计划时计算一次:where id = 2 * 21 会变成 Index Cond: (id = 42),而 and 1 = 2 会规划为 Result,带有 One-Time Filter: false,什么也不读取。像 now() 这样的稳定函数不会被折叠(预备语句可能明天才执行),但规划器会计算它们来估算行数;这就是 created_at >= now() - interval '1 day' 能得到真实估算并使用索引的原因。
过滤条件下推。 对分组子查询的分组列施加的过滤条件会落到聚合下面,因此 Postgres 只统计一个项目的行,而不是先统计全部 20,000 个项目的行再丢掉其中 19,999 个(GroupAggregate 位于 Seq Scan ... Filter: (project_id = 42) 之上)。
外连接变成内连接。 projects p left join events e ... where e.kind = 'deploy' 无法保留空项目(它们的 e.kind 是 null),因此规划结果是普通的 Hash Join,搜索过程可以重新排序。如果你本来想保留这些项目,过滤条件就应该放进 ON 子句。
没人读取的连接会消失。 select p.* from projects p left join users u on u.id = p.owner_id 的计划只有 Seq Scan on projects p。ORM 经常生成这样的连接;正是这次重写让它们的代价低于表面看起来的样子。
PostgreSQL 18 会消除自连接并折叠 OR 列表。 一个表按主键与自身连接时,第二次扫描会消失;id = 1 or id = 2 or id = 3 会变成一次探测:Index Cond: (id = ANY ('{1,2,3}'::integer[]))。
20-plans误差会沿连接树向上累积
回到开头的查询。连接估算值等于两侧输入行数的乘积再乘以选择率;有两个连接条件时,规划器会把它们当成彼此独立,分别相乘(规划器假设各列彼此独立):
第二个条件什么也不会排除,因此估算值低了 1,000 倍。接着,这个误差变成了一个输入。与 users 的连接还有自己的多余条件,于是又除以约 1,000:得到 2 行。对于 2 行,通过索引探测 users 的嵌套循环是正确计划;对于 2,000,000 行,这意味着两百万次探测,每次大约三个页。
删除多余条件后,每个估算都正确,两个连接都会使用哈希连接,查询的页访问次数降到了原来的一百六十五分之一。在两个层级各有 10 倍误差,到第三层就会变成 100 倍。
在每次连接中都匹配 account_id 感觉更安全,而带有复合键的 ORM 会生成这样的条件。每个多余条件都会让估算值除以该列的不同值数量。应按决定该行的键连接。若要保证账户匹配,请使用复合外键:events (project_id, account_id) references projects (id, account_id)。它既约束数据,规划器又会在估算连接时读取外键;因此,有了它之后,包含两个条件的连接也能得到正确估算。
没有多余条件时:
users 的哈希代价是 1,126 次命中(整张 users 表),读取则来自 events 和 projects。下面的断言也确认了提示框中复合外键的修复。
20-plans访问路径是按代价计算的,不是按排名决定的
对于每张表,规划器都会构建它可以使用的每一种扫描方式(读取索引的三种方式,再加上顺序扫描),并为每一种计算代价。没有“索引一定胜过顺序扫描”这种规则,只有算术;对结果影响最大的数字是相关性。
相关性决定索引扫描的代价
索引扫描的 I/O 代价会在两个极端之间变化。相关性为 0 时,每个匹配行都位于不同的页上,需要按随机顺序获取。相关性为 1 时,匹配行位于连续页上,几乎可以按顺序读取。规划器会按相关性的平方进行折算,所以只有很强的相关性才能获得明显折扣:相关性为 0.5 时,只能得到四分之一的折扣。
为了隔离这个因素,给 events 在 created_at 上建立索引,再以随机顺序复制这张表,并使用相同的索引:行相同,唯一不同的是物理顺序。在查询最近一天事件时强制使用索引扫描(为当前会话关闭位图扫描),乱序副本的代价是有序表的 82 倍;如果不强制,规划器会选择位图扫描。
5% 规则在两个方向上都不对
扩大时间窗口后,每张表都会在某个窗口宽度切换计划:
| 表 | 计划 | 截止(窗口) | 估算行数 |
|---|---|---|---|
| events(相关性 1) | Index Scan | 235 天 | 1,293,301(65%) |
| events(相关性 1) | Seq Scan | 超过 | |
| events_shuffled | Index Scan | 2 分钟 | 8 |
| events_shuffled | Bitmap Heap Scan | 143 天 | 781,520(39%) |
| events_shuffled | Seq Scan | 超过 |
“表中低于 5% 就使用索引”这句话可以休矣。对于有序数据,索引扫描一直适用到表的 65%。对于乱序数据,普通索引扫描只有在行数很少时才胜出,而位图扫描可以一直适用到 39%,因为一旦触及大多数页,它就会按物理顺序读取这些页。
在我们的机器上,所有数据都已缓存;在计划切换点,顺序扫描实际上比它替代的计划更快(有序表切换点约为 115 ms,对比 210 ms):这说明当内存能容纳全部数据时,可以降低 random_page_cost,并且要一次性为整台服务器设置。
对于 created_at >= '2026-10-05',在两张表上都强制使用索引扫描:
如果不强制,规划器会为乱序表选择代价为 14,360 的位图扫描。实验通过对窗口宽度进行二分搜索,找出表中的每个切换点。仅索引扫描会根据全可见页另行折算代价,折算依据来自 pg_class.relallvisible。
20-plans排序顺序是访问路径的属性
一条访问路径还携带它输出行的顺序(规划器称之为pathkeys),因此,如果一条代价更高的路径可能省掉后续排序,它也会在搜索中保留下来。ORDER BY ... LIMIT 正是这种情况发挥作用的地方:order by created_at desc limit 10 反向遍历索引,读取 4 个页后停止;Limit 只为它实际读取的那一小部分付出代价。若要求一个没有索引提供的顺序(order by kind, created_at desc),就必须先读取并排序全部行,才能输出第一行:35,179 个页。
介于两者之间的是增量排序(PostgreSQL 13+):它使用索引提供第一个排序键,再在每个组内排序;order by created_at desc, kind limit 10 读取了 8 个页。
意外出现排序,说明没有任何访问路径提供所需顺序(Limit 押注于尽早找到行展示了代价高昂的版本)。
反向索引扫描报告 Buffers: shared read=4,排序报告 shared hit=6 read=35173;增量排序显示 Presorted Key: created_at。第一个索引扫描的总代价是 87,124,但它的 Limit 代价是 0.86。排序的启动代价(98,392)几乎等于总代价:直到它看完每一行,才会有任何东西输出。
20-plans连接顺序是一场搜索,而且搜索会变得昂贵
有了每张表的最低代价路径后,规划器会寻找组合它们的最低代价方式,采用的是 1979 年 System R 论文提出的做法:动态规划。它会为每一对表找出最佳计划,再每次增加一张表,并为每组表只保留代价最低的计划。这样的剪枝让搜索变得可行,但规模仍然增长很快。下面使用 4 到 13 份同一张 1,000 行表的副本,它们都按一个键连接,分别在穷举规划(geqo = off)和默认设置下进行规划:
| 表数量 | 穷举规划耗时 | 默认设置规划耗时 |
|---|---|---|
| 4 | 0.4 ms | 0.5 ms |
| 8 | 8.1 ms | 10.5 ms |
| 10 | 75.7 ms | 112.5 ms |
| 11 | 217 ms | 211 ms |
| 12 | 962 ms | 41.8 ms |
| 13 | 2,609 ms | 37.6 ms |
每增加一张表,穷举规划的时间大约会变成原来的三倍;直到 12 张表时,默认设置那一列突然掉下悬崖。这就是 geqo_threshold = 12:从这里开始,遗传查询优化器(GEQO)会用随机搜索替代穷举搜索,并在固定的工作量后停止。规划时间保持平稳,但计划只是很好,并不保证是最佳计划。
join_collapse_limit(默认值为 8)避免大查询进行完整搜索:超过 8 个项目的显式 JOIN 会按你写下的顺序分块规划,每一块都单独求最优。相同的 12 张表用显式 JOIN ... ON 时规划耗时 9.2 ms,而用逗号列表并进行穷举规划时需要 962 ms。因此,只有逗号列表才会穷举搜索到 11 张表;对于 ORM 编写的 JOIN 语法,它在 8 张表处就停止。join_collapse_limit = 1 会让规划器严格遵循你的连接顺序。只在会话内调整这些设置,绝不要全局调整。超过十二张表后,在责怪执行器之前先检查 Planning Time:ORM 的预加载可能花在规划上的时间比执行还多。
这是我们机器上三次运行中最好的一次;重要的是形状,而不是这些数字。GEQO 从 geqo_seed 取得种子,因此相同的查询和统计信息会得到相同的计划。
20-plans每种连接方法都在某条代价曲线上胜出
每种连接方法只适合某些行数展示了如何读取三个连接节点。下面解释为什么每种方法会被选中:
规划器会为每一对输入计算三种方法的代价,并保留代价最低的那个,因此行数变化时选择也会变化。一个账户的 20 个项目与其事件连接时,会采用嵌套循环:每个项目的索引查找代价约为 383 个单位,而哈希连接要先扫描全部 events(约 55,000)才行。把范围扩大到 account_id <= k:8 个账户(190 个项目)时仍是嵌套循环;到 9 个账户(212 个项目)时就切换为哈希连接。
这也解释了为什么当外侧估算值偏低时,嵌套循环是最危险的计划:它是为小数量选择的,而代价会随着真实数量增长。
内存也会改变选择,而且不一定是在你想象的位置。按 order by e.user_id 把全部 events 与 users 连接,在默认的work_mem 4 MB 下得到的是归并连接。哈希连接本身不是问题:100,000 个用户的哈希在 4 MB 下只需一个批次,因为 hash_mem_multiplier 会给哈希两倍于 work_mem 的内存;在 4 MB 和 8 MB 下,哈希连接本身的代价也相同。问题是哈希连接之后所需的排序:两百万个连接结果,每行约 35 字节,需要在磁盘上排序。归并连接只需在连接前排序较窄的 events 一侧(每行 14 字节),因此在 4 MB 下更便宜。到 8 MB 时,大排序需要的归并轮次减少,估算代价下降,同一查询变成哈希连接加排序:一个设置导致不同的连接,这也是应当为报表角色提高 work_mem,而不是为整台服务器提高它的好理由。
Memoize(PostgreSQL 14+)是一种带记忆能力的嵌套循环:它在内侧建立以连接值为键的缓存;当外侧的不同键远少于行数时,规划器会添加它。在计划节点中,Misses 是内侧真正执行的次数,Hits 是节省下来的执行次数。归档项目及其账户的用户数:外侧有 3,911 行,但只有 989 个不同账户,因此子查询只运行 989 次;启用 Memoize 时,查询读取了 3,444 个页,而设置 enable_memoize = off 时读取了 13,075 个页。需要关注的输入是连接列上的 n_distinct。
单账户嵌套循环的内侧是一条参数化路径:索引扫描(Index Cond: (project_id = p.id))从当前外侧行获取键,这正是嵌套循环很快的原因。在 k = 8 时,嵌套循环的代价是 60,105;在 k = 9 时,哈希连接的代价是 60,688。交叉点大约是 19,000 个事件,即表的 1%。在 4 MB 下,归并连接的代价为 371,832,而哈希连接加排序为 387,490;在 8 MB 下,哈希连接加排序的代价为 332,802。在这两种内存设置下,哈希连接本身的代价都是 63,799,并使用 7,274 KB 在一个批次内运行,这和上一章在一个批次内运行的哈希相同(每种连接方法只适合某些行数)。全部差异都来自顶层排序:4 MB 时启动代价为 382,490,8 MB 时为 327,802,而这个排序无论哪种设置都溢写了约 96 MB。Memoize 节点:
20-plans并行计划和其他计划一样按代价计算
并行计划只是多一条访问路径,同时多出两项代价:启动工作进程的 parallel_setup_cost(1000),以及工作进程交给领导进程的每一行所需的 parallel_tuple_cost(0.1,是 cpu_tuple_cost 的十倍)。因此,小表永远不符合条件,返回数百万行的扫描很少符合条件,而最终只得到少数几行的扫描最合适。
工作进程数量来自表的大小,而不是查询:表达到 8 MB(min_parallel_table_scan_size)时有一个工作进程,此后表大小每增加到原来的三倍就增加一个;因此 275 MB 的 events 得到 4 个工作进程,但会受 max_parallel_workers_per_gather 限制(默认值为 2)。
一个没有标注的函数会让查询保持串行
规划器拒绝为写入或锁定行的查询使用并行计划(create table ... as 和 create materialized view 是例外:它们内部的 select 可以并行),也拒绝游标,以及调用标记为 PARALLEL UNSAFE 的函数的任何查询;而且用户定义函数默认都是 PARALLEL UNSAFE。WHERE 子句中只要有一个未标注的辅助函数,两百万行的扫描就会由一个进程完成。把纯计算标记为 parallel safe(并行安全需要显式选择)。
执行相同的 count(*) 查询,作用于 events 的副本;设置 max_parallel_workers_per_gather = 8 且两个并行代价都为零,因此规划器总会选择并行:projects(1.5 MB)没有工作进程;10 MB、28 MB 和 83 MB 的副本分别得到 1、2 和 3 个工作进程;events(275 MB)得到 4 个。使用默认代价时,ev_70k 根本不会得到并行计划。用 alter table events set (parallel_workers = 6) 可以按表覆盖大小规则。一个未标注的 PL/pgSQL is_slow(payload) 过滤器规划时没有 Gather;执行 alter function is_slow(jsonb) parallel safe 后得到 Workers Planned: 2。即使是已经内联的 language sql 函数,只要仍标记为不安全,也会阻止并行:检查依据的是你写下的查询。
20-plansJIT 是规划器根据自身估算下的一次赌注
即时编译会把查询表达式转换为机器码。只要 Postgres 构建时带有 LLVM,它默认就是开启的;编译需要几毫秒,因此规划器只有在估算代价较高时才下注:超过 100,000(jit_above_cost)时进行编译,超过 500,000 时还会内联并运行 LLVM 的昂贵优化。
按 kind 分组的报表估算代价刚超过 100,000,编译约 5 ms,却没有获得可测量的收益,因为它的工作是 JIT 无法加速的 jsonb 调用。开启内联和优化后,同一查询花了 607 ms 编译,运行时间几乎翻倍。JIT 在处理数亿行的长分析查询时有收益;只要估算过高,它就会得不偿失:一个估算代价为 600,000、实际运行 20 ms 的查询,会为编译付出数百毫秒。
我们的默认做法是:OLTP 主库关闭;对会扫描整张表的分析角色按角色开启。
在我们的机器上,该报表的计划显示 JIT: Functions: 9、Emission 5.030 ms, Total 5.584 ms 和 Execution Time: 723.054 ms。查询为:select kind, count(*), avg((payload->>'duration_ms')::int), count(*) filter (where payload->>'status' = 'failed') from events group by kind。去掉 filter 聚合后,代价降为 85,172:不再使用 JIT。开启 JIT 时,两次运行分别耗时 723 和 778 ms;设置 jit = off 时,则为 716 和 641 ms。将内联和优化阈值设为 0 后,Timing 显示 Inlining 347.702 ms, Optimization 209.518 ms ... Total 606.963 ms,Execution Time: 1321.098 ms(在更安静的运行中编译耗时 175 ms;它会变化,但始终很大)。缓存的通用计划会使用准备时的设置作出 JIT 决定。
20-plans错误计划有四种原因
上面的内容都可以归结为一句话:规划器根据估算和代价选择最低代价计划。因此,错误计划有四种原因,应按以下顺序检查:错误的行数估算、隐藏统计信息的查询形状、缺失或错误的索引,或者无法描述硬件的代价参数。
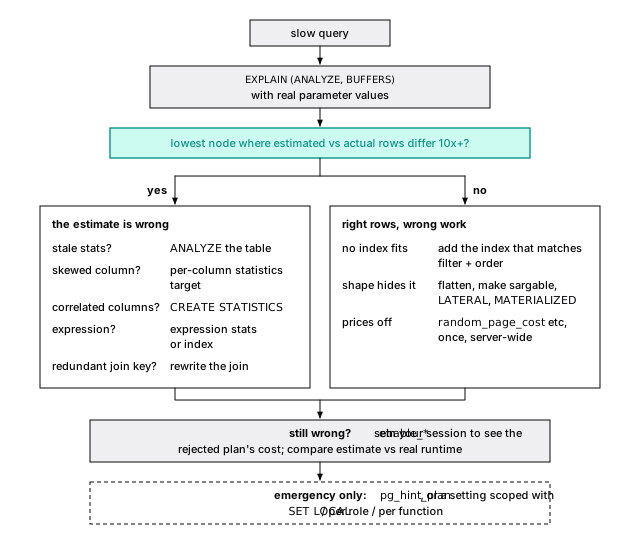
慢查询的方法可以找到节点;规划器也在估算包含统计信息修复方法。如果你能根据 pg_stats 重现规划器的估算,问题就在统计信息。如果你甚至无法写出公式,因为它退回到了常量,问题就在查询形状。你需要的是生产环境中的计划,带有生产环境的参数;auto_explain 会记录它(auto_explain 会记录以后无法重现的计划)。
enable_* 展示规划器没有走的路
在会话中关闭 enable_* 设置,EXPLAIN 就会显示规划器拒绝的计划,以及它认为该计划的代价。在 PostgreSQL 18 中,禁用的计划类型不再通过巨大的惩罚来计算代价:规划器会统计被禁用的节点数,偏好禁用节点更少的计划,并标记仍然不得不使用的禁用节点。对一张没有其他访问方式的表设置 enable_seqscan = off 后:
如果被拒绝的计划运行更快,却被计算出更高代价,那么它下面的某个估算是错的,或者代价参数错了。
20-plans只在你自己的会话中设置 enable_*,用于观察。全局修改会悄悄重塑服务器上的每个计划,而写进应用代码的设置会比当初支持它的数据活得更久。如果必须把它限定到一条查询,就在该事务中使用 set local,并写下原因。
pg_hint_plan 适用于计划翻转的那一晚
核心 Postgres 有意不提供提示(提示会冻结计划;应该修复估算)。pg_hint_plan 扩展提供了提示,适合生产查询在某个夜晚突然翻到糟糕计划、而统计信息修复还需要先测试的情况。
提示放在 /*+ ... */ 注释中。它们可以强制指定扫描方法、连接方法或连接顺序;最有用的是,还能修正行数估算(Rows),从而修复根因,而不是硬性规定计划。它的提示表会把提示绑定到查询 ID,因此无需修改应用就能修复 ORM 生成的 SQL。每个提示都是在赌数据的形状永远不会改变:在每个提示旁边都留一张工单,以便最终删除它。
本章要点
- Postgres 会在计算代价之前重写你的查询。不要手动优化它已经完成的工作。
- 连接估算会相乘,因此误差会沿树向上累积:一个多余的租户条件让 2,000,000 行看起来像 2 行,代价是页访问次数达到原来的一百六十五倍。
- 索引扫描的代价跟随相关性的平方变化。在有序数据上,索引扫描一直胜出到表的 65%,所以 5% 经验法则在两个方向上都不对。
- 连接搜索会穷举到 8 个显式
JOIN(join_collapse_limit),或者 11 张逗号列表中的表,每增加一张表,规划时间大约变为原来的三倍;到 12 张表时由遗传优化器接管。 - 嵌套循环在数量较小时胜出,而外侧估算值偏低时会输得很惨。
- 用户函数在标记之前都是
PARALLEL UNSAFE。JIT 押注于估算;OLTP 主库应将它关闭。 - 计划不对时,依次检查估算、查询形状、索引和代价。
pg_hint_plan留给紧急情况。
延伸阅读
- Planner/Optimizer,PostgreSQL 文档。路径生成、三种连接策略,以及 GEQO 何时接管。
- Parallel Query 和 JIT,PostgreSQL 文档。并行安全规则和 JIT 代价阈值的一手说明。
- Access Path Selection in a Relational Database Management System,Selinger 等,SIGMOD 1979。关于基于代价的访问路径和动态规划连接搜索的论文。
- How Good Are Query Optimizers, Really?,Leis 等,PVLDB 2015。基于 PostgreSQL 的测量表明,随着连接增加的基数估算错误,远比代价模型重要。
- pg_hint_plan,NTT OSS Center。该提示扩展及其提示表。
22 经得住数据增长的查询
活动流第 1 页只需远不到一毫秒就能加载。第 50,000 页在我们的机器上需要 180 ms,并读取 21,000 个页。同一条查询、同一个索引、同一个 LIMIT 20,唯一的差别是 OFFSET 后面的数字。
大多数慢查询都属于几种熟悉的形状:它们让数据库的工作量与整张表成正比,而不是与答案成正比——演示时很快,第六个月却很慢。经得住增长的查询,其访问页数与所请求的行数成正比。计划中的 Buffers: 行可以用来检查这一点(缓冲区才是证据)。
本章为 events 添加两个索引(模板中没有索引),并关闭并行查询,让计划更容易阅读:
OFFSET 会读取它跳过的每一行
不要再用 OFFSET 分页。没有任何东西记录第 1,000,000 行在哪里,因此 Postgres 会从索引头部开始遍历,产生行再把它们丢掉:
| 偏移量 | 读取行数 | 缓冲区 | 耗时(我们的机器,约值) |
|---|---|---|---|
| 0 | 20 | 4 | 0.04 ms |
| 100,000 | 100,020 | 2,146 | 15 ms |
| 1,000,000 | 1,000,020 | 21,422 | 180 ms |
读取一百万零二十个条目,只为了显示二十个。对于没人会翻过第 5 页的搜索页面,这没问题;对于客户端会逐页遍历的 API,这就是灾难。
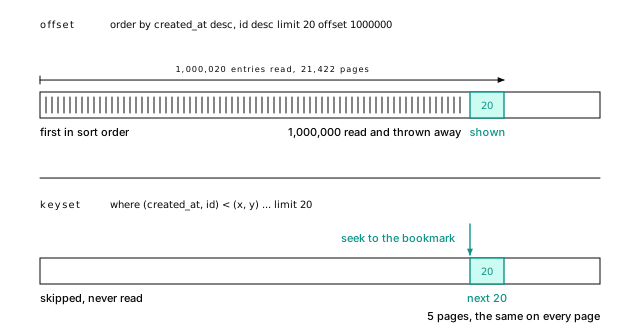
21-queries键集分页(也称游标分页或寻道分页)使用书签,而不是从封面开始数页。记住上一页结束的位置,请求它之后的行:
(created_at, id) < (x, y) 的意思是“在这个排序顺序中排在后面”,而且它可以直接匹配两列索引。它返回的正是 OFFSET 1000000 产生的那一页,Buffers: shared hit=4 read=1:只需 5 个页,而不是 21,422 个页,并且每一页都相同。
要让它经得住增长,需要三个习惯。加入主键来打破并列,让排序成为全序。把过滤列放在索引前面,因此单个项目的活动流适合使用 (project_id, created_at, id)。还要给客户端一个不透明的游标(在应用中编码;报告可以交给 SQL介绍了其中一种编码方式)。
你放弃了跳到第 37 页的能力;无限滚动本来就不需要这个能力。批处理作业也使用同一个书签:where id > $last order by id limit 1000。
下面用 TypeScript 和 node-postgres 展示一个端点执行这条查询的完整写法:
第一页使用 'infinity',它的排序位置在所有时间戳之后,因此所有页都能共用同一条语句和同一份计划。有两个细节至关重要。游标携带的是 created_at::text,而不是解析后的日期:JavaScript 的日期只能保存毫秒,timestamptz 保存微秒,因此通过 Date 往返一次会略微偏离真实行,导致跳过或重复行。而且 bigint 在 node-postgres 中以字符串到达,这正是游标所需要的形式。
像 created_at desc, id asc 这样的混合方向需要按这种方式声明索引,而且不能使用行比较。
21-queriesN+1 是一个循环,不是慢查询
N+1 问题就是循环中的查询:先加载 100 个项目,再逐个查找所有者。每次查找读取 3 个页,耗时以微秒计,因此监控永远不会报警。代价在于往返:同一台主机上的 101 次查询需要 8 ms,跨可用区后则需要 152 ms(往返比查询更昂贵)。ORM 在循环中访问延迟关联时,默认就会这样做。
用一次往返修复它:如果需要把关联行直接放进结果,就使用连接;如果已经加载了父项,就使用 = any($1),并把完整列表作为一个数组参数传入:
一次往返、一次索引扫描,就能处理全部一百个所有者;在内存中把它们匹配起来。不要生成 in ($1, $2, ... $500):它的文本会随列表长度变化,因此无法只准备一次,而且会触及 65,535 个参数的上限。当每个父项都需要自己的几个子项时,使用 LATERAL。
用 EXISTS 过滤,而不是用连接
用 EXISTS 过滤;只有需要另一张表的列时才连接。“哪些账户在最近一天有过告警?”(数据在 2026 年 10 月 6 日午夜结束):
Postgres 会把它执行为半连接,在每个账户第一次匹配时停止:Hash Right Semi Join ... rows=479。in (subquery) 形式得到完全相同的计划。连接会返回 rows=637,每个告警一行,然后有人再加上 distinct 来消除本不该出现的重复。
NOT IN 是陷阱;使用 NOT EXISTS
如果 NOT IN 下的子查询产生一个 NULL,查询会悄悄返回零行(一个 NULL 就会让 NOT IN 什么也不返回)。同一个 NULL 规则也会阻止 Postgres 把它变成反连接,因此一旦子查询结果超过work_mem,它就会为每个外侧行重新扫描。“没有事件的用户”如果写成 not in (select user_id from events),代价会接近 39 亿,因为这可能意味着 1600 亿次比较(80,000 个没有事件的用户,每个都要与 200 万个 user_id 比较)。写成 not exists 后,它是一个 Hash Right Anti Join,每张表各扫描一次,代价为 68,394。
始终写 NOT EXISTS。只有由不含 NULL 的常量组成的短列表才可以使用 NOT IN(status not in ('done', 'failed'))。
Filter 中写的是 SubPlan,而不是 hashed SubPlan:两百万个 user_id 放不进 work_mem,所以 80,000 个没有事件的用户中的每一个都会扫描全部这些值。对于 projects.owner_id(20,000 行),它会得到 hashed SubPlan 1,并在 12 ms 内完成;这就是 NOT IN 能通过评审、却会在生产环境失败的原因。
21-queries精确计数会读取一切
对大表执行 count(*) 很慢,这不是缺陷。同一时刻,不同事务看到的行数可能不同(更新就是插入),因此不存在一个保存好的计数;最好的情况是对主键执行仅索引扫描,也要为得到一个数字读取 5,469 个页。先问自己这个数字要用来做什么:
- “约 200 万”。(管理面板、“约 2,000,000 条中的 1 到 20 条”):规划器的估算是免费的。
select reltuples::bigint from pg_class where oid = 'events'::regclass返回了 1,999,993。 - “1,000+”。 对一个有上限的子查询进行计数:
select count(*) from (select 1 from events where kind = 'deploy' limit 1001) t。它读取了 159 个页;工作量由上限决定,而不是由表决定。 - 每次请求都需要每个租户的精确数字。 保留一张计数器表,随写入更新,或由定期汇总更新。用触发器完成这件事,会让每个写入者都在该行上串行化(计数器触发器会让写入者串行化)。
规划器可以为任何查询提供估算:
它返回了 500,598;精确答案是 499,992。估算只能和统计信息一样准确,而相关过滤条件会让它失准(规划器假设各列彼此独立)。永远不要把用户输入传给它:它会执行传入的任何字符串。
保持索引列裸露
当一个谓词把裸列与一个可以在扫描前计算出来的值进行比较时,它就是可利用索引的(sargable,“可作为搜索参数”)。把列包在函数、算术表达式或类型转换中,索引就帮不上忙。
列上的函数会隐藏索引
要查询“9 月 1 日的所有事件”,自然的写法是类型转换:where created_at::date = '2026-09-01':
为了取出 5,479 行,却读取了全部页:索引按时间戳排序,而不是按 created_at::date 排序。对裸列使用范围条件,created_at >= '2026-09-01' and created_at < '2026-09-02',只读取 25 个页。
对 date_trunc、extract 和算术表达式也是一样:created_at + interval '1 day' > now() 读取了全部 35,173 个页;created_at > now() - interval '1 day' 使用索引。如果确实需要对列应用函数,就为表达式建立索引(索引会准确存储你提供的表达式)。这要求表达式是 IMMUTABLE 的,而 created_at::date 作用于 timestamptz 时并不满足这一要求:它取决于会话时区,因此 create index ... ((created_at::date)) 会被拒绝。请对 ((created_at at time zone 'UTC')::date) 建立索引,并用相同的表达式查询。
21-queries日期范围是半开区间
时间范围应写成 >= start and < end,永远不要写 between;后者会把第 2 日零点同时计入前后两天(如果结束时间写成 23:59:59,又会漏掉最后一秒;时间戳带有微秒)。半开区间可以首尾相接。边界应在用户的时区中计算,而不是在列上计算。
类型不匹配会在每一行上进行类型转换
即使没有显式函数,类型不匹配也会隐藏索引。where id = 5.0 会变成 Seq Scan,其中有 Filter: ((id)::numeric = 5.0):numeric 字面量让 Postgres 对每一行的 bigint 列做类型转换,就像驱动把数字绑定为浮点数时一样。判断线索是列一侧的 :: 出现在 Filter 行中。
对比 where id = 42 和 where id = 42.0,同时允许并行工作进程:
七个页变成了 35,173 个页。当两侧类型不同时,Postgres 会向能够容纳两者的类型转换,即 numeric,这意味着转换列。绑定参数时使用列的类型。
21-queries跨连接使用 OR 会击败两个索引
在一张表上使用 OR 没问题:BitmapOr 会合并各个条件对应的索引扫描结果。但跨越连接两端两张表的 OR 就不行,即使 projects (name)、projects (owner_id) 和 users (email) 上都有索引(实验会创建这三个索引):
两个条件都无法单独限制任意一张表,因为一行可能通过另一个条件入选,所以 Postgres 会连接全部数据,最后再过滤。把它拆成两个查询的 union,每个条件一个分支,那么每个分支都能进行索引查找:
同样返回那一行,访问 10 个缓冲区即可,而不是 1,317 个。当两个分支不可能重叠时,使用 union all,跳过排序。
两个分支找到了同一个项目(用户 29695 拥有项目 4242),因此 Append 产生两行,Unique 删除其中一行。第二个分支需要 projects (owner_id);没有它,就会退回到顺序扫描。没有索引的外键又一次成了问题(删除每个父行都会扫描整张子表)。
21-queries只使用一次的 CTE 会被内联,而不是设栅栏
为提高可读性可以使用CTE;只有有意为之时才添加 materialized。从 PostgreSQL 12 开始,一个没有副作用且只被引用一次的 CTE 会像任何子查询一样被内联,因此你的过滤条件可以到达表(你的查询在计算代价之前就已被重写)。每个 CTE 都是栅栏的时代留下的建议如今已经错误;遵循它会付出真实页数的代价:“上周项目 4242 的事件”在内联时读取 6 个缓冲区,而标记为 materialized 时则读取 826 个缓冲区,并写入 584 个临时页。
当错误估算一直产生坏计划时,可以有意设置栅栏(提示会冻结计划;应该修复估算),或者为了只运行一次易变函数。被引用两次的 CTE 默认会物化;not materialized 会将它内联。
这一周的全部 38,357 行都被取出,Storage: Disk 说明数据量超过了 work_mem 限制,已溢写到磁盘。内联后,它变成一个 Index Scan,其中的 Index Cond 同时带有两个条件。
21-queriesON CONFLICT 是安全的插入或更新
Postgres 有两个语句可以实现“插入;如果已存在则更新”,但只有 INSERT ... ON CONFLICT 对应用流量是安全的。这里它维护一张汇总表 project_daily_counts,其主键是 (project_id, day, kind):
excluded 是你试图插入的那一行。先用 3,再用 2 执行:第一次返回 old_n 为 null、new_n 为 3;第二次返回 3 | 5(RETURNING old 和 new 适用于 PostgreSQL 18+)。
两个会话对同一个键执行插入或更新时不会都插入成功,也都不会报错:一个插入,另一个等待,然后执行更新。手写的“先查询,不存在再插入”会发生竞态,在负载下抛出重复键错误。与 MySQL 不同,你要明确指定仲裁者(插入或更新(upsert)要指明冲突目标)。
让唯一约束保证只发生一次
客户端在超时后重试支付,而你必须只扣款一次。payments 表保存客户端的幂等键,数据库拒绝使用同一键插入第二行:
第一次请求返回 id 1;重试返回零行,意思是“已经完成”:查找原来的记录并返回相同答案。这个键在每个租户内唯一,unique (account_id, idempotency_key)。
在 Go 中使用 pgx:
如果两个相同的请求在同一时刻到达,第二次插入会等待第一个事务;第一个事务提交后,第二次插入什么也不做;在读已提交隔离级别下,后续的 select 会看到已提交的行。若要在一条语句中取回 ID,do update set idempotency_key = excluded.idempotency_key returning id, old.id is null as inserted 可以做到(重试时返回 1 | f),代价是每次重试都会产生一个新的行版本。
21-queriesON CONFLICT 会等待,MERGE 却会发生竞态
MERGE(PostgreSQL 15+)会让一张表与数据源同步:插入新数据,更新发生变化的数据;从 PostgreSQL 17 开始,还会删除已经消失的数据。它不具备 ON CONFLICT 的保证。它根据自己的快照判断“已匹配”,所以两个并发的 MERGE 都可能插入同一个新键,其中一个会因唯一性冲突而失败。把它用于你能控制的批量同步,不要用于应用流量。
两个 dblink 会话对同一个新键执行同一条语句,第一个会话处于打开的事务中。使用 ON CONFLICT 时,第二个会话会等待第一个会话的锁(wait_event_type = 'Lock');第一个提交后,它会更新新行:没有错误,计数为 2。
21-queries使用 MERGE 时,两个会话都会判断键不存在。第一个提交后,第二个会话的插入会失败,并报告 duplicate key value violates unique constraint;应用会看到一个必须重试的错误。
21-queriesMERGE ... RETURNING 与 merge_action(),以及 when not matched by source,适用于 PostgreSQL 17+(插入或更新(upsert)要指明冲突目标中有一个示例)。
一次提交,而不是每行提交一次
每条自动提交语句都是自己的事务,而每次提交都会等待磁盘刷新(每次提交都等待磁盘),因此一条语句插入一行时,每行都要付出一次刷新和一次往返的代价。按批次提交,并通过 unnest 把每列作为一个数组发送,这是写入端对应于 = any($1) 的做法;一次提交一个批次,而不是每行提交一次和用数组批处理,而不是 VALUES 列表对各种数据写入方式进行了并列测量。
LATERAL 读取每组前 N 行;row_number() 会读取全部行
“某个账户名下每个项目最近三个事件”很常见,而教科书式答案经不起增长。那个答案用窗口函数 row_number() over (partition by e.project_id order by e.created_at desc) 编号,再保留 rn <= 3。它取出了每个项目的每个事件(Sort ... rows=2084,2,080 个堆页),将它们排序后保留 60 行;Buffers: shared hit=367 read=1977。工作量随着每个项目的事件数增长,而事件数只会越来越多。
LATERAL 允许 from 中的子查询引用它前面的表,因此它会对每个外侧行运行一次;有了 (project_id, created_at) 索引,每次运行只需一次短扫描:
20 次短扫描,loops=20:读取 311 个页,而不是 2,344 个;即使一个项目有一百万个事件,所需页数也仍然如此。窗口函数应留给累计总和与排名,而不是用来读取随后会丢弃的行。
这种模式需要一个以分组键开头、再接排序键的索引。没有它,每次 LATERAL 运行都要扫描并排序,结果比窗口函数版本更糟。如果即使没有事件也应显示项目,就使用 left join lateral (...) on true。在 311 个页中,有 191 个用于扫描 projects;这张表在 account_id 上没有索引。
窗口函数版本有一个 Run Condition(PostgreSQL 15+),会在每个分区中提前停止编号,但行仍然会被取出并排序。如果每组恰好只需要一行,select distinct on (project_id) ... order by project_id, created_at desc 简洁有效,前提是大多数分组本来就会被读取。
窗口函数适合时,还有两个问题会咬你。在有 order by 且没有显式指定窗框时,默认窗框是 range between unbounded preceding and current row,它会包含所有与当前行并列的行,因此累加和会一次增加整个并列组的值;如果你想逐行计算,就写 rows。此外,按日 group by 生成的图表会跳过没有行的日期,于是 lag() 比较的是错误的日期:用 generate_series 生成桶,再把数据左连接到这些桶上。
21-queries本章要点
- 在匹配的索引上使用键集分页:
OFFSET 1000000读取 21,422 个页,而键集分页只读取 5 个。 - 用连接或一个
= any($1)数组参数消灭 N+1 循环。 - 用
EXISTS过滤。永远不要使用NOT IN (subquery)。 - 不要在每次请求中对大表执行
count(*):使用估算、上限或计数器。 - 保持列裸露:使用半开范围,把算术放在常量一侧,并匹配类型。
- 把跨连接的
OR重写为UNION。 - 应用流量使用
ON CONFLICT,批处理作业使用MERGE,幂等性使用唯一键。 - 按批次提交,而不是逐行提交;使用
unnest发送数组。 - 使用
LATERAL加(group, sort)索引查询每组的前 N 行。
延伸阅读
- LIMIT and OFFSET,PostgreSQL 文档。包含大偏移量很慢、结果需要
ORDER BY才稳定的警告。 - We need tool support for keyset pagination,Markus Winand。最清楚地说明键集分页,并附有图表和框架说明。
- Subquery Expressions,PostgreSQL 文档。介绍
EXISTS、IN和NOT IN,包括让NOT IN变得危险的 NULL 规则。 - INSERT: ON CONFLICT clause,PostgreSQL 文档。仲裁索引、
excluded和并发保证;再结合 MERGE 阅读两者的差异。 - Slow Counting,PostgreSQL Wiki。解释
count(*)为什么会扫描,以及 Count estimate 中的估算方法。
23 不用搜索引擎,也能搜索
给帮助中心加搜索框有两种做法。相同的 50,000 篇文章、相同的GIN索引、搜索“failed payment”得到相同的 4,206 个匹配项、排名最前的 20 个结果也相同。其中一种不到 5 ms 就能返回,另一种却要 170 ms,因为它索引的是表达式而不是存储列,而且每个匹配项都要再次解析才能排名。
Postgres 中的搜索就是这样:每个部分都很好,但只有测量时才会看到它的代价。大多数产品根本不需要搜索引擎;确实需要的产品也能说清楚原因。
B-树之外已经介绍了基础知识:一个tsvector列、一个 GIN 索引,以及一个 @@ 匹配操作。这里我们在一个包含 50,000 篇文章的合成帮助中心上构建文本和向量搜索(实验脚本是 22-search.sh)。其中的嵌入向量并非来自任何模型,因此这里的召回率数字用于展示取舍,不是对你的数据的预测。
文本会变成词素
全文搜索从不把查询与原文直接比较。它比较的是规范化词与规范化词。to_tsvector 会解析文档,并保留带位置的词素,也就是规范化后的词:
“Deploys”和“deployment”都会变成 deploy;“the”、“were”、“so”和“we”都会被去掉。'english' 参数是一种文本搜索配置:它由解析器以及每类词元所使用的词典组成。
停用词和词干提取有两面性
词干提取依靠后缀规则,而不是理解含义:在 english 中,“organization”会匹配“organ”。搜索乐队 The Who 时,english 会把整个查询当作停用词丢掉。词干提取有利于普通文章,却会伤害名称和代码,因此应为不同内容提供不同配置:文本使用 english,标题、标签和错误代码使用只做小写转换的 simple。
配置是索引的一部分
始终传入配置:单参数形式 to_tsvector(body) 依赖会话设置,因此索引会拒绝它(functions in index expression must be marked IMMUTABLE)。
重音符号需要自己的配置。english 会把“Zürich”保留为 zürich,因此搜索“zurich”什么也找不到。应把 contrib 中的 unaccent 词典加入配置副本,而不是把它作为函数调用。我们的配置名是 app_english,to_tsvector('app_english', 'Requests from Zürich and Montréal') 会得到 'montreal':5 'request':1 'zurich':3。
english_stem 是带有 127 个停用词的 Snowball 词干提取器,因此 plainto_tsquery('english', 'to be or not to be') 会返回空结果。unaccent() 函数只有 stable 属性(它的规则文件可能变化),所以索引会拒绝 to_tsvector('english', unaccent(body)),却接受 to_tsvector('app_english', body),因为它信任该配置。你要手动兑现这个承诺:修改 app_english 后,旧行会继续保留旧向量,直到你重写它们。至于内置解析器无法拆分成词的日语或中文,见PGroonga。
22-search.sh存储 tsvector;不要索引表达式
把向量存储在生成列中,再为该列建立索引。直接索引表达式看起来更节省空间,却会让每次搜索都付出代价。
标题词的权重高于正文词。作为比较,第二张表 docs_expr 不保存该列,而是在相同表达式上建立 GIN 索引。这里写成 stored:在 PostgreSQL 18 中,生成列默认是虚拟列,而虚拟列不能建立索引(类型是一份契约)。
| 堆页 | GIN 索引 | 加载时的 WAL | |
|---|---|---|---|
| 表达式索引 | 3,347 | 9,064 KB | 70 MB |
| 存储列 | 6,766 | 9,360 KB | 95 MB |
存储列让堆的大小翻倍:带位置信息的 tsvector 平均为 511 字节,而它所来源的正文只有 380 字节。
这就是代价。对匹配项排名时,收益就出现了。存储版本在我们的机器上耗时 4.6 ms;表达式版本耗时 170 ms。两个 GIN 索引都能在不到一毫秒内找到 4,206 个匹配项,但排名需要每个匹配项的 tsvector,而表达式版本必须再次解析全部 4,206 个文档,才能为每个匹配项取得这个向量。
把堆和 WAL 的代价在写入时一次付清,而不是每次搜索都让解析器重新工作。
表达式版本为什么会输:tsvector 上的 GIN 索引只存储词素和行指针,除此之外什么也没有,因此它能说哪些行匹配,却不能把向量交给 ts_rank 打分。没有列可以读取向量时,排名过程会对每个匹配项的标题和正文再次调用 to_tsvector,每次搜索共 4,206 次。两个 GIN 索引的大小大致相同;存储列额外增加的是向量本身,它存在于堆中,也存在于记录每行写入的 WAL 中。
22-search.sh表达式索引只有在你永远不需要排名或高亮时才会胜出。
websearch_to_tsquery 从不抛出语法错误
永远不要把用户输入的内容直接交给 to_tsquery:它要求 tsquery 语法,因此 'failed payment' 会产生语法错误。websearch_to_tsquery(PostgreSQL 11+)接受搜索框语法,从不抛出语法错误:'"roll back" -flags or rollback' 会变成 'roll' <-> 'back' & !'flag' | 'rollback',而像 'payment & ) ( !' 这样的垃圾输入会变成 'payment'。
短语需要位置信息
引号会变成 <->,也就是“紧跟其后”,然后根据存储的位置进行检查:“roll”和“back”都出现在 7,849 篇文章中,但两词紧挨着作为短语出现的文章只有 4,194 篇。
phraseto_tsquery('english', 'roll back the deploy') 会产生 'roll' <-> 'back' <2> 'deploy',因此“roll back a deploy”也能匹配。如果你只是想做搜索,这样已经足够;如果你期待精确字符串,就会觉得意外。
22-search.sh按邻近程度排名,而不是按频率
匹配只有是或否;排名则负责给这些匹配排序。使用 ts_rank_cd:它计算覆盖密度,也就是查询词彼此靠得有多近,因此短语“failed payment”会胜过相隔数句才出现的两个词。(ts_rank 只计算它们出现的频率。)
对于查询“failed payment”:
norm 2 列是 ts_rank 使用规范化值 2 的结果。
ts_rank 略微偏好那篇短文的标题匹配;ts_rank_cd 偏好四个相邻命中;两者都会把第三个结果压到后面。默认情况下,标题命中(权重 A)计为正文命中(B)的 2.5 倍。规范化位会把排名得分除以文档某个属性对应的值:2 表示除以文档长度,让长文章的得分降到短文章的四分之一。不存在正确的唯一设置,只有一个得到你的用户认可的设置。
22-search.sh排名会读取每个匹配项
order by rank limit 20 看起来应该只读取 20 行,但它做不到。只有给每个匹配项都排名之后,才能知道排名最前的 20 个:
索引查找只需 13 个页;其余页用于取出全部 4,206 个匹配项,总计仍是 3,283 个页,和没有 limit 时相同。(这里的 8 ms 包含 EXPLAIN ANALYZE 自身的开销;直接运行时,同样的搜索耗时就是前面引用的 4.6 ms。)“deploy”出现在 19,507 篇文章中,对它排名会读取 97% 的表。GIN 知道哪些行包含某个词素,却不知道它出现了多少次、位于哪里,因此无法先返回最佳结果。这就是内置全文搜索的扩展性上限。
所以要在排名前先缩小范围。在这份语料中,一个租户总共约拥有 50 篇文章,因此租户过滤只留下少量候选,而整个语料库会有 4,206 个候选。给过滤条件建立索引,让规划器可以把它和 GIN 扫描组合起来:在 account_id 上建立 B-树以得到 BitmapAnd,或者通过 btree_gin 扩展建立一个组合 GIN 索引。在多租户应用中,这通常就是完整的修复。
22-search.shts_headline 会再次解析文档
最后再计算摘要,而且只为你展示的行计算。ts_headline 每次调用都会再次解析整篇原文。显示 20 行的页面,无论计算摘要与否都约需 5 ms,因为规划器会在限制行数之后才计算摘要。为全部 4,206 个匹配项生成摘要约需 150 ms;当 API 或视图为每个匹配项都生成摘要时,这就是它要支付的账单。
文档说明,它不能防御跨站脚本攻击。渲染前先转义结果,或者把 StartSel 和 StopSel 设置为特殊标记,让模板先转义结果,再把这些标记转换成标签。
对大多数应用来说,Postgres 的搜索已经够用
Postgres 搜索的是你自己的内容,写入与搜索处于同一个事务中,使用相同的权限和租户过滤条件,不需要同步。只有在能明确说出缺少什么时,才考虑更强的工具:把相关性当作产品能力(知道某个词在整个语料中有多稀有的BM25评分、权重提升、同义词),长篇文本的拼写容错(pg_trgm 覆盖短字符串),海量结果集上的分面和计数,或一个字段中包含多种语言。
独立的搜索引擎会带来一条有延迟且会漂移的同步管线、每条权限规则的第二份副本,以及两个系统之间无法共享事务。先从 Postgres 开始。只有当你能展示某个搜索引擎可以回答、而 Postgres 无法回答的查询时,再迁移出去。
搜索扩展把 BM25 放进索引
应该像评价搜索引擎一样评价一个能提供搜索引擎式排名的扩展:使用你的查询和语料,而不是看功能表。话虽如此,BM25 已经不再要求你离开 Postgres。较新的扩展会把词频和语料统计信息保存在索引中,因此无需取出每个匹配项,就能返回最好的 k 个结果。截至 2026 年 10 月,有四个扩展值得了解(我们的实验没有运行其中任何一个;以下内容来自各项目自己的文档):
| 扩展 | 短语、模糊 | 许可证 | 运行位置 |
|---|---|---|---|
| pg_search(ParadeDB) | 是,是 | AGPL-3.0;Enterprise 为商业版 | 自托管、ParadeDB Cloud |
| pg_textsearch(Timescale) | 是,否 | PostgreSQL | 自托管、PostgreSQL 17 和 18 |
| VectorChord-bm25(TensorChord) | 否,否 | AGPL-3.0 或 ELv2 | 自托管 |
| TIN(PlanetScale) | 是,是 | 未发布 | 仅 PlanetScale |
在测试其中一个之前,先确认你的托管平台提供它、它的索引能否经受故障切换,以及查询语法有多大可移植性(只有 pg_textsearch 保留 tsquery)。PlanetScale 的基准测试把 TIN 排在很前面;但这是厂商在测量自己的产品。
pg_search(0.26.0,PostgreSQL 15+)在 Tantivy 上建立日志结构合并索引;Tantivy 是一个采用 Rust 编写的 Lucene 风格库。其文档称开源版不会复制搜索索引,因此搜索只在主库上运行;副本功能只有商业版提供。
pg_textsearch(1.5.1)基于本章的配置实现 BM25,并按 order by content <@> 'failed payment' 排名。其 README 指出,任何共享 BM25 索引都有一个限制:语料统计会计算被行级安全隐藏的行,因此一个租户可以推断出其他租户数据的某些信息(不要信任任何租户)。
VectorChord-bm25(0.3.0,2025 年 12 月)对词元计数的稀疏向量排名:没有位置信息,因此不支持短语;按照其 README,它只在英语上测试过。
TIN(2026 年 9 月 16 日正式发布)使用行的ctid作为文档 ID,因此倒排列表会按页、再按元组组织成位图进行压缩。我们没有找到已发布的源代码或许可证;Lead(AGPL-3.0)是一个供开发使用的替代品,自称“有意不适合生产环境”。我们没有复现厂商的基准测试。
向量搜索会找到临近的点,不在乎文字是什么
嵌入模型会把文本转换为浮点数组,并把相似输入放在彼此附近。“找出与这个问题相似的文章”就变成“寻找最近的点”,而不论它们使用什么词。pgvector(实验运行 0.8.7)增加了 vector 类型和距离运算符:<=> 表示余弦距离,这是大多数文本模型需要的距离;<-> 表示欧几里得(L2)距离,<#> 表示负内积,<+> 表示 L1 距离。
一个 1,536 维向量会存进 TOAST
一个常见的 1,536 维嵌入向量有 6,152 字节(每个维度 4 字节,再加 8),占页的四分之三,远远超过约 2 KB 的阈值;Postgres 超过这个阈值后会把值移到行外的 TOAST 中(大值会先压缩,再移出行外)。存储 2,000 个向量时,表有 15 个只保存 ID 和指针的堆页,另有 2,000 个 TOAST 页。任何跳过向量的操作都很便宜:count(*) 读取 15 个页。精确搜索会逐块读取每个向量:12,024 个缓冲区,每个向量约 6 个。
把列设置为 storage plain 后,2,000 个向量会内联存储,每个占一个堆页;同样的搜索读取 2,003 个缓冲区。只有在行能装进一个页时这才有效(2,100 个维度会被拒绝:“row is too big”)。halfvec(1536)(pgvector 0.7+)为 3,080 字节,并使用 1,000 个 TOAST 页;经过 binary_quantize() 的 bit(1536) 在堆中只占 200 字节,而且表根本不会有 TOAST 表。两者都是近似形式(halfvec 可以缩小索引,召回率没有可测量的损失会测量它们的召回率)。
22-search.sh精确搜索是顺序扫描
不要先去使用近似索引。从这里开始,嵌入向量的维度是 384,存放在单独的 doc_embeddings 表中,这样文章列表就不会把它们带进缓存。没有索引时,order by embedding <=> $1 limit 10 会扫描全部 10,000 个页,在这里约需 20 ms。它是精确的,不需要调参;对于几万个向量,或单个租户对应的那份数据,速度已经足够快。
HNSW 会贪心地遍历图,也可能漏掉结果
HNSW(Hierarchical Navigable Small World,分层可导航小世界)是一张图。每个向量都会连接到一些临近邻居;其中少数向量还会出现在更稀疏、连接更长的上层,就像地铁线路上的快车站:
搜索从顶层进入,向查询点靠近,再下降一层;它只接触几百个节点,而不是全部节点,因此可能漏掉贪心遍历无法到达的结果。要给构建过程足够的内存和工作进程:默认 64 MB 的 maintenance_work_mem 且没有并行工作进程时需要 57 秒,256 MB 和两个工作进程时需要 8 秒。索引为 98 MB,比 78 MB 的表更大。
ef_search 用延迟换召回率
查询时有一个设置很重要:hnsw.ef_search,它控制候选列表的大小(默认 40)。Recall@10 是真实的十个最近邻中最终返回的比例:
hnsw.ef_search | Recall@10 | 每次查询毫秒数(我们的测量) | 缓冲区,单次查询 |
|---|---|---|---|
| 40(默认) | 0.969 | 0.7 | 722 |
| 400 | 0.995 | 4.0 | 3,925 |
| 精确搜索(无索引) | 1.000 | 21 | 10,035 |
在默认设置下,只需十四分之一的页数,就能得到真实邻居的 97%。HNSW 构建过程带有随机性,因此每次构建的召回率会相差几个百分点:在我们的多次运行中,默认设置得到 0.92 到 0.99,ef_search 400 得到 0.98 到完整的 1.0。这就是“近似”的含义,也是你要在自己的数据上测量召回率的原因。对于高风险查询,按查询提高它(set local hnsw.ef_search = 100),并将真实查询样本与精确搜索比较,在自己的数据上测量召回率。
在 64 MB 下,构建会警告 hnsw graph no longer fits into maintenance_work_mem after 28369 tuples。我们的计时从串行构建开始(max_parallel_maintenance_workers = 0;服务器默认允许两个工作进程)。仅增加内存(256 MB)就把耗时从 57 秒降到 23 秒;仅增加两个并行工作进程则降到 17 秒;两者都增加时降到 8 秒。并行构建会把图保存在共享内存中,因此在 Docker 中应给容器更大的 /dev/shm。
这轮参数测试还测得 10(0.956,340 个缓冲区)、20(0.968)、100(0.986,1,684 个缓冲区)和 200(0.986)。构建不是确定性的:pgvector 会随机选择每个向量的图层级(setseed 不能影响它),而并行构建每次插入顺序都不同。在我们的多次运行中,默认设置的召回率范围为 0.923 到 0.992,因此实验检查的是 0.9 或更高,而不是某一次运行的数字。
22-search.shIVFFlat 的默认一次探测是陷阱
IVFFlat 在构建时把向量聚成 lists 个组,并且只搜索距离查询点最近的 probes 个组。它的构建耗时不到 2 秒,而 HNSW 要 8 秒;它的默认设置却是陷阱:50 个组且 ivfflat.probes = 1 时,recall@10 只有 0.636。5 次探测达到 1.000。应从 sqrt(lists) 开始,并在加载数据后构建,因为这些组来自当时已经存在的行。我们的默认选择是 HNSW。
halfvec 可以缩小索引,召回率没有可测量的损失
表可以继续保存 4 字节浮点数,而索引保存更小的形式:using hnsw ((embedding::halfvec(384)) halfvec_cosine_ops) 把索引从 98 MB 缩小到 56 MB,召回率没有可测量的损失。二值量化每个维度只使用一位,生成了一个 17 MB 的索引,找回真实近邻的比例为 0.303;按完整向量对 400 个候选重新排名后,比例为 0.915(先用位向量取 400 个最近邻,再进行精确重排)。先在自己的嵌入向量上测量。
位索引是 using hnsw ((binary_quantize(embedding)::bit(384)) bit_hamming_ops),而且 hnsw.ef_search 必须至少等于内层查询的行数上限。对 100 个候选重新排名得到 0.747。高斯噪声是单比特的困难案例;真实模型(其中一些就是为此训练的)表现会好得多。在这次构建中,半精度的 0.980 胜过全精度的 0.969:这是建图运气。
22-search.sh过滤条件与近似索引不能混用
使用近似索引时,where 会在索引扫描之后运行:HNSW 找到 ef_search 个最佳候选,Postgres 丢弃不满足过滤条件的候选,剩下的才是答案。kind = 'faq' 每十篇文章中匹配一篇。请求十篇:
结果只有四行,100 次查询平均只返回 3.7 行,有些查询一行也没有。你的应用请求十行,却只拿到四行,而且没有报错,这是最糟糕的一种错误。
对于宽泛过滤条件,打开 pgvector 0.8 的迭代索引扫描(set hnsw.iterative_scan = relaxed_order),它会持续获取候选,直到得到足够多符合过滤条件的结果:每次都返回十行,但页数超过原来的三倍。对于高选择性的过滤条件,在过滤列上建立 B-树:对于某个租户的 46 篇文章,规划器使用该索引并计算 46 个精确距离,读取 83 个页,不使用 HNSW。每个值一个部分 HNSW 索引,或分区,可以覆盖剩余情况。
使用 relaxed_order 时,一次查询读取 2,529 个页,而未开启迭代扫描时读取 708 个页;它会扫描最多 hnsw.max_scan_tuples(20,000)个候选。结果可能并不严格按距离排序;strict_order 会保持顺序,但召回率会降低。连接表上的过滤条件无法在扫描期间应用,这就是 account_id 和 kind 会被复制到 doc_embeddings 上的原因。
22-search.sh关键词和向量的失败方式不同,所以要融合
全文搜索能精准命中确切词语(错误代码、“SAML”),却会漏掉释义相同的表达:“card declined”在我们的语料中什么也匹配不到。向量能找到这种释义,却会模糊确切词语。
它们的分数没有共同尺度,因此应改为组合排名位置:倒数排名融合(RRF)会从每个返回该文档的列表中按 1 / (60 + rank) 给它一个分数,再按总和排序。两张列表都找到的文章总会胜出:每张列表返回 50 个结果时,两个至少为 1/110 的分数之和,会超过最好的单个分数 1/61。对于“card declined”,向量一侧会填满全部十个位置。
把查询向量作为参数传入:如果查询向量来自连接所得行中的某一列,距离计算就无法使用 HNSW 索引。
以计费主题的中心作为查询嵌入向量时,前十名会交错来自两个列表。在一次索引构建中,排名第一的结果在文本列表中排第 35、在向量列表中排第 19;另一次构建中,没有文章同时进入两个列表的前 50。HNSW 图每次构建都不同,因此向量列表也不同。常数 60 来自 RRF 论文,该论文称它为 k;我们函数中的 k 只是结果数量。
22-search.sh向量数据库需要一个说得出的理由
把属性说清楚:数亿个向量、繁忙主库无法满足的延迟、迭代扫描读取过多页的过滤搜索。若需求还没达到这些程度,让向量和行放在一起更有优势:一份备份、一套权限模型,以及与文本在同一事务中更新的嵌入向量。
本章要点
- 大多数产品根本不需要搜索引擎。只有为了一个说得出的属性才迁移:BM25 相关性、拼写容错、规模化分面。
- 到处传入文本搜索配置。
- 存储
tsvector:通过表达式索引排名耗时 170 ms,而存储列只需 4.6 ms。 - 对用户输入的一切内容使用
websearch_to_tsquery。 - 排名会读取每个匹配项。先按租户或日期缩小范围。
- 只为展示的行计算
ts_headline,并对其进行转义。 - 1,536 维的
vector会存进 TOAST:跳过它不增加开销,但扫描每个向量要访问 6 个缓冲区。 - 先做精确搜索。默认 HNSW 的召回率为 0.92 到 0.99,只需十四分之一的页数。
- 过滤条件在近似扫描之后运行:打开
hnsw.iterative_scan,或用 B-树对高选择性过滤后的数据进行精确搜索。
延伸阅读
- Full Text Search,PostgreSQL 文档。整个子系统。
- Controlling Text Search,PostgreSQL 文档。排名、规范化以及
ts_headline的代价和 XSS 警告。 - ParadeDB architecture,ParadeDB 文档。Postgres 内部的 Tantivy 索引,以及哪些内容会复制。
- pg_textsearch,源代码仓库。基于 Postgres 配置的 BM25,以及它的限制。
- Introducing TIN,PlanetScale 博客,2026 年 9 月。以
ctid作为文档 ID 的设计。 - pgvector,pgvector 项目。README 就是手册。
- Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs,Yu. A. Malkov 和 D. A. Yashunin。HNSW 论文。
- Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods,Gordon V. Cormack、Charles L. A. Clarke 和 Stefan Büttcher,SIGIR 2009。介绍 RRF 的两页论文。
24 数据库中的代码
两个函数返回相同的行:某个账户的所有事件。一个用 SQL 编写,另一个用 PL/pgSQL 编写,内部查询相同。让它们分别查这个账户最近一天的事件,SQL 版本通过索引读取 7 页;PL/pgSQL 版本读取 2,040 页,取出该账户的全部 2,084 个事件,却丢掉其中 2,080 个。
这两个函数都没有问题。差别在于规划器能看见什么。数据库中的代码发挥得最好时,是你能拥有的最快代码:它在数据旁边运行,不需要往返通信;发挥得最差时,它会隐藏一个把写入者串行化的锁、一个过时的计划,或一个让每次批量更新都付出代价的触发器,而这一切都发生在那台无法继续横向扩展的服务器上。
主库是你最昂贵的 CPU
系统的其他层都可以靠增加机器来扩展:Web 服务器、工作进程、缓存、只读副本。主库是唯一无法横向扩展的那一层。每次写入都要经过同一台机器,而把它换成更大的机器,是扩容阶梯上最昂贵的一步(先用数据证明,该换更大的机器了)。函数或触发器在那里占用的每一个 CPU 周期,都在和每个查询竞争:花 1 毫秒格式化报表,就意味着结账插入要多等 1 毫秒才能得到一个核心。
我们的立场是:数据库负责让数据变少、保持数据正确,或节省一次往返通信。其他事情都交给应用层,即使 SQL 能够表达它。尤其如此。
- 留在数据库中: 过滤、连接和聚合(在应用中统计两百万个事件,意味着把整张表传过去,只为了算出一个数字);基于集合的写入;必须与写入保持原子性的约束;以及任何能节省往返通信的工作。
- 移到应用中: 逐行格式化(按用户地区设置显示日期、格式化货币或 HTML);经常变化的业务规则,这些规则应该用功能开关管理,并能在几分钟内回滚,而不是靠一次迁移;任何会调用外部世界的事情,因为事务回滚时,函数无法把已经发出的邮件收回来(把工作移出请求路径);以及任何你希望用单元测试覆盖的事情。
下面看看格式化的代价。一个报表端点用 SQL 的 format() 和 to_char() 把 200,000 个事件变成句子;另一种做法只返回组成句子的六个字段:
| 200,000 行 | 原始字段 | 在 SQL 中格式化 |
|---|---|---|
| 我们机器上的服务器时间 | 约 60 ms | 约 230 ms |
| 发送的文本 | 9.2 MB | 18 MB |
| 端到端、经过 psql | 约 110 ms | 约 280 ms |
服务器时间是四倍,字节数是两倍。应用本来也会花费大致相同的 CPU;区别在于 CPU 花在哪里。应用服务器一分钟就能加机器。每秒调用 10 次时,多出来的 170 毫秒会让主库将近两个核心整天都在格式化日期,其他查询只能排在它们后面等待。
如果逻辑是在保护数据或缩小数据,就把它放在数据旁边。如果逻辑是在服务某项功能或某个人,就把它和功能放在一起。(用 jsonb_agg 返回结果、替代一串查询循环,这是在节省往返通信,而不是做格式化。)
(这里把一行输出换行显示。)
我们用 explain (analyze, timing off) 分别计时,各取五次中的最佳结果;并把原始字段转换为文本,这样两边都会为服务器本来就要执行的行发送转换付出代价。格式化每行大约多花 0.9 µs。在应用中,Intl.DateTimeFormat 会在用户自己的地区设置下完成同样的工作。
23-functions要寻找候选对象:在 pg_stat_statements 中,如果一条语句总耗时很高,但每次调用访问的共享块很少,那么它不是在读取页,而是在计算(用四种方式对同一个视图排序,先看总耗时)。在等待样本中,如果很多会话都没有等待事件,说明它们正在占用 CPU(采样等待,看看时间花在哪里)。而 track_functions 会统计每个函数的耗时(函数不可见,除非你开启跟踪)。
SQL 函数会内联;PL/pgSQL 函数不会
下面是开头提到的两个函数,它们使用 (account_id, created_at) 上的索引:
调用者要查一天的数据:select * from account_events(42) where created_at > '2026-10-05';两个孪生函数各自的计划如下:
SQL 版本的计划中没有函数:规划器把查询粘贴进来,合并调用者的过滤条件,然后使用索引。Function Scan 会先把函数运行完,再进行过滤;规划器只能猜测函数内部做了什么(函数会隐藏你的统计信息)。对于最大的租户,它必须读取该租户曾经拥有的每个事件,才能展示其中一天的数据。
23-functions如果函数只包含一个查询,就用 SQL 编写。 需要变量、循环或异常处理时,再使用 PL/pgSQL,并且要预期它表现得像一次调用,而不是一个视图。
STRICT、SECURITY DEFINER 或 SET 子句会阻止内联
只有在以下条件同时满足时,返回集合的 SQL 函数才会内联:函数体是单个 SELECT,易变性是 STABLE 或 IMMUTABLE(默认值 VOLATILE 不行),不是 STRICT,不是 SECURITY DEFINER,并且没有 SET 子句。我们逐项尝试了这些会阻止内联的设置;每种情况都得到一个 Function Scan。因此,带有固定 search_path 的定义者函数(本来就应该如此)是一个黑盒:把这类函数留给范围狭窄的操作。
标量 SQL 函数的函数体是单个表达式(select <expression>,没有 FROM)时可以内联,前提是它声明的易变性不能比函数体本身更严格。函数 is_failed(p jsonb) 的函数体是 select p ->> 'status' = 'failed',它在计划中会显示为 ((payload ->> 'status'::text) = 'failed'::text),因此可以使用 (payload ->> 'status') 上的表达式索引。PL/pgSQL 版本会显示为 Filter: is_failed_pl(payload),并且每行调用一次。PostgreSQL wiki 的 Inlining of SQL functions 页面列出了完整的条件。
PL/pgSQL 会按会话缓存计划
PL/pgSQL 会在每个会话中准备每条语句一次,并保留该计划,因此也会继承 预备语句的切换规则:先使用五次自定义计划;如果通用计划的代价看起来不比这些自定义计划的平均代价高,就切换到通用计划。同一个陷阱现在藏进了函数内部。把规划器章中的 latest 查询封装到 latest_ids(k text) 中,针对常见的 kind 调用五次,第六次调用就会锁定通用计划:对于罕见的 incident kind,它要读取 34,536 页,而不是 23 页。
函数本身没有变化;变化的只有会话历史,这就是这个问题如此难以复现的原因。把修复固定到函数上:alter function latest_ids(text) set plan_cache_mode = force_custom_plan,这样每次调用都会根据实际值规划。
PostgreSQL 18 把计划缓存扩展到了不会内联的 SQL 函数:声明为 strict 的 SQL 版本(因此无法内联)在五次调用后也会发生同样的切换,对于 incident 要读取超过 30,000 页。动态 SQL(return query execute ... using k)每次调用都会重新规划。根据 PL/pgSQL 文档,创建函数时,语句只会做语法检查;第一次运行时才会进行分析。此前从未运行过的分支中拼错的表名或列名,只有等到该分支最终运行时才会暴露。
23-functions易变性是给规划器的承诺
每个函数都属于 IMMUTABLE(参数相同,结果永远相同)、STABLE(在同一条语句内结果相同,不执行写入)或 VOLATILE(不作任何承诺,也是默认值)之一,规划器会照单全收。下面是同一个纯函数:它计算向前 n 天的截止时间,依次使用每种标记,并用于过滤 projects:
第一种 IMMUTABLE 在规划时被折叠成了一个字面值(常量会被折叠)。STABLE 保留为一次调用,却驱动了同一个索引。VOLATILE 可能随行变化,所以顺序扫描会调用它 20,000 次。要为每个函数选择事实允许的最严格标记。
虚假的 IMMUTABLE 会返回过时结果
永远不要给函数贴比事实更严格的标签。一个读取表中设置的查找函数被标记为 IMMUTABLE,它供一个统计过期项目的 PL/pgSQL 函数使用:30 天时结果是 19,271。把设置改成 365 天后,同一会话仍然返回 19,271,因为“常量”30 已经被折叠进缓存计划;新会话返回 10,913。只要连接池中的这些连接还在,这个错误就会持续存在。IMMUTABLE 函数绝不能读取表、设置、时区或时钟。
STABLE 版本的估算来自对其值的窥探:直方图给出 173 行(实际数量是 163)。VOLATILE 版本退回到三分之一的默认值,即 6,667 行。设置 track_functions = 'pl' 后,IMMUTABLE 版本运行一次,STABLE 版本运行两次(一次用于估算,一次用于扫描),VOLATILE 版本运行 20,000 次。
23-functions过时的查找:
alter function setting(text) stable 会使缓存计划失效,下一次调用就会得到正确结果。在索引表达式中,虚假的 IMMUTABLE 会留下过时的索引项,直到执行 REINDEX。还有一个区别:VOLATILE 函数会为其中的每个查询获取新的快照,因此能看到调用它的语句所做的更改;STABLE 和 IMMUTABLE 使用调用者的快照。
23-functions并行安全需要显式选择
用户函数默认是 PARALLEL UNSAFE,因此,在 where 子句中只要有一个未标注的辅助函数,两百万行的扫描就会在一个进程中运行(一个未标注的函数会让查询保持串行)。把纯辅助函数标记为 PARALLEL SAFE。不要撒谎:执行写入的函数必须保持 UNSAFE(标成安全后,我们的函数因 cannot execute INSERT during a parallel operation 而失败);接触临时表或后端本地状态的函数则是 RESTRICTED。
规划器还会相信另外三个标记
易变性不是规划器会照单全收的唯一标记。只有超级用户才能设置的 LEAKPROOF,允许函数先于 行级安全过滤器运行,这样策略就可以使用索引(不防泄漏的函数会在策略之后运行)。较高的 COST 会让规划器先运行代价更低的条件。ROWS 会替换返回集合的函数默认 1,000 行估算(FROM 中的函数会被估算为 1,000 行);更好的做法是把它写成可内联的 SQL。
触发器逐行运行,除非你另有指定
触发器是数据库在表发生变化时调用的函数,而你拥有的每个外键本身已经带着几个触发器。BEFORE ... FOR EACH ROW 会在行处理过程中调整行;AFTER 会对已经发生的变化作出反应。FOR EACH STATEMENT 触发器只运行一次,并通过过渡表读取所有发生变化的行。WHEN 子句让触发器变得再便宜不过:不触发的触发器。
行触发器每行大约花费一微秒
我们在 events 的一份不记录 WAL 的表副本上更新了 100,000 行,取五次中的最佳结果:
| 100,000 行更新 | 我们机器上的时间 | 相对基线每行增加 |
|---|---|---|
没有触发器,语句中使用 updated_at = now() | 150 到 185 ms | |
BEFORE 行触发器设置 updated_at | 240 到 300 ms | 约 1 µs |
写入一条审计行的 AFTER 行触发器 | 360 到 400 ms | 约 2 µs |
每行约一微秒:一次只处理一行时只是噪声;但对每晚处理 5,000 万行的任务来说,会耗掉将近一分钟的 CPU 时间。BEFORE 触发器还会为每行增加一条 WAL 记录,用于记录在触发器看到该行之前取得的锁。在语句中设置该列,可以完成同样的工作,却不必承担触发器的代价。
BEFORE 触发器只有一行:new.updated_at := now()。在记录 WAL 的表副本上,每次运行处理 20,000 行;根据 pg_stat_get_backend_wal(PostgreSQL 18+):没有触发器时写入 60,264 条 WAL 记录;BEFORE 触发器、行审计触发器和语句审计触发器各自都写入 80,264 条。审计触发器每写一条审计行,就会增加一次堆插入;无论逐行还是逐语句,都是如此。BEFORE 触发器本身不会写入任何东西;pg_walinspect 显示,它增加的记录是 Heap LOCK:裸更新有 19,994 条,带触发器时有 39,994 条。(裸更新也有锁记录,因为这里的每个新版本都会写到不同的页。)
对于普通审计日志,语句级触发器从过渡表写入全部审计行,耗时 270 到 320 ms,即每行约 1.3 µs:节省了 10% 到 30%,因为写入的行仍然相同。真正的收益来自逐行工作发生合并的情况,例如下面的计数器。AFTER 行事件会在语句结束前排队留在内存中,因此一次巨大的更新会排出一张巨大的队列。
23-functions计数器触发器会让写入者串行化
保持每个项目精确计数的通常做法是(精确计数会读取全部数据)在 events 上设置行触发器,运行 update projects set event_count = event_count + 1。它是正确的,但有两个问题,你在开发环境中看不到。
现在每次插入都会锁住父行。 两个会话向项目 7 插入事件时,过去可以并行进行。现在每个会话都会更新项目 7,而该行会一直锁到提交,因此会话 B 要等待会话 A 的整个事务结束(行锁存在行中,而不在 pg_locks 中)。最繁忙的项目会产生最多竞争。
一次批量插入会把同一行重写数千次,每次更新都要遍历此前的行版本。为一个项目插入 500 个事件大约耗时 16 ms;插入 4,000 个则耗时约 260 ms。行数是八倍,时间却是十六倍。
语句级触发器可以解决批量场景。锁的问题却无从解决。需要时用索引计数,或者把增量追加到一张窄表中,这种追加操作不会阻塞,再稍后汇总这些增量(把热点计数器移到窄表)。
COPY 会触发触发器;复制角色会跳过触发器
COPY FROM 和 INSERT 一样会触发触发器,因此加载一百万行要为触发器付出一百万次代价。session_replication_role = replica 会跳过触发器(设置它需要超级用户权限,或者在 PostgreSQL 15+ 中被授予对它的 SET 权限,而托管服务往往不会授予这种权限);逻辑复制会设置这个值,这样触发器就不会执行两遍。
外键也是触发器,而 replica 会把它们全部关闭。我们为不存在的项目 999,999 插入了一条事件,插入成功了。用这种方式加速批量加载,留下的孤儿行也不会有任何约束再报告。
对于每个触发器,alter table ... enable replica trigger t 只会在 replica 模式下触发,enable always trigger t 则会在两种模式下都触发。在逻辑复制订阅端,如果某个触发器应该在复制行到达时运行(比如维护一张本地汇总表),就必须使用其中一种设置,否则它会悄无声息地什么也不做。
23-functions触发器必须证明自己值得存在
本章中的每个触发器都做了它声称要做的事。但它是否应该存在,是另一个问题。我们的答案是:触发器应该比你想象的少。
它们带来的好处。
- 原子性。 触发器的工作会和更改一起提交或回滚。审计行不会只写了一半。
- 不怕调用者漏做。 每次写入都会触发它:应用、第二个服务、迁移、凌晨两点有人从 psql 运行的修复命令,都一样。
- 覆盖每个写入者的历史(历史触发器捕获每个写入者,每行插入一次)。
它们隐藏的东西。
- 行为。 一条报告插入一行的
insert,可能还增加了计数器、写入了审计行、排队了一个任务。调用位置没有任何说明,搜索应用代码也找不到这些行为。 - 代价与串行化。 每次回填都要支付逐行代价;更新父行的触发器会把并行插入变成排队。
- 顺序。 同一事件上的触发器按名称顺序运行,而不是按创建顺序。我们依次创建了
z_normalize、a_validate和m_stamp,但它们的运行顺序是 a、m、z。重命名一个触发器,就会重新排列业务逻辑。 - 部署与调试。 它们以迁移的形式发布,一次改变所有会话的行为;出错时,
INSERT报告的是一行 PL/pgSQL 上下文,而不是堆栈跟踪。
我们的规则。 当工作必须与更改保持原子性,并且必须对每个写入者发生时,使用触发器:审计和历史行、你不能指望调用者设置的派生列、以及任何约束无法表达的跨行不变量。很可能会有批量写入时,使用语句级触发器。
其他事情都在提交之后交给应用处理:通知、邮件、webhook、缓存失效、搜索索引、热点行上的计数器、业务工作流。如果副作用不能丢失,就在事务中写一行 outbox。触发器是隐藏的写入,每行都要永远为它付费,因此每个触发器都应该经得起设计评审。
23-functions一个会写入另一张表的触发器,也会触发那张表上的触发器,因此一条触发器链可能在无人注意前连续执行好几层。
约束触发器可以延迟到提交时执行(deferrable initially deferred),适合用于某条跨行规则在事务内部可能短暂不成立的情况。两个并发事务仍然可能同时通过一个会读取其他行的检查(有目的地选择隔离级别)。
过程可以提交事务
过程(PostgreSQL 11+)通过 CALL 调用,可以边执行边提交;函数不能这样做。因此,对于回填和清理任务,过程是更合适的形式:如果只有一个长事务,它会持有锁、阻止 vacuum 清理,并在任何错误发生时丢掉全部结果。我们的回填分十个已提交批次更新了 100,000 行。要在自动提交模式下运行过程:如果处于 BEGIN 内部(许多驱动程序会替你添加它),第一次 COMMIT 会因 invalid transaction termination 而失败。
EXCEPTION 块就是子事务
带有 EXCEPTION 子句的 PL/pgSQL 块每次进入时都会设置一个保存点,形成一个子事务,并付出 子事务并非没有代价所描述的成本。进入这样的块 100,000 次大约耗时 18 ms,而普通块只需 3 ms,即使没有抛出错误也是如此。循环插入 1,000 行,每次插入都放在异常保护块中,就会使用 1,000 个子事务 ID,从第 65 行开始就超过了 64 个条目的缓存。使用 on conflict do nothing,让错误根本不会发生;或者用一层异常处理包住整个循环。
函数不可见,除非你开启跟踪
本章中的每个问题,一旦能看见它就更容易修复;而默认统计信息会让函数不可见。track_functions 在 pg_stat_user_functions 中统计每个函数的调用次数和耗时。pg_stat_statements.track = all 会为函数内的语句建立独立条目,而不是把它们隐藏在一条缓慢的 INSERT 中(从 pg_stat_statements 开始)。auto_explain.log_nested_statements 会记录函数内部的计划,而 EXPLAIN 本身不会显示这些计划。
快速调用不会记录任何内容。第七次调用会记录嵌套计划:
Filter: (kind = $1) 就是通用计划,它在实际运行中暴露出来了。在生产环境中,要按慢查询阈值将计划记入服务器日志,并寻找本应是字面值却出现 $1 的地方。
本章要点
- 主库是唯一不能横向扩展的 CPU。让它承担能缩小数据、保持规则原子性或节省往返通信的工作。
- 如果函数只包含一个查询,就用 SQL 编写,并标记为
STABLE或IMMUTABLE。 - PL/pgSQL 五次调用后可能切换到通用计划;
force_custom_plan可以解决参数倾斜带来的计划问题。 - 在事实允许的范围内尽可能严格地标注易变性,绝不超出这个范围。
- 只有当工作必须具有原子性并且必须对每个写入者发生时,才使用触发器。
- 计数器触发器会把所有写入者串行化到父行上。
session_replication_role = replica也会禁用外键。- 不要在逐行循环中使用
EXCEPTION块。
延伸阅读
- User-Defined Functions,PostgreSQL 文档。SQL 函数、过程,以及
SUPPORT、ROWS和COST钩子。 - Function Volatility Categories,PostgreSQL 文档。每种标记背后的承诺,包括过时计划的风险。
- Inlining of SQL functions,PostgreSQL wiki。内联的每个条件。
- PL/pgSQL: Plan Caching,PostgreSQL 文档。PL/pgSQL 如何准备语句,以及何时切换到通用计划。
- Transaction Management in PL/pgSQL,PostgreSQL 文档。过程内部何时可以使用
COMMIT。 - Triggers 和 CREATE TRIGGER,PostgreSQL 文档。触发顺序、过渡表和约束触发器。
- auto_explain,PostgreSQL 文档。记录嵌套语句的计划。
25 大家都得排队
一次迁移向 accounts 添加一个可为空的列。这是只改元数据的操作,几毫秒就能完成。它一运行,所有访问 accounts 的请求都挂起,连接池被填满,网站随即宕机。迁移中的操作本身并不慢;它只是在等待,而在它等待时,其他所有人也都在等待。
下面是在本书数据库中用三个会话复现的那次故障。migration 运行 alter table accounts add column note text,web 运行 select name from accounts where id = 42:
reporting 会话在一个事务中运行了 select count(*) from accounts,然后一直没有关闭事务。迁移需要排他锁,因此要等待 reporting 会话。Web 请求只想读取一行,reporting 会话本来完全可以允许它读取,但它排在迁移后面。之后的每个请求都加入了队列。
通常读操作和写入操作不会互相阻塞(更新就是插入)。但一旦阻塞发生,队列就是全部故事。学会读懂它。
有目的地选择隔离级别
Read committed(读已提交)是默认级别,每条语句都会获得一个新的 快照;repeatable read(可重复读)让整个事务使用同一个快照;serializable(可串行化)还保证结果可以由某种一次只运行一个事务的顺序产生。只有 serializable 能排除所有异常列出了每种级别能防止什么;下面看看它们会怎样影响你的代码。(InnoDB 默认是 repeatable read:MySQL 默认是 repeatable read;Postgres 不是。)
Read committed 会丢失在应用中计算的更新
大多数应用都运行在这个级别上,而且没有问题。陷阱在于应用代码中的读改写:两个请求分别读取一个余额,在应用中减去金额,再把结果写回去。
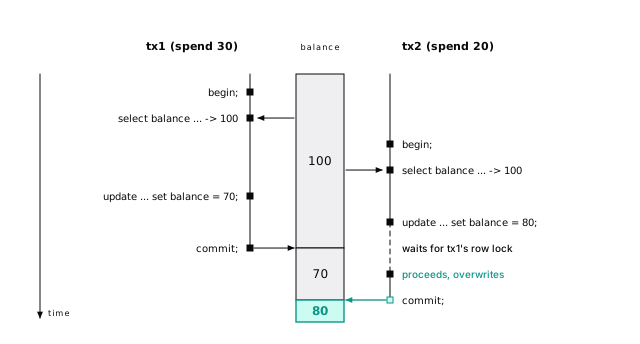
tx1 花了 30,tx2 花了 20:总共花掉 50 个额度,余额却只减少了 20。这就是丢失更新,但没有任何错误会告诉你。把算术放进数据库:
因行被其他事务修改而等待的更新操作,会重新读取最新版本,并重新检查它的 where 条件,因此两个并发消费会依次返回 70 和 50。当逻辑无法放进一条语句时,在读取行时用 select ... for update 把它锁住。
两个会话都处于 read committed,并分别执行请求处理器会做的事情:
tx2 等待期间,pg_stat_activity 显示它在等待 Lock / transactionid,并被 tx1 阻塞。tx1 提交后,tx2 的 update 发现该行已改变,重新读取它,重新检查 where account_id = 42(仍然为真),然后把根据旧读取算出的 80 写到 tx1 的 70 之上。
24-concurrency让两个事务都在 repeatable read 下运行相同的顺序;tx1 提交的瞬间,tx2 就会失败,因为它想更新的行在自己的快照之后发生了变化。tx1 的 70 会保留下来。
24-concurrencyRepeatable read 会把这场竞态变成需要重试的错误
在 repeatable read 下,如果某行在你的快照之后被别人改过,更新会被拒绝,而不是覆盖它:同一场竞态会让 tx2 报错 could not serialize access due to concurrent update。在这个级别和 serializable 下,这个错误(SQLSTATE 40001)是正常结果,不是 bug:你的代码要重试整个事务,否则少见的竞态就会变成用户看到的错误。
Serializable 能捕获 repeatable read 漏掉的写偏差
repeatable read 仍然允许写偏差。值班表必须始终有人值班。两名工程师同时取消值班;他们各自统计当前值班人数(2 人,所以安全),然后只停用自己的行。两人都提交后,没有人值班;没有任何一行被更新两次,因此 repeatable read 看不出问题。在 serializable 下,其中一个事务会因 could not serialize access due to read/write dependencies among transactions 失败。Postgres 会记录每个事务读取过的内容,但不会阻塞任何人;当没有任何串行顺序能够解释这个结果时,它会中止其中一个事务(即使只读事务也可能看到不可能的结果)。
两行都处于启用状态;每个工程师的事务都会执行:
读取跟踪会显示为 SIReadLock 条目,位置在 pg_locks 中。你付出的是额外开销和更多可重试失败,其中少数是误报。
24-concurrency我们的默认选择是:请求使用 read committed,报表使用 repeatable read,跨行规则使用 serializable,并配合重试。
重试整个事务
串行化失败(40001)和死锁(40P01)意味着“什么都没有发生;再试一次”。要重试整个事务,包括读取,限制尝试次数,并在每次重试前加入随机延迟。这两个代码是默认应该重试的代码;在 serializable 下,唯一性冲突(23505)或排他约束冲突(23P01)也可能表示在竞态中落败,值得再试一次。不要盲目重试其他任何错误。把副作用移出可重试的函数,否则每次尝试都会发出一封邮件;记录意图,并在提交后执行(把消息和订单放进同一个事务)。
一个错误会中止整个事务
在 Postgres 中,事务内部的任何错误都会毒化事务的剩余部分:
update 根本没有运行,commit 返回了 ROLLBACK:第一次插入也消失了。“插入、捕获重复错误、继续执行”一旦被包在事务中就会失效。要么预防错误(on conflict do nothing),要么使用保存点(MySQL 不同;参见错误会中止整个事务)。
24-concurrency保存点可以把损害控制住
保存点标记了一个可以回滚到的位置,同时不会丢掉其余工作。ORM 所谓的“嵌套事务”其实是保存点(Rails 的 requires_new: true、Django 的嵌套 atomic()),每个 PL/pgSQL EXCEPTION 块也是如此。
子事务并非没有代价
每个保存点都会启动一个子事务,而执行写入的子事务会获得自己的 XID。每个后端会缓存 64 个子事务 XID;超过这个数量后缓存就会溢出,每个会话针对该事务执行的可见性检查都会退回到磁盘上的结构 pg_subtrans。副本更加脆弱:在那里,只要一个长事务旁边出现任何子事务,就可能把查找推入 pg_subtrans。2021 年这件事影响了 GitLab:在他们的副本上,长事务期间的一个保存点就足以让查询时断时续地停滞数周,直到他们从应用中移除了保存点(GitLab 的说明)。不要在循环中使用保存点,优先考虑 on conflict。
pg_stat_get_backend_subxact(PostgreSQL 16+)可以显示它。在一个事务中设置 64 个保存点,每个保存点后都执行一次插入:subxact_count 为 64,subxact_overflowed 为 false。再多一个:仍然是 64,但变成 true。
24-concurrency每条语句都会锁住表
每条语句还会把它访问的每张表锁到事务结束。八种表锁模式的三个事实,几乎涵盖了每次事故:
- 读写在表级别永远不会冲突。 行冲突是另一套系统。
ACCESS EXCLUSIVE会与一切冲突,包括普通的select。drop、truncate以及大多数alter table形式都会取得这种锁。SHARE会阻塞写入,但不会阻塞读取,这就是普通的create index会让表变成只读、而create index concurrently存在的原因。
大多数 ALTER TABLE 形式都会取得 ACCESS EXCLUSIVE
大多数 ALTER TABLE 形式都会取得 ACCESS EXCLUSIVE,即使工作本身瞬间就能完成:添加可为空的列只需微秒量级的时间,但拿到锁才是危险所在(变更模式,服务照常)。要检查一条语句,可以在事务中运行它,读取 pg_locks 中属于当前会话的行,然后回滚。
ROW SHARE 用于 select ... for update;ROW EXCLUSIVE 用于 insert、update、delete;SHARE UPDATE EXCLUSIVE 用于 vacuum、analyze、create index concurrently;SHARE ROW EXCLUSIVE 用于 create trigger 和添加外键;EXCLUSIVE 用于 refresh materialized view concurrently。
X 表示请求的模式会等待。在这台服务器上,add column、add constraint ... not valid 和 rename column 取得了 AccessExclusiveLock;validate constraint 和 set (fillfactor = 90) 取得了 ShareUpdateExclusiveLock;add foreign key ... not valid 在两张表上都取得了 ShareRowExclusiveLock。
24-concurrency一个等待中的锁会阻塞后面的所有人
锁像柜台前的一条单队列,会按顺序授予。与一个正在等待的请求冲突的请求,即使它们与当前已经持有的所有锁都兼容,也会排在该请求后面。这能防止饥饿,也正是一次无害的迁移会变成故障的原因。
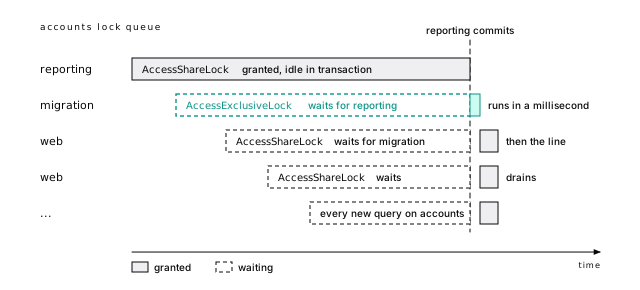
在开头那次事故期间的 pg_locks 中,Web 查询的 AccessShareLock 显示 granted = f,尽管唯一已授予的锁也是另一个 AccessShareLock:它排在迁移后面。在生产环境中,每秒几百个请求会堆积起来,连接池耗尽,健康检查失败。reporting 事务结束后,迁移在一毫秒内运行完,队列随之排空。
24-concurrency防御手段是让 DDL 快速放弃。设置 set lock_timeout = '2s' 后,同一个 alter 会在两秒后因 canceling statement due to lock timeout 失败,而不是一直占着队列。两秒的流量阻塞只是一个小插曲;重试几次。然后找到持有该锁的会话:持锁的 idle in transaction 会话就是 bug,而idle_in_transaction_session_timeout会限制它能持续多久。
任何取得 ACCESS EXCLUSIVE 的语句,只要需要等待,就可能让网站宕机,因此每个迁移会话都设置 lock_timeout 并重试(规则一:lock_timeout 和重试)。
三个会话:reporting 运行 begin; select count(*) from accounts; 后保持空闲;migration 运行 alter table accounts add column note text;web 运行 select name from accounts where id = 42。然后把 pg_locks 与 pg_stat_activity 按 pid 连接起来,条件是 relation = 'accounts'::regclass:
24-concurrency行锁存在行中,而不在 pg_locks 中
行锁在持有期间不会保存在 pg_locks 中(否则可能有数百万条)。加锁事务会把自己的 ID 写进该行的行头(xmax、一切都从页说起),想要冲突锁的事务会等待那个事务结束。因此,行锁等待通常会显示为一个未授予的 ShareLock,其锁定对象是 transactionid,而不是行本身。当多个会话在同一行上排队时,第一个等待者还会持有该行的重量级 tuple 锁,后面的会话则改为等待这个 tuple 锁,因此在堆积场景中,你也会看到未授予的 tuple 条目。
| 锁 | 由谁取得 | 阻塞 |
|---|---|---|
FOR UPDATE | DELETE;会更改键列的 UPDATE;显式请求 | 所有其他行锁 |
FOR NO KEY UPDATE | 其他任何 UPDATE;显式请求 | FOR UPDATE、FOR NO KEY UPDATE、FOR SHARE |
FOR SHARE | 显式的 select ... for share | FOR UPDATE、FOR NO KEY UPDATE |
FOR KEY SHARE | 对被引用行执行的外键检查;显式请求 | 仅 FOR UPDATE |
外键需要较弱的那一对锁。向项目 1 插入事件时,会在项目行上取得 FOR KEY SHARE;重命名项目(FOR NO KEY UPDATE)不会阻塞它。但如果某个会话在项目上持有 select ... for update,插入就会等待:在我们的测试中等待了 3.6 秒,直到该会话回滚。因此,除非你要删除该行或更改它的键,否则应使用 for no key update 加锁。nowait 会直接失败而不是等待;skip locked 会跳过别人持有锁的行。
会话 A 在项目 1 上持有 for update 时,插入操作的锁如下:
写入者会请求对持锁者 XID 的 ShareLock:“等那个事务结束后叫醒我。”已授予的 tuple 锁就是写入者在该行队伍最前面的位子;第二个写入者会在这个锁上等待,且锁不会被授予。
24-concurrency共享行锁会产生 multixact,而 multixact 也会回卷
当两个打开的事务以互不冲突的模式锁住同一行时,例如两个子插入都在同一个父行上取得 FOR KEY SHARE,Postgres 会把一个multixact 放进它的 xmax:这是一个指向成员列表的 ID。一个热门父行被许多并发子插入访问时,每次插入都会产生一个新的 multixact。multixact 也有自己的回卷问题(回卷会在任何内容损坏前停止写入):要在事务 ID 年龄旁边观察 mxid_age(datminmxid),并让插入子行的事务保持短小。
三个会话分别执行 begin,为父行 1 插入一行子数据,然后保持打开。pgrowlocks 显示父行的 xmax 中有一个 multixact,pg_get_multixact_members 则以 keysh 模式列出三个事务 ID。第三个持锁者获得了一个包含三者的新 multixact,因为 multixact 从不改变。
24-concurrencyautovacuum_multixact_freeze_max_age(默认 4 亿)会强制执行防回卷清理。成员区有自己的上限:超过约 10 GB 后,autovacuum 会在各处变得激进;达到约 20 GB 时,服务器拒绝创建 multixact(multixact "members" limit exceeded,Routine Vacuuming),这恰恰会阻塞那些通过外键引用繁忙父行的插入操作。对于存在这类父行的表,alter table projects set (autovacuum_multixact_freeze_max_age = 100000000) 会让它更早冻结;同时避免在应用代码中使用 for share。
解决 LWLock 等待要调整负载,而不是查询
并不是每条队列都由你主动请求的锁造成的。在高并发下,会话还会排队等待 LWLock,而你的语句根本不会提到它。轻量级锁会保护一块共享内存,持锁时间以微秒计;大量等待意味着“我们太多人同时在做同一件内部工作”,而不是“有人持有我想要的东西”。因此,修复点在负载:
LockManager: 热点查询锁住了太多表和索引。每个后端都有几个私有的 fast-path 槽位,可以跳过共享锁表:PostgreSQL 17 及之前是 16 个,18 默认是 64 个。BufferMapping: 工作集装不进内存。WALWrite: 太多微小事务提交。
每个查询都会锁住规划时涉及的每个关系;共享锁表分成 16 个分区,每个分区由一个 LockManager LWLock 保护。私有的 fast-path 槽位会为弱表锁跳过共享锁表;PostgreSQL 18 会根据 max_locks_per_transaction 设置槽位数量,默认是 64 个(提交记录)。一个无法剪枝、涉及 365 个分区的查询使用了 64 个快速路径锁和 1,035 个存入共享锁表的锁(查询无法剪枝的每个分区都会增加规划时间)。删除未使用的索引,让分区查询执行剪枝;在 18 中,如果热点查询访问的关系超过 64 个,就提高 max_locks_per_transaction(这需要重启)。
24-concurrency查找一页需要哈希查找会解释 BufferMapping,多次提交共享一次刷新会解释 WALWrite。第四种等待是 BufferContent,表示很多会话都在写同一个热点页,例如不断增大的键的最后一个叶页。服务器内部还会形成两条队列:当很多会话增长同一张表时会出现关系扩展锁(Lock:extend),自 PostgreSQL 16 起它便便宜得多(提交记录);以及用于事务状态、子事务和 multixact 的 SLRU 缓存,当 pg_stat_slru 的 blks_read 持续增长时会发生颠簸。
Postgres 队列与业务写入一起提交
行锁和 skip locked 结合起来就是一个可靠的任务队列,而且比独立系统多一个决定性的优势:任务和业务写入在同一个事务中入队。回滚时,任务从未存在过。jobs 表需要一个仅覆盖排队中任务的部分索引;无论有多少完成的任务堆积起来,这个索引都能保持很小:
每个工作进程都会跳过别人持有的任务
每个工作进程都必须在不等待其他工作进程的情况下取得不同的任务:
子查询会跳过其他工作进程持有的任务,并取得它能锁住的第一项:表中有 200,000 个已完成任务时,也只读取 20 个缓冲区。当工作进程 A 持有任务 1 时,工作进程 B 立即拿到了任务 2。没有 skip locked 时,第三个工作进程会排在 A 后面,直到它的 lock_timeout 触发:每个工作进程都在同一行上排队,吞吐量降到了单个工作进程的水平。
短任务持有事务;长任务先提交
对于只运行几秒的任务,让事务覆盖整个任务:发生崩溃时,事务会回滚,任务也会被释放。对于运行几分钟的任务,如果事务一直不提交就会阻碍清理,先认领并提交,再处理,最后记录结果,同时让回收器处理卡在 running 状态的任务,并使用幂等的处理器。一次认领大约读取 20 页,因此在任务本身成为瓶颈之前,队列很少会限制吞吐量;我们没有测量上限,所以请测量你自己的上限。按计划删除或归档 done 任务:部分索引会忽略它们,但堆和清理不会。
入队事务中的 notify jobs 只会在提交后送达,因此工作进程可以 listen,而不是高频轮询。但在入队速率很高时,每个发出 notify 的提交事务都要取得一个数据库级锁来排队通知,从而把这些提交串行化。每批只通知一次,或者让工作进程以适中的间隔轮询。
按事务取得咨询锁,而不是按会话取得
要对行以外的对象实现互斥(“每次只能有一个夜间汇总任务”),咨询锁会锁住一个整数键,至于这个键代表什么由你决定。两个 cron 实例分别启动事务,并运行 select pg_try_advisory_xact_lock(hashtext('nightly-rollup')):第一个得到 t,第二个得到 f 并退出。事务范围的形式会在提交或回滚时释放,因此优先使用它,而不是会话级的 pg_advisory_lock。只要连接池中的会话还在,会话级锁就会沿着任何跳过解锁的错误路径泄漏。
下面的检查使用会话级的 pg_try_advisory_lock 来展示区别。在 pg_locks 中,这个锁显示为 locktype = advisory,objid 为 107030647,也就是 hashtext('nightly-rollup') 的结果。对于实体锁,两整数形式的 pg_advisory_xact_lock(1, account_id) 可以避免哈希碰撞。
24-concurrency死锁是顺序错误
死锁是两个事务分别等待对方持有的锁。经过 deadlock_timeout(1 秒)后,Postgres 会发现这个环并中止其中一个:
tx1 收到 ERROR: deadlock detected;tx2 提交了。修复方法是一致的加锁顺序:按主键顺序锁行(先运行 select ... order by id for update,因为 where id = any($1) 不保证顺序),按固定顺序访问表,并重试 40P01。开启 log_lock_waits。
错误的 DETAIL 会列出两个进程、各自在等待的 XID 和两条语句,这通常能直接指向以相反顺序加锁的两条代码路径。pg_stat_database.deadlocks 会统计死锁,因此把计数画成图:持续出现的少量死锁意味着热点路径中的顺序错误,而不是运气不好。开启 log_lock_waits 后,任何超过 deadlock_timeout 的锁等待都会连同阻塞者一起记录,即使没有形成环,也能捕获这些险些酿成死锁的情况。
24-concurrency找到根阻塞者
遇到卡住的情况,先找到队列根部。下面的查询会列出所有正在等待锁的会话,以及阻塞其中一个会话的每个会话;它生成了本章开头的表格,而那张表只展示了查询结果中的部分列:
wait_event 在表锁上显示 relation,在行锁上显示 transactionid。根阻塞者的 blocked_by 为空,而且通常是 idle in transaction。select pg_terminate_backend(11033) 会结束它并回滚事务(pg_cancel_backend 对空闲会话不起作用)。然后修复那个让事务一直打开的问题。
本章几乎每个问题都会因长事务而恶化:它们持锁更久,延长锁队列,为死锁扩大窗口,让子事务溢出持续存在,并阻塞清理。不要让事务跨越网络调用或用户思考时间而保持打开。
本章要点
- 读已提交会在应用的读改写中丢失更新。把算术放进 SQL。
- repeatable read 和 serializable 会把异常变成
40001错误;重试整个事务,把副作用放在提交之后。 - 一个错误会中止事务。预防错误,而不是捕获错误;不要在循环中使用保存点。
- 一个等待中的
ALTER TABLE会阻塞该表上之后的每个查询。迁移总是设置lock_timeout。 LWLock等待意味着负载正在争用一个内部结构:调整负载。for update skip locked和部分索引可以构建一个与业务写入一起提交的任务队列。- 按一致的顺序加锁。发生事故时,先找到根阻塞者。
延伸阅读
- Transaction Isolation,PostgreSQL 文档。每个级别提供什么保证,包括读已提交的重新检查规则。
- Explicit Locking,PostgreSQL 文档。表锁和行锁矩阵、咨询锁、死锁。
- Serialization Failure Handling,PostgreSQL 文档。哪些 SQLSTATE 应该重试。
- Why we spent the last month eliminating PostgreSQL subtransactions,GitLab,2021 年。上面那次事故的完整调查。
- Subtransactions,PostgreSQL 文档。64 项缓存以及超过它之后会发生什么。
- src/backend/storage/lmgr/README,PostgreSQL 源码。自旋锁、LWLock、重量级锁和快速路径。
- Multixacts and Wraparound,PostgreSQL 文档。冻结 multixact 以及成员区的限制。
26 变更模式,服务照常
现在你知道队列为什么会形成了。一个 ALTER 在报表后面等待排他锁,后面的每个请求也都在等待,即使只是普通读取(一个等待中的锁会阻塞后面的所有人)。你的连接池被填满,网站因为一次“什么也没做”的迁移而宕机。GoCardless 记录过完全相同的情况:一次很快的外键迁移排在长时间读取后面,API 请求又排在迁移后面,API 大约宕机了 15 秒。
这一章讲的是另一半:周二下午两点发布模式变更,而不形成那条队列。
模式变更造成伤害,不是因为它们慢,而是因为它们锁住了什么以及锁了多久。因此,每条语句都要问两个问题:它取得什么锁,以及它持有锁多久?几乎每个危险变更都有安全版本:同一个变更拆成几个步骤,让弱锁持有几分钟,或让强锁只持有几毫秒。下面就是这些拆分,以及测量结果。
所以,迁移的第一条规则与 DDL 毫无关系。
规则一:lock_timeout 和重试
在每个迁移会话上设置 lock_timeout。它到期后,语句会失败(canceling statement due to lock timeout),离开队列,后面的流量也会重新流动,即使报表仍然没有结束。
25-migrations这个错误说明系统正在正常工作。请求排队几秒不会被察觉;无上限的等待就是一次故障。失败的语句什么也没有改变,因此要在有上限的尝试次数内重试它(只有超时而没有重试,会把本来能完成的迁移变成失败的发布):
把它放进迁移工具的连接初始化设置中,设为 1 到 5 秒:足够长,可以穿过短事务之间的空隙;又足够短,可以让停顿不被察觉。如果重试仍然不断失败,就找出阻塞者,通常是长事务或处于 idle in transaction 的会话(backend_xmin 会指出阻碍清理的事务)。
还要设置一个宽松的 statement_timeout,这样意外重写 500 GB 的表会在几分钟内失败,而不是持有排他锁一小时。只有在并发构建索引(以及执行同类操作 reindex concurrently 和 drop index concurrently)时,才把这两个超时都关闭(单独运行并发构建,不设超时,并检查索引是否有效)。
每次变更都是系统目录编辑、扫描或重写
拿到锁之后,重要的是操作会持续多久。变更要么只编辑几行系统目录记录(无论表有多大都只需几毫秒),要么扫描每一行来检查某件事,要么重写表及其索引;后一种操作的时间、磁盘和 WAL 都会随着表增长。在 events 上(275 MB、200 万行),不同做法的区别,是一次不被察觉的发布与一次持续 9 秒的冻结;在 CI 的 1,000 行数据上,你根本分辨不出它们。
因此,要在用生产数据恢复出的副本上测试迁移(这也验证你的备份),并观察两个数字。重写会改变 pg_relation_filenode,也就是表所在的文件;扫描会增加 seq_scan,即表的完整扫描次数。
目标锁是 ShareUpdateExclusive,它既不阻塞读取,也不阻塞写入(大多数 ALTER TABLE 形式都会取得 ACCESS EXCLUSIVE)。下面的每种安全模式,都会让变更中耗时较长的部分在这种锁下运行。
常量默认值没有代价;易变默认值会重写
从 PostgreSQL 11 开始,添加带常量默认值的列只改系统目录。易变默认值不是:
第一个 filenode 就是表原来拥有的那个:常量没有触碰任何行。Postgres 把 'web' 存在系统目录中,读取旧行时再提供它。UUID 需要每行有不同的值,因此 Postgres 在 AccessExclusive 下重写了全部 200 万行,耗时 9 秒。规则是易变性,而不是有没有调用函数:now() 是稳定的,只计算一次,会像常量一样保存。
对于逐行值,要把它拆开:先添加不带默认值的列(只改系统目录),再 set default,让新行得到默认值(也只改系统目录),最后按批次对旧行执行回填。
常量进入了 pg_attribute,成为该列的“缺失值”:atthasmissing = t、attmissingval = {web}。旧元组的属性数少于表的属性数,Postgres 会从这里填上缺口。add column ts2 timestamptz default now() 耗时 17 ms,filenode 保持为 17220,而每个已有行都会报告迁移发生的时刻,这可能不是你想要的结果。生成列遵循相同逻辑:虚拟生成列(PostgreSQL 18+ 的默认形式)只改系统目录,存储生成列会重写表(小测试表的 filenode 从 19978 变为 19986)。
25-migrations先通过 CHECK,再设置 NOT NULL
set not null 必须证明不存在空值,因此会在 AccessExclusive 下扫描整张表,并在从磁盘读取每一页时阻塞读取。使用 CHECK 作为过渡:
第 3 步才是巧妙之处(PostgreSQL 12+):一个证明 col is not null 的有效 CHECK,可以让 SET NOT NULL 跳过扫描。在 PostgreSQL 18 上可以跳过 CHECK:直接把 NOT NULL 本身添加为 NOT VALID,然后验证它。
seq_scan 在 pg_stat_user_tables 中会统计完整扫描。直接执行 set not null 会让它从 11 增加到 12(在我们已缓存的表上耗时 130 ms)。在上述模式中,第 2 步使它增加一次(耗时 87 ms,流量可以在锁下通过),第 3 步没有增加,耗时不到 4 ms。
25-migrations在 18 中:
两者之间,插入空值已经会被拒绝。需要注意的是:验证之前,\d 已经显示 not null,pg_attribute.attnotnull 也已经是 true。应当检查 pg_constraint.convalidated。
25-migrations先添加 CHECK NOT VALID,再验证
永远不要一步给大表添加 CHECK。先以 NOT VALID 添加它(短暂持锁,不扫描,并立即对新写入强制执行),然后再执行 VALIDATE CONSTRAINT(在 ShareUpdateExclusive 下扫描),正如上面 NOT NULL 模式的第 1、2 步。如果验证发现坏行,它会失败,但约束会保留下来,在你修复旧数据时继续保护新写入。
25-migrations先添加 NOT VALID 外键,再验证
一步添加外键会在阻塞两张表写入的同时扫描子表。按相同方式拆开:
add 操作仍然会阻塞父表的写入,而父表可能是最繁忙的表,并且像其他操作一样排队(GoCardless 就是被这个问题绊倒的),所以要给它设置 lock_timeout。还要自己并发地为引用列建索引;没有这个索引,每次从 projects 删除数据都会扫描 events(有目的地选择约束)。
选择与表流量匹配的索引构建方式
Postgres 有两种构建索引的方式,选择可以用一句话说清。普通的 CREATE INDEX 做的工作最少,但在完成前会阻止表上的所有写入;CREATE INDEX CONCURRENTLY 允许写入通过,却要付出两倍读取、大量等待以及中途失败的可能。
下面是在没有其他操作运行时,以两种方式构建同一个 (project_id, created_at) 索引,目标表是 events:
同一个索引,同样的 WAL,表读取次数却翻倍:在我们的机器上,并发构建耗时约为普通构建的 1.5 倍。
这是基准测试看到的代价。用户感受到的代价,则是写入发生了什么。构建索引期间,四个客户端尽可能快地向 events 插入数据:
| 构建方式 | 构建期间完成的插入 | 最慢插入 |
|---|---|---|
create index | 41 到 56 | 723 到 751 ms |
create index concurrently | 1,848 到 2,119 | 16 到 103 ms |
普通构建期间到达的每次插入,都要等它全部完成。在 events 上,这不到一秒;在 200 GB 的表上,这就是整个构建过程,而每次结账、注册和 webhook 都在队列中等待。
区别只有一个锁。普通构建的 ShareLock 允许读取通过,却阻塞每次写入都需要的 RowExclusiveLock;并发构建的 ShareUpdateExclusiveLock 两者都不阻塞。
四个 pgbench 客户端运行单行插入,持续 5 秒;构建在开始 1.5 秒后启动,pgbench -l 记录每次插入的延迟。构建是串行的(没有并行工作进程),因此上面的每一页和每一个 WAL 字节都属于构建;时间是五次运行的中位数,表已缓存。
普通构建中,最慢插入的耗时就是构建的耗时:每个等待中的插入都在构建提交的瞬间完成,而少数在“构建期间”完成的插入,是在构建取得锁之前刚好落地的。并发构建的 16 到 103 ms 属于磁盘和 CPU 的普通竞争。普通构建后让迁移事务保持打开,就能把这一状态定格下来:
同一时刻发出的主键查找立即返回。
25-migrationsB-树构建会通过 max_parallel_maintenance_workers(默认 2)在多个工作进程间拆分扫描和排序,但 maintenance_work_mem(默认 64 MB)为整个构建设定预算,而且包括领导者(leader)在内的每个进程都需要其中 32 MB。因此,在默认设置下,允许两个工作进程也只会实际使用一个。下面是我们在 8 核机器上进行七次构建的中位数:
| maintenance_work_mem | 允许的工作进程数 | 进程数 | 构建耗时中位数 |
|---|---|---|---|
| 64 MB | 0 | 1 | 0.82 s |
| 1 GB | 0 | 1 | 1.06 s |
| 64 MB | 2 | 2 | 0.53 s |
| 256 MB | 2 | 3 | 0.50 s |
| 1 GB | 4 | 5 | 0.37 s |
单靠内存没有带来任何收益(排序 200 万个键时,溢写磁盘的代价很低)。内存带来的是工作进程,而工作进程带来了时间收益:使用五个进程时,速度是原来的 2.2 倍。对于有空闲核心的服务器上的大构建,要在迁移会话中同时提高这两个设置。并发构建只会并行化第一次扫描。要进行全服务器范围的配置,请参阅每个 autovacuum 工作进程也会占用 maintenance_work_mem。
25-migrations如果你得问它是否繁忙,就使用并发构建
只有在表上没有人写入时,才使用普通的 CREATE INDEX:新表或空表(包括在同一迁移中更早创建的表,此时普通构建能让表、索引和约束保持原子性);真正的维护窗口,且写入确实已停止,而不是“通常很安静”;或无人写入的表,例如查找表、归档表,或已经停止接收行的分区。
生产环境中任何会接收写入的表,都使用 CREATE INDEX CONCURRENTLY。如果你得问一张表是否繁忙,就把它当作繁忙。
普通构建不是糟糕的默认值:它更快、具有事务性,而且失败时能干净地回滚。它只是不适合那些你最常需要建立索引的大型繁忙表。
单独运行并发构建,不设超时,并检查索引是否有效
- 为这条语句关闭
lock_timeout,这是规则一:lock_timeout 和重试的例外。并发构建的锁即使在等待时也不会阻塞读取或写入,因此超时不会保护任何流量。更糟的是,Postgres 会把它应用到构建等待其他事务的场景:1 秒超时会取消一个卡在慢报表后面的构建,并留下无效索引。为构建设置lock_timeout = 0和statement_timeout = 0。(普通构建要保留它:只要它在等待锁,就已经会阻塞后面的写入。) - 单独运行。 它拒绝在事务块中运行,因此要用工具的“无事务”开关,为它提供自己的迁移。同一张表上的第二个并发构建会排在第一个后面。
- 观察它。
pg_stat_progress_create_index会显示阶段、已完成的页数和它正在等待的会话(current_locker_pid),等待对象可能来自数据库中的任何位置:对该表尚未提交的写入、repeatable read 事务、打开的游标或正在运行的查询都可能成为等待对象。空闲的 read committed 会话不算。 - 完成后检查
indisvalid。 失败、取消或超时的构建会留下无效索引(并发构建失败时)。重试前,先并发删除它。
失败后,create index concurrently if not exists 是一个陷阱:无效索引已经存在,所以它什么也不做,却报告成功。先删除同名的无效索引,再创建它,并在每次发布后检查 indisvalid。
普通构建只有一次遍历:加锁、扫描、排序、写入树、提交。并发构建面对的是不断变化的表,因此会分阶段运行(文档)。我们在一次构建期间每隔几毫秒采样 pg_stat_progress_create_index;开始时 events 中有一个未提交的插入,并有一个空闲的 repeatable read 事务打开;两者都在 0.3 秒后释放:
(locker 是 current_locker_pid;每一行是该阶段看到的最后一个样本。)
从上到下读取。索引进入系统目录时是无效的,因此新事务知道它存在。构建会等待已经在写这张表的事务(插入事务,pid 2081),扫描全部 35,173 页,排序 200 万个条目,然后把索引标记为 ready(indisready):此时写入会开始维护它。验证阶段读取新索引的 7,703 页,并再次读取表,把期间到达的行加入进去。最后,它会等待所有更早的快照(repeatable read 会话,pid 2082),并把自己标记为有效。普通构建只会显示三个“building index”阶段。
25-migrations最后的等待会覆盖数据库中快照早于验证阶段的每个事务,无论它访问了哪张表。我们测试了每种会话:
| 构建开始时打开的会话 | 会拖住构建吗? |
|---|---|
处于事务中空闲、read committed,读取或写入 accounts | 否 |
处于事务中空闲、repeatable read,读取 accounts | 是:“waiting for old snapshots” |
在 accounts 上打开游标的 read committed 会话 | 是:“waiting for old snapshots” |
| 仍在任何表上运行查询 | 是:“waiting for old snapshots” |
向 events 未提交的插入 | 是:“waiting for writers before build” |
Read committed 每条语句都会获取新快照,因此空闲会话不会持有任何东西;repeatable read 会一直保留快照,直到事务结束。线索是 backend_xmin 在 pg_stat_activity 中的值:只要某个会话的这一值早于构建,它就会阻碍构建,甚至一个写成单条长语句的监控循环也包括在内。构建等待时没有危害(插入会直接通过);它只是无法结束。
还有两个意外。构建的锁会与该表上的清理冲突:autovacuum 会让开,防回卷清理不会,于是构建会等待。唯一索引构建从第二次扫描开始就强制唯一性:当我们的索引仍无效、构建停留在“waiting for old snapshots”阶段时,一次重复插入因 23505 失败。一次失败留下的无效索引,会一直拒绝重复值,直到你删除它。
25-migrations失败的普通构建会回滚。失败的并发构建(唯一索引中出现重复值、死锁、取消或超时)会留下一个无效索引,并以 INVALID 标记出现在 \d 输出中。查询永远不会使用它;如果它已经通过第一次扫描,之后的每次写入仍然会维护它(我们有一次很晚才取消构建,它在 20,000 次插入中持续增长);而且它的名称会与你的重试冲突。找出它们,并发删除它们,修复原因,再次构建:
indisready 表明你拥有的是哪一种索引。遇到重复值的唯一索引构建会在第一次扫描中失败,因此留下的索引尚未 ready,写入会跳过它。验证阶段失败或被取消的索引已经 ready,在你删除它之前,写入都会为它付出代价。
25-migrations并发构建唯一索引,然后把它挂接上
直接添加唯一约束,会在 AccessExclusive 下构建它的索引。先并发构建索引,再把它挂接上。挂接只改系统目录,但仍然需要短暂的 AccessExclusive,因此要在 lock_timeout 下像其他 ALTER 一样运行:
主键也是相同做法(primary key using index),前提是列已经是 NOT NULL;如果还不是,挂接操作会执行 SET NOT NULL,并在该锁下扫描表。
永远不要在线上表上运行普通 REINDEX。它会在索引上取得 AccessExclusive,而且因为规划任何查询都会锁住该表的每个索引,即使从不访问被重建索引的主键查找,也会一直等到提交。改用 reindex index concurrently(PostgreSQL 12+)。分区表完全拒绝 concurrently,因此要并发构建每个分区的索引,再把它们挂接到父表的索引上。
对于膨胀的索引(何时重建)或受排序规则库变更影响的索引,reindex index concurrently(PostgreSQL 12+)会在旧索引旁边构建一个 ..._ccnew 副本,然后交换两者;所用锁及注意事项与并发创建相同。如果失败,删除残留的 _ccnew 后重试;残留的 _ccold 表示它已经成功,只有旧副本需要删除。
普通 REINDEX 是紧急情况下人们最容易使用的办法,却比普通 CREATE INDEX 更糟:它还会在索引上取得 AccessExclusiveLock,而且规划任何查询都会锁住表上的每个索引。普通重建 events_created_at_idx 时,select kind from events where id = 42 明明不会使用该索引,却一直等到提交,正如 REINDEX 文档所警告的那样。
25-migrations对分区表执行 create index concurrently 会失败(cannot create index on partitioned table "events_m" concurrently),而在父表上执行普通构建,会同时对每个分区取得 ShareLock。并发构建各个部分,再把它们组装起来。在 events 的三个按月分区上:
父表的索引会在最后一个分区索引挂接后自行变为有效。之后使用 partition of 创建的分区会自动获得匹配的索引,并以普通方式构建;这没问题,因为它们是空的。对一个已经包含行的表执行 attach partition,也会在锁下以普通方式构建缺失的索引,因此要在挂接表之前给它建好索引。分区章节提供了生成这些语句的工具。
25-migrations扩宽类型没有代价;大多数其他类型变更都会重写
放宽限制没有代价。增加限制、改变标度或改变表示方式,都会重写表以及该列上的每个索引。在一张 100,000 行的表上:
| 变更 | 会重写吗? |
|---|---|
varchar(20) 到 varchar(50),varchar(n) 到 text | 否 |
text 到 varchar(100),即使所有值都放得下 | 是 |
int 到 bigint | 是 |
numeric(12,2) 到 numeric(12,4) | 是 |
timestamp 到 timestamptz,会话处于 UTC | 否 |
timestamp 到 timestamptz,任何其他时区 | 是 |
因此,要用 CHECK 约束表达长度限制。对于时间戳,转换会把每个旧值当作会话时区中的时间来读取。如果保存的值确实是 UTC,先设置 timezone = 'UTC':字节不会改变,也不会发生重写。如果它们保存的是本地钟表时间,就把会话设置到那个时区并接受重写;把它们按 UTC 转换虽然可以跳过重写,却会让每个值按偏移量发生移动。
integer 主键在 21 亿处插入失败,而 alter column id type bigint 会在 AccessExclusive 下重写表及其每个索引:在这种规模下会停机数小时。在线修复是一个由本章各部分组成的小项目,安全完成需要数周,而且完全可以避免:从第一天起就使用 bigint。
对于已经存在的表,要把每个序列与它的最大值画在一起,并在它远未达到最大值时就发出告警:
有一个陷阱:从 PostgreSQL 10 之前升级的数据库,可能有 serial 列,类型为 integer,却由 bigint 序列支持。它们报告的比例不到百分之一,而列本身却已经接近溢出,因此要把 last_value 与列类型的取值上限比较,而不只是与序列的 max_value 比较。
在线交换的顺序如下,这样可以让外键始终保持生效:
- 添加并同步。 添加
id_new bigint,允许为空、没有默认值(只改系统目录),并添加一个触发器,在每次插入和更新时设置new.id_new := new.id。 - 回填。 按批次遍历主键,对已有行执行回填。
- 在不持有长锁的情况下让它变成 NOT NULL:
add constraint ... check (id_new is not null) not valid,然后validate constraint,就像上面 NOT NULL 模式的第 1、2 步。(在 PostgreSQL 18 中使用not null id_new not valid和validate。) - 并发地在
id_new上建立唯一索引。 - 对每个引用列重复相同操作。 每个子表的
parent_id都获得一个bigint双胞胎列,以及自己的触发器、回填和 NOT NULL;然后从这个双胞胎列向父表的id_new建立外键,以NOT VALID添加并验证。外键可以引用唯一索引,因此不必等待新的主键。 - 在一个短事务中交换。 设置
lock_timeout并重试:删除旧外键和旧主键,在新索引上执行add primary key using index(不扫描:经过验证的 CHECK,或 PostgreSQL 18 的 not-null 约束,已经证明不存在空值),重命名父表和每个子表中的列,把标识或序列移到新列(先执行alter sequence ... as bigint,因为int序列会在 2,147,483,647 处停止),然后删除触发器。新的外键已经验证过,因此完整性从未中断。 - 之后再删除旧列。 等到没有代码再读取它们,在下一个发布中删除。
上面的类型表,已通过比较每次变更前后的 pg_relation_filenode 核对过。每个“否”都保留了表文件;每个“是”都产生了新文件。
25-migrations在序列还剩几年可用时开始交换。一个从 2,147,483,646 重新开始的 int 标识列,只能插入两行,然后就会拒绝此后的每次插入:
于是,文章中的监控查询会显示 tickets_id_seq 已达到 100%。
25-migrations重命名要用扩展与收缩发布
rename column 只改系统目录。问题在于,几十个应用进程都知道旧名字:代码和模式不可能在同一瞬间改变,因此谁先改变都会破坏另一个。永远不要做让新旧代码无法同时存活的变更。把它拆成扩展和收缩,并在两者之间发布:
用这种方式把 events.kind 重命名为 event_type,需要三次迁移和三次发布。这就是零停机的真实代价,也是谨慎选择名称的最佳理由。触发器或视图可以替代部分应用代码,但二者都不能消除这些阶段。同样的步骤也可以用来拆分列、合并表,也可以改变 API 发出的 ID(通过同时接受两种 ID,让 API 脱离整数 ID)。
按主键逐步遍历,在短批次中回填
update events set status = payload->>'status' 是一个跨越 200 万行的事务:产生 200 万个新行版本和 200 万个死行版本(更新就是插入),每行都锁到提交,阻碍清理,让整张表大小的 WAL 流向副本;如果在最后一行失败,所有工作都会回滚。要分批:
- 按范围遍历主键(
id > $1 and id <= $1 + 10000 and status is null),永远不要使用OFFSET。每个批次的代价相同,而status is null让任务可以重启。 - 每个批次都提交,让每个批次的耗时远低于一秒。过程可以做到这一点(过程可以提交事务);我们的任务约 16 秒填完了 200 万行。
- 预期会膨胀: 快速回填可能在 autovacuum 追上之前让表翻倍,因此大型任务要在中途执行清理。
- 把它作为可恢复的任务放在模式迁移之外运行,并在副本延迟时暂停它。
批量加载新行是另一种任务,有更好的工具(冻结分区,挂接已构建的分区,再分析父表)。
先删除代码,再删除列
删除列只改系统目录,但会取得 AccessExclusive,因此要设置 lock_timeout。危险在应用:明确写出该列名的代码会失败,没写列名的代码也可能失败,例如在启动时缓存了列清单的 ORM。先发布忽略该列的代码,等到所有旧进程都消失,再删除它。
删除表会在每张通过外键与它相连的表上取得 AccessExclusive。先逐条删除这些外键,每条语句都设置一个较短的 lock_timeout,这样就没有一条语句需要同时取得所有锁;如果想保留廉价的撤销方案,可以先重命名表,下一次发布再删除。
事务性 DDL 会持有所有锁直到提交
Postgres 的 DDL 具有事务性,因此大多数工具会把每次迁移包进事务,不会出现只执行一半的迁移。代价是:每把锁都会一直持有到提交。
update 之后,pg_locks 仍然显示两张表上的 AccessExclusiveLock,对任意一张表的每个查询都会排队,直到 commit。
25-migrations你持有的每一把锁,都会让下一个等待变得更糟。因此:每次迁移只处理一张有风险的表,并且模式迁移中不做数据变更。(MySQL 会分别提交每条 DDL 语句;参见DDL 具有事务性。)
本章要点
- 每次迁移都设置
lock_timeout(1 到 5 秒)并重试。等待锁的 DDL 会阻塞后面的所有操作,甚至包括读取。 - 判断变更是只改系统目录、扫描还是重写,并在生产规模的数据上测试。
- 常量默认值会立即完成;
gen_random_uuid()这样的易变默认值会重写。 - 以
NOT VALID添加 CHECK、FOREIGN KEY 和 NOT NULL 约束,然后在流量可以通过的锁下执行VALIDATE。 - 普通
create index会在整个构建期间停止写入;concurrently让写入继续,但读取量翻倍。普通方式只用于无人写入的表。 - 并发构建时关闭
lock_timeout,并检查残留的INVALID索引。永远不要在线上表上运行普通reindex。 int到bigint、text到varchar(n)以及标度变更都会重写。- 重命名用扩展与收缩发布;回填要在迁移之外作为按主键范围分批运行的任务。
延伸阅读
- ALTER TABLE,PostgreSQL 文档。每种形式的锁级别、重写行为和
NOT VALID规则。 - CREATE INDEX: building indexes concurrently,PostgreSQL 文档。两阶段构建等待什么,以及为什么会留下无效索引。
- Zero-downtime Postgres migrations: the hard parts,GoCardless。上面那次锁队列故障,由亲历它的团队讲述。
- Zero-downtime Postgres schema migrations need this: lock_timeout and retries,Nikolay Samokhvalov,PostgresAI。规则一的依据,以及重试策略。
- strong_migrations、Squawk 和 pgroll。把这些规则编码进工具,让评审者不用靠记忆。
27 快速加载数据
一个跑一整夜的导入,和一个在咖啡变凉前就完成的导入,可以把同样的一百万行加载进同一张表。区别在于每一行还拖着什么:一次提交、一次往返通信、一次语句解析、每个索引中的一项、一次外键查找。去掉这些工作后,Postgres 加载行的速度几乎和写入页的速度一样快。
然后账单就来了。大批量加载写入的 WAL 比它填满的表还大,这些日志会触发检查点,并落到每个副本上。行还没有完成,因此第一次读取它们的查询会向每一页写入。规划器也不知道表发生了变化。
所以,加载时要让每行做尽可能少的工作,然后在用户发现之前,按照自己的意图主动支付延期的代价。
加载速度从每秒 1,200 行到 50 万行
我们把结构相同的事件行加载进 events 的新副本,测试了十种方式;每种方式都在一台使用默认设置的独立服务器上运行,并统计每秒行数和 WAL。WAL 是每次变更在到达数据文件之前都要写入的日志(先记日志,再写数据)。两种单行方式加载 1,000 行,因为一百万行会耗时数小时;其余方式加载 1,000,000 行:
从每秒约 1,200 行到 50 万行。表格每向下走一步,就去掉一种逐行开销;本章剩下的内容会一次比较两行。(第 8b 行的速率是重写表的速度,不是加载速度。)
把这些时间当作大致值。它们来自一次安静运行;如果有十几个其他工作负载共享这台笔记本,有些方式会慢好几倍。WAL 的数值始终没有变化:每次相差都不到 1 KB。
每台服务器都设置了 wal_level = replica、max_wal_size = 1GB 和数据校验和;检查点之后,WAL 通过 pg_stat_get_backend_wal()(PostgreSQL 18)按会话统计。每张一百万行的表最终都是 137 到 138 MB。我们的多次运行中,COPY 的速率为每秒 125,000 到 508,000 行,而自动提交为每秒 15 到约 1,200 行,因此实验只检查比例,从不比较时间。
每批提交一次,而不是每行提交一次
第 1 行和第 2 行是相同的 1,000 次插入。唯一的区别是在它们外面加了一次 begin 和一次 commit。在这里,这让加载速度达到原来的约 15 倍;在更繁忙的运行中,所有刷新都要排在其他写入后面,速度则达到原来的 100 多倍。
自动提交的 INSERT 自己就是一个事务,每次提交都要等待它的 WAL 到达磁盘(提交意味着刷新)。提交记录很小,等待才是每行的代价。
整个加载只使用一个事务,也有自己的问题:第 999,999 行失败会回滚全部工作,运行期间还会阻碍清理。向线上表加载时,每几千行到几十万行提交一次,就像回填那样。向空表加载时,一个事务就够了,也能解锁下面最快的路径。
单行插入会写两条 WAL 记录:堆和主键;自动提交还会增加一条提交记录。500 行的结果是:12,884 ms 内写入 1,521 条记录,而另一种方式在 88 ms 内写入 1,021 条。多出的 500 条记录只多出 17 KB WAL,而繁忙笔记本运行 Docker 时,12.9 秒几乎全部耗在刷新上。优秀的 NVMe 磁盘刷新耗时远低于 1 毫秒;这种规律仍然成立。
26-loading用数组批处理,而不是 VALUES 列表
提交开销去掉后,每行的代价就是语句本身:一次往返通信、一次解析、一次规划。批量发送 1,000 行,这个代价就由 1,000 行共同承担。但如何批处理仍然重要。
第 3 行和第 4 行都在每条语句中发送 1,000 行,并写入相同的 WAL。在这里,unnest 只快了 6%;在更繁忙的运行中,最多快到 9 倍。
差别在解析。多行字面量 VALUES 列表是 ORM 通常使用的“批量插入”形式;每批 1,000 行就是 6,000 个文本值,Postgres 必须为每条语句从头解析它们,而 CPU 紧张时最先受影响的就是解析。INSERT ... SELECT * FROM unnest($1, $2, ...) 为每列发送一个数组:无论批次大小如何都只有六个参数,而且只需准备一次。
如果驱动程序可以绑定数组,就使用 unnest。两种形式都不能节省磁盘:每行都会写一条堆记录和一条索引记录。
预先准备的 unnest 形式:
作为参数绑定时,VALUES 列表每 1,000 行需要 6,000 个占位符,而且每种批次大小都需要新的语句文本;协议把一条语句限制在 65,535 个参数以内。作为字面量时,它在我们的运行中从未比 unnest 更快:安静服务器上大致相当,繁忙服务器上则慢到 9 倍。
26-loadingCOPY 是批量加载路径
COPY ... FROM STDIN 可以用文本、CSV 或二进制这样的简单格式流式发送行,完全不需要每行一条语句。它的写入方式也不同:它会缓冲行,一次填满一页堆,而不是每行写一条堆 WAL 记录,每页只写一条堆 WAL 记录(但每条索引项仍然按行记录)。读取 wal/row 列:每种 INSERT 形式都是 239 字节,COPY 是 193 字节。第 5 行的加载速度则是 unnest 的好几倍。
使用客户端一侧的方式:COPY table FROM '/path' 会读取数据库服务器上的文件,需要特殊权限;而 psql 的 \copy 会读取你的机器上的文件,并以 COPY FROM STDIN 的形式发送:
所有成熟的驱动程序都支持 copy 协议。在 Go 中,pgx 的 CopyFrom 发送二进制 COPY;在 Node 中,pg-copy-streams 会把任意流接入管道。
在 100,000 行上,VALUES 和 unnest 各自写入约 203,000 条 WAL 记录(每行 2 条);COPY 写入 105,243 条:每条主键项一条,再加上每个堆页一条;字节数少了 19%。
26-loading有三件事会让 COPY 退回到逐行处理。第一,BEFORE 或 INSTEAD OF 行触发器,因为每行都必须先通过它,才能处理下一行。第二,易变的默认表达式,因为它可能读取正在加载的表(标识列和 serial 列背后的 nextval() 是源码中特别放行的唯一例外)。第三,带有易变函数的 WHERE 子句位于 COPY 上。AFTER 触发器,包括外键背后的触发器,不会停止批处理,但每行仍然会排队一个事件。
COPY FREEZE 会写入已完成的行
普通 COPY 加载的行还没有完成。它的行头记录了加载事务,因此第一次读取时,系统会检查该事务是否已提交,并把答案保存到行的提示位中(读取也可能写入)。这会弄脏页面;而在开启数据校验和时(PostgreSQL 18 的默认设置),还会记录一张整页镜像。检查点之后,对刚刚复制的 100,000 行执行第一次 count(*):
只读查询弄脏了存放这些行的全部 1,759 页,并写入 14.4 MB WAL,而表只有 14 MB。如果这是用户的查询,他们就得等待。之后,清理还必须在事务 ID 计数器回卷之前,回来冻结每一行,将它们永久标记为对所有事务可见。
COPY ... WITH (FREEZE) 会写入已经冻结的行;从 PostgreSQL 14 开始,它还会把每一页标记为全可见。条件是:表必须在同一个事务中创建或截断,这样其他人不可能已经看到它:
跳过 truncate 后,Postgres 会拒绝执行。对冻结表执行相同的 count(*) 什么也不会弄脏,即使是第一次执行也如此;第 6 行的 WAL 代价与第 5 行相同。如果可以使用 FREEZE 加载,就使用它。
26-loadingpg_visibility_map_summary('l_freeze') 报告 1,759 页全可见、1,759 页全冻结:也就是所有存放着行的页。(文件共有 1,816 页;COPY 每次扩展表几页,空页没有东西可以标记。)WAL 为 19.4 MB,而普通 COPY 为 19.3 MB。如果没有 truncate,错误就是 cannot perform COPY FREEZE because the table was not created or truncated in the current subtransaction。
文档指出了这个例外:冻结行对每个快照都可见,因此一个在加载前就已开始、并在加载事务提交后读取该表的事务,会看到新行,而正常 MVCC 本应把它们隐藏起来。对于在加载完成前没有人读取的表,这无关紧要。
26-loading先使用不记日志表,再 SET LOGGED,只是把 WAL 开销后移
一个常见技巧是:创建unlogged表,不写 WAL 地加载它,然后执行 alter table ... set logged。第 8a 和第 8b 行:加载只写入 34 KB,然后 SET LOGGED 写入 181 MB,而普通 COPY 写入 184 MB。
这条绕路只是把代价推后,并没有消除它。SET LOGGED 会重写表并记录每一行,因为副本或恢复操作没有其他数据记录。它执行时会持有 ACCESS EXCLUSIVE 锁,而在转换完成之前如果崩溃,表会被清空。
不记日志表适合用作不会转为正式表的暂存表:加载原始数据,用 SQL 清洗,把结果插入真正的表,再删除暂存表。只有最后一次插入承担 WAL(能重新生成的数据可以跳过 WAL)。
在 100,000 行上,SET LOGGED 写入 18 MB:先为行写入 100,190 条记录,再为重建的索引写日志。这个大小大约等于表加索引的大小,接近普通 COPY 写入的 19.3 MB。
26-loadingwal_level = minimal 会为新表跳过 WAL
第 7 行是常见加载建议中的陷阱。“在同一个事务中创建表并执行 COPY”什么也没有节省:184 MB,与第 5 行相同。
这个技巧只有在 wal_level = minimal 下才有效;此时,创建或截断表并加载数据的事务会在提交时对新文件执行 fsync,而不是记录这些行。在这样启动的服务器上,相同的加载只写入 38 KB,而不是 184 MB;在该服务器上,它的速度约为向已有表执行 COPY 的三倍。
除此之外,它的代价都很高:开启和关闭都需要重启,没有副本,没有归档,也就没有时间点恢复。它只适合一种工作:在任何对象依赖它之前,从头构建数据库,然后获取一份新的基础备份。托管数据库通常不允许设置它。
第二台服务器运行 wal_level=minimal 和 max_wal_senders=0(否则无法启动)。在那里,向事务开始前就已存在的表执行 COPY 仍然写入完整的 184 MB(每秒 109,841 行);在事务中创建表时写入 38 KB(每秒 352,487 行);在事务中截断表时写入 2,939 KB。自 PostgreSQL 13 起,跳过范围覆盖向新表或已截断表执行的任何写入,而不只是 COPY;写入量低于 wal_skip_threshold(默认 2 MB)时会在提交时记录 WAL,这比 fsync 更便宜。实验随后用 SIGKILL 杀掉服务器并让崩溃恢复运行:两次加载都完整无缺,因为提交时的 fsync 已经让文件持久化,而无需日志。
26-loading.sh加载之后再建立索引和外键
第 9 行和第 10 行把相同的行加载进同一张表,表上有一个主键、两个二级索引和三个外键。索引与约束已经存在时,速度是每秒 64,047 行,WAL 为 346 MB;全部留到之后添加时,速度是每秒 431,132 行,WAL 为 174 MB。在我们的多次运行中,速度达到原来的 6 到 7 倍,WAL 减半,而且索引小了 10 MB。
加载期间,每行都会为每个索引写一条 WAL 记录,并为每个外键执行一次查找。之后再建立时,索引只需对键排序一次,然后按页写入。在建立索引的会话中给这次排序足够的内存(set maintenance_work_mem = '1GB';它按操作计算,因此会话级设置是安全的)。pg_restore 自己就是按这个顺序工作的。
这适用于空表和暂存表。线上表要保留索引,并分批加载。
外键:先 NOT VALID,再 VALIDATE
外键会为每一条加载的行检查父表,并在语句结束前为每行排队一个触发器事件;文档警告,在加载数百万行时,这个队列可能耗尽内存。
像迁移那样分两步添加:NOT VALID 会在不检查旧行的情况下对新行强制执行;然后 VALIDATE CONSTRAINT 通过一次连接运算检查旧行,并在允许写入继续进行的锁下运行。验证是真正的检查:实验中,它发现了约束建立前埋入的一条孤儿行;在删除这条孤儿行之前,约束一直保持未验证状态。
在 100,000 行上,索引已存在时要写入 348,851 条 WAL 记录;之后建立索引时只有 5,194 条。(时间差会在不同运行中变化;早期有一次两种方式之间没有检查点,裸加载反而输了。)
行按 created_at 顺序到达,但 (project_id, created_at) 会把它们分散到索引各处,因此叶页会从中间分裂,最后部分为空。构建索引时会先排序,并按填充因子(fillfactor)填充(B-树叶页为 90%):构建后的大小是 3,104 KB,而逐行增长的是 4,328 KB;增长出来的索引会一直更大,直到 REINDEX。每个索引都是写入税测量了每个索引的代价。
CREATE INDEX 会在 maintenance_work_mem 中排序(默认 64 MB),并与最多 max_parallel_maintenance_workers 个工作进程共享内存(默认 2);超过内存后会溢写到临时文件。实验中的构建在 1 MB 时发生溢写,在 256 MB 时没有。让全服务器值保持适度;每个 autovacuum 工作进程也可能占用这么多内存,除非另有 autovacuum_work_mem 设置。
26-loading大批量加载会触发检查点并淹没副本
写入数 GB WAL 的加载不会孤立发生。
检查点会提前到来。 超过 max_wal_size(默认 1 GB)的 WAL 会触发检查点(检查点为恢复设定上限)。上面最重的加载为一百万行写入了 346 MB,因此一千万行会超过这个限额三次。每个提前的检查点都会和加载争用磁盘,并让对每一页的下一次变更再次记录整页镜像(检查点后的第一次变化会记录整页)。计划加载之前,提高 max_wal_size(只需 reload,不需重启),确保 pg_wal 所在磁盘有空间,完成后再改回去。
每个副本都会收到每个字节,并由单个进程重放(重放只有一个进程)。减少 WAL(不带索引和约束加载、在不记日志表中暂存、开启wal_compression),分批加载,并在副本延迟超过预算时暂停。逻辑订阅端逐行应用加载,因此延迟会更久。
将同样的 500,000 行加载进有三个索引的表,分别把 max_wal_size 设为 128 MB 和 16 GB:
两个强制检查点,产生 999 张整页镜像,而不是 3 张。这里的差额只有 6 MB,是因为加载主要写入新页,无论如何都会完整记录;向带有已有索引的大表加载时,每次检查点后都会为数千张散布的旧页重新生成镜像。开启 log_checkpoints 后(PostgreSQL 15 起默认为开启),日志会注明哪些检查点是因 WAL 量而触发的。
长时间运行的 COPY 会在 pg_stat_progress_copy 中报告进度(PostgreSQL 14+);跟踪 tuples_processed,因为 bytes_total 对于 STDIN 为 0。
26-loading.sh开放入口前先 vacuum 和 analyze
加载完成后,立刻自己支付延期的代价:
一次处理会设置提示位,冻结每一行,使防回卷清理不必再次访问这些页(清理的冻结步骤),把页标记为全可见以便仅索引扫描工作,并收集统计信息。autovacuum 最终也会到达那里,但会受到限流,并按自己的计划运行;而此时用户已经在查询了。对于 COPY FREEZE 表,没有行需要再冻结,同一条命令几乎不写任何东西。
不要跳过 analyze。从未分析过的表没有列统计信息,因此规划器只能猜测。问它刚加载的 100,000 个事件中有多少是告警时,它估计为 554;真实数量是 12,621,约为估计值的 23 倍,这样的猜测会选择嵌套循环,而应该使用哈希连接。执行 ANALYZE 后,估算是 12,550。把它作为每次加载的最后一步(三种变化会绕过 autovacuum 的 analyze)。
有统计信息的表也不安全:向其中大量加载后,在再次分析之前,统计信息描述的仍然是加载前的表。autovacuum 会在表的 10% 发生变化时分析它(autovacuum_analyze_scale_factor,再加 50 行),因此向大表增加 5% 的数据可能永远不会触发它。而你刚加载的行通常是最新的,也是查询最常请求的行,却位于规划器仍持有的直方图末端之外。每次大批量加载后都要分析,不只是向空表加载时才这样做。
26-loading一个坏值会让整个 COPY 失败
默认情况下,任何位置出现一个格式错误的值,都会让整个 COPY 失败,并且不会加载任何内容。PostgreSQL 17 增加了 ON_ERROR ignore,会跳过值无法转换为列类型的行;PostgreSQL 18 增加了 REJECT_LIMIT,因此“跳过几行”不会悄悄变成“跳过一半文件”。只有数据类型错误会被跳过:重复键或约束失败仍然会让全部操作停止。
对于更脏的数据,可以用 COPY 把数据导入一个由 text 列组成的暂存表,它什么都接受;然后用一条 INSERT ... SELECT 把通过检查的行写入目标表。
给定四行数据,其中两行有坏整数,on_error ignore 会加载另外两行;设置 log_verbosity verbose 后,每跳过一行都会打印一条通知。设置 reject_limit 1 后,第二个坏行会让命令失败(skipped more than REJECT_LIMIT (1) rows due to data type incompatibility),并且不会加载任何内容。
26-loading冻结分区,挂接已构建的分区,再分析父表
COPY 向分区表加载时,会把每行路由到所属分区,并且仍然按分区批处理。这里有三个区别:
FREEZE只对在同一事务中创建或截断的分区有效,对父表永远无效。- 把下一个分区放到一边构建: 加载并索引一张普通表,添加一个与边界匹配的
CHECK,然后attach partition会跳过验证扫描(不停机地改造现有表)。 - 分析父表。 autovacuum 永远不会分析父表,而规划跨分区查询时会使用父表的统计信息。
在 COPY 中指定分区,而不是父表:
直接加载分区仍然会针对边界检查每一行:属于错误月份的行会让命令失败。截断分区会在该分区上取得 ACCESS EXCLUSIVE 锁,因此这适合尚未有人读取的分区,例如下个月的分区。
26-loading批量 upsert:先暂存,再执行一条语句
把数据流同步进已有表时,通常会对每个输入行执行一条 INSERT ... ON CONFLICT:这是本章开头的单行模式,再加一次索引查找。改为先暂存:
对于 19,874 行的数据流,逐条 upsert 即使在一个事务中也耗时 2,811 ms;先暂存则耗时 605 ms,结果相同。
每次批量 upsert 都会遇到一条规则:一条语句不能两次更新同一行。某个键在数据流中出现两次时,会失败并报 ON CONFLICT DO UPDATE command cannot affect row a second time。先对暂存表去重(group by 或 distinct on);因为它是一张表,你可以这样做。
以同一张暂存表为来源执行 MERGE(PostgreSQL 15+)会产生相同的表;ON CONFLICT 会等待,MERGE 却会发生竞态解释了为什么在其他会话也在并发写入时,ON CONFLICT 更安全。autovacuum 永远不会分析临时表,因此在对它执行连接前,先运行 analyze stage。
26-loading一次有计划的加载分七步
向新表或空表执行有计划的加载:
- 提高
max_wal_size,并检查pg_wal有足够的磁盘空间。 - 创建不带二级索引和外键的表,或者在加载事务中
truncate它。 - 在该事务中执行
COPY ... WITH (FREEZE)。 - 执行
set maintenance_work_mem将其调高,然后建立索引。 - 以
NOT VALID添加外键,然后执行VALIDATE验证它们。 - 执行
vacuum (freeze, analyze);只需执行analyze,前提是已经使用FREEZE。 - 把
max_wal_size改回去,并观察副本延迟直到追上。
对于线上表:通过暂存表分批处理,保留索引,并在延迟增加时暂停。
本章要点
- 每批提交,而不是每行提交:自动提交的插入每次都会等待磁盘刷新。
- 使用
COPY(\copy或驱动程序的 copy API):它在速度和 WAL 上都胜过任何INSERT。如果必须使用INSERT,就发送unnest数组。 - 裸加载,然后建立索引并以
NOT VALID添加外键,再执行VALIDATE:速度为原来的六倍,WAL 减半。 COPY ... FREEZE向在同一事务中创建或截断的表加载时,会写入已完成的行,因此第一次读取不会写入。- 先使用不记日志表再
SET LOGGED,只是把 WAL 开销后移,并没有节省 WAL。只有wal_level = minimal会跳过它,代价是失去副本和 PITR。 - 大批量加载前提高
max_wal_size,最后执行vacuum (freeze, analyze),或者至少执行analyze。 - 从去重后的暂存表批量 upsert。
延伸阅读
- Populating a Database,PostgreSQL 文档。官方清单:COPY、删除索引和外键、
maintenance_work_mem、max_wal_size、wal_level = minimal以及之后的 analyze。 - COPY,PostgreSQL 文档。所有选项,包括
FREEZE、ON_ERROR、REJECT_LIMIT和LOG_VERBOSITY,以及服务器端 COPY 的文件访问规则。 - Write Ahead Log settings,PostgreSQL 文档。
wal_level = minimal会移除什么、哪些命令会在其中跳过 WAL,以及wal_skip_threshold。 - INSERT … ON CONFLICT,PostgreSQL 文档。upsert 规则,包括为什么一条语句不能两次处理同一行。
28 连接并非免费
事情通常这样发生:应用在负载下变慢,于是团队把它横向扩展。四个 pod 变成四十个。每个 pod 有一个大小为 20 的连接池,于是数据库现在看到 800 个连接,max_connections 也提高到 1,000 来容纳它们。吞吐量下降,p99 延迟变成原来的三倍。数据库 CPU 占用达到 100%,做的工作却比以前更少。
没有哪条查询是错的。数据库只是在一台 16 核、同一时间能做 16 件事的机器上,同时周旋于 800 个会话,而周旋本身已经成了工作负载。
连接更多不等于容量更大。每个连接都是一个进程,都有内存、CPU 和建立连接的代价;合适的数量取决于数据库的核心数和磁盘,而不是用户数量。
每个连接都是一个进程
客户端连接时,postmaster(服务器的父进程)会为它派生一个新的操作系统进程。这个进程就是一个后端进程,负责解析、规划和执行你的查询,并一直持有会话状态,直到你断开连接。它不会为其他人服务。pg_stat_activity 会列出这些进程:
每个 client backend 都对应一个连接。其余进程负责维护工作(io worker 进程执行异步 I/O,PostgreSQL 18+)。这种模型带来了崩溃隔离,也让操作系统可以分别调度每个连接;代价是每个连接都很重。
MySQL 为每个连接运行一个线程,并配有线程缓存;它的文档描述了 Linux 通常处理 500 到 1,000 个连接的情况。Postgres 则为每个连接派生一个完整进程。在 MySQL 上运行过 2,000 个直连的团队,在这里需要连接池代理,并把 max_connections 设得低得多(Postgres 不是 MySQL)。
在数据库主机上,ps 会把每个后端显示为一个独立的 postgres 进程;进程标题经过改写,会显示它服务的对象和正在做什么,例如 postgres: app book 10.0.0.7(51234) idle。用 kill -9 杀掉它并不等于关闭连接:postmaster 会把后端意外死亡当作崩溃,并连带重启所有其他会话,所以应使用 pg_terminate_backend() 结束会话。实验通过 dblink 打开第二个连接,并找到了它的进程。
27-connections内存:空闲时 1.5 MB,排序中途 109 MB
空闲连接很便宜,正在工作的连接则不然。每个后端都有不属于共享缓冲区的私有内存(后端内存是私有的);在我们的实验服务器上,一个空闲后端在其内存上下文中大约占用 1.5 MB。把work_mem提高到 256 MB 后,同一个后端对 2,000,000 行 events 的两列排序,使用了 109 MB,因为 work_mem 是按每个后端的每个排序或哈希节点分配的(work_mem 是按节点计算的,而且可以看到)。同样的排序在默认 4 MB 下则会溢写到磁盘。
内存占用也会随着模式规模增大而增长。一个访问过 1,000 张小表的后端,内存从 1.5 MB 增长到约 14 MB,因为目录缓存只会增长。当表和分区达到数千个时,每个后端都可能稳定在几十 MB。
乘以 800。
CPU:超过核心数后,连接会排队
一个需要 2 ms CPU 时间的查询,在 800 个并发执行时仍然需要 2 ms。16 个核心可以推进 16 个查询,其余查询排队等待;与此同时,操作系统还要花 CPU 周期在它们之间切换。共享结构(锁管理器、缓冲区映射、WAL 插入)会随着活动后端增加而承受更多争用,因此连接数超过某个点后,争用增长得比吞吐量还快。
建立连接:重连的代价是 70 倍
建立一个连接意味着 TCP 握手、通常还包括 TLS、身份验证(SCRAM 自己就会增加两次往返)、派生进程、初始化后端,然后面对冷缓存。对 users 执行同一个主键查找,用 pgbench让 4 个客户端运行 5 秒,先使用持久连接,再按事务重连(-C):
在没有 TLS 的本地 Unix 套接字上,代价相差 70 倍。在真实网络上,建立连接很容易就要 10 到 50 ms,远远超过一个 1 ms 查询的时间。它还会带来页读取开销:在运行手册实验中,新连接上的一次插入读取了约 239 页,其中大多是为外键检查建立环境所需的系统目录页;使用连接池时只读取了 36 页。
少建立连接,保持它们打开,并在请求之间共享。
把 max_connections 提高到几千会造成伤害
max_connections(默认 100,修改需要重启)不是容量旋钮。它只是上限;合适的值应该阻止服务器接受超过自身处理能力的并发工作。把它提高到几千会在三个方面造成伤害:
- 内存。 一台能稳定运行 200 个连接的服务器,在糟糕的一天会因 2,000 个连接开始交换,或触发 OOM killer;那正是每个连接都在执行重查询的一天。
- 由它决定大小的共享内存。 例如,锁表的大小是
max_locks_per_transaction乘以连接槽位数,即使连接空闲也要付出这份代价。 - 它掩盖了真正的问题。 达到上限意味着应用没有使用连接池,在非数据库工作期间占着连接,或者泄漏了连接。提高上限只会消除症状,让病根继续存在。
对大多数服务器来说,把 max_connections 设为几百是合理的;如果应用需要更多连接,就在前面加连接池代理。
超过上限后,客户端会收到 FATAL: sorry, too many clients already。给自己留一扇门:superuser_reserved_connections(默认 3);从 PostgreSQL 16 开始,还有 reserved_connections,供具有 pg_use_reserved_connections 成员资格的角色使用,监控和管理角色正适合放在这里。
pg_settings 保存每项设置的编译时默认值(boot_val),以及修改它需要什么条件(context;其中 postmaster 表示需要重启)。保留槽位是从 max_connections 中扣除的,而不是额外增加:默认值为 100、超级用户槽位为 3 时,普通角色只能得到 97 个槽位。为了在应用用完其余槽位时仍让监控保持连接:
27-connections在应用中并在数据库前面使用连接池
始终使用驱动程序或框架提供的连接池;每个请求建立一个连接,就会每次都重现 pgbench -C 的缓慢表现。但应用连接池会相乘:连接总数等于进程数乘以池大小,而自动扩缩容会在没有询问数据库的情况下改变进程数:
连接池代理,例如PgBouncer,位于两者之间。客户端可以随意向它打开许多连接(代价很低:PgBouncer 是一个事件驱动进程,不会为每个客户端创建一个后端),而它只借出一组小而固定的服务器连接:
两者都使用。应用连接池避免了向连接池代理建立连接的代价;连接池代理则无论 pod 有多少,都限制真正到达数据库的连接数。如果你的托管服务提供承担 PgBouncer 作用的内置连接池代理,就打开它(托管连接池代理要么固定会话,要么泄漏状态)。
事务池模式会破坏会话状态
连接池代理必须决定什么时候可以把一个服务器连接交给另一个客户端,而这个决定也决定了应用可以做什么。
| 模式 | 归还服务器连接的时机 | 多路复用程度 | 会话功能 |
|---|---|---|---|
| 会话 | 客户端断开连接时 | 低 | 全部可用 |
| 事务 | 每个事务结束时 | 高 | 许多功能会失效 |
| 语句 | 每条语句之后 | 最高 | 多语句事务会失效 |
会话池模式是安全的,但几乎不能减少连接数。事务池模式才是最大的收益:客户端只在事务内占用服务器连接,因此 800 个大多空闲的客户端可以共享几十个连接。语句池模式禁止多语句事务,只适合范围很窄的工作负载。
事务池模式的代价是:同一个客户端连续发起的事务可能运行在不同的后端上。任何驻留在会话中的东西都会泄漏,或直接消失:
SET。 普通SET statement_timeout会改变当前后端,接下来的客户端会继承这个设置;而你的下一个事务可能落到一个没有该设置的后端上。在事务内部使用SET LOCAL,或者用alter role ... set ...设置角色默认值。行级安全使用的租户变量也要同样小心:set_config('app.tenant_id', $1, true)中的true表示事务本地。- 会话咨询锁。
pg_advisory_lock属于后端。使用pg_advisory_xact_lock,它会在事务结束时释放。 - 驱动程序预备语句。 大多数驱动程序会在协议层、某个后端上准备参数化查询;下一个事务可能落到从未见过这些语句的后端。PgBouncer 1.21 及更高版本会替你重新准备;如果使用较旧的连接池代理,或使用没有这项能力的托管连接池代理,就在驱动程序中关闭预备语句。
LISTEN。 通知会发给执行监听的那个后端。把监听器放在专用的直连上。- 存续时间超出事务的临时表、
WITH HOLD游标、SQL 层面的PREPARE,以及其他任何假定跨事务仍使用“我的连接”的功能。
事务池模式下,会话级 SET 不会失败。它会成功,然后悄悄应用到另一个客户端的事务中。用普通 SET 设置的租户 ID 可能被下一个请求从同一个后端读到。切换连接池代理到事务模式前,审计每个 SET、set_config(..., false)、咨询锁和 LISTEN。
客户端 A 执行普通 SET statement_timeout = '7s' 后结束。客户端 B 的下一个事务落到同一个后端,并继承了它从未请求过的 7 秒超时。事务范围版本的行为符合预期:SET LOCAL 和 set_config(..., true) 会在提交时消失。咨询锁也有同样的区别。用 pg_advisory_lock 获取的会话锁,在获取它的事务结束后仍会留在 pg_locks 中,由下一个拿到这个后端的客户端持有;pg_advisory_xact_lock 则会随事务释放。实验通过 dblink,让两个客户端在一个共享的服务器连接上运行。
27-connections截至 2026 年 10 月:
- 协议层预备语句。 PgBouncer 1.21(2023 年 10 月)增加了跟踪机制,会在客户端落到的任意服务器连接上重新准备语句;只要
max_prepared_statements非零就会启用。自 1.24(2025 年 1 月)起默认值为 200,因此默认开启。1.21 之前的通常建议是在驱动程序中关闭预备语句。 - 已报告的参数。 PgBouncer 1.26(2026 年 9 月)默认跟踪 Postgres 报告给客户端的每个参数,尤其是 PostgreSQL 18+ 中的
search_path和 14+ 中的default_transaction_read_only。在较旧的 PgBouncer 上,或在 PostgreSQL 18 之前(当时它不会报告search_path),客户端的SET search_path会泄漏给下一个使用该服务器连接的用户。Postgres 不报告的参数,例如statement_timeout和app.tenant_id之类的自定义设置,仍然会泄漏;继续使用SET LOCAL。
根据核心数而不是用户数确定连接池大小
连接池要达到最大吞吐量,所需大小比你想象的要小得多。运行中的后端要么占用一个核心,要么在等待磁盘或锁。工作集位于内存中时,超过每核心一个的后端只是在排队等待 CPU。如果查询在等待磁盘,每个核心多放几个连接可以让核心保持忙碌。一个广泛使用的起点来自经验而非理论:
对于使用网络存储的 16 核服务器,大约是 32 到 40 个活动连接。从这里开始测量:在贴近实际的负载下增大连接池,当吞吐量趋于平坦而延迟开始上升时停止。
从另一个方向用 Little 定律检查:忙碌连接数等于吞吐量乘以每个事务持有连接的时间。一个每秒处理 2,000 个请求的应用,每个请求持有连接 5 ms,平均会保持 2,000 x 0.005 s = 10 个忙碌连接。这样的负载只需要十几个到二十几个连接来应对突发,而不是几百个。(上面的 pgbench 运行按构造就符合这个定律:每秒 38,500 次查找、每次约 0.1 ms,正好对应它的 4 个客户端。)
Little 定律还说明了什么真正会使连接数膨胀:占着连接却不使用它。一个请求处理程序打开事务,调用支付 API 800 ms,然后提交;它占用连接的时间是 2 ms 数据库工作所需时间的 400 倍。慢速外部调用要放在事务之前或之后,绝不能放在事务内部。
连接池耗尽时,请求会等待。这是正确的:连接池前的短队列,胜过 Postgres 内部的同一条队列。给这个等待设置几秒钟的超时。
先决定数据库应该拥有多少个服务器连接(比如 40 个),再把它分配给所有会建立连接的对象:应用 pod、工作进程、cron 作业、迁移运行器和监控。给 40 个 pod 各配置一个大小为 20 的连接池,你就会在无意间选择 800 个连接。
每个超时默认都是关闭的
一个查询会永远运行,一个事务被遗忘,一个空闲连接占着槽位,一个客户端消失。Postgres 为这些情况各有一个超时。它们默认都为 0(禁用),也都可以按角色设置:
statement_timeout会取消运行过久的语句(SQLSTATE57014),但连接仍然存活。超过请求截止时间的语句是在浪费工作,并且还占着锁。lock_timeout限制等待锁的时间;迁移把它列为第一原则。把它设得比statement_timeout略短,可以把锁堆积变成快速报错。transaction_timeout(PostgreSQL 17+)会结束一个打开时间过长的事务所在的会话,无论事务正在忙还是处于空闲;它能抓住许多小语句被塞进一个超大事务的情况,而其他超时抓不住。idle_session_timeout(PostgreSQL 14+)会结束在事务外空闲的会话。连接池中的连接本来就会空闲,因此只对人工用户和临时工具的角色使用它,或者把它设得比连接池的空闲超时更长。
应用角色的基线设置:
lock_timeout 的值低于 statement_timeout,而空闲超时又远低于 transaction_timeout,因此最具体的超时会先触发,错误信息也会说明出了什么问题。迁移、回填和批处理作业应使用单独的角色,并设置更长的限制(或者在每个事务中用 set local 设置),这样应用基线就不会杀掉有意运行很久的作业。
idle_in_transaction_session_timeout 最重要
在所有超时中,这一个能避免最大的损害。它会结束停留在打开事务中的空闲会话。一个被遗留的事务(异常路径跳过了回滚、调试器暂停、脚本等待输入)会无限期持有锁,并阻止清理回收其快照之后产生的任何内容。被遗忘的 begin 就是这样变成表膨胀和迁移阻塞的。为每个应用角色设置它;30 秒是很好的默认值,最多几分钟。
它、transaction_timeout 和 idle_session_timeout 都属于 FATAL:会关闭整个连接,许多驱动程序只会报告连接已中断。把这当成正常事件;好的连接池会丢弃该连接并重新打开一个。
三个会话,每个对应一种超时:
最后一种情况下,没有哪条语句运行缓慢,会话也从未空闲;只是总时长太长。idle_session_timeout 结束时会产生 FATAL: 57P05: terminating connection due to idle-session timeout。SQLSTATE(用 psql 的 \set VERBOSITY verbose 显示)就是服务器发送的内容;但服务器杀掉空闲会话后,要等客户端下次与它通信才能交付这个错误,所以许多驱动程序只会看到 SQLSTATE 08006,即连接已中断。
27-connections一个失联客户端可以占住连接槽位数小时
如果客户端崩溃或网络断开,后端会等待下一条永远不会到来的查询,同时占着连接槽位,甚至可能占着一个事务。TCP 保活会探测沉默的对端。默认值为 0,意思是“使用操作系统设置”;在 Linux 上,通常要等两个小时才发出第一次探测。把它们设置成几分钟。
反过来,如果后端正在为一个已经离开的客户端运行长查询,则由 client_connection_check_interval 处理(PostgreSQL 14+,Linux 和少数其他平台支持);它会让运行中的查询定期检查客户端是否还在,若客户端已离开就取消查询。也要设置驱动程序的保活,这样应用会发现数据库连接已死亡,而不是一直挂住。
连接风暴会自我加剧
无服务器架构和激进的自动扩缩容会把数量相乘变成突发:几百个实例在几秒内启动,各自打开连接,失败后又同时重试。部署和故障切换也会这样;数据库变慢时同样如此:请求耗时变长,连接池扩大,更多连接到达,数据库变得更慢。
防御措施大致按价值排序:
- 在前面放一个连接池代理。 对无服务器架构来说这是必需的;使用平台提供的连接池代理,或自己运行一个,并留意事务模式的语义。
- 严格限制连接池,并把最小大小设小。 一个启动时急着打开 20 个连接的池,会把 100 个同时启动的实例变成 2,000 次连接尝试。
- 使用带指数退避和抖动的重试。 客户端同步重试,会把短暂过载变成长时间过载。
- 连接池耗尽时快速失败。 较短的获取超时会主动丢弃负载,而不是放大负载。
- 逐步滚动部署,让连接池分波次重连。
从服务器一侧统计连接
遇到连接问题时,首先运行这条查询:
在每个连接字符串中设置 application_name,这样它就能标出连接的所有者。
然后读取各个状态。大量 idle 意味着连接池过大。任何 idle in transaction 都值得检查(backend_xmin 会指出阻碍清理的事务会显示持续了多久)。如果 active 经常超过核心数的两倍,前面带队列的小连接池很可能会同时改善吞吐量和延迟。
连接池配置是一份计划;pg_stat_activity 才是已经发生的事实。
本章要点
- 每个连接都是拥有自己内存的操作系统进程:空闲时几 MB,设置较大的
work_mem后在排序中途可能达到一百 MB 甚至更多。连接是稀缺资源,并非免费。 - 把
max_connections保持在一两百左右。达到上限说明应用需要连接池,而不是更大的上限。为管理和监控预留槽位。 - 根据核心数和磁盘确定服务器连接总数(从核心数 x 2 加磁盘数附近开始,再进行测量),并把总数分给所有会建立连接的对象。
- 始终使用应用侧连接池;当许多进程或无服务器函数连接时,再加一个外部连接池代理。
- 事务池模式会破坏会话状态:使用
SET LOCAL或set_config(..., true)、事务范围的咨询锁,并为LISTEN使用直连。 - 绝不要让事务跨越缓慢的非数据库工作。
- 为每个应用角色设置
statement_timeout、lock_timeout和idle_in_transaction_session_timeout,并在 PostgreSQL 17+ 上设置transaction_timeout(起步值分别为 5s、3s、30s 和 5min)。迁移和批处理作业使用单独的角色。 - 通过连接池代理、较小的最小连接池、较短的获取超时,以及带退避和抖动的重试来应对连接风暴。
延伸阅读
- How Connections Are Established,PostgreSQL 文档。关于每个连接一个进程模型的权威说明。
- Connections and Authentication 和 Client Connection Defaults,PostgreSQL 文档。
max_connections、保活和本章中的所有超时。 - Analyzing the Limits of Connection Scalability in Postgres,Andres Freund,Microsoft,2020 年。空闲连接为何有代价,以及 PostgreSQL 14 修复了什么。
- PgBouncer features 和 configuration,PgBouncer 项目。池化模式兼容性表以及
max_prepared_statements。 - PgBouncer changelog,PgBouncer 项目。检查你的版本修复了什么;1.21、1.24 和 1.26 分别改变了事务池模式。
- About Pool Sizing,Brett Wooldridge,HikariCP wiki。支持小连接池的经典论证。
- Number Of Database Connections,PostgreSQL Wiki。核心数乘二这一出发点的来源。
29 如实测量
下面是同一台服务器执行同一条查询的两次测量。第二次的吞吐量是第一次的 80%,负载更轻。第一次的第 99 百分位点的延迟是 0.12 ms,第二次是 2,038 ms。两次之间 Postgres 没有任何变化。一次基准测试问服务器做完工作用了多久,另一次问用户等了多久。
大多数基准测试都会撒谎,而且几乎从来不是故意的。它们在热缓存上运行十秒,使用能放进内存的均匀随机数据;服务器一停顿,客户端就礼貌地停止发送请求。然后,这个数字被写进设计文档。
基准测试是一项实验:一个问题、一个对照、足够多的运行次数以看见噪声,以及与要预测的对象具有相似特征的数据。
只问一个问题
运行之前,先把问题写下来。问题大致有几类,每一类都需要自己的设置:
| 问题 | 固定不变的内容 | 报告什么 |
|---|---|---|
| 能做到多少? | 负载组合 | 峰值吞吐量,以及该峰值下的延迟 |
| 在我们的负载下有多快? | 到达速率(-R) | 该速率下的延迟百分位点 |
| 变更 B 比 A 好吗? | 除 B 以外的一切 | 差异,并列出不同运行之间的噪声 |
| 这个计划能撑过生产吗? | 数据特征和统计信息 | 计划及其缓冲区 |
“Postgres 有多快”不是一个问题。“这台机器能否以每秒 2,000 个请求为我们的结账端点服务,同时使 p99 低于 20 ms”才是。
这也是每次申请更大服务器背后的问题。一个在完成低成本修复后仍然如实回答这个问题的基准测试,才能让这项申请得到肯定(用数据争取更大的机器)。
基准测试撒谎的方式(太短、太热或太冷、太均匀、闭环、只运行一次、同时改两件事),也是阅读别人发布的基准测试的方法:供应商的图表,是你没有运行过、也没有选择过负载的基准测试(读基准测试数字前,先问是谁跑的)。
pgbench 已经安装好了
pgbench 随 PostgreSQL 一起提供;只要有 psql,就有它。它可以用你指定数量的客户端,把脚本运行在任意数据库上,并报告吞吐量和延迟。前面的章节用它测量过提交代价和连接建立。我们的数字来自一台共享笔记本;实验要证明的是它们之间的关系。
它还附带一个类似 TPC-B 的模式和脚本(pgbench -i)。不要引用它的数字。在我们的机器上,只读模式每秒运行约 99,000 个事务,而默认脚本每秒只有 8 个,因为每个默认事务都在等待一块忙于服务其他数据库的磁盘执行fsync。后一个数字主要反映邻居的速度。
pgbench -i -s 5 会创建 pgbench_branches(5 行)、pgbench_tellers(50 行)、pgbench_accounts(500,000 行)以及空的 pgbench_history,每个规模单位约占 15 MB。用 -b 选择的内置脚本包括 tpcb-like(默认)、simple-update 和 select-only(-S)。在信任它之前先读一遍(pgbench --show-script=tpcb-like):每个类似 TPC-B 的事务都会更新一条账户记录、一条柜员记录和 -s 条分行记录中的一条,最后提交。客户端多于分行记录时,它们会在这些行上排队,而你测量的其实是行锁争用;规模至少要达到客户端数量。每次运行前,pgbench 会清理 pgbench_tellers 和 pgbench_branches,并截断 pgbench_history。-n(--no-vacuum)会跳过这一步;对自己的表使用自定义脚本时可以使用它,因为那些 pgbench 表并不存在。
28-benchmarking.sh为自己的查询做基准测试,使用倾斜分布的键
内置脚本只是冒烟测试。真正重要的基准测试运行的是你的查询。pgbench 脚本是一个由 SQL 和客户端执行的反斜杠命令组成的文件;每次执行完整文件,都算作一个“事务”:
\set 会把表达式计算成一个变量;:u 会替换成它。使用倾斜分布的键:random() 是均匀分布,而生产流量几乎从来不是。脚本中的 random_exponential(1, 20000, 5) 只是轻微倾斜:约 5% 的抽样会落在项目 ID 的前 1% 中。random_zipfian(1, 20000, 1.1) 会把 68% 的抽样送到那里,更接近有少数超大租户的多租户 SaaS。选择符合你流量的那个。
把 -j(线程数)设为等于 -c(客户端数):一个线程无法驱动许多快速客户端;在我们的机器上,8 个只读客户端使用 -j 8 时,速度约为使用 -j 1 的 6 倍。如果 pgbench 一侧的 CPU 已经打满,你测量的就是 pgbench。
pgbench 有三个:
random_zipfian(lb, ub, s):抽到 k 的次数是抽到 k+1 的((k+1)/k)^s倍,其中s取值范围为 1.001 到 1000。random_exponential(lb, ub, p):大致来说,范围最低的 1% 会在p% 的抽样中被选中。random_gaussian(lb, ub, p):约 67% 的抽样会落在范围中间的1/p区间内。
针对 20,000 个项目 ID,用每种分布各抽样 40,000 次,并由 pgbench 脚本(insert into picks values (:z, :e, :g))记录到一张表中:
分布总是向范围的低端倾斜(高斯分布则朝中间);如果模式中的低 ID 有特殊含义,就用 permute(value, size) 打乱。把 -c 的大小当作连接池大小;而真正做负载测试时,应在靠近服务器的另一台机器上运行 pgbench。
28-benchmarking.sh预备语句更快,而且快得超过噪声范围
-M 决定 pgbench 如何与服务器通信。simple 和 extended(大多数驱动程序使用的模式)每次都会让服务器解析和规划;prepared 每个连接只解析一次,还可能切换到缓存的通用计划。对于只需几微秒的查询,这占了很大的比例。对一行进行查找,运行三轮、每轮 8 秒,同时运行这些模式进行比较,让机器噪声同样作用于三者:
预备模式快约三分之一。再看看离散程度:三次相同运行之间的差异约为 20%,所以任何更小的差异都不能算结果。但这一次可以:最慢的一次预备运行也超过了最快的一次简单运行。
这里得到两条规则。使用应用实际使用的协议做基准测试(事务池模式可能使预备语句失效)。比较结果要报告范围,每侧运行三次并交错进行;只有范围不重叠时,差异才算数。
在我们繁忙的笔记本上依次运行时,各模式的范围经常重叠,有一次简单模式的平均值甚至更好。因此实验先执行清理和检查点,然后在有空闲核心的机器上同时运行三种模式,每种一个客户端。扩展模式并不比简单模式快:它只是在更多协议消息中做同样的解析和规划。
28-benchmarking.sh闭环会隐藏停顿
回到开头的例子。两次运行都使用 4 个只读客户端,持续 15 秒。运行到第 5 秒时,另一个会话取得了持续两秒的 ACCESS EXCLUSIVE 锁,目标是 pgbench_accounts,用来代表任意停顿:排在迁移后面的锁、故障切换、检查点 fsync,或应用中的垃圾收集暂停。
第一次运行是 闭环,也是 pgbench 的默认方式:每个客户端发送查询,等待答案,然后再发送下一条。第二次把 -R 设置为第一次达到速率的 80%,这样 pgbench 会按时间线调度事务,并从每个事务预定的开始时刻起测量其延迟:
所有延迟都以毫秒计。负载更轻,停顿相同,但 p99 相差超过一万倍。
闭环的问题在于它没有记录某些东西。停顿期间,4 个客户端各有一条查询卡住:一百万个样本中只有 4 个慢样本,不会改变这里的百分位点。
但真实用户不会因为服务器忙就停止到达。在这两秒内,本来会有约 100,000 个请求到达,而且每一个都会等待。基准测试却和服务器协调,跳过了对它们的测量。这就是 协调遗漏(coordinated omission),这个术语由 Gil Tene 推广;这种遗漏是大多数负载生成器和许多监控代码本身就有的问题。
使用 -R 后,这些请求会留在时间表上。它们会晚启动,而迟到的时间(调度延迟)会计入延迟。影响会持续到停顿之后:处理积压时,超过 5% 的请求等待了 1.8 秒以上,中位数从 0.05 ms 上升到 3 ms。现在看第三行:减去调度延迟,就又得到闭环的数字。服务器做得很快,但用户仍然等了。
28-benchmarking.sh所以,要回答“在我们的负载下有多快”,请以现实的速率使用 -R,并且远低于峰值;然后从带有调度延迟的 --log 中报告百分位点(每个事务一行)。如果调度延迟持续增长,服务器就无法维持该速率,而这就是答案。在相信任何人的 p99 之前,也包括你自己的监控,先问它是不是从预定开始时刻计时的。
在完整的闭环速率下,停顿之后没有余量可以追赶,pgbench 可能永远落后于时间表,因此实验检查 -R 运行是否达到了它的速率(请求到达服从平均速率为该值的泊松过程)。--latency-limit 与 -R 一起使用时,会把本来会太晚开始的事务计作跳过,这样“p99 低于 20 ms”就变成了可以测试的数字。
--log 为每个事务写一行,每个线程一个文件:
time 是以微秒计的延迟(在 -R 下从计划开始时间计,因此包含 schedule_lag)。对它排序,再从中取出所需位置:
对于长时间运行,--sampling-rate=0.1 会保留十分之一的行;--aggregate-interval=1 每秒写一行汇总,这正适合回答“当时发生了什么”。
28-benchmarking.sh先预热,再完整经过一个检查点
一次基准测试的前几秒和第十分钟,测量的是不同的服务器。
冷缓存和热缓存是不同的服务器
第一次执行均匀的 events 查找时,速度是每秒 2,700 次;几分钟后,同一条命令达到每秒 52,900 次:变化的只有缓存。要测量稳定状态,就预热到 -P(pgbench 的周期性进度报告)显示吞吐量趋于平坦,然后再测量。对于故障切换和部署问题,用户看到的是冷启动数字,所以要有意识地测量它,并同时清除操作系统缓存。
像重启一样把 users 及其索引从共享缓冲区驱逐出去,然后连续两次运行同一条查找:冷运行读取了 1,401 页(96,014 tps),热运行没有读取页(111,236 tps)。差距之所以不大,只是因为这些页仍在操作系统缓存中。pg_buffercache_evict_relation()(PostgreSQL 18+)会把一个关系从共享缓冲区中清空;在 Linux 主机上,以 root 执行 echo 3 > /proc/sys/vm/drop_caches 还会清除操作系统缓存。blocks read 来自 pg_stat_statements,而命中与读取在这里和计划中的含义相同。
28-benchmarking.sh60 秒基准测试可能错过每一个检查点
一个检查点每隔 checkpoint_timeout 运行一次(默认 5 分钟);它开始后,每一页的第一次变更都会把一张整页镜像写进 WAL。60 秒的基准测试可能错过所有检查点,于是它的数字会超过生产环境能看到的一切。下面是一个类似 TPC-B 的运行,按秒列出;各列分别是距检查点开始的秒数、每秒事务数、平均延迟、整页镜像数和每事务 WAL 字节数:
有一秒钟,同样的事务写出的 WAL 是平时的 12 倍。在这里磁盘吸收了它;早先的一次运行中,磁盘繁忙,吞吐量连续两秒减半。不包含检查点的基准测试无法告诉你面对的是哪一种服务器。
我们的规则是:用于预测生产环境的运行,至少持续两个 checkpoint_timeout 周期,使用生产环境的设置,并且长到足以让 autovacuum 访问大表。之后检查检查点进程计数器和 last_autovacuum,确认两者都发生在测量窗口内。
实验服务器设置 checkpoint_timeout = 30s(最小值),让检查点落在一分钟的测试运行内,同时设置 synchronous_commit = off,排除提交 fsync 的影响;采样器每秒读取一次 pg_stat_wal 和 pg_stat_checkpointer(scale 5,4 个客户端)。在它之前,每个事务写入 383 到 420 字节;之后的五秒约为其四倍,随着更多页第一次被触碰,数值经过 897 和 561 字节后逐渐稳定。在接近性能极限的存储设备上,长时间运行的 tps 会随检查点周期呈锯齿状变化。
同一分钟内,autovacuum 处理了 pgbench_tellers 和 pgbench_branches(小而繁忙的表很快就会越过其阈值),但从未处理 500,000 行的 pgbench_accounts:它约有 25,000 个死行版本,而需要约 100,000 个。在生产环境中,这次大清理会在你的流量中间运行。
28-benchmarking.sh只改一件事,并端到端测量
相同的数据、相同的脚本、相同的时长,中间只改变一件事;如果差异不大,每侧运行三次。运行手册中的实验就是把这个方法连续应用八次。
然后从两端测量。-r 报告客户端看到的脚本每一行的平均延迟。下面是给 events (project_id) 建索引前后的仪表盘脚本:
吞吐量从每秒 39 个事务提高到 6,083 个。但没有改变的主键查找的速度也变成原来的三倍,因为客户端延迟包含了在一台被顺序扫描压满的机器上等待 CPU 的时间。客户端的数字告诉你用户感受到了什么,而不是为什么。
pg_stat_statements 会告诉你原因(在每次运行前后做快照并比较):
报告查询从每次读取整张表,变成每次约一百页。查找前后都恰好访问 3 个块。每次调用的块数说明是哪条语句在工作,时间说明谁在承受代价,而只有块数在不同运行之间保持稳定。计时有噪声时,就比较缓冲区。数页。
两次运行把索引建立夹在中间,因此索引建立本身的 I/O 不在任何一个窗口内。客户端数字是 -r 的逐行平均值。服务器端数字来自每次运行前后对 pg_stat_statements 做快照并相减:时间使用 total_exec_time / calls,块数使用 (shared_blks_hit + shared_blks_read) / calls。客户端数字会随机器正在做的其他事情波动:早先在同一台笔记本上的一次运行中,查找的 -r 延迟从 27 ms 变成了 0.2 ms,但每次调用的块数都是 3。
28-benchmarking.sh均匀数据会撒谎
这本书的种子数据有意采用均匀分布,因此每章的数字都能复现:最繁忙的 1% 项目持有不到 2% 的事件。生产系统没有一个是这样的。
倾斜会改变缓存。 在一张 275 MB、共享缓冲区为 128 MB 的表上按 ID 查找事件:均匀 ID 的速度是每秒 40,168 次,命中率为 81.4%;Zipf ID 的速度是每秒 97,107 次,命中率为 98.4%。在这里使用均匀基准测试,会让你去购买并不需要的 RAM。(对于写入,倾斜的影响相反:热门行会制造锁队列。)
倾斜会改变计划。 取 500,000 个事件做两份,一份使用种子数据,另一份重新生成项目 ID,使项目 1 占约 7% 的行。索引相同,查询也相同(项目 1 最新的 20 个事件):
有 25 行时,规划器会把它们全部取出并排序。有 34,000 行时,它会从最新端反向扫描 created_at 索引,找到第 20 个匹配项就停止,因为pg_stats已经告诉了它数据分布。用均匀数据测试,结果大租户拿到的是没人检查过的计划。
一个月的更新可能让表接近翻倍。 每次更新都会留下一个死行版本,而清理很少把空间还回去。连续 30 个“天”每天更新 projects 的三分之一、每周清理一次,最终让同样的 20,000 行从 224 页增长到 399 页。基准测试要使用六周后你会拥有的表,而不是今天早上刚加载的表。
贴近实际的测试数据库应当具有生产环境的行数、倾斜、值大小(4 KB 的 JSON 数据远远超过约 2 KB 的行大小,此时TOAST会接管),以及空闲空间。获得这四样东西最便宜的办法,是从生产环境开始。
重新按对数均匀分布生成项目 ID 只需一行:
exp(random() * ln(n)) 在对数空间内是均匀分布:项目 1 会得到约 7% 的行,前 1% 的项目合计超过一半。power(random(), 3) 会把值堆向 0,而 random_normal()(PostgreSQL 16+)会给出钟形曲线。两份副本都在 project_id 和 created_at 上建立了索引并执行了 analyze;均匀数据的计划是该位图扫描上方的 Sort,并且位于 Limit 下。
老化过程每个“天”执行一条语句(psql 的 \gexec 会让每条语句各自运行,因为 VACUUM 不能在函数或 DO 块中运行):
pgstattuple('projects_aged') 随后报告 49% 的空闲空间。
28-benchmarking.sh复制生产数据,隐去个人信息
不要把真实个人数据放在笔记本电脑、CI 运行器,或访问控制比生产环境更弱的预发布服务器上。复制数据特征,并对人员信息做掩码。可靠的做法是:在生产环境旁边的克隆中完成掩码,然后导出这个克隆。
使用带密钥的哈希(hmac,来自 pgcrypto)。它是确定性的,因此电子邮件仍然彼此不同,唯一约束仍然成立,连接也仍然匹配;不带密钥的电子邮件哈希可以通过对一组可能的地址逐一哈希来反推出原文。不要抹掉数据特征:把所有 created_at 替换成 now(),会毁掉你想保留的倾斜分布。
克隆本身并不干净:旧值以死行版本的形式留在页上,也留在 WAL 中。这就是它应留在生产一侧并随后被删除的原因。它的 pg_dump 是干净的,因为导出只读取仍然存活的行。通过恢复备份来创建克隆:只要还有人连接,以正在使用的数据库为模板创建副本就会失败。
28-benchmarking.sh如果列不止几列,可以使用 PostgreSQL Anonymizer,这是 Dalibo 维护的扩展;它可以在列上声明掩码规则,并生成匿名化导出或做过掩码的克隆。另外,pg_dump --exclude-table-data=sessions 会保留表定义而不保留其中的行(pg_dump)。
测试计划,而不只是测试速度
有时你只需要计划。PostgreSQL 18 的 pg_dump --statistics-only 会导出规划器统计信息,因此很容易产生这样的想法:把模式和统计信息加载进一个空数据库,然后在那里生成计划。但这行不通。我们让两边都估计告警数量:
统计信息完整到达了。但规划器估算表大小时,会检查表在磁盘上的实际大小,并只把 reltuples / relpages 当成密度,再按实际大小缩放。零页、零行,向上调整为一行。
优先顺序应当是:完整大小的掩码副本;行数和倾斜分布符合生产环境的合成数据;生产副本上的 EXPLAIN(普通 EXPLAIN 不会执行查询)。无论使用哪种方式,都要比较计划,而不只是比较计时(慢查询的方法)。如果计划不同,计时比较就没有意义。
导出内容是对 pg_restore_relation_stats() 和 pg_restore_attribute_stats() 的调用:包括 relpages、reltuples 和每一列的 pg_stats 行,也包括 most_common_vals。列统计信息仍然会影响选择率,但行数估计不会照搬过来。只导出统计信息在有数据时才真正有用:用 --statistics 恢复完整导出,意味着恢复的数据库在第一次 analyze 完成前就能生成良好计划。
28-benchmarking.sh本章要点
- 先把问题写下来:峰值吞吐量、给定速率下的延迟,还是 A 与 B 的比较。
- 使用自定义 pgbench 脚本(
-n -f)、倾斜分布的键以及驱动程序使用的协议,测试自己的查询。 - 测量延迟时,以现实速率使用
-R,并从--log中取得 p50、p95 和 p99。闭环百分位点会隐藏所有停顿。 - 每个变体交错运行三次,只有范围不重叠时才相信差异。一次只改一件事。
- 为了稳定状态先预热;有意识地测量冷启动;运行足够长的时间,包含一个检查点和一次 autovacuum。
- 计时有噪声时,比较
pg_stat_statements的每次调用块数。 - 在特征符合生产环境的数据上测试:真实行数、倾斜、值大小和空闲空间。在生产一侧为克隆做掩码并导出克隆;没有数据的统计信息无法复现生产计划。
延伸阅读
- pgbench,PostgreSQL 文档。所有选项、脚本语言及其函数、日志格式,以及 “Good Practices” 小节。
- pg_stat_statements,PostgreSQL 文档。前后对照的测量工具,包括定向重置。
- pg_dump,PostgreSQL 文档。
--statistics-only、--exclude-table-data以及创建测试副本所需的其他选项。 - wrk2,Gil Tene。其 README 对协调遗漏以及恒定速率负载生成器为何能修复它,给出了最清楚的简短解释。
- How NOT to Measure Latency,Gil Tene,QCon San Francisco 2015 年。延迟常见的错误测量和报告方式,以及正确做法。
30 真正重要的配置
在一台 64 GB 内存的机器上,采用默认配置的 PostgreSQL 18 服务器,会拿出 128 MB 作为自己的缓存。它假定随机读取的代价是顺序读取的四倍,仿佛背后是旋转磁盘。它每产生大约半个 GB 的 WAL 就启动一次 检查点,默认不记录慢查询、锁等待或临时文件。
这些默认值全都很安全,目的是让 Postgres 能在任何人可能运行它的最小机器上启动。作为默认值,这样做是对的;对于你的生产服务器,却不对。
大约 400 项配置中,真正重要的只有二十来项。下面说明它们是什么、每项怎么选,以及要检查 Postgres 底层环境的哪些方面。在有人要求更大的服务器之前就设好它们:默认配置会浪费你给它的任何机器(先用数据证明,该换更大的机器了)。
每个配置项编译时内置的默认值都在 pg_settings.boot_val 中,旁边还有当前值以及这个值的来源。要查看服务器偏离原始默认值的所有设置,这也是接手一台服务器后首先要读的内容:
postgresql.conf 中有少数几行是由 initdb 写入的(TimeZone、log_timezone、lc_* 配置,以及小型机器上有时会写入的 max_connections 或 shared_buffers),所以 source 会显示为 configuration file,尽管并没有人主动选择它们。
29-configuration知道配置在哪里设置,以及什么会使它生效
修改值之前,先知道它能在哪里设置,以及要经过什么才能应用。大多数“配置没有生效”的谜团都源于这两点之一。
最具体的设置胜出
每一行都会覆盖上面的设置。按角色设置常被低估:每种负载都可以有自己的上限。应用角色的超时配置在 每个超时默认都是关闭的;报表角色则相反:给更多内存,也更有耐心:
它们在会话启动时应用,所以连接池中的连接在重新连接前会保留旧值。某个配置看起来没有生效时,pg_settings.source 会告诉你这个值来自哪里。
给数据库设置 work_mem:新会话会以 source = database 报告这个值,而已经连接的会话会保留旧值。再添加角色设置后,角色设置会胜出,source = user。数据库设置和角色设置都存放在 pg_db_role_setting 中。
29-configuration上下文决定重载还是重启
context 列位于 pg_settings 中,说明修改需要什么操作:
| 上下文 | 修改方式 | 示例 |
|---|---|---|
postmaster | 配置文件或 ALTER SYSTEM,然后重启 | shared_buffers、max_connections、io_method |
sighup | 配置文件或 ALTER SYSTEM,然后重载 | max_wal_size、大多数 autovacuum_* |
superuser | 重载,或由超级用户执行 SET | log_min_duration_statement、wal_compression |
user | 重载,或由任何人执行 SET;也可按角色、按数据库设置 | work_mem、random_page_cost、statement_timeout |
对于服务器级配置,先执行 alter system set ...,再执行 select pg_reload_conf();重载是安全的,正在运行的查询会继续。postmaster 配置虽然会被记录下来,却要等重启才会应用,所以每次改完配置都运行:
postgresql.auto.conf 会覆盖 postgresql.conf。把两者混用,迟早会出现这样的情况:postgresql.conf 的修改没有效果,因为旧的 ALTER SYSTEM 仍然胜出。选定一个地方(配置管理通常意味着使用配置文件),再用 alter system reset all 清空另一个地方。
internal 设置完全不能修改(block_size、data_checksums)。pg_file_settings 会显示每个配置文件行以及它是否已应用;它的 error 列可以捕获错误值,而重载报告这类错误时只会写入服务器日志。
29-configuration内存:先做预算,再调优
Postgres 在启动时分配一个共享池,此外每个连接运行时还会分配私有内存(后端内存是私有的)。后者是服务器耗尽内存的原因,所以提高任何配置之前,先把各项上限加起来。本章起步配置的预算如下:
这些上限加起来超过了机器的内存容量,这很正常:大多数查询只会用到一小部分 work_mem。但要知道哪一项会随流量增长:work_mem 乘以连接数。
shared_buffers 从内存的 25% 起步,而不是 80%
shared_buffers 是 Postgres 自己的页缓存(shared_buffers 是一个页数组),默认值为 128 MB。在专用服务器上,从内存的 25% 起步。不要设成 80%:Postgres 还会经过 操作系统页缓存读取数据;那是第二层、更大的缓存,而过大的 shared_buffers 会挤压它,同时又重复缓存相同的页。超过 40% 后要测量。修改它需要重启。
大的 shared_buffers 需要大页
当 shared_buffers 很大时,在 Linux 上使用 2 MB 的大页(huge pages):如果使用普通的 4 KB 页面,数百个进程映射 16 GB 共享内存时,其页表可能占掉数 GB。先在内核中预留大页(vm.nr_hugepages,数量由 postgres -C shared_memory_size_in_huge_pages 计算),然后设置 huge_pages = on;默认值 try 在没有预留大页时会静默回退。
effective_cache_size 是提示:设为内存的 50% 到 75%
它不会分配任何内存。规划器把它当作关于可以缓存多少数据的提示(effective_cache_size 是提示,不是内存)。把它设为内存的 50% 到 75%;默认值是 4 GB。
work_mem:先乘起来,再提高
work_mem(默认 4 MB)是一个查询在溢写到临时文件之前,可供每个排序或哈希节点使用的内存。下面是以默认值和 256 MB 对整个 events 排序的结果:
在 4 MB 时,排序向临时文件写入了 50 MB;在 256 MB 时,它用 109 MB 内存完成了排序。阈值很陡:64 MB 仍然会溢写同样的 50 MB,而 128 MB 就能装下。在我们的机器上,内存排序甚至没有更快。当溢写量大、发生频繁或存储很慢时,就需要重视溢写。
那为什么不在全局设置 work_mem = 256MB?关键在于“每个”。一个计划可能有多个排序和哈希节点(work_mem 是按节点计算的,而且可以看到),哈希节点会得到两倍的 work_mem(hash_mem_multiplier 自 PostgreSQL 15 起默认为 2.0),每个并行工作进程都有自己的额度,而且每个连接都可能同时这样做:
真正会唤醒 Linux OOM killer 的,是内存使用的尾部峰值;它杀掉一个后端进程时,整个服务器都会重启(见下文的不要让 OOM killer 选择 Postmaster)。所以:
- 在连接池代理后面保持全局
work_mem适中:16 到 64 MB;连接数很多时还要更低。 - 在明确知道需要的地方,按角色(如上面的
reporting角色)或按事务(set local work_mem = '512MB')提高它。 - 打开
log_temp_files(见下文),找出实际发生溢写的地方。
29-configuration排序是在关闭并行的情况下运行的;它溢写了 temp written=12751 个块。普通的 select kind, count(*) from events group by kind 会在三个进程中运行一个位于 Partial HashAggregate 之上的 Sort(一个领导进程和两个工作进程)。它实际用量只在 KB 量级(每个排序 25 KB、每个哈希 32 KB),但它的上限是:每个进程中排序的内存额度是 work_mem,哈希的额度是它的两倍;合计就是 work_mem 的九倍。
每个自动清理工作进程也会占用 maintenance_work_mem
maintenance_work_mem(默认 64 MB)供 CREATE INDEX、VACUUM 和恢复操作使用;同时运行的这类操作通常不多,所以在 16 GB 机器上设为 1 GB 是合理的。除非显式设置 autovacuum_work_mem,否则每个自动清理工作进程也会占用同样多的内存。(内存不足时,清理会重新扫描每个索引。)
告诉 Postgres 你的存储能做什么
有两组配置用于向 Postgres 描述磁盘:一组为规划器设定读取代价,另一组决定同时保持多少次读取处于在途状态。
random_page_cost 假定旋转磁盘
规划器把顺序读取一页的代价定为 1,把随机读取一页的代价定为 random_page_cost = 4,这个比值模拟的是磁盘磁头寻道。在 SSD 上,随机读取与顺序读取的代价几乎相同,所以默认值会低估索引扫描的价值。下面是在 project_id 上有索引时,按项目顺序读取前 20 个项目的事件的结果:
两种方式触碰的页面数大致相同(1,919 对 1,970)。在 4 下,规划器认为按顺序读取索引的代价高于位图扫描加排序,于是用位图收集页面后再排序;在 1.1 下,按顺序的索引扫描胜出,排序消失。对于 SSD 存储的服务器(包括云块存储),设置 random_page_cost = 1.1。它是 user 配置,所以先按会话试用,看看哪些计划会变化(规划器也在估算)。
快速存储需要更多在途读取
effective_io_concurrency 设置的是:当 Postgres 能预判所需页面时,允许同时在途的读取数量。PostgreSQL 18 把默认值从 1 提高到 16(maintenance_io_concurrency 也从 10 提高到 16);在快速 NVMe 或高 IOPS 的云卷上,把它设为 64 到 200,可能有助于从磁盘读取的扫描。
PostgreSQL 18 还为读取加入了异步 I/O,由 io_method 选择,而修改它需要重启。默认的 worker 会把读取交给 io_workers 个进程;io_uring 使用 Linux 内核的接口;sync 是旧行为。保持 worker。如果扫描受 I/O 限制,先提高 io_workers,这只需要重载。
拉长检查点间隔,并按 WAL 速率设置 max_wal_size
先记日志,再写数据解释了这些配置的作用;下面说明如何设置它们:
checkpoint_timeout(5 分钟):在写入繁重的系统上提高到 15 到 30 分钟。整页镜像会更少,但崩溃恢复会更久。max_wal_size(1 GB):检查点之间 WAL 的软上限;Postgres 会在 WAL 达到约max_wal_size / (1 + checkpoint_completion_target)时请求检查点,按默认值大约是 540 MB。测量 WAL 速率(在繁忙的一小时内计算 LSN 的差值),把它设得明显高于一个间隔产生的 WAL 量:在 16 GB 服务器上,4 到 16 GB 很常见,同时要在pg_wal所在磁盘上留出同样多的空闲空间。wal_compression(off):设为lz4或zstd。WAL 章节的测试中,它把以镜像为主的 WAL 降到了 59% 和 35%。min_wal_size(80 MB):1 GB 没问题。其余配置已经合适。
然后确认大多数检查点是按时间触发,而不是被请求触发的(检查点为恢复设定上限说明了如何读取 pg_stat_checkpointer)。
wal_buffers 的默认值为 -1:取 shared_buffers 的 1/32,但上限是一个 16 MB 的 WAL 段;这对几乎所有服务器都合适。有两个 WAL 配置可以保持不动:wal_level 的默认值是 replica,足以支持备库和时间点恢复(只有逻辑解码需要 logical);full_page_writes 保持开启,因为关闭它后,如果 8 KB 页写入到一半时发生崩溃,可能留下恢复无法修复的撕裂页。“其余配置已经合适”指的就是这些配置。
29-configuration自动清理的默认值适合小表和慢磁盘
清理不可省解释了为什么这些默认值在大表和快速存储上会落后。值得做的服务器级修改如下:
| 配置项 | 默认值 | 起始值 | 原因 |
|---|---|---|---|
autovacuum_vacuum_cost_limit | -1 (200) | 1000 到 2000 | 在 SSD 上太慢,而且由所有工作进程共享 |
autovacuum_vacuum_scale_factor | 0.2 | 0.05 | 死行达到 5% 就清理,而不是 20% |
autovacuum_vacuum_insert_scale_factor | 0.2 | 0.05 | 更早冻结并设置可见性位 |
autovacuum_analyze_scale_factor | 0.1 | 0.02 到 0.05 | 让增长中的表拥有更新的统计信息 |
autovacuum_max_workers | 3 | 3 到 6 | 并行处理更多表;同时提高代价上限 |
log_autovacuum_min_duration | 10min | 1s | 看到自动清理在做什么 |
然后为最大的表添加按表设置。PostgreSQL 18 还把死行触发条件限制在 autovacuum_vacuum_max_threshold(默认 1 亿行),所以一个有十亿行的表不再需要等到出现 2 亿个死行才触发(清理不可省中有公式)。
在 PostgreSQL 18 中,autovacuum_max_workers 可以通过重载修改,最高不超过 autovacuum_worker_slots(默认 16;修改该值需要重启)。
按表设置属于存储参数,只对那张表覆盖服务器级值。对于像 events 这样规模大、很繁忙的表:
除非表拥有自己的 autovacuum_vacuum_cost_limit,否则一个工作进程的代价预算会在同时运行的工作进程之间分摊;如果表有自己的设置,该工作进程就使用自己的预算。
29-configuration并行查询加速一个查询,不是整个服务器
Postgres 可以把大型扫描、连接或聚合拆分到多个工作进程中。这样会让一个大型查询更快,但不会提高每秒查询数;在繁忙的 OLTP 服务器上,查询的工作进程占用的每个核心,都是其他连接无法使用的核心。
对于 4 个 vCPU:设置 max_parallel_workers = 4、max_parallel_workers_per_gather = 2。分析型服务器可以设得更高;对延迟敏感的 OLTP,可以为应用角色将每个 Gather 的并行工作进程上限设为 0,只让报表查询并行执行。
max_worker_processes(8,修改需要重启)限制所有后台工作进程,而 max_parallel_workers(8)是其中分给并行查询的份额。规划器根据表大小调整工作进程数量:超过 min_parallel_table_scan_size(8 MB)后可以使用一个工作进程;每增加一个工作进程,所需大小再乘以三,因此 events(275 MB)会得到四个工作进程。
29-configuration低开销日志能回答大多数凌晨 3 点的问题
Postgres 开箱只记录错误和检查点(从 PostgreSQL 15 起,log_checkpoints 默认开启),除此之外几乎什么都不记。这些配置代价很低,却能回答大多数“凌晨 3 点发生了什么”的问题:
| 配置项 | 默认值 | 建议值 | 它提供的信息 |
|---|---|---|---|
log_min_duration_statement | -1 | 250ms 到 1s | 所有慢于该值的语句 |
log_lock_waits | off | on | 每当锁等待超过 deadlock_timeout(1s)时记录一行 |
log_temp_files | -1 | 0 或某个大小 | 把数据溢写出 work_mem 的查询 |
log_autovacuum_min_duration | 10min | 1s | 带有完整统计信息的自动清理运行记录 |
把 log_line_prefix 设为 '%m [%p] %q%u@%d %a ',这样每一行都会标出用户、数据库和 application_name。
有两点需要注意:log_min_duration_statement 会记录查询参数,因此个人数据可能进入日志;log_statement = 'all' 产生的 I/O 可能比数据库本身还多。日志能显示哪些查询很慢;pg_stat_statements 能显示哪些查询的总开销最大,而这通常才是更好的问题(观察数据库运行)。
auto_explain 记录你之后无法复现的计划
auto_explain 会记录慢查询实际运行时的计划,而这个计划往往无法在事后复现。把它预加载到 shared_preload_libraries 中,将 auto_explain.log_min_duration 设为两秒左右,打开 log_analyze 和 log_buffers,关闭 log_timing:逐节点计时才是昂贵的部分。下面的起步配置已经包含这些行。
内核可以拖垮一台调优良好的服务器
上面的每项配置都可能是正确的,但服务器仍然会崩溃:Linux 杀掉 Postmaster,检查点被数 GB 的脏页阻塞,容器只给并行查询 64 MB 共享内存。内核有自己的规则。(在托管服务中,内核由服务商负责,但内存不足导致的进程终止仍会影响你,表现为所有连接同时断开。)
别让 OOM killer 选择 Postmaster
默认情况下,Linux 会承诺分配它可能无法实际兑现的内存;当 RAM 和交换空间都耗尽时,OOM killer 会杀掉一个进程。如果它选中的是后端进程,Postgres 无法判断共享内存是否只改了一半,于是会终止其他所有进程并执行崩溃恢复(检查点为恢复设定上限)。所有连接都会断开。
文档给出了两个可以一起使用的修复办法。严格超额承诺(vm.overcommit_memory = 2)会让内核拒绝超过上限的分配,因此想要过多内存的查询只会单独失败并报 out of memory。用 oom_score_adj = -1000 保护 Postmaster,并设置 PG_OOM_ADJUST_FILE,让它的子进程仍然可以被杀掉。它们都不能修复根因;根因要靠内存预算解决。
在严格超额承诺下,提交上限为 (RAM - huge pages) x vm.overcommit_ratio / 100 + swap;该比值默认是 50,这会在还有一半 RAM 空闲时就拒绝分配,所以只能在专用服务器上调高它;我们从 80 到 90 起步。在 systemd 下,保护配置是 OOMScoreAdjust=-1000 加上 Environment=PG_OOM_ADJUST_FILE=/proc/self/oom_score_adj;没有这个变量时,每个后端进程都会继承豁免。如果 Postmaster 自己被杀掉,在重启前不会接受新连接(PostgreSQL 文档)。
29-configuration为每种机器类型一次性决定操作系统配置
每一项都是 Postgres 无法替你决定的内核或文件系统选择:
- 预留大页(
vm.nr_hugepages),并关闭透明大页(transparent huge pages)。 文档不建议使用透明大页。 - 保留交换空间,但让它很少被使用(
vm.swappiness为 1 到 10)。被换出的后端进程会很慢;被杀掉的后端会让服务器重启。 - 用字节数限制脏页(
vm.dirty_background_bytes和vm.dirty_bytes,约为存储每秒可写入量)。默认情况下,内核允许 10% 的内存处于未刷盘状态;而检查点的fsync会让每次提交都在它后面停住:每隔几分钟准时出现一次延迟尖峰。 - 使用 ext4 或 XFS、设置
noatime,并且绝不要禁用写屏障,否则断电可能丢失 Postgres 已报告为持久化的提交。 - 保持预读和 I/O 调度器的默认值,并保持
vm.zone_reclaim_mode = 0。 对 OLTP,优先选择更少但更快的核心;在 x86 云环境中,一个 vCPU 通常只是半个物理核心。 - 在容器中按 cgroup 限额做预算,因为该限额包含页缓存;同时给
/dev/shm多于 Docker 默认的 64 MB,否则大型并行查询可能失败。
postgres -D "$PGDATA" -C shared_memory_size_in_huge_pages 即使在服务器启动之前也能给出答案(实验服务器上是 76 个,即 152 MB)。把 vm.nr_hugepages 设为这个数,再设置 huge_pages = on。预留的大页会从其他用途可用的内存中消失,所以只预留 Postgres 需要的数量(文档中的操作步骤)。透明大页“已知会在某些 Linux 版本上让某些用户的 PostgreSQL 性能下降”(文档);这些报告之后内核已经变化,但没人证明 THP 有帮助。
超过 vm.dirty_background_ratio(10)后,内核开始刷盘;超过 vm.dirty_ratio(20)后,写入者必须自己刷盘:在一台 256 GB 的机器上,开始刷盘前大约会积累 25 GB。Postgres 写入时会推动内核(checkpoint_flush_after 为 256 KB,bgwriter_flush_after 为 512 KB),但批量写入的后端进程不会这样做(backend_flush_after = 0)。把字节数上限设为存储约一秒内可写入的数据量,并比较修改前后 sync 在 log_checkpoints 行中的时间。
29-configurationcgroup 的内存包括页缓存和共享内存(内核 cgroup 文档);达到 memory.max 时,OOM killer 会在 cgroup 内运行。根据这个限额设置 shared_buffers,限额见 /sys/fs/cgroup/memory.max;容器内的 free 通常报告的是宿主机的内存。
并行查询会在 /dev/shm 中共享状态,例如并行哈希连接的哈希表;Docker 给容器的这一空间只有 64 MB。几次大型并行哈希连接同时运行时,会失败并报 could not resize shared memory segment ... No space left on device。实验套件采用 shm_size: 512m 这一设置;在 Kubernetes 中,把一个以内存为后端的 emptyDir 挂载到那里(Kubernetes 文档)。
29-configuration下面这份 16 GB 起步配置面向一台专用服务器,存储可以持续提供约 500 MB/s:
从这份 4 vCPU、16 GB 配置开始,然后测量
大多数值都在前文相应小节中说明过;少数没有沿用上文的值,会在注释中说明原因。它假定这是使用 SSD、4 个 vCPU、16 GB 内存的专用服务器,应用位于连接池代理(pooler)之后,并且已按 PostgreSQL 18.6 核对。复制之前先注意:work_mem = 32MB 假定服务器连接数约为 100;max_wal_size = 8GB 需要 WAL 卷有同样多的余量;所有值都应随环境缩放:内存随 RAM、并行度随核心数、WAL 随写入速率变化。
把它放入由 postgresql.conf 引入的文件中,或者用 ALTER SYSTEM 设置,但不要两者都用。
修改之前,先记录它应该改变的数值:pg_stat_statements 总量、检查点次数、临时文件量和自动清理频率。一次只改一个配置,等待一个有代表性的时间段,然后进行比较(只改一件事,并端到端测量)。把配置放进版本控制,这样“改了什么?”永远都有答案。
实验会用检查自己的配置同样的方式检查这份配置:每个名称都存在于 pg_settings 中,每个会话可以设置的值都能被接受。在你自己的服务器上,再为本章前面的 pending_restart 检查加一条查询。它会列出服务器无法应用的配置文件行:
postgresql.conf 中拼错的名称会出现在这里,而 postmaster 配置的错误值会让服务器根本无法启动;所以要在重启之前检查,而不是之后。
29-configuration在托管服务上,真正重要的配置仍可调整
在托管服务上,配置位于服务商的参数组中,需要重启的配置要重启实例才生效(往往意味着故障切换),有些配置则被锁定(设置位于参数组中)。替换存储层的服务商会改变 WAL 配置的行为(分离式存储改变了部分规则)。最重要的配置在哪里都可以调整,ALTER ROLE ... SET 即使在不能使用 ALTER SYSTEM 的地方也能工作。
本章要点
- 在修改任何内容之前检查
pg_settings(source、context);凡是因负载而异的配置,都按角色设置。 - 先做内存预算:
shared_buffers设为 RAM 的 25%,再加上work_mem乘以节点数和连接数。全局保持work_mem适中,在明确需要的地方再提高。 - 在 SSD 上设置
random_page_cost = 1.1;让异步 I/O(io_method = worker)保持默认值。 - 用更大的
max_wal_size和更长的checkpoint_timeout让检查点由时间驱动,并打开wal_compression。 - 给自动清理更大的代价上限和更小的比例因子。
- 在 Postgres 之下的系统层:让 OOM killer 不要杀掉 Postmaster,关闭透明大页,用字节数限制脏页,绝不要禁用写屏障;在容器中按 cgroup 限额做预算。
- 打开慢查询、锁等待、临时文件和自动清理日志,以及
auto_explain。
延伸阅读
- Setting parameters,PostgreSQL 文档。设置值的所有方式,包括 include、
ALTER SYSTEM和按角色设置。 - Resource consumption,PostgreSQL 文档。内存、I/O 和异步 I/O 配置,以及它们的确切默认值和限制。
- Write Ahead Log settings,PostgreSQL 文档。检查点、
max_wal_size和wal_compression。 - Error reporting and logging,PostgreSQL 文档。所有
log_*配置以及log_line_prefix的转义符。 - Managing kernel resources,PostgreSQL 文档。大页、Linux 内存超额承诺,以及保护 Postmaster 不被 OOM killer 杀掉的
oom_score_adj配置方法。 - Documentation for /proc/sys/vm,Linux 内核文档。超额承诺、交换倾向、脏页阈值和区域回收的确切含义与默认值。
31 观察数据库运行
在一分钟内,我们的测试服务器用 pgbench 运行了一组混合负载:按主键查找 users 中的行、向 events 插入、项目列表和一份小报表。下面列出调用次数最多和最少的查询:
一条查询的调用次数只有另一条的 1/59,消耗的数据库时间却是它的 37 倍:占服务器全部工作量的三分之二。请求速率仪表盘看不出这一点。100 ms 的慢查询日志也看不出来,因为一次典型调用大约只花 57 ms。
你能看到的慢查询很少是真正的问题。本章的这些视图会找出你看不到的那个问题,最后给出一份值得叫醒别人的短清单。它们几乎都读取累计统计信息系统:由每个后端进程递增的计数器,一直保留到重置或崩溃。单个计数器几乎说明不了什么;要看速率和排名。
从 pg_stat_statements 开始
pg_stat_statements 是 Postgres 最有用的可观测性工具。它按归一化后的结构对语句分组,并为每种结构保留累计总量:调用次数、时间、行数、缓冲区、WAL 和临时文件。它随 Postgres 一起提供,所有主要托管服务也都支持它。
pg_stat_statements 在服务器启动时加载
它必须预加载,所以打开它需要重启:
然后在每个要查询它的数据库中执行 create extension pg_stat_statements;数据是整个集簇级别的。现代 Linux 上 track_io_timing 的开销很小(可用 pg_test_timing 检查),它记录的 I/O 时间是你能收集到的最有用的数据之一。
常量会变成占位符,因此每次主键查询都归为一行,以 queryid 为键;这个值也会在 pg_stat_activity 中显示为 query_id。
pg_stat_statements.max(5,000)限制不同语句的数量;默认值 track = top 只统计顶层语句。从 PostgreSQL 18 开始,计算 queryid 哈希时会按名称标识表,因此删除并重建表后仍会保留历史。反过来,不同模式中同名的表现在会共享一条记录;如果每个租户使用一个模式,那么每个租户的 select ... from orders 都会合并成一行。把 %Q 加入 log_line_prefix,日志就会带上 queryid。
过去,发送 in ($1, $2)、接着发送 in ($1, $2, $3) 的 ORM 会让视图为每种列表长度各生成一条记录。PostgreSQL 18 会把它们合并成一条,显示为 in ($1 /*, ... */)。使用数组的 = any($1) 仍是更好的习惯:在所有版本中都只有一种语句结构(经得住数据增长的查询)。
30-observability30-observability30-observability用四种方式给同一视图排序,先看总时间
每次排查都从同一个视图开始,按四种方式排序。时间都花在哪里? 按 total_exec_time 排序。这是任何服务器上第一条该运行的查询:
总时间等于调用次数乘以平均时间。修复排名第一的语句,可以释放这个服务器三分之二的查询时间;修复调用最频繁的语句,最多只能释放 1.8%。
对用户来说,什么慢? 按 mean_exec_time 排序,跳过执行次数很少的语句。这份报表的平均值是 57 ms。较大的 max_exec_time 表示一条查询有时会慢得多,就像这里的插入一样:平均 0.92 ms,最大 254 ms,而当时磁盘正被其他工作占用。
什么触碰的页面最多? 按 shared_blks_hit + shared_blks_read 除以 calls 后的结果排序。耗时有噪声,页面数没有。整本书的论点可以写成这样一个查询:
这份报表每次调用会触碰 35,248 个页面,也就是 275 MB:整张 events 表,而它在 project_id 上没有索引(B-树挑起大梁可以解决这一点)。主键查询只触碰 3 个页面。项目列表为 20 行触碰 257 个页面,原因是外键没有索引。每次调用的块数是应该压下去的数字,而且不同运行之间几乎不变,所以可以作为前后对比指标(只改一件事,并端到端测量)。
什么写入最多? 按 wal_bytes 排序。插入在一分钟内写入了 75 MB 的 WAL,平均每行约 7.5 KB,几乎全是整页镜像(先记日志,再写数据)。WAL 量会影响副本延迟、备份大小和磁盘吞吐量。
30-observability其他排名只是替换 order by:mean_exec_time(加上 where calls > 100)、shared_blks_hit + shared_blks_read,或者 wal_bytes。rows / calls 可以找出返回行数超过应用实际使用量的查询。WAL 排名的第一行是插入:10,484 次调用、53,067 条记录、9,272 个整页镜像。这大约是每行五条记录:堆元组、主键条目,以及外键检查的三个父行各自对应的一条行锁(提交记录发生在语句之后,所以不计入)。这些锁会在每次插入时触碰三个随机的父表页;服务器当时又频繁执行检查点,整页镜像就是在这里产生的。
还有几个值也值得知道:temp_blks_written(溢写到磁盘的排序或哈希)、shared_blk_read_time(启用 track_io_timing 时;PostgreSQL 17 之前叫 blk_read_time),以及 plans 和 total_plan_time。后两者只有在打开 pg_stat_statements.track_planning = on 后才会填充;该选项默认关闭,因为有开销。
30-observability做快照并求差值;不要重置
几周之后,累计历史会占据主导地位,昨天才变慢的查询会藏在它漫长而快速的过去里。不要按计划重置。做快照并求差值:每隔几分钟复制一次视图并计算增量,这样就能问“昨天 14:00 到 14:15 之间,排名靠前的查询是什么”。大多数监控代理会替你做这件事。
在一次基准测试之前,有针对性地调用 pg_stat_statements_reset(userid, dbid, queryid) 是可以的。同时观察 dealloc(它位于 pg_stat_statements_info 中):它不断升高,意味着语句超过 pg_stat_statements.max 后正在被淘汰。
pg_stat_activity 显示此刻发生的事
pg_stat_statements 记录的是过去,pg_stat_activity 记录的是此刻:每个服务器进程一行,包括它正在运行什么、从什么时候开始运行,以及在等待什么。它的 state 可以是 active、idle(等待客户端的下一条语句,这是正常状态),或者 idle in transaction:位于一个打开的事务中,持有自己的锁,并可能持有快照,而应用正在做别的事。几毫秒属于正常情况;几分钟就是缺陷。
没有等待事件的活动会话正在占用 CPU
wait_event_type 和 wait_event 表示后端进程正在等待什么;这两列均为空的 active 行表示该会话正在 CPU 上运行。Lock 是重量级锁(可以锁表,也可以是另一个事务持有行锁时的 transactionid);LWLock 表示内部结构上的争用(解决 LWLock 等待要调整负载,而不是查询);IO 表示读取页面或刷新 WAL;Client 表示等待应用。pg_wait_events(PostgreSQL 17+)记录了每一种等待事件。每秒统计十次,你就得到了一个画像。
本节的示例来自账户 7 上的三个会话。会话 a 在事务中更新了该账户,然后运行 pg_sleep(60)。会话 b 打开一个事务,读取了一些用户,然后没有提交就进入空闲。会话 c 尝试更新同一个账户,于是被阻塞。睡眠中的会话状态是 active,而不是 idle:它正在运行一条语句,等待事件是 Timeout:PgSleep;应用步骤在数据库内运行时,慢就会呈现为这种样子。会话 a 还有一个 backend_xid,因为它执行过写入;会话 b 没有,因为事务要到第一次写入时才会取得 XID。
30-observabilitybackend_xmin 指出阻挡清理的事务
长事务会阻塞清理、持有锁,并让迁移超时。按年龄列出所有打开的事务:
idle in transaction 且 in_state 很大的会话,是被遗忘的事务;query 是它最后运行的那条语句。backend_xmin 是该会话快照所需的最老事务,也正是它阻挡清理的原因。会话 9733 处于读已提交隔离级别的空闲状态,没有这个值,因为读已提交会在语句之间丢弃快照;repeatable read 则会在整个事务中保留快照。
pg_blocking_pids(pid) 会显示谁阻塞了谁:9745 的更新被 {9726} 阻塞,后者更新了同一个账户但还没有提交。发生事故时,pg_cancel_backend(9726) 会取消它的语句并释放行锁;处于 idle in transaction 的会话没有正在运行的语句可取消,所以要用 pg_terminate_backend 结束它(大家都得排队)。
真正会悄悄伤害数据库的是旧快照,而不是慢查询。清理无法移除整个数据库中最老快照可能需要的任何行版本。检查 max(age(backend_xmin))(在 pg_stat_activity 中),以及复制槽的 xmin 和使用 hot_standby_feedback 的备库的相应值;它们都会阻碍同一个 xmin 清理界限(xmin horizon)推进(清理无法移除旧快照可能需要的内容)。
隔离级别决定空闲事务是否会阻止清理界限推进。会话 b 处于读已提交的空闲状态,既没有 XID,也没有 xmin:它在语句之间不持有快照,所以完全不会阻塞清理,尽管它仍然持有锁。第四个会话 d 执行了 begin isolation level repeatable read,运行一次 select 后进入空闲;只要事务保持打开,它的 backend_xmin 就会一直存在,因为之后的每条语句都必须看到同一个快照。因此,一个忘记提交的可重复读报表任务,比一个做同样事情的应用事务更糟。要找出阻碍清理界限推进的会话:
30-observability采样等待,看看时间花在哪里
看一眼 pg_stat_activity 就像拍了一张照片。每秒取十次样,持续一分钟,统计你看到的内容,你就得到了一个画像:会话的忙碌时间有多少花在 CPU、读取页面、等待锁或刷新 WAL 上。它不需要扩展,却能回答 pg_stat_statements 回答不了的问题:不是哪个查询,而是查询在等待什么。
每次采样都必须使用独立事务
创建一张表,然后从 psql 反复执行同一条插入语句:
\watch 会每 100 ms 重新执行一次插入,共执行 600 次,也就是一分钟(count 是 psql 16+ 支持的参数)。每次执行都必须是独立事务:Postgres 每个事务只会为 pg_stat_activity 取一次快照,因此如果把采样循环写成一个 DO 块,它会把第一次采样记录 600 次。
每次采样前调用 pg_stat_clear_snapshot(),并用 clock_timestamp() 给行加时间戳,因为 now() 和 statement_timestamp() 也会被冻结。(运行一分钟的 DO 块同样是一个运行一分钟的事务,这本身就是另一个小问题。)
30-observabilityCPU 行高于核心数,说明正在排队
按等待事件统计采样。没有等待事件的活动会话正在占用 CPU,所以把它标成 CPU:
在一个由四个会话组成的玩具负载上(一个在循环中空转,一个在睡眠,一个持有行锁并进入空闲,一个等待该行锁),采样 20 轮:
采样 20 轮时,查询应该除以 20,而不是 600。每一行的平均会话数都恰好是 1;处于事务中空闲的那个会话没有出现在这里,因为画像只统计 active 行。avg_sessions 是托管服务仪表盘绘图使用的单位。把 CPU 行与核心数比较:超过核心数,就说明会话正在排队等待处理器。
然后把 query_id 连接到 pg_stat_statements,看看哪些语句拥有这些等待。采样大多是 CPU 或 DataFileRead 的语句,慢是因为自己的工作量,修复点在执行计划;采样大多是 Lock 或 LWLock 的语句,慢是因为其他人的活动,修复点在它等待的对象上。
大多数画像中,只有少数几种事件占主导
每一种都指向不同的修复方法:
- CPU:查询正在做自己的工作。按总时间和每次调用的块数排序。
IO:DataFileRead:正在读取不在共享缓冲区中的页面。按shared_blks_read排序,先修查询,再考虑买更多内存。LWLock:WALWrite和IO:WalSync:提交正在等待 WAL 到达磁盘。使用更少但更大的事务,或者更快的 WAL 存储(多个提交共享一次刷盘)。Lock:transactionid:会话正在等待另一个事务持有的行。找到阻塞链的根(找到根阻塞者)。Lock:relation通常表示锁队列中的 DDL。
采样不是计时器,但持续一分钟后,每种事件都会按其总时间的比例出现,这正是你需要用来排序的依据。要和上周比较,就持续采样:pg_wait_sampling 扩展在服务器内部完成这件事;托管服务商的“数据库负载”图表也是同一种画像(服务商仪表盘是等待事件采样器)。学会读取自己的 SQL 版本,就能读取它们中的任何一个。
表统计计数器能找出缺失和未使用的索引
在 pg_stat_user_tables 中,应该关注的是 seq_tup_read。 对一张 10 行的查找表来说,顺序扫描没问题;真正有代价的是顺序扫描读出的行。一分钟负载之后,events 显示为 1,054,772,482:一分钟读了十亿行,又是那份报表。大表如果每次扫描读到的行数很多且还在上升,就说明缺少索引。(events 统计出 1,573 次扫描,而报表运行了 525 次,因为每个并行工作进程的份额都会计入。要看速率。)
pg_stat_user_indexes 能找出没人使用的索引:连续几周 idx_scan = 0。但 events_pkey 在 10,484 次插入之后仍显示 0,因为唯一性检查不算扫描。不要因为某个索引看起来没用就删除约束背后的索引;还要检查副本,因为副本会统计自己的使用情况(idx_scan 为零只是疑点,不能据此定案)。
累计统计信息会因 pg_stat_reset() 重置,会在崩溃时消失,也不会在从模板创建数据库时复制过去:在我们刚克隆的数据库中,100,000 个用户的 n_live_tup 读数是 0。判断索引未使用之前,先检查 stats_reset(位于 pg_stat_database 中)。
缓存命中率是趋势,不是目标
缓冲区缓存命中率,也就是页请求在共享缓冲区中命中的比例,是 Postgres 最常被引用的健康指标。我们的命中率是 40.64%,放在通常的“保持在 99% 以上”规则旁边看很吓人。仔细看就会发现,这个规则站不住脚:
- “读取”不等于磁盘读取。 Postgres 把由操作系统页缓存提供的页面也计为一次读取,耗时可能只有微秒:
users查询的命中率是 67.7%,平均只花 0.03 ms。 - 一个查询就能占据主导。 几乎所有这些读取都来自那份报表;它的扫描使用一小块缓冲区环,所以每次运行都会从操作系统读取大部分页面。
- 平均值会藏住尾部。 整体命中率可以达到 99.9%,同时某条查询每次运行仍要从磁盘读取 50,000 个页。
所以要把这个比例画成图,观察突然下降的时刻;然后在 pg_stat_statements 中按 shared_blks_read 排名,找出发生了什么变化。
对于大于 shared_buffers 四分之一的表,顺序扫描会使用 256 KB 的缓冲区环,而不是整个缓存,这样一次大扫描就不会把其他内容全部挤出去。代价由扫描本身承担:它读到的每个页面几乎刚读完就会从这个环中被挤出,因此下一次运行还会把它们全部重新读取。它实际命中的页面,是其他查询已经缓存的页面。那份报表每次运行都能在共享缓冲区中找到大约三分之一的页面;重复运行不会提高这个比例,索引(或比表更大的缓存)则能提高这个比例。
30-observabilitypg_stat_io 发现后端进程写脏页的情况(PostgreSQL 16+)
pg_stat_io 会按执行者、对象和上下文拆分所有 I/O(上下文包括 normal,以及 bulkread、bulkwrite 和 vacuum 缓冲区环)。它最值得问的问题是:客户端后端进程是否在自己写脏页? 理想情况下,几乎所有这类工作都应由检查点进程和后台写入器完成(你的查询不该负责写脏页)。
在我们的实验服务器上,一上午加载数据之后,客户端后端进程写了 151,031 个页面,比后台写入器的 60,192 个还多。默认的 128 MB shared_buffers 对这份写入负载来说太小了,更激进的后台写入器(bgwriter_lru_maxpages)是另一个可以调节的地方。批量加载期间出现一部分这种情况是预期的;稳定运行时不应该如此。
这些 151,031 次写入发生在 normal 上下文中;检查点进程写入了 119,725 次。客户端后端进程对关系执行的 fsyncs 次数应该是零(这里就是 0);非零表示检查点进程的请求队列溢出了。读取量最大的,是在 bulkread 上运行的并行工作进程,它们正在执行报表扫描。PostgreSQL 18 中,这个视图还会报告字节数,并覆盖 WAL:这里客户端后端进程完成了大部分 WAL 写入和 7,711 次 fsync,也就是提交路径上的工作。
30-observability检查点应该由时间触发
几乎所有检查点都应该按时间触发,而不是由 WAL 量请求触发。我们的实验服务器在 pg_stat_checkpointer(PostgreSQL 17+)中显示了 1 次按时间触发和 28 次请求触发:WAL 生成太快,默认 1 GB 的 max_wal_size 不足以应付(检查点为恢复设定上限解释了这些计数和修复办法)。在 PostgreSQL 18 中,还要读取实际完成的检查点数量 num_done:即使服务器空闲,num_timed 也会统计那些被跳过的检查点,这可能让安静的服务器看起来比实际更健康。在图中把 pg_stat_wal 的每秒 WAL 字节数和这些计数放在一起。
被遗弃的槽会填满磁盘
主库上的 pg_stat_replication 会显示每个备库的复制延迟(权威数据的副本)。每台服务器都应该检查一项,无论它是否有副本:没有消费者的复制槽会永远保留 WAL,最终填满磁盘。
一个不活跃且 retained 不断增长的槽,说明事故正在发生。两个设置可以给它设上限:max_slot_wal_keep_size 限制槽最多保留多少 WAL,idle_replication_slot_timeout(PostgreSQL 18+)会让闲置太久的槽失效。两者默认都关闭;失效的槽意味着必须重建其消费者,但这总比磁盘写满好。
低开销估算膨胀,低峰时精确测量
膨胀是死行版本或空页面占用的空间。n_dead_tup 是一种低开销估算,足够用来画图。pgstattuple_approx 会跳过全可见页面;删除四分之一的 events 后,它报告了 24% 的死元组。精确的 pgstattuple() 和 pgstatindex 会读取整个关系,所以应在业务低峰运行(清理不可省说明了接下来该做什么)。
scanned_percent 为 100,是因为尚未执行清理,所以没有页面被标记为全可见。pgstatindex('events_pkey') 报告的 avg_leaf_density 是 90.03:以递增键建立的新 B-树大约为 90%,也就是它的 fillfactor。如果本应紧凑的索引远低于这个值,就可以考虑执行 REINDEX CONCURRENTLY。
30-observability只对需要尽快人工处理的事情告警
只对需要尽快人工处理、并且会自行恶化的事情告警。其他一切都画成图。
告警:
- 数据库不可达,或连接失败。
- 事务 ID 年龄:当
age(datfrozenxid)达到 5 亿到 10 亿时就告警,远低于 20 亿的上限。接近上限时,Postgres 会有意停止分配事务 ID;在清理追上来之前,写入都会停止(回卷会在任何内容损坏前停止写入)。 - 长事务:超过应用设定的阈值,或处于
idle in transaction超过几分钟。 - 复制:复制延迟超过应用能够容忍的范围、备库消失,或不活跃的复制槽正在保留 WAL。
- 磁盘空间:数据和 WAL 都要监控,并留出提前量(空间使用率达到 80% 且还在上升时告警)。
- WAL 归档失败(
failed_count,位于pg_stat_archiver中):你的时间点恢复出现了缺口。
**画图:**按排名靠前的语句显示每秒查询时间;按状态和 application_name 显示连接;按等待事件显示会话;显示读取和命中的块;按类型显示检查点,并显示每秒 WAL 字节数;显示最大表的死元组、临时文件字节数、复制延迟,以及主机的 CPU、内存、IOPS 和磁盘延迟。
本章每个视图显示的都是“此刻”或“上次重置以来”,这两者都回答不了“昨天 14:05 发生了什么变化?”。每隔 15 到 60 秒把它们抓取到时间序列系统,保留数周历史。发生事故时,问题几乎总是要和上周比较。
本章要点
- 到处安装
pg_stat_statements,并先按total_exec_time排名:调用最频繁的查询很少是代价最高的。 - 按每次调用的块数排名,找出触碰页面过多的查询;这是最好的前后对比指标。做快照并求差值,不要重置。
- 在
pg_stat_activity中寻找idle in transaction会话和旧的backend_xmin值。 - 想知道会话在等待什么,就用
pg_stat_activity配合\watch每秒采样十次,持续一分钟,再按等待事件计数。没有等待事件的活动会话正在占用 CPU;把它和核心数比较。 - 大表上数值很大且不断增加的
seq_tup_read指向缺失的索引;idx_scan = 0指向未使用的索引,除非它支撑某个约束。 - 把缓存命中率当作趋势,而不是目标。检查点应当大多按时间触发。
- 只对一份短清单告警:不可达、事务 ID 年龄、长事务、复制、磁盘空间和归档。其他一切画图,并保留历史。
延伸阅读
- pg_stat_statements,PostgreSQL 文档。介绍每一列、各项设置以及语句如何归一化。
- The cumulative statistics system,PostgreSQL 文档。
pg_stat_activity、表和索引视图、pg_stat_io、pg_stat_checkpointer以及所有等待事件的参考资料。 - pg_wait_sampling,Postgres Professional。一个在服务器内部采样等待事件,并按事件和查询保留画像的扩展。
- Viewing locks 和 progress reporting,PostgreSQL 文档。介绍
pg_locks以及清理、索引构建等操作的pg_stat_progress_*视图。 - The USE Method,Brendan Gregg。用于检查利用率、饱和度和错误的清单,让主机指标保持可信。
32 未经验证的备份只是传闻
设想周一 14:02。有人把迁移脚本跑在了错误的数据库上,删掉了存放三年账单地址的列。夜间备份在 03:00 完成。如果你只有这份备份,为了找回一列数据,你将丢失这 11 小时内系统中的所有写入。持续归档 WAL,就能恢复到 14:01:59,除了这次错误之外什么都不会丢。
备份只做到大致正确,结果和错误一样。无法在足够短的时间内恢复到你需要的时刻,就不算备份。除非你试过,否则不知道手里的备份属于哪一种。
先写下 RPO 和 RTO
**RPO,恢复点目标:**按时间计算,你能承受丢失多少数据。每晚转储:最多 24 小时。持续归档:几秒或几分钟。同步复制:服务器故障时为零,但人为错误不是,因为人为错误会立即复制。
**RTO,恢复时间目标:**恢复期间你能停机多久。重新加载一个 2 TB 的逻辑转储并重建所有索引,可能要花大半天;物理副本受限于移动 2 TB 数据并重放 WAL 的速度。
| 方法 | 典型 RPO | 决定 RTO 的因素 |
|---|---|---|
每晚 pg_dump | 最多 24 小时 | 重新加载数据,重建所有索引 |
| 仅物理基础备份 | 距上次备份的时间 | 复制文件 |
| 基础备份 + WAL 归档(PITR) | 几秒到几分钟 | 复制文件 + 重放 WAL |
| 流式复制副本(故障切换) | 几秒(异步) | 提升为主库:几秒 |
副本不是备份。它能覆盖硬件故障,却覆盖不了 drop table、错误的迁移或应用缺陷,因为这些错误会在几毫秒内复制过去。两者都需要。
pg_dump 可移植、小巧,但恢复很慢
pg_dump 读取一个快照,也就是启动时所有已提交内容的冻结视图(更新就是插入),然后写出 SQL 定义和数据行;即使应用仍在写入,这个视图也保持一致。
它会在转储的每张表上持有最弱的表锁。读写不受影响,但迁移会等待转储,而每个查询又会排在迁移后面(等待中的锁会阻塞后面的所有人)。
我们的示例数据库(345 MB,200 万条事件)复制到 scratch 后,以自定义格式转储:
一个 345 MB 的数据库变成了 47 MB 的转储:它经过压缩,而且不包含索引数据,只有 create index 语句。这就是转储很小而恢复很慢的原因。恢复会重新插入每一行,并重建每个索引。
31-backups.sh使用自定义(-Fc)或目录(-Fd -j N)格式:两者都会压缩、支持并行恢复,也能从整份转储中只恢复一张表。小数据库以及需要阅读内容时,保留纯 SQL 格式。
任何逻辑恢复之后都要运行 analyze,否则最初的查询会根据猜测生成计划。PostgreSQL 18 的 pg_dump --statistics 可以把规划器统计信息和数据一起带走,但它默认关闭;只依靠它而没有数据,无法复现生产环境的计划(测试计划,而不只是测试速度)。
pg_dump 不包含角色;单独转储它们
pg_dump 只转储一个数据库。角色、成员关系和表空间属于整个集簇,所以它会把这些内容排除在外。单独转储它们:
没有这些内容,恢复到新服务器时,每条 alter ... owner to app_owner 都会报错。把全局对象和每份转储放在一起。在托管服务上,你没有超级用户权限读取密码哈希,因此要加上 --no-role-passwords,并在恢复后重新设置密码。
运行 pg_dump 时使用能看到每一行的角色。如果租户表强制实施行级安全策略,所有者也会受策略约束,pg_dump 会报错退出,而不是写出一张不完整的表;给备份任务一个超级用户或 BYPASSRLS 角色(除非强制执行,RLS 会跳过表所有者)。
| 格式 | 选项 | 并行转储 | 并行恢复 | 选择性恢复 |
|---|---|---|---|---|
| 纯 SQL | -Fp | 否 | 否(psql) | 否 |
| 自定义 | -Fc | 否 | 是 | 是 |
| 目录 | -Fd | 是 | 是 | 是 |
| Tar | -Ft | 否 | 否 | 是 |
目录格式使用 -j 4 按表并行,连接数为 -j 指定的数值加 1,这些连接共享一个快照。按表并行的局限也在这里:我们的示例数据中,一张表 events 几乎包含全部行,所以 -j 4(45 MB 的目录)并不比 -Fc 快(在我们的机器上两者都耗时 3.5 到 4.5 秒)。当数据分散在许多表中时,并行转储才有收益。从 PostgreSQL 16 开始,-Z 还接受 lz4 和 zstd;在我们的示例数据上,zstd 目录转储和 gzip 一样都是 45 MB。
31-backups.sh自定义格式或目录格式的转储都带有目录表,pg_restore -l 会列出它:
createdb scratch_restore && pg_restore -j 4 -d scratch_restore scratch.dir 恢复了全部 2,000,000 条事件。实际恢复时会用到的选项如下:
-t table恢复一张表(数据和定义);-n schema恢复一个模式。-l把目录表写入文件;用;注释掉不需要的行,再用-L file把它传回去,就能只恢复你保留的内容。--section=pre-data、data、post-data把定义、行,以及索引和约束分开。- 对于角色名不同的环境(例如笔记本电脑),使用
--no-owner --no-privileges。 -1(--single-transaction)让恢复要么全部成功,要么全部回滚。它不能和-j组合使用。
31-backups.sh31-backups.sh关于统计信息:普通转储的目录表中有 0 条 STATISTICS DATA,加入 --statistics 后就会包含它们。
31-backups.sh角色确实不在转储中,而 pg_dumpall --globals-only 会包含它们。
31-backups.sh数据库超过几百 GB 时,逻辑恢复会花费数小时,因为它要重建每一个索引。保留 pg_dump,用于可移植性、单表恢复和迁移;灾难恢复则使用带 WAL 归档的物理备份。
数据量大时,只有物理备份恢复得快
物理备份会原样复制磁盘上的 8 KB 页面,包括索引和膨胀。恢复就是把文件复制回去并启动服务器:不重新插入数据行,也不重建索引。数据量大时,这是唯一恢复得快的方式。
直接用 cp -r 复制运行中服务器的数据,会得到每次写入前后页面混杂的撕裂副本。pg_basebackup 用 WAL 修复了这个问题;WAL 是在变更本身之前写下的每项变更的日志(先记日志,再写数据):重放从复制开始到结束这段时间内的 WAL,会像崩溃恢复一样修复每个撕裂页面。
然后对它运行 pg_verifybackup。它会根据备份清单检查每个文件(PostgreSQL 13+),在你需要它之前发现截断或损坏的副本。
限制也很明确:它是整个集簇,只能恢复到相同的大版本和平台上;要找回一张表,首先必须把全部内容恢复到某个地方。
一条典型命令:
-Ft -z写入压缩的 tar 文件,而不是目录树。-X stream将备份期间生成的 WAL 一并流式传输,备份因此自包含。--checkpoint=fast让起始检查点全速执行,而不是把工作分散到一段时间内完成,这样复制会立即开始。backup角色需要REPLICATION属性,并且需要一条replication规则写在pg_hba.conf中。
对于这样的 tar 格式备份,运行 pg_verifybackup -n /backups/base/2026-10-05:在 PostgreSQL 18 中,它会根据清单检查 tar 文件,但只有在普通文件格式(plain)的备份中才能解析 WAL。
31-backups.sh时间点恢复就是持续重放
单独的基础备份仍只是一个快照。但重放不必在 B 停止:保留备份之后的每个 WAL 段,就能把它向前推进到这个窗口内的任意时刻。这就是时间点恢复(point-in-time recovery,PITR),它把“丢失 11 个小时”变成“除了这次错误之外什么都不丢”。
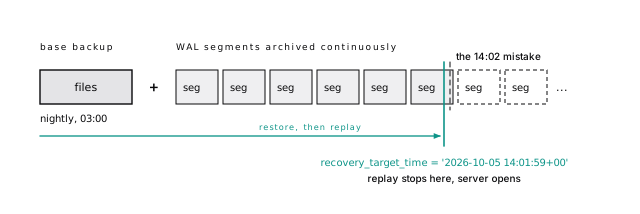
归档失败会填满磁盘并让主库停止
PITR 依赖一份连续完整的归档,所以应从这里开始。16 MB 的 WAL 段填满后,服务器会把它交给你的 archive_command。打开归档需要重启:
那个 cp 只是示意:它不会把副本刷新到磁盘,所以崩溃可能留下一个归档认为已经存在、实际却不完整的段。在生产环境中,使用备份工具的归档命令(使用备份工具)。
在安静系统上,archive_timeout 为 RPO 设上限:需要一小时才能填满的段,意味着磁盘故障时会丢失一小时数据。
监控归档器。如果 archive_command 持续失败,Postgres 会把所有未归档的段留在 pg_wal 中,磁盘会填满,主库也会停止。pg_stat_archiver.last_failed_time 晚于 last_archived_time 时,或者最新归档段已经超过几分钟时,就应告警。
恢复会在目标处暂停,让你先检查
要撤销 14:02 的错误,请把错误发生前的最后一份基础备份复制到新服务器上的空数据目录中,然后告诉它归档在哪里、何时停止:
服务器会重放在目标时刻或之前提交的每一笔事务,并在第一笔晚于目标时刻提交的事务之前停止,不应用那笔事务。使用 'pause'(默认值;这里明确写出来,免得有人疑惑)时,服务器会开放只读访问并等待。检查该列是否恢复,然后执行 select pg_wal_replay_resume() 以开放读写访问,或者调整目标时刻后重试。凌晨 3 点时,你会希望它暂停。(它需要 hot_standby = on,这也默认开启;没有它时,暂停的效果与关闭服务器相同。)
31-backups.sh对于人为错误(误删数据、删掉一列),请在另一台服务器上恢复到某个时间点,然后用 pg_dump -t 或 copy 把受影响的行复制回来。直接把生产环境回滚,也会丢掉目标时刻之后每一笔合法写入。
除了时间之外,还可以在 recovery_target_lsn(精确的 WAL 位置)、recovery_target_xid(某个事务的 XID)或 recovery_target_name 处停止;后者是先前用 select pg_create_restore_point('before_billing_migration') 创建的标签。在有风险的迁移之前创建一个命名恢复点,是成本很低的好习惯。
恢复会启动一条新的时间线,也就是 WAL 历史的一条新分支,这样恢复服务器的 WAL 就不会和归档中的旧历史冲突。.history 文件也要保留。
重放大致只运行在一个进程中,所以重放繁忙系统一周产生的 WAL 可能要花几小时。这就是为什么仍然要每天或每周做基础备份:每份备份都会限制重放范围,也就限制了 RTO。
关于 archive_timeout:60 秒时,最坏情况大约会丢失一分钟的数据;代价是每个安静但有过写入的分钟都会产生一个大多为空的 16 MB 段。还有上面告警所需的归档器计数器:
增量备份的好坏取决于它的链条
一个 2 TB 数据库的完整基础备份每次都要复制 2 TB,即使只有 20 GB 发生了变化。PostgreSQL 17 把增量备份加入了核心。
启用 summarize_wal = on(默认关闭)后,服务器会跟踪哪些块发生了变化。把上一份备份的清单交给 pg_basebackup --incremental,它就只复制这些块。pg_combinebackup 会把完整备份和它的增量备份链拼成一份可以恢复的完整备份。
问题在于这条链。每个环节都必须存在且完整;丢了周一的备份,周二的就没用了。逐个验证每个环节。
使用备份工具
手工构建一次 PITR,先理解它的工作方式。在生产环境中,使用 pgBackRest、WAL-G 或 Barman;它们都是开源项目,前两个使用得最广泛。每个工具都会压缩、加密 WAL,再将其上传到对象存储,并在上传失败时重试;并行执行完整和增量基础备份;清理过期备份,并且只清理不再需要的 WAL;还可以用一条命令恢复到指定时刻。
选一个,不要混用,并检查它是否有人维护:pgBackRest 的维护在 2026 年 4 月停止,在获得赞助资金后于 5 月恢复(pgBackRest news,截至 2026 年 10 月)。把备份存放在数据库服务器的凭据无法删除它们的位置(单独的账户、对象锁、版本化存储桶)。勒索软件和错误的清理脚本会以同样的方式删除备份。
托管备份仍需要一份由你掌握的副本
托管服务会内置快照、WAL 归档和“恢复到某个时间点”按钮。这个按钮有局限:恢复会创建一台新服务器,保留期是以天或周计的固定窗口,自动备份存放在实例自己的账户中,有时还会随实例一起删除。把快照复制到其他地方,并定期保留自己的 pg_dump,这是你唯一可移植的副本。备份是快照加 WAL,而恢复会创建新服务器说明了恢复按钮遗漏的内容。
测试恢复
备份会静默失败:归档命令失败了一周,生命周期规则删除了需要的 WAL,加密密钥留在已经损坏的服务器上,恢复要花 9 个小时而你的 RTO 只有 1 小时。你只能在恢复时发现这些问题,所以要在不得不恢复之前先恢复一次。
GitLab 的 2017 年 1 月故障 是标准教训。一名工程师以为那是备库,结果擦掉了主库的数据目录。随后每种备份都接连失败:pg_dump 一直静默失败(9.2 二进制文件连接 9.6 服务器),磁盘快照从未启用,而备库刚刚被擦掉以重新同步。一个六小时前的 LVM 快照花了大约 18 小时才复制回来,约 5,000 个项目丢失。纸面上每种方法都存在,但没有一种经过恢复验证。
把它自动化。按计划用正常流程把最新备份恢复到一台临时测试服务器,然后检查服务器能否启动、关键行数是否接近生产环境、最新一行的时间与目标恢复时刻之差是否在 RPO 允许范围内,以及 amcheck 在一部分索引上是否通过。为每一步计时:那才是你的真实 RTO。拆掉这台服务器,任何一步失败都要告警。
每年几次,让一个没有构建备份的人只依据运行手册来恢复。让他找出缺口,总好过让事故找出缺口。
“备份任务以 0 退出”不是证据。应针对最近一次成功基础备份的年龄、最近归档 WAL 段的年龄、不断升高的 pg_stat_archiver.failed_count,以及上一次自动恢复测试的结果设置告警。
及时采用小版本;演练大版本
升级属于本章,因为大版本升级就是一次由你安排的恢复:同样需要复制、回退方案和演练。小版本升级(18.5 到 18.6)保持磁盘格式不变:阅读发行说明,以防它要求重建索引;安装二进制文件并重启。大版本升级(17 到 18)会改变系统目录格式,所以新服务器无法打开旧数据目录。
跨越大版本有三种方式。转储并恢复适用于任何版本,也不会留下膨胀,但停机时间等于转储加恢复的全部时间,所以只适合小数据库。另外两种方式可以扩展到更大规模。
pg_upgrade –link 快速且只能单向进行
pg_upgrade 会建立新的系统目录并原样复用旧数据文件。使用 --link 时,它会创建硬链接而不是复制文件,所以 TB 级升级只需几分钟。代价是:新服务器一旦写入共享文件,旧集簇就不能再使用,因此回退方案只能是备份或副本。先做备份,并在正式操作前运行 pg_upgrade --check。
升级当晚有两个 PostgreSQL 18 的变化很重要。好的变化是:pg_upgrade 现在会迁移大部分规划器统计信息,因此之后的一小时里查询不会一直依赖猜测(来自create statistics的扩展统计信息仍需执行 analyze)。陷阱是:initdb 现在默认打开数据校验和,而 pg_upgrade 拒绝配对校验和设置不同的集簇。对于没有校验和的 17 集簇,应使用 initdb --no-data-checksums 创建新集簇。
副本也要规划:它们无法跨大版本跟随主库,所以要重建,或者按文档中的 rsync 流程升级。
| 模式 | 做法 | 速度 | 旧集簇之后是否仍可用? |
|---|---|---|---|
--copy(默认) | 复制每个文件 | 慢,需要 2 倍磁盘空间 | 是 |
--link | 为文件创建硬链接 | 几秒到几分钟 | 否,新服务器启动后不可用 |
--clone | 写时复制克隆(需要文件系统支持) | 快 | 是 |
--swap(PostgreSQL 18+) | 把数据目录移动到新集簇中 | 可能是最快的 | 否 |
之所以可以复用文件,是因为近几个大版本之间用户表和索引格式一直兼容;使用 --link 时,工作量取决于文件数量,而不是文件大小。要在旧集簇中打开校验和,而不是在新集簇中关闭它,请在旧集簇停机时运行 pg_checksums --enable;它会重写每个页面,所以停机时间取决于集簇大小,而不是文件数量。--no-statistics 会跳过 PostgreSQL 18 的统计信息传输,最后 pg_upgrade 会打印 vacuumdb --analyze-in-stages --missing-stats-only 命令,供你补齐未迁移的统计信息。
31-backups.sh逻辑复制把升级停机时间压缩到切换阶段
要实现最短停机时间,可以让新版本集簇通过逻辑复制订阅旧集簇:它会先复制每一行,再持续流式传输变更,直到你切换;切换只需几秒到一两分钟。代价包括:冻结模式变更(DDL 不会复制)、每张表都必须有主键或副本标识、通过网络完成一次完整复制,以及序列和大对象也不会复制。新集簇接管写入前,要把每个序列推进到旧值之后,否则第一条插入就会因键重复而失败。好处是得到一个没有膨胀的集簇,还能随时演练切换。一些托管服务把这叫作蓝绿升级。
先复制模式(pg_dump --schema-only),创建订阅并等待初始复制。然后在切换时:
- 停止向旧集簇写入(维护模式,或撤销写权限)。
- 等待订阅者追上(槽的确认位置等于旧主库当前的 WAL 位置)。
- 把新集簇中的每个序列推进到旧值之后,因为序列不会复制。
- 把应用指向新集簇。
无论采用哪种方式,都要先在生产环境的恢复副本上演练。
本章要点
- 先写下 RPO 和 RTO;它们决定你需要哪些备份。副本不是备份。
- 用
pg_dump -Fd -j N(或-Fc)做可移植、可选择性恢复的备份,再用pg_dumpall --globals-only备份角色(托管服务上加--no-role-passwords)。任何逻辑恢复后都运行analyze。 - 灾难恢复使用物理基础备份加持续 WAL 归档,通过 pgBackRest 或 WAL-G 之类的工具,把备份放到数据库主机无法删除的存储中。
- 要撤销人为错误,请在另一台服务器上恢复到某个时间点,设置
recovery_target_action = 'pause',再把数据行复制回来。 - 在
pg_stat_archiver报告失败时、pg_wal填满磁盘前发出告警。 - 增量备份自 PostgreSQL 17 起进入核心;验证链条中的每个环节。
- 自动执行恢复测试并测量真实 RTO。未经恢复验证的备份只是传闻。
- 使用
pg_upgrade --link获得速度,或用逻辑复制实现接近零停机的大版本升级(切换时推进序列);在 18 中留意校验和默认值。
延伸阅读
- Backup and Restore 和 Continuous Archiving and PITR,PostgreSQL 文档。完整流程,包括每个恢复目标设置。
- pg_basebackup 和 pg_combinebackup,PostgreSQL 文档。增量备份及其链条。
- pg_dump 和 pg_upgrade,PostgreSQL 文档。格式、并行处理、升级模式和副本流程。
- pgBackRest User Guide,pgBackRest 项目。完整且带有明确观点的生产备份操作指南。
- WAL-G 和 Barman。如果 pgBackRest 不合适,可选的其他广泛使用的备份工具。
- Postmortem of database outage of January 31,GitLab,2017 年。四种备份和复制方法都没能挽救局面;在相信自己的备份之前先读读它。
- amcheck,PostgreSQL 文档。在恢复副本中验证索引和堆的完整性。
33 不要信任任何租户
多数多租户应用靠反复写上一千遍的一行来隔离租户:where account_id = ?。它一直有效,直到有人写出第一千零一条查询却忘了这一条件,某个客户的仪表盘于是显示了另一个客户的数据。这不是性能问题,而是需要通报的数据泄露。
Postgres 可以在应用下面强制执行这条规则,让任何人都无法忘记它。这需要一个不拥有数据表的应用角色、有意授予的权限,以及正确且快速的行级安全策略。每一部分都有可能静默失效,我们会指出具体位置。
应用永远不以 postgres 连接
Postgres 只有一种主体:角色。“用户”是带有 LOGIN 的角色;“组”是不带该属性、由其他角色成为其成员的角色。
角色属于整个集簇,而不是某个数据库内部的对象,所以 pg_dump 会跳过它们(pg_dump 不包含角色;单独转储它们)。
角色属性是功能强大的开关(SUPERUSER、CREATEROLE、CREATEDB、REPLICATION、BYPASSRLS),应用角色不应拥有其中任何一个。Postgres 最常见的安全错误,是让应用以 postgres 或托管服务的管理员用户连接:每一次 SQL 注入都会变成完全沦陷,而且任何策略都不会生效(超级用户会绕过策略;托管管理员通常拥有数据表,也会因此绕过策略)。
把一个角色授予另一个角色后,被授予者就成为成员,并且默认继承被授予角色的权限。在创建新角色之前,先检查预定义角色,例如用于查看 观察数据库运行中那些视图的 pg_monitor,以及 pg_maintain(PostgreSQL 17+),它无需拥有数据表就能执行 vacuum 和 reindex。
从 PostgreSQL 16 开始,一次授权带有三个选项:inherit(自动使用该角色的权限)、set(可以通过 set role 切换到该角色)和 admin(可以把它授予别人)。因此,迁移角色可以有意成为所有者:
作为 wg_migrator 时,普通查询会失败,直到它执行 set role wg_owner:这正是模式变更所需要的“sudo”行为。(wg_analyst 是一个登录角色,通过普通的 grant wg_readonly to wg_analyst 成为成员。)其他值得了解的预定义角色还有 pg_read_all_data 和 pg_write_all_data(PostgreSQL 14+),以及用于取消查询的 pg_signal_backend。
32-security来自 MySQL 的读者会发现:MySQL 中的账户是 'user'@'host' 对,角色(8.0+)则是另一个可以授予账户的对象。在 Postgres 中,登录角色、组角色和所有者都是同一种对象,只是属性不同;主机规则位于 pg_hba.conf 中(Postgres 不是 MySQL)。
应用永远不拥有自己的数据表
所有者可以对自己的数据表执行 alter、drop,并授予任何权限,而且默认会忽略这些表上的行级安全。处理 Web 请求的进程不该拥有这些能力。因此,至少需要两个角色:
| 角色 | 登录 | 使用者 | 能做什么 |
|---|---|---|---|
| 所有者 / 迁移角色 | 仅迁移时 | 部署流水线 | DDL,拥有所有对象 |
| 应用角色 | 是 | 正在运行的应用 | 对获授权限的数据表执行 select、insert、update、delete |
| 只读角色(可选) | 通过成员角色 | 分析人员、BI 工具 | select |
所有者可以是 nologin,由迁移角色 set role 成为它(切换成它,像 sudo 一样,但只用于模式变更)。应用的连接字符串永远不包含所有者的凭据。
访问数据表需要两项授权
模式上的 USAGE 允许角色查看其中的对象;访问数据表则需要 USAGE 加上数据表权限:
只给所有数据表授权,会漏掉下周的数据表
grant ... on all tables in schema app 只覆盖当前已经存在的数据表。下周新建的数据表会返回 permission denied,于是有人会用“给所有人授予一切权限”来修复它。默认权限可以填上这个缺口:它们会应用于某个角色之后创建的对象。
现在,wg_owner 在 app 中创建的每个数据表都会带有正确的授权。本章创建了其中两张:app.projects 和 app.events,它们是示例表的副本,保留所有行但减少了列(没有 user 或 owner 列)。应用可以执行 select、insert、update 和 delete,仅此而已:不能 truncate,不能 alter,也不能 drop。
这些字母分别表示:a 为 insert,r 为 select,w 为 update,d 为 delete,D 为 truncate,x 为 references,t 为 trigger,m 为 maintain。应用拥有 arwd。
32-securityalter default privileges 只作用于执行该命令的角色所创建的对象(或者 for role 指定的角色所创建的对象)。如果迁移由另一个角色执行,新建对象就不会自动带上这些授权。始终以所有者角色创建对象,并在 psql 中用 \ddp 检查。
较旧的数据库仍允许任何人在 public 中创建对象
search_path(默认值为 "$user", public)决定 Postgres 查找未限定名称的位置。多年来,每个角色都可以在 public 中创建对象,这带来了经典攻击:在其中放置一个与特权用户会调用的函数同名的函数,然后等待。PostgreSQL 15 对新数据库取消了这一默认权限;除了数据库所有者之外的所有人都只有 USAGE:
升级或从旧版本恢复的数据库会保留旧授权:如果 \dn+ public 显示所有人都有 =UC,就执行 revoke create on schema public from public。对应用模式,在 SQL 中限定名称(app.events),或者为角色设置路径:alter role wg_app set search_path = app。
策略会让其他租户的行不可见
行级安全(RLS)会把策略附加到数据表上:Postgres 将布尔表达式加入每一次查询,因此策略不为真的行对读取不可见,也无法写入。
租户由自定义设置 app.account_id 表示,应用在每个请求中设置它;如果从未设置,current_setting(..., true) 会返回 null。没有单独的 with check 表达式时,using 同时控制读取和写入。
MySQL 没有行级安全;隔离由应用代码实现,或者由视图实现,而对基础表的查询可以绕过视图。这里策略附加在数据表上(Postgres 不是 MySQL)。
在 1,000 个账户共有 2,000,000 个事件的情况下,未设置租户的应用角色什么也看不到:
account_id = null 永远不会为真,所以所有行都会被隐藏。RLS 会在失败时拒绝访问,这正是你需要的失败方式。设置租户 42 后,它能看到自己的 2,084 个事件,看不到其他内容。明确指定租户 7 进行查询会返回零行,向租户 7 写入一行则会失败:
32-securityRLS 是检查机制;不可猜测的公开 ID 是检查缺失那一天的备用防线(计数器是在邀请攻击)。
外键会穿过策略查看数据
外键检查会绕过 RLS,所以租户 42 可以把事件关联到一个自己看不到的项目。修复方法是采用 让跨租户引用不可能发生中介绍的多租户键设计:把租户放进外键,使用 (account_id, project_id) 引用 projects (account_id, id),这样被引用的行必须属于同一个租户。
除非强制执行,否则 RLS 会跳过表所有者
RLS 默认不会应用于数据表所有者。在设置了相同租户的情况下,所有者查询 app.events 会返回全部 2,000,000 行。如果应用以所有者身份连接(ORM 的迁移工具共享同一个连接字符串时很常见),RLS 就会静默失效。执行 alter table app.events force row level security 后,所有者只能看到 2,084 行。
对每一张租户数据表都强制实施 RLS。它不会增加查询时的开销,却会约束所有以所有者身份运行的任务。所有者执行 pg_dump 时会报错退出,而不是转储出一张不完整的表;所有者在没有设置租户时执行回填 update,则会静默地修改零行。超级用户和带有 BYPASSRLS 的角色仍会跳过策略,因此要为备份以及有意进行的跨租户工作提供专用的 BYPASSRLS 角色,并明确使用这一绕过能力(备份部分见 pg_dump 不包含角色;单独转储它们)。
32-security应用以超级用户、带有 BYPASSRLS 的角色,或者未设置 force row level security 的表所有者身份连接。在这三种情况下,查询都会成功并返回每个租户的行。进行测试:使用应用的准确凭据连接,不设置租户,并确认查询租户数据表时返回零行。
连接池会泄露租户
连接池会把同一个服务器连接依次交给一个又一个请求(事务池模式会破坏会话状态)。为某个请求设置的会话租户会在请求结束后继续存在;下一个忘记设置租户的请求就会以之前那个租户的身份运行。即使 RLS 完全开启,也会发生跨租户泄露。
规则是:在事务内设置租户,并把它限定在该事务内。 set_config 的第三个参数就是作用域,true 表示“直到提交”,效果类似 set local:
有一个陷阱:提交之后,一个没有设置租户的请求得到的不是零行,而是 invalid input syntax for type bigint: ""。自定义设置一旦在会话中设置过,之后会恢复成空字符串,而不是“未设置”。访问仍会在失败时被拒绝,但忘记设置租户会变成一个 500 错误。要把空字符串当作缺失值处理:
然后让安全路径成为唯一的路径:由一个应用辅助函数开始事务,从绑定参数设置租户,执行请求,再提交事务。
32-security辅助函数使用 node-postgres:
租户是绑定参数,绝不能拼接进 SQL。每条查询都通过 db 执行;直接使用 pool 的查询没有租户,并且由于策略的存在,什么也看不到。应用代码使用 set_config(..., true) 比使用 SET LOCAL 更合适,因为 SET 不能接受绑定参数。
RLS 性能:策略就是谓词
策略就是 where 子句中的另一个条件(视图和策略只是文本替换),因此和其他条件一样需要索引。没有索引时,应用角色统计租户 42 的部署事件数量会读取 33,309 个页面:执行并行顺序扫描,按 kind 和策略进行过滤。每张租户表的主要索引都应以租户列开头:
现在,同一个统计只读取 2,036 个页面,策略也成了索引条件。查询租户最近的 20 个事件只读取 23 个页面,而且查询本身根本不需要提到租户。
让策略保持简单:策略中的子查询会加入对该表的每一次查询。每个请求只确定一次成员关系,并把结果设置为租户。
加索引之前:
加索引之后:
current_setting 是稳定函数,因此在索引条件中 Postgres 会计算它一次,再用这个值探查索引。在顺序扫描的过滤器中,它会对每一行执行。查询最新 20 个事件时,会在同一个索引上执行 Index Scan Backward,Buffers: shared hit=23。
32-security不具备 leakproof 属性的函数会在策略之后运行
Postgres 不会把每个条件都放在策略之前执行。某个函数的错误消息如果包含输入,就可能泄露你看不到的行;因此,任何没有标记为 LEAKPROOF(即承诺永远不暴露输入)的函数都会在策略之后运行,也不能在策略之前驱动索引扫描。text、bigint 和 timestamptz 上的 = 与 < 是 leakproof 的;like、ilike 和 jsonb 包含操作(@>)则不是。
代价是真实存在的。在 payload 上有一个 GIN 索引时,把租户写进查询的包含搜索读取了 434 个页面。通过策略执行时读取了 2,036 个:GIN 索引不被允许使用,所以规划器取出该租户的全部行再过滤。对最大的客户来说,这意味着每次搜索都要扫描它的全部数据。
修复方法是把这个字段提升为带类型的列,并使用具有 leakproof 属性的比较操作符。一个存储型生成列 duration_ms int,在 (account_id, duration_ms) 上建立索引后,只需四个页面就能回答同一个搜索。添加存储列会在 ACCESS EXCLUSIVE 锁下重写数据表,因此对大表要按任何重写操作来规划(每次变更都是目录编辑、扫描或重写)。
要以应用角色读取执行计划:超级用户根本看不到策略谓词。
以绕过 RLS 的 postgres 身份,并把租户写进查询:where account_id = 42 and payload @> '{"duration_ms": 1234}':
以应用角色身份通过策略执行:where payload @> '{"duration_ms": 1234}':
32-security生成列的修复方法。(另一条出路是把函数标记为 LEAKPROOF,但这需要超级用户权限,并且需要验证该函数绝不会抛出依赖输入的错误。)
SECURITY DEFINER 函数需要固定的 search_path
security definer 函数以其所有者的权限运行,就像 setuid 程序一样:对于“接受这份邀请”这类范围有限的操作很有用,却也是经典的权限提升入口。函数内部的未限定名称会通过调用者的 search_path 解析,因此调用者可以把自己的 count 放在最前面,让所有者执行它。固定搜索路径:
记住三点:固定 search_path,并把 pg_temp 放在最后;为每张数据表加上模式限定;撤销 execute 权限,使 public 不再拥有它(新函数默认对所有人可执行)。
强制 RLS 也会约束所有者,因此租户 42 调用 app.account_event_count(7) 得到 0;绕过 RLS 的所有者本来会返回租户 7 的数量。而且 definer 函数永远不会被内联,所以规划器看到的是一个黑盒(STRICT、SECURITY DEFINER 或 SET 子句会阻止内联)。
实验定义了第二个函数 app.unpinned_event_count,它与前者相同,但没有 set search_path 子句。然后,以 wg_app 身份在自己控制的模式中定义一个 count(*),其状态函数会记录是谁执行了它,并把该模式放在 pg_catalog 之前:
只有当路径没有写出 pg_catalog 时,它才会被优先搜索;把它写在后面就会把第一选择交给调用者。未固定路径的函数会以 wg_owner 身份运行冒牌函数。固定路径的函数会忽略调用者的路径,运行真正的 count,并返回 2,084。
32-security使用 scram-sha-256 和 verify-full,切勿使用 trust
上面所有内容都假设连接进来的正是正确角色。pg_hba.conf 决定谁可以连接、从哪里连接,以及如何证明身份。服务器会使用第一条同时匹配连接类型、数据库、用户和地址的规则:
hostssl 只匹配 TLS 连接,因此未加密连接根本不会匹配。使用 scram-sha-256,网络规则中永远不要使用 trust,并以明确的 reject 结尾。它的地址 all 也涵盖 IPv6,而 0.0.0.0/0 会漏掉 IPv6。
密码方面:scram-sha-256 从 PostgreSQL 14 起就是默认值;从 PostgreSQL 18 起,MD5 已被弃用,设置 MD5 密码时会发出警告。用 where rolpassword like 'md5%' 在 pg_authid 上找出旧角色并重置它们的密码。
TLS 方面:设置 ssl = on,并使用 sslmode=verify-full 连接,让客户端检查证书和主机名;require 会加密连接,却不能阻止冒充。托管数据库会提供 CA 证书包。
从服务器日志开始审计;它不额外收费
锁上的门仍然需要记录是谁打开了它。先从服务器日志开始:log_statement = 'ddl' 会记录每个 create、alter 和 drop 以及执行用户;有了所有者与应用角色的分离,日志中的任何 DDL 都来自迁移角色。连接也要记录。不要在繁忙的生产环境设置 log_statement = 'all':日志会迅速膨胀,并充满敏感值。
再看 TLS:哪些会话正在使用它:
对于合规级审计,使用 pgaudit。对于应用历史(“谁修改了这张发票”),在同一个事务中写入审计表(历史记录也是你要设计的表),并从应用角色撤销对它的 update 和 delete 权限。
然后在 CI 中检查权限。下面的查询会找出没有启用并强制执行 RLS 的租户数据表:
在迁移后的测试数据库上运行时,如果新建的租户数据表没有 RLS,它会让构建失败。在本章的设置中,它已经能找到一张:app.projects 从未执行 force。再增加一项检查,找出具有 rolsuper、rolbypassrls 或 rolcreaterole 的登录角色。
本章要点
- 应用以一个不是超级用户、没有
BYPASSRLS、也不拥有数据表的角色连接。迁移以单独的所有者角色运行。 - 使用
alter default privileges,让新数据表自动得到正确授权;在早于 PostgreSQL 15 创建的数据库中,撤销create权限在public模式上的默认授权。 - 对多租户隔离,在每张租户数据表上启用并强制执行行级安全,策略使用
account_id(备份和跨租户任务随后需要BYPASSRLS角色),并添加复合(account_id, id)外键,使引用无法跨租户。 - 在每个请求的事务内,通过一个辅助函数用
set_config('app.account_id', $1, true)设置租户;在策略中用nullif(..., '')包住它。 - 策略就是谓词:索引以租户列开头,让策略保持简单,并把你通过策略搜索的 jsonb 字段提升为带类型的列。
- 每个
security definer函数都应设置set search_path = pg_catalog, pg_temp,使用带模式限定的名称,并执行revoke execute ... from public。 - 使用
hostssl和scram-sha-256,把规则写在pg_hba.conf中;客户端使用sslmode=verify-full,并记录 DDL 和连接。
延伸阅读
- Row Security Policies 和 CREATE POLICY,PostgreSQL 文档。介绍宽松与限制性策略、按命令区分的策略,以及
using和with check的确切规则。 - Privileges 和 ALTER DEFAULT PRIVILEGES,PostgreSQL 文档。完整的权限模型,包括
\dp打印出的字母。 - CREATE FUNCTION,PostgreSQL 文档。如何安全地编写 SECURITY DEFINER 函数。
- A Guide to CVE-2018-1058: Protect Your Search Path,PostgreSQL Wiki。
search_path攻击,以及 PostgreSQL 15 为什么改变了 public 模式。 - Abusing SECURITY DEFINER functions,Laurenz Albe,CYBERTEC,2019。通过未固定的 search_path 实现权限提升的完整示例。
- The pg_hba.conf File,PostgreSQL 文档。每一种认证方法和匹配规则。
- pgAudit,pgAudit 项目。当服务器日志不够用时,执行语句和对象审计。
34 别人来运行这台机器
图表显示,读取 IOPS 已经整整一小时稳定在恰好 3,000。不是接近 3,000,而是恰好 3,000。延迟不断上升,应用请求超时,但仪表盘却显示数据库“健康”。没有东西坏掉。你买的是一块有上限的卷,而你的工作负载找到了这个上限。
这就是托管服务大多数时候的样子。服务商为操作系统打补丁、执行备份,并在凌晨 3 点提升备用实例。它不会替你选择索引,也不会调优 autovacuum。这些从来就不是服务器该做的事。它们是你的事,现在仍然是。这一章要讲的是两者之间的差异,先从究竟要把多少工作交给别人开始。
本章的服务商行为均引用各服务商截至 2026 年 10 月的文档;在据此构建方案前,请先检查链接。这里的服务只是用来说明机制,不是排名。选择一个你能离开的服务商一章保存了各厂商的具体数字。
能负担多少托管,就购买多少托管
把 Postgres 运行好是一项全职技能,而大多数团队没有任何人能全职负责它。能恢复的备份、不会脑裂的故障切换、升级、清理、连接池,以及有人响应的值班电话:每一项都是一份工作,而且每份工作都要有人完成。唯一的问题是由谁完成。
对大多数团队,我们的答案是:在预算允许的范围内,尽可能多地把这些工作交给别人。
托管是一个连续谱,不是开关
从你这边工作最多,到最少:
- 自托管在虚拟机或裸机上:完全的控制、完全的责任,以及值班电话。
- Kubernetes Operator(自我管理意味着你拥有超级用户和值班电话)自动处理副本、备份和故障切换;但你仍然要运行它下面的集群。
- 超大规模云厂商的托管服务(超大规模云厂商)负责机器运维、备份、备用实例和补丁更新,并给你一个管理员角色。
- 专业托管服务(专业托管 Postgres):承担同样的平台工作,并配备一个应该懂 Postgres 内部机制的支持团队。用一个真实问题来检验这一点。
- 托管加专家帮助:购买最高级别的支持,或聘请兼职 DBA,让一个调优过上千个数据库的人来看看你的数据库。
没有哪一级适合所有人。每一级都会把工作从你的清单移到别人的清单上,同时带来相应的价格。
无论谁运行这台机器,有些工作仍然是你的
下面是本书所教工作的分工方式。超大规模云厂商和专业服务商两列结果相同,所以合并成了一列。
再读一遍最后一行。每一列写的都是“你”,而这正是本书大部分内容。
“共同负责”掩盖了真实的分工。服务商执行备份,但只有你能证明你的恢复满足你的 RTO。服务商提升备用实例,但你的应用必须重新连接并重试。服务商会为坏掉的磁盘触发自己的告警,但你的值班范围仍然包括慢查询、锁队列和连接槽耗尽。
- **备份和 PITR:**Operator 会安排基础备份和 WAL 归档,而存储桶、生命周期规则和凭据由你负责。服务商负责归档和重放;你选择保留窗口,在窗口到期前发现错误,并把所有东西重新指向恢复所创建的新服务器。
- **故障切换:**Operator 依赖你运行的 Kubernetes 集群;服务商的提升操作仍然需要你的应用重新连接并重试。无论哪种方式,演练都由你安排。
- **升级:**Operator 会把你选择的版本滚动发布到副本中(有些会自动处理大版本;请检查你使用的 Operator)。服务商会在你选择的窗口内打小版本补丁,并在大版本升级时运行
pg_upgrade或蓝绿升级,而你要测试应用和扩展并运行analyze。 - **清理和配置:**服务商按实例大小而不是按最繁忙的数据表来设置默认值,并锁定部分设置。每张表的 autovacuum、
work_mem、超时和日志记录仍然由你负责。
专家帮助只能移动几个格子,永远不会变成“服务商”:
| 工作 | 仅托管服务 | 加支持合同 | 加兼职 DBA |
|---|---|---|---|
| 测试恢复 | 你 | 你 | 共同负责 |
| 清理和配置调优 | 你 | 共同负责(按需提供建议) | 共同负责 |
| 凌晨 3 点的事故 | 你,可向服务商升级求助 | 共同负责,按合同响应时间 | 共同负责,前提是其服务时间覆盖这一时段 |
| 查询、索引和模式审查 | 你 | 你,或通过工单获取建议 | 共同负责 |
自我管理消耗的是人员,而不是服务器
虚拟机是便宜的部分。自我管理需要本书整个运维部分所涉及的专业能力,还需要一个由多人组成的值班轮换,每个人都必须能恢复备份并提升副本。一个专家加一张假期日历就是单点故障。它还带来了足以让公司倒闭的故障模式:没有人通过恢复验证过的备份(GitLab,2017),或者两个主库同时接受写入。这些问题都不需要糟糕的工程师,只需要一项没人负责的工作。
用同一个单位计算两边的成本:
托管一侧的第二行永远不会变成零;表格最后几行的工作也永远不会离开你。但在服务器规模足够大、工作负载足够稳定并配有运维人员之前,人员成本通常远高于加价。计算你真正会花费的时间,而不是你希望花费的时间。
托管要付加价、控制权和退出成本
服务本身有价格,本章剩下的内容会逐项说明它:加价,而且 I/O 的计费方式有自己的故障模式;更少的控制权(没有超级用户,没有 postgresql.conf,没有Shell);服务商自己的日程;以及退出成本。对大多数团队来说,这仍然低于一套值班轮换。即便如此,也要把它写进账本。
托管不等于优化
服务商会让你的数据库持续运行,却不会让它变快。它不会注意到你的仪表盘查询为了返回 20 行而读取了 35,249 个页面,却会让你一键升级到更大的实例。更大的机器会掩盖查询问题,成本每月累积,而这个查询仍然排在列表顶端(赢得更大的机器)。
把运维工作交给服务商;设计工作留在自己手里
具体来说,尤其是在没有专职数据库工程师时:让服务商负责备份、PITR、故障切换、打补丁和硬件。条件允许时再加专家帮助;让专家花一个小时处理你最慢的查询,往往比升级一次实例更划算。
然后把自己的专业能力投入服务商无法替你完成的地方:查询、索引和模式设计。这是本书的大部分内容,也是收益最大的地方:上面的仪表盘查询加上第一个索引后,会从 35,249 个页面降到 91 个,而没有哪个服务档位会替你做到这一点。
只有在有具体理由、并且有人负责时才自我管理:例如规模大到加价足以支付一个团队、你能明确说出的控制需求、合规要求,或某个没有服务商提供的扩展。“纸面上更便宜”在把人员成本算进数学题之前都不算理由。并且这些选择都不是永久的;坚持使用社区 PostgreSQL 功能,你可以向任一方向迁移。
没有超级用户
所有托管服务都不会授予 SUPERUSER,改为给你一个管理员角色:rds_superuser、cloudsqlsuperuser、azure_pg_admin。原因是超级用户可以读取服务器文件,并以服务器操作系统用户的身份运行程序,这等于拿到了服务商机器上的 Shell。
预计 alter system、pg_read_file、copy ... to program、C 函数和不受信任的扩展都会失败,所以要在事故发生前测试运行手册中的命令。给监控和值班账号授予预定义角色(pg_monitor、pg_read_all_stats、pg_signal_backend),永远不要给它们管理员密码。
实验中的 mg_admin 只有 LOGIN CREATEROLE CREATEDB,没有其他属性。alter system、pg_read_file、pg_ls_dir、copy ... to program、create function ... language c、set log_min_duration_statement 和 create extension pg_visibility(不受信任)都会以 42501 失败;create extension hstore(受信任)则成功。没有 pg_read_all_stats 时,另一个角色的会话会把它的查询显示为 <insufficient privilege>。就连本书用来查看原始页面的 pageinspect,默认也只有超级用户可用。
33-managed33-managed截至 2026 年 10 月,各服务商的情况如下:AWS 的 rds_superuser 页面打印出 CREATE ROLE postgres WITH LOGIN NOSUPERUSER INHERIT CREATEDB CREATEROLE ...,并说明 rds_superuser 可以添加 RDS 的扩展、查看每个会话以及终止任意连接。Cloud SQL 的客户“无法创建或访问带有超级用户属性的用户”;AlloyDB授予 alloydbsuperuser。在 Azure 上,“只有 Microsoft 属于超级用户角色”(Microsoft)。Neon 的 neon_superuser 持有 pg_monitor 和 pg_signal_backend,并带有 ADMIN OPTION;Supabase 保留 supabase_admin 供自己使用。接下来,管理员角色应根据应用永远不以 postgres 连接一节创建所有者角色、迁移角色和应用角色。
设置位于参数组中
没有超级用户也意味着没有配置文件。你不能编辑 postgresql.conf;服务商会从控制台对象生成它(托管服务说明)。
静态意味着重启,而控制台不会替你完成重启
需要重启的设置就是“静态”设置。在 RDS 上,静态变更会停留在 pending-reboot 状态,而该状态“不会在下一次维护窗口中自动重启”(AWS),因此它可能等上几个月,最后与一次无关的重启一起生效。把静态变更集中安排在你选择的窗口内。
默认值不是本书中的默认值
服务商按实例大小而不是25% 规则来配置内存:Cloud SQL 将 shared_buffers 设置为内存的三分之一,Aurora 大约设置为三分之二。在假设之前,先读取 pg_settings。
每个角色的设置才是可迁移的工具
alter role ... set 不需要控制台,而且可以随你在不同服务商之间迁移。在迁移脚本中按角色保留超时、work_mem 覆盖值和 search_path;把控制台留给内存、日志和 autovacuum。
33-managedCloud SQL 的配置标志表会为每个配置标志标记“是否需要重启?”,并将 shared_buffers 设置为“实例 VM 总内存的三分之一”。Aurora会把它设置为 SUM(DBInstanceClassMemory/12038,-50003) 个 8 KB 页面。Azure 表示 shared_preload_libraries“需要服务器重启”(Microsoft)。RDS 的默认参数组不能编辑;先创建一个自定义参数组。在 pg_settings 中,source 表示某个值是由服务商设置的,还是由你设置的。
标记为 superuser 的设置,在有人执行 GRANT SET ON PARAMETER(PostgreSQL 15+)之前,不能按角色设置;这是服务商可以用来委托权限的钩子。在原生 Postgres 上,alter role mg_app set statement_timeout = '5s' 可以成功,而对 log_min_duration_statement 执行同样操作会以 42501 失败。
33-managed扩展来自允许列表
你只能 create extension 服务商已经编译并允许的扩展,而脚注和列表本身同样重要:版本可能落后、配置标志可能要求重启、后台工作进程可能缺失,或者功能只在付费计划中提供。在围绕某个扩展设计方案前,先检查它(每个扩展的用途),并在每次大版本升级后运行 alter extension ... update;扩展不会自动升级。
服务商会在 CREATE EXTENSION 上再加一道门
从 PostgreSQL 13 开始,受信任的扩展可以由拥有数据库 CREATE 权限的非超级用户安装。不受信任的扩展需要超级用户,这里意味着服务商,或者根本没人能装。服务商还会加上自己的门槛,而且默认值正好相反:RDS 允许所有可用扩展,Azure 则要先把扩展列入允许列表,默认什么都不允许。
| 扩展 | RDS | Aurora | Cloud SQL | AlloyDB | Azure | Neon |
|---|---|---|---|---|---|---|
pg_stat_statements | 是 | 是 | 是 | 是 | 是 | 是 |
vector | 0.8.2 | 0.8.2 | 0.8.5 | 0.8.2 | 0.8.2 | 是 |
pg_partman | 5.4.3 | 5.4.3 | 5.4.3¹ | 5.4.3 | 5.4.3 | 5.1.0 |
pg_repack | 1.5.3 | 1.5.3 | 1.5.2 | 1.5.3 | 1.5.3 | 付费² |
pg_hint_plan | 1.8.0 | 1.8.0 | 配置标志 | 配置标志 | 1.8.0 | 1.8.0 |
PostgreSQL 18 上的版本(RDS 和 Aurora 为 18.6)。¹ 没有后台工作进程。² 仅限付费计划。来源,2026 年 10 月:RDS、Aurora、Cloud SQL、AlloyDB、Azure、Neon;Supabase 列出了上表中除 pg_hint_plan 以外的所有扩展。Cloud SQL 的 pg_partman“不包含后台工作进程”(改为从 pg_cron 调用维护任务);pg_hint_plan 隐藏在 cloudsql.enable_pg_hint_plan(需要重启)或 alloydb.enable_pg_hint_plan 后面;Neon 的 pg_repack“仅在付费 Neon 计划中可用”;AlloyDB 无法启用 autoprewarm,因为你不能配置 shared_preload_libraries,所以autoprewarm 技巧无法使用。
pg_available_extension_versions 会为每个扩展显示 trusted。作为实验中的管理员角色,create extension hstore(受信任)可以成功,而 create extension pg_visibility(不受信任)会以 42501 失败。
33-managedRDS 的 rds.allowed_extensions 默认值为 '*',并且是动态设置(AWS);Azure 要求先在 azure.extensions 中“把扩展加入允许列表”(Microsoft);在 Cloud SQL 上,只有 cloudsqlsuperuser 成员可以创建扩展。AWS 说明扩展版本“不会在引擎版本升级流程中自动升级”。
现在,卷成了你的瓶颈
在托管服务上,你很少会先耗尽 CPU。你会先耗尽 I/O,因为数据库位于网络块存储上,而它有预置上限;这些数字比人们想象的更小:400 GiB 以下的 RDS gp3 卷基线是 3,000 IOPS,128 GiB 的 Azure Premium SSD 是 500 IOPS。
两个上限,你会撞上其中较低的那个
磁盘有一个上限,实例也有一个上限,而你得到的是其中较小的那个。
在小实例后面接一块更快的卷不会带来任何收益,而小实例的突发额度即使在流量没有变化时也会耗尽。
I/O 被节流时,会表现为 IOPS 持平而延迟上升
在 Postgres 内部,活动会话会等待 IO,主要是 DataFileRead(某个页面不在共享缓冲区中);可以多采样几次等待事件。在服务商的指标中,它就是本章开头所说的情形:IOPS 顶在某个数字上,而延迟和队列深度持续上升。然后按本书的顺序修复:少读页面,给工作集更多内存,最后才购买 IOPS。
截至 2026 年 10 月:RDS gp3 在 20 到 399 GiB 范围内提供 3,000 IOPS 和 125 MiB/s;从 400 GiB 开始会把四个卷条带化,提供 12,000 IOPS 和 500 MiB/s;gp2 每 GiB 提供 3 IOPS,并可突发到 3,000(AWS)。Azure Premium SSD 在 128 GiB 时提供 500 IOPS,并可“突发到最高 3,500”,512 GiB 时提供 2,300;v2 在任何容量都从 3,000 开始(Microsoft)。Cloud SQL 的 SSD IOPS 随机器类型和容量变化,并且“不能配置这些值”;Hyperdisk Balanced 在 20 到 256 GB 范围内默认提供 4,000 IOPS(Google)。Supabase 说得很清楚:“有效 IOPS 取计算规格支持的 IOPS 与磁盘预置 IOPS 中较低者”,其 Micro 计算规格的基线是 500 IOPS(Supabase)。AWS 警告某个实例“可能无法充分利用预置的 IOPS”;Microsoft 说 VM 类型“也有 IOPS 限制”;Google 说“机器类型决定上限”。
| 信号 | RDS(CloudWatch) | Azure |
|---|---|---|
| I/O 被顶在上限 | ReadIOPS、WriteIOPS、ReadThroughput | disk_iops_consumed_percentage |
| 请求排队 | DiskQueueDepth、ReadLatency | disk_queue_depth |
| I/O 突发额度正在耗尽 | BurstBalance(gp2)、EBSIOBalance% | disk_iops_consumed_percentage 接近 100 |
| CPU 突发额度正在耗尽 | T 类实例的 CPUCreditBalance | 可突发实例的 cpu_credits_remaining |
名称来自 AWS 和 Microsoft;AWS 的 IO:DataFileRead 页面描述了同一种等待。EBSIOBalance% 是实例的突发额度池:gp3 卷没有突发能力,但它前面的实例可能有。
分离式存储改变了部分规则
Aurora、AlloyDB 和 Neon 保留 Postgres 在缓冲区缓存以上的部分,并替换缓存以下的存储层:服务器把 WAL 发送到一个构建页面的分布式存储服务(这会如何改变基准测试)。Aurora 和 AlloyDB 跳过整页写入,因此检查点之后的 WAL 峰值会消失,所以不要照搬检查点调优指南。副本共享存储,而不是复制存储;I/O 可能成为一项费用;缓存未命中意味着一次网络读取。行版本、清理、膨胀以及规划器对页面的计数都完全不变。
截至 2026 年 10 月:
- Aurora 在三个可用区之间把写入复制到“六个存储节点”;副本读取同一个卷,延迟“通常远低于 100 毫秒”(存储、复制、HA)。它的参数参考中没有
checkpoint_timeout、max_wal_size或full_page_writes。Aurora Standard 按“每 100 万次 I/O 操作请求”收费;I/O-Optimized 不按此收费,并且当“你的 I/O 支出占 Aurora 数据库总支出的 25% 或更多”时是“最佳选择”。 - AlloyDB 把 WAL 写入“低延迟的区域日志存储服务”,因此“无需在数据库层执行检查点”,也不需要整页写入(Google Cloud 博客,2022)。
- Neon“在达到法定人数的 safekeeper 通过 Paxos 协议确认 WAL 记录后提交”,而 pageserver 会按请求重建页面(Neon)。缩容到零的计算实例唤醒时,缓冲区是空的(相关章节给出了具体时间)。读己之写仍然需要小心:延迟很小,但不是零。
服务商仪表盘是等待事件采样器
每个服务商的性能仪表盘都是等待事件画像,只是被采样并保存下来。用同样的方式阅读它:IO 条带意味着页面正在从存储中读取,Lock 条带意味着一个锁队列。修复点仍然在查询中。
“CPU”不是等待事件
每个仪表盘都有 CPU 条带,而 Postgres 没有名为 CPU 的等待事件。这个条带表示没有等待事件、处于 active 状态的会话:它们正在运行,或在等待操作系统调度器,因此数值可以高于核心数。
33-managed截至 2026 年 10 月:RDS Database Insights 每秒“采样同时运行查询的会话数量”,并将 CPU 定义为“在 CPU 上活动或正在等待 CPU”(AWS)。Cloud SQL Query Insights 只有 Enterprise Plus 才显示等待事件(Google),Google 还指出 CPU 负载“可以超过核心数上限线”。AlloyDB 将“CPU 和 CPU Wait”、“IO Wait”和“Lock Wait”分开显示(Google)。Azure Query Store 会采样等待,但在 Burstable 上不会采样,因为“会导致性能问题”(Microsoft)。仪表盘有保留期限;可观测性一章的 SQL 在任何服务上都能运行。
托管连接池要么固定会话,要么泄露状态
在事务模式中,会话状态要么会出问题,要么必须被跟踪(事务池模式会破坏会话状态),而托管连接池会选择其中一种处理方式。
RDS Proxy 会固定会话:一旦客户端改变会话状态(SET、预处理语句,甚至 nextval),它就会一直获得自己的服务器连接,直到断开连接。这样做是正确的,但你付费购买的多路复用就没有了;如果 ORM 在从连接池取出连接时设置一个变量,就会固定每个连接。Cloud SQL、Azure、Neon 和 Supabase 上的PgBouncer式连接池不跟踪 SQL 级会话状态(SET、PREPARE、咨询锁):多路复用完整保留,但状态会静默泄露。有些连接池会在服务商启用后跟踪协议级预处理语句,也就是大多数驱动发送的那一种。
无论是哪一种,都要知道自己使用的模式,并使用 SET LOCAL 和按角色设置。
截至 2026 年 10 月:RDS Proxy 还会在游标、LISTEN、临时表、会话级咨询锁和超过 16 KB 的语句上固定会话;如果连接池用 DISCARD ALL 重置,则所有连接都会被固定;请观察 DatabaseConnectionsCurrentlySessionPinned(AWS)。Cloud SQL 的连接池需要 Enterprise Plus,启用它“会导致数据库重启”;事务模式“不支持”SET、LISTEN 和 PREPARE(Google)。Azure 的 PgBouncer 1.25.2 将 pgbouncer.max_prepared_statements 设置为 0,“不支持 Burstable”,并且每次故障切换都会重启(Microsoft)。Neon 在 -pooler 主机名后运行 PgBouncer(Neon);Supabase 的事务模式“不支持预处理语句”(Supabase)。
备份是快照加 WAL,而恢复会创建新服务器
每项服务都按照备份一章所描述的方式构建时间点恢复:快照加归档 WAL。按钮确实有效。但它不会提醒你保留期是固定窗口(各服务商的窗口见超级用户访问和保留规则会排除哪些服务),最后几分钟的 WAL 可能还没发送出去,或者删除实例时可能会把自动备份一并删除。
恢复时间比按钮提示的更长
托管恢复会创建一台新服务器,因此应用、连接池、密钥和防火墙规则都必须跟着它走。数据可能还没有全部出现:RDS 会惰性加载恢复快照中的数据块,所以最初几小时的速度可能只有对象存储的速度。并且缓存是冷的。20 分钟后可用可能意味着四小时后才能投入生产。请对生产规模的数据计时恢复,把预热也算进去,并在服务商账户无法删除的位置保留自己的 pg_dump。
蓝绿升级就是逻辑升级,限制也会一并到来
原地升级会在停机状态下运行 pg_upgrade,并且可能带来意外:Cloud SQL 会“删除实例上所有现有的逻辑复制槽”,而 RDS 只能通过恢复旧快照回退。低停机路径是逻辑复制升级,RDS 将其作为 Blue/Green Deployments(蓝绿部署)出售。它的限制也会一起出现(冻结 DDL、每张表都要有主键),所以要在克隆上进行演练,让演练找出那张没有主键的数据表。
故障切换依赖 DNS,你的连接池必须注意到
故障切换是你付费购买服务商服务的主要原因。文档中给出的时间大多落在 30 到 120 秒之间,而所有连接都会断开。随后,大多数服务会让一个 DNS 名称指向新的主库(Cloud SQL 和 AlloyDB 则保留静态 IP);无论哪种方式,你的连接池都会继续持有失效连接,直到发现它们失效。你这边要履行的合同义务是:重新连接,而不是缓存旧地址(AWS 建议 JVM DNS TTL“不超过 60 秒”);重试整个事务;检查逻辑复制槽是否保留;并且要有意地、在工作时间内、按计划执行故障切换演练(要问的三个问题)。
| 部署方式 | 文档给出的典型故障切换时间 |
|---|---|
| RDS Multi-AZ 实例 | 通常为 60 到 120 秒 |
| RDS Multi-AZ 集群(两个可读备用实例) | “通常少于 35 秒” |
| 带副本的 Aurora | “少于 60 秒,通常少于 30 秒” |
| 不带副本的 Aurora | “通常少于 10 分钟” |
| Cloud SQL HA | 不可用,“大约六十秒” |
| AlloyDB HA | 检测“最多 30 秒”,然后“通常少于 30 秒” |
| Azure 可用区冗余 HA | “60 到 120 秒内且零数据丢失” |
来源,2026 年 10 月:RDS Multi-AZ、RDS 集群、Aurora、Cloud SQL、AlloyDB、Azure。AWS:“大型事务或漫长的恢复过程可能增加故障切换时间”。Microsoft:备用实例“通常以 40 MB/s 的速度恢复 WAL 文件”,并且从 PostgreSQL 17 开始,只要配置正确,向备用实例同步复制槽就由原生功能提供。RDS 和 Azure 会移动 DNS;Cloud SQL 和 AlloyDB 保留静态 IP。
不能 SSH 登录,所以要规划日志
没有 Shell 就没有 tail -f。日志存放在服务商指定的位置,并且只保留服务商规定的时长:RDS 默认保留日志文件 3 天,最多 7 天(AWS)。第一天就设置值得保留的日志,并把它发送到你能控制的地方,否则在事故复盘前证据就会消失。
账单也有自己的故障模式
托管定价会把性能问题变成账单项目,所以慢查询会出现两次:一次在仪表盘上,一次在发票上。在 Aurora Standard 上,每一次不必要的顺序扫描都会计入 I/O 费用。AWS 在可用区之间收取“每 GB 进出各 0.01 美元”(AWS,2026 年 10 月),因此应用从另一个可用区的副本读取时,每个结果集都要付费。
最昂贵的陷阱,是为了慢查询而升级的实例:关系一章中的删除操作,在没有索引时会读取 events 的全部 35,173 个页面,有索引时只读三个页面。RAM 会掩盖问题;索引可以修复它,而且每月不增加任何费用。
本章要点
- 尽可能购买你能负担的托管服务,把自己的专业能力投入查询、索引和模式设计。只有在有具体理由、并且有人负责时才自我管理。
- 托管不等于优化。用人员时间而不只是账单来比较两种方案。
- 没有超级用户:给监控和值班账号授予预定义角色,不要给它们管理员密码。
- 静态设置要等你安排的重启;把按角色设置写入迁移脚本。围绕扩展设计方案前,先检查扩展列表中的脚注。
- 你得到的是卷和实例 I/O 上限中较低的那个。IOPS 持平且存在
DataFileRead等待时,先减少读取的页面,最后才购买 IOPS。 - 知道你的连接池是在固定会话,还是会泄露状态。对真实恢复计时,在克隆上演练升级,并让应用在故障切换期间重新连接和重试。
延伸阅读
- Understanding the rds_superuser role,AWS 文档。RDS 管理员角色的确切属性及其能力。
- Avoiding pinning an RDS Proxy,AWS 文档。会固定 PostgreSQL 会话的完整事项清单,以及查看方法。
- RDS Blue/Green Deployments considerations,AWS 文档。蓝绿大版本升级中会遇到的每一项逻辑复制限制。
- PgBouncer in Azure Database for PostgreSQL,Microsoft 文档。托管事务连接池的设置和限制说明。
- Cloud SQL high availability,Google Cloud 文档。区域备用实例如何执行故障切换,以及故障切换期间应用会看到什么。
- Neon architecture overview,Neon 文档。Safekeeper、pageserver 以及基于法定人数的提交的含义。
- Predefined roles,PostgreSQL 文档。每个内置角色授予什么权限,以及如何在任何服务商上构建最小权限账号。
35 选择一个你能离开的服务商
两家服务商,同样的 4 vCPU 和 32 GB RAM,同样的基准测试。一家厂商公布的结果是自己每秒处理 18,000 次查询,对手则是 12,000 次。即便照单全收,这些数字也不能说明哪家的 PostgreSQL 更好。其中一家把页面放在机器内部的硬盘上,另一家则把它们放在网络另一端的存储上,而数据集大小是内存的十五倍。
服务商之间的差异大多如此。在缓冲区缓存之上,大家运行的是同一个引擎。在它之下以及周围,各家的选择不同:页面放在哪里,谁掌握超级用户权限,哪些东西要收费,以及离开有多难。
先决定购买多少托管,再决定向谁购买;能负担多少托管,就购买多少托管一节阐述了理由。之后我们的建议很简单:按你现有的工作负载选择,而且要选一个你能离开的服务。
厂商资料来自各服务商截至 2026 年 10 月的文档、价格页或博客,链接随文给出;据此设计方案前,请先检查链接。排列顺序不是排名,我们的观点会明确标出。版本方面:PostgreSQL 18 是最新正式版;19 在 2026 年 9 月 24 日发布了 Beta 4,项目表示正式版“也可能在 10 月发布”(PostgreSQL)。这里还没有服务商提供可用于生产的 19。
了解架构形态,就了解了取舍
每个选项都属于五种架构之一,或者是它们的混合;还没读功能清单,架构形态就能告诉你大部分取舍。
| 形态 | 页面存放位置 | 长处 | 代价 | 示例 |
|---|---|---|---|---|
| 传统托管 | VM 加网络卷 | 熟悉、可迁移 | 每次未命中都要走一趟网络 | RDS、Cloud SQL、Azure |
| 本地 NVMe | 机器内的硬盘 | 超出内存后仍然快 | 持久性由副本承担 | PlanetScale Metal |
| 存算分离 | 以 WAL 为输入的存储 | 副本共享存储,自动扩容 | 专有存储 | Aurora、AlloyDB |
| 无服务器 | 存算分离,可缩容至零 | 空闲成本低,支持分支 | 冷启动,繁忙时账单高 | Neon |
| 平台套装 | 上述任一种 | 认证、API、存储 | 应用的更多部分依赖同一家厂商 | Supabase |
大多数专业服务商也采用传统托管架构。
在虚拟机或 Kubernetes 上自行管理是第六个选项,可以采用前三种形态中的任一种。
存储决定基准测试结果
一家服务商在相同 vCPU 和内存下公布了另一家两倍的吞吐量时,先看磁盘。一旦工作集(working set)无法全部放入内存,页面的位置就决定了速度。
延迟一章列出了这个阶梯:内存是纳秒级,本地 NVMe 是几十微秒,网络存储则是几百微秒或更长。这个阶梯只在缓存未命中时才有意义(shared_buffers 是页的数组)。如果热点页面都能放进内存,这三种存储设计表现就差不多。
网络块存储:每次未命中都要一次往返
RDS、Cloud SQL、Azure 和大多数专业服务商把数据目录放在网络卷上,因此一次未命中内存的读取,就会变成发往数据中心其他位置的存储服务器的请求。卷有 IOPS 上限,而前面的实例往往有一个更低的上限:EC2 r8g.xlarge(4 vCPU、32 GiB)的突发额度耗尽后,只能持续提供 6,000 IOPS,不管你买的是什么卷(两个上限,你会撞上其中较低的那个)。
即便如此,它仍然有理由成为默认选择。卷的寿命不依赖实例,主机坏了只需重新挂载,无需重建。快照便宜,存储和计算可以独立扩缩容,甚至单个实例也能承受磁盘故障,因为底层存储会进行复制(但并非永远可靠:AWS 给 gp3 标出的年持久性是 99.8% 到 99.9%)。
本地 NVMe:快,但会随主机一起消失
实例存储就是同一台机器里的硬盘。AWS 给 i8g.xlarge 标出的性能是:同样的 4 vCPU、32 GiB,单块 937 GB 硬盘提供 150,000 随机读 IOPS,是网络路径 6,000 IOPS 的二十五倍。
代价是持久性。AWS 表示:“实例停止、休眠或终止后,数据不会保留。”因此,本地 NVMe 上的数据库要通过复制获得持久性,这会带来一些后果。一次提交必须到达另一个可用区的副本才算安全,这需要一次往返。丢失的节点要靠复制整个数据库来重建,TB 级数据需要数小时。而磁盘大小也与实例大小绑定:硬盘装不下了,就得迁移到更大的节点。
截至 2026 年 10 月,AWS 给出的数据如下:
- gp3 包含 3,000 IOPS 的基线(托管一章展示了触及该上限时的表现),最高可预置 80,000 IOPS 和 2,000 MiB/s,没有突发能力(AWS)。持久性标为“99.8% - 99.9%”(AWS)。
- io2 Block Express“设计目标是在 16KiB I/O 操作下提供低于 500 微秒的平均延迟”,在 Nitro 实例上可达 256,000 IOPS,标称持久性为“99.999%”,按预置 IOPS 收费。
r8g.xlarge的基线为 6,000 IOPS 和 156.25 MB/s,最高为 40,000 IOPS 和 1,250 MB/s;该档位的实例“每 24 小时至少能以最高性能持续运行 30 分钟,此后恢复到基线性能”(AWS)。i8g.xlarge在 4 KiB、满队列深度下,标称随机读 IOPS 为 150,000,写 IOPS 为 82,500(AWS)。AWS 提醒:“不要依靠实例存储卷保存有价值的长期数据”(AWS)。
Google 的 Local SSD“物理连接到服务器”,但“只能提供临时存储”(Google)。AWS 也会把本地 NVMe 用于更有限的用途:RDS Optimized Reads 将临时表放在本地存储上,使“查询性能最高提升 50%”,而数据仍留在 EBS 上(AWS)。
日志结构存储:发送 WAL,而非页面
Aurora、AlloyDB、Neon 和 Azure 的 HorizonDB(预览版)把 WAL 发送给据此构建页面的存储服务,因此写入要等待网络上达到法定人数的节点确认;读取未命中则要从网络获取数据,本地缓存能缓解这一开销。这会怎样影响调优,参见分离式存储改变了部分规则。选型时的差异在账单上:Aurora Standard 按每百万次 I/O 请求收费,AlloyDB 不收 I/O 费用,Neon 的本地缓存则可以溢出到 NVMe。
最知名的基准测试用十五倍于内存的数据测试存储
最知名的对比来自 PlanetScale,随其 Postgres 产品于 2025 年 7 月 1 日发布,截至 2026 年 10 月仍在它的基准测试页面上。在 32 GB 的机器上,用大约 500 GB 的数据库进行类 TPCC 测试,它报告自己在本地 NVMe 上约为 18,000 QPS,而 Aurora 约为 12,000。所有这些都是厂商公布的结果;我们没有复现过。
架构解释了这种表现。数据集是内存的十五倍,大部分读取无法命中内存:NVMe 上是一次本地读取,其他架构则要在 IOPS 限制之下走一次网络往返。PlanetScale 反过来在每次提交时承担网络开销,等待另一个可用区的副本,却省下了每次读取未命中的网络开销。竞争对手的回应也印证了这个物理事实:把热点页面放到本地闪存或内存中,网络的影响就会减小。
根据其方法说明文章:
- **被测系统:**PlanetScale 的
M-320,一个i8g节点(4 vCPU、32 GB RAM、937 GB 本地 NVMe),以一个主库和两个副本的形式分布在三个可用区;只有主库承载测试。 - **其他系统:**vCPU 和内存与之相当或更多的单实例,例如使用
db.r8g.xlarge的 Aurora 和 8 个计算单元的 Neon,它们都“使用网络附加存储”。 - **工作负载:**Percona 的类 TPCC sysbench 脚本,规模设为“产生约 500 GB 的 Postgres 数据库”,分别以 32 和 64 个连接运行 5 分钟;在“约 300 GB”的数据集上运行 sysbench 只读测试;以及反复执行
SELECT 1测量往返延迟。除连接数限制和超时外,设置“保持各平台的默认值”;成本对比则用它自己的三节点价格,与各对手加上副本后的价格比较。
PlanetScale 公布的主要类 TPCC 结果:自身约 18,000 QPS,Aurora 约 12,000(Aurora 页面),Neon 约 12,500(Neon 页面),AlloyDB、Crunchy Data、Supabase、TigerData 和 Heroku 则更低。只读测试中,PlanetScale 和 Aurora 都“约为 35,000 QPS”,PlanetScale 的 p99 更稳定。它的架构页面表示,变更会“由至少一个副本确认”。
- Xata(2025 年 7 月 16 日)在自己的 NVMe-over-Fabrics 网络存储上运行了这项测试,为本次测试调优 Postgres 后,8 vCPU、64 个连接下报告约 25,000 QPS,4 vCPU 下约 20,000。它称自己的图表“不是同等条件下的比较”,并批评了测试方法:运行前没有执行检查点或清理,默认配置未经调优,工作负载“写入非常密集”。PlanetScale 回应称 Xata 针对该工作负载做了调优,并拒绝提供访问权限让 PlanetScale 复现。
- Neon(2025 年 7 月 11 日)使用 NVMe 上 500 GB 的本地缓存重新测试,报告 17,030 QPS,而默认设置下为 12,512;若将缓存设为与工作集相当的 180 GB,峰值 QPS 低约 10%。它的反驳是:固定大小的本地磁盘会迫使你购买更高一档的实例。
读基准测试数字前,先问是谁跑的
这些问题适用于所有厂商的基准测试,包括那些让你喜欢的服务显得很好的测试:
- **谁跑的?**厂商会调优自己的产品,却测试对手的默认配置;每个数字旁都该写上“厂商公布”。
- **什么工作负载?**Percona 的 README 表示其脚本“不是 TPCC 工作负载的实现”,并要求厂商在对比中说明这一点(Percona)。
- **数据集与内存的比例?**十五倍于内存的数据集测试的是存储。生产环境通常会按工作集能装进内存的原则配置。
- **持久性和调优相同吗?**同步副本、基于法定人数的存储确认和单个卷提供的承诺不同,服务商的默认设置也有很大差异。
- **是否统一比较口径,能否复现?**每次查询的价格取决于档位、地域和副本数;公开脚本能让结论可验证。
用一天时间,在两个候选服务上运行你的模式和十条最重的查询,能获得比所有公开图表更多的信息(如何进行测试)。
迁移之前,先证明问题出在磁盘
基准测试能告诉你有更快的磁盘,只有自己的数据才能告诉你是否需要。对比工作集和内存(根据工作集配置内存)。采样等待事件:会话主要处于 IO / DataFileRead 等待,意味着读取已经离开了内存。在 pg_stat_statements 中按 shared_blks_read 排序(四种排名);通常是一条查询读取了大部分页面。还要寻找上限的迹象:IOPS 持平,延迟却不断上升(如何判断)。
然后依次尝试便宜的修复:减少读页、增加内存、预置 IOPS、更大的实例(先用数据证明,该换更大的机器了)。做完这些,存储读取仍占主导时,再换架构。
超大规模云厂商胜在覆盖面,代价是复杂度
每家大云厂商都销售传统托管服务和存算分离服务。它们胜在覆盖面:地域、合规计划,以及通往你在同一云上运行的其他一切服务的私有网络。代价是复杂度:账单上项目众多,大版本落后时还要支付延长支持费用。
截至 2026 年 10 月:
**Amazon RDS for PostgreSQL。**使用 EBS 的虚拟机,容量最高 64 TiB(AWS)。标准支持涵盖 14 到 18,当前版本为 18.6;19 仅出现在预览环境中,而且“不能将预览版本用于生产”(发布日历、预览);目标是在社区新大版本的第一个小版本发布后 30 天内提供该大版本。支持的扩展很多(AWS);可以选择“不承担读流量”的 Multi-AZ 备库,或具有两个可读半同步备库的集群(AWS);最多 15 个只读副本。没有超级用户时,通过 pg_dumpall --globals-only --no-role-passwords 导出角色,再手动重置密码。旧大版本转入付费 Extended Support,按 vCPU 小时收费,最长三年,备库也收费(AWS)。按实例小时、存储、额外 IOPS 和备份存储计价(AWS)。
**Amazon Aurora PostgreSQL。**一个跨三个可用区的共享卷,“可增长至 256 TiB”,最多承载 15 个副本(AWS)。2026 年 6 月 11 日开始提供 PostgreSQL 18;大版本的目标是在社区第一个小版本发布后的八个月内提供(AWS)。Global Database 可扩展到“最多 10 个只读的辅助 AWS 地域”,延迟“通常不到一秒”(AWS)。Aurora serverless 可“从 0 ACU 扩展至 256 ACU”,每个 ACU 约 2 GiB;13.15、14.12、15.7、16.3 及更高版本支持自动暂停(AWS、自动暂停)。Limitless Database 自 2024 年 10 月正式可用,提供分片(托管分片 Postgres)。迁出只能走逻辑方式,由 Aurora 充当发布者(AWS)。I/O-Optimized 不再按 I/O 请求计费,“每 30 天”可以切换一次(AWS;何时划算)。
**Aurora DSQL 是另一种数据库。**自 2025 年 5 月正式可用,基于 PostgreSQL 16,但隔离级别“固定为 PostgreSQL 的可重复读”,发生冲突会报错而不是等待,也没有临时表、触发器和 PL/pgSQL(AWS)。和那些分布式 SQL 数据库一样,采用它需要做一次迁移。
Google Cloud SQL。“每个 Cloud SQL 实例由一台虚拟机提供支持”,使用网络磁盘(Google);提供 9.6 到 18,默认为 18.6(Google)。从 16 起默认使用 Enterprise Plus,它增加了本地 SSD 缓存、读取池、“停机不到一秒”的维护、“最长 35 天”的 PITR 日志(Enterprise 为 7 天)和 99.99% 的 SLA(Google)。高可用模式会同步写入两个可用区的磁盘(Google)。延长支持自 2025 年 5 月 1 日起收费(Google)。按 vCPU 和内存计费,高可用价格翻倍(价格)。
AlloyDB。“跨多个可用区的存算分离架构”(Google),附有分析用的列式引擎(Google)。18 于 2026 年 3 月 18 日正式可用;大版本在社区正式发布后“五个月内”提供(Google)。连续备份保留 1 到 35 天,“RPO 为零”(Google);不收 I/O 费用(价格)。AlloyDB Omni 在你自己的数据中心、任意公有云或笔记本上运行同一套引擎,按 vCPU 授权(Google)。迁出要通过 pglogical 或 pg_dump 等逻辑方式(扩展、导出)。
Azure flexible server。“数据库引擎运行在 Linux 虚拟机内的容器中”,数据有“三份本地冗余的同步副本”(Microsoft)。存储最高 64 TiB(Microsoft);当前版本为 18.6(Microsoft)。提供“零数据丢失”的可用区冗余高可用、五个只读副本(Microsoft),以及“开源 Citus 扩展的托管服务”弹性集群(Microsoft)。在 18 上,“不能将服务器配置为使用新的异步 I/O io_method = io_uring”。Microsoft 表示,11 到 13 的延长支持自“2026 年 9 月 1 日”开始计费,且无法退出(Microsoft)。按 vCore 加存储计费(Microsoft)。Azure HorizonDB“目前处于预览阶段”,它才是存算分离的服务:“数据页不会从计算副本写入存储层”(Microsoft)。
专业服务商提供更贴近需求的支持,但地域更少
这些公司主要销售 Postgres,其他业务不多。我们的看法是:这种专注带来了 Postgres 专属功能和更贴近需求的支持,代价是可选地域较少,以及服务背后的公司规模较小。
仔细阅读高可用和备份条款;这里的差异远大于超大规模云厂商之间的差异:PITR 从 2 天到 30 天不等,备库也从热备到可能丢失最近提交的异步备库不等。在明确说明权限的服务商中,只有 Crunchy Bridge 提供超级用户。
截至 2026 年 10 月:
**Crunchy Bridge 和 Snowflake Postgres。**Snowflake 于 2025 年 6 月 2 日宣布计划收购 Crunchy Data;其后续博客表示“2025 年 6 月,Snowflake 收购了 Crunchy Data”(新闻稿、博客)。Crunchy Bridge 在 AWS、Google Cloud 和 Azure 上运行虚拟机,提供 15 到 18(2026 年 5 月起新集群不再提供 15),并给予“你的 Postgres 超级用户账户”(版本、用户);每 60 秒归档一次 WAL,保留 10 天;高可用“使集群价格翻倍”(HA、套餐)。Snowflake Postgres 于 2026 年 2 月 24 日正式可用,运行 16 到 18,提供 10 天 PITR,但其管理员“不是完整的 Postgres 超级用户”(Snowflake、角色)。
**Aiven。**运行在各大云上的虚拟机,提供 13 到 18,上游结束支持时相应版本也退役(Aiven);Business 有一个备库,Premium 有两个(Aiven)。“除少数例外,无法安装仅超级用户可用或不受信任的扩展”;按套餐保留 2 到 30 天的备份(Aiven);有免费档(Aiven)。
**EDB Postgres AI Cloud Service。**EDB“将不再向新客户提供 Hosted Cloud Service 选项”;继续提供在客户自己的云账户中管理集群的服务(EDB)。Advanced Server 现名为“Enterprise Postgres (Oracle Compatible)”(EDB),每 vCPU 小时的价格是社区 PostgreSQL 的三倍(EDB);它的 Oracle 功能无法迁移到社区 Postgres。
**Fly.io Managed Postgres。**每个套餐都包括“一个主库和副本、PgBouncer 和备份”,提供 16 和 17,容量最高 1 TB(Fly.io);Fly.io 将“安全补丁和版本升级”列为“开发中”。旧的非托管 Fly Postgres“已不再维护”(Fly.io)。
**PlanetScale Postgres。**2025 年 9 月 22 日正式可用:一个主库和两个副本跨可用区部署,可使用本地 NVMe(“Metal”)或网络存储,提供 17 和 18(正式发布、版本),通过逻辑复制提供 CDC(PlanetScale)。Metal“存储容量由实例大小固定”;备份默认“保留 2 天”(PlanetScale);Neki 分片“目前处于 Platform Preview”(PlanetScale);按集群大小定价(PlanetScale)。
Tiger Cloud。“Timescale 现已更名为 Tiger Data”(2025 年 6 月 17 日,Tiger Data):在 16 到 18 上运行 TimescaleDB(Tiger Data),面向超出建模一章中 BRIN 和分区能力范围的事件数据。“Tiger Cloud 不提供超级用户访问”(Tiger Data);PITR 为 3 或 14 天;按计算小时加存储收费(Tiger Data)。
**DigitalOcean。**提供 14 到 18(DigitalOcean),PITR 可回到“过去七天内”(DigitalOcean),没有超级用户。对新账户自 2026 年 10 月 15 日起,对全部账户自 11 月 30 日起,新建的 Standard Edition 集群“不能使用超过 4 GiB 内存的套餐,也不能添加备库或只读节点”;高可用移到更贵的 Advanced Edition。
**Render。**提供 13 到 18(Render);高可用由异步备库在 30 秒后接管(Render),这可能丢失最后几笔提交;PITR 为 3 或 7 天(Render);免费数据库“创建 30 天后到期”(Render)。
**Heroku Postgres。**Advanced 档采用“计算与存储解耦”架构,容量最高 100 TB,目前处于“有限正式可用”阶段(Heroku、Advanced);默认版本为 18(Heroku)。所有者“比超级用户低一级”(Heroku);故障切换可能丢失“少量但有明确上限的最近已提交数据”(Heroku)。2026 年 2 月 6 日,Heroku 表示正在“转向以维护为主的工程模式……而不是引入新功能”(Heroku)。
无服务器平台围绕开发者的日常工作优化
它们的卖点是:数据库空闲时不花钱,每个拉取请求都能创建一个分支,有时还提供围绕数据库的一整套后端。代价是冷启动、难以预测的按单位用量计费,以及在平台套装中,应用更多部分与同一家厂商绑定。
截至 2026 年 10 月:
**Neon。**计算与存储由“一条预写式日志(WAL)记录流”连接,现在以 Lakebase Postgres 为品牌(Neon);Databricks 于 2025 年 5 月 14 日宣布计划收购 Neon,而 Neon“已是 Databricks 平台的一部分”(Databricks)。提供 14 到 18(Neon)。空闲 5 分钟后缩容至零,“几百毫秒内”唤醒(Neon);可“从当前或过去的状态”创建分支(Neon);恢复窗口按套餐最长为 30 天。大版本升级意味着新建项目;保持连接的逻辑复制订阅者会使计算实例保持唤醒,非活动的复制槽约 40 小时后会被删除(Neon)。按计算单元小时计费,有免费套餐(Neon)。
**Supabase。**每个项目一个 Postgres 实例,配上一套平台服务:Auth、通过 PostgREST 提供的 REST API、Realtime、Storage 和 Edge Functions(Supabase),运行 PostgreSQL 15 或 17(Supabase)。基于行级安全构建,有文档说明如何通过逻辑复制向外传输数据(Supabase)。分支“默认不含数据”(Supabase);PITR 是附加服务,至少需要 Small 计算规格;无需清理的存储引擎 OrioleDB“处于公开测试阶段”(Supabase)。套餐加计算加用量计费(Supabase)。
Xata。“原生支持分支的 Postgres”:每个分支都是“底层逻辑卷的写时复制快照”(Xata),支持匿名化克隆;提供 14 到 18(Xata);可运行在 Xata 的云、你的云,或自托管环境中(Xata)。只能原地进行小版本升级;Xata 的公开文档没有描述备份或 PITR。
**Nile。**面向多租户 SaaS 的 Postgres:每个存储页属于一个租户,租户可以放在共享或专用计算实例上(Nile),也就是分片一章里手动完成的事情。只提供 PostgreSQL 15,而且租户表上不支持用户定义函数、触发器和序列(Nile)。
**Railway。**不是托管服务:它的模板是“非托管服务”,备份、调优、安全和监控“由你负责”(Railway)。可选 Patroni 高可用(Railway);备份是卷快照,并非基于 WAL 的恢复(Railway)。
还有规模更小的服务,例如按操作次数计费的 Prisma Postgres(Prisma)。
自行管理,超级用户和值班电话都归你
在虚拟机或 Kubernetes 上自行管理,意味着你有超级用户、能用所有扩展、可以在发布当天使用任意版本,而且在规模大且稳定时成本最低。代价是值班轮换,复制和备份章节中的所有工作都归你。标准组件是用 Patroni 做高可用,用 pgBackRest、WAL-G 或 Barman 做备份,在 Kubernetes 上使用 CloudNativePG 等 Operator。
截至 2026 年 10 月:
- Patroni:“一个用于构建 PostgreSQL 高可用(HA)集群的 Python 模板”,用 etcd、Consul、ZooKeeper 或 Kubernetes 进行领导者选举;MIT,支持 PostgreSQL 9.3 到 18(GitHub)。
- **pgBackRest:**向 S3、Azure 或兼容 GCS 的存储执行全量、差异和增量备份,支持 PITR(pgbackrest.org)。维护者于 2026 年 4 月 27 日宣布“不再维护”,随后在 5 月 18 日宣布“一个赞助商联盟已联合起来,资助后续开发”(新闻)。
- WAL-G(Apache-2.0)和 Barman(GPL-3.0)(WAL-G、Barman)。
- **CloudNativePG:**一个“直接与 Kubernetes API 集成”而不使用 Patroni 的 Operator;Apache-2.0,自 2025 年 1 月起成为 CNCF Sandbox 项目,通过其 Barman Cloud 插件执行备份(GitHub、CNCF)。
- **Crunchy Postgres for Kubernetes(PGO):**Patroni 加 pgBackRest,Apache-2.0;其默认镜像受 Crunchy Data Developer Program 条款约束,所以先读这些条款(GitHub)。
- **Zalando postgres-operator:**通过 Spilo 镜像使用 Patroni,MIT,支持 PostgreSQL 14 到 18(GitHub)。
- **StackGres:**AGPL-3.0,基于 Patroni,带有 Web 控制台和大量扩展(StackGres)。Percona Operator for PostgreSQL“基于 Crunchy Data 开发的 Postgres Operator”,Apache-2.0(GitHub)。
超级用户权限和保留期限可以排除一批服务
下面把主要服务列在一张表中,时间截至 2026 年 10 月,来源见各服务条目。“版本”指新建数据库可选的大版本。重点看那些能帮你排除服务的列:只有一家给你超级用户,备份保留期限则从两天到五周不等。
| 服务 | 形态 | 版本 | 超级用户 | PITR 窗口 |
|---|---|---|---|---|
| RDS | 传统 | 14 到 18 | 无 | 0 到 35 天 |
| Aurora | 存算分离 | 14 到 18 | 无 | 1 到 35 天 |
| Cloud SQL | 传统 | 9.6 到 18 | 无 | 7 或 35 天 |
| AlloyDB | 存算分离 | 14 到 18 | 无 | 1 到 35 天 |
| Azure | 传统 | 14 到 18 | 无 | 7 到 35 天 |
| Crunchy Bridge | 传统 | 15 到 18 | 有 | 10 天 |
| PlanetScale | NVMe 或网络 | 17、18 | 无 | 默认 2 天 |
| Neon | 无服务器 | 14 到 18 | 无 | 最长 30 天 |
| Supabase | 套装 | 15、17 | 无 | 附加服务 |
Supabase 的每个套餐都有每日备份;时间点恢复是附加服务。Azure 仍然为现有服务器运行 11 到 13,但属于付费延长支持。
用排除法选择
按顺序回答这些问题。前几个答案就会排除列表中的大多数服务。
- **多大,增长多快?**检查存储上限(Fly.io Managed Postgres 为 1 TB,RDS 和 Azure 为 64 TiB,Aurora 为 256 TiB)、磁盘是否与实例大小绑定,以及你的工作集与能负担的内存之间的关系。
- **写入多少?**写入关注提交延迟和 WAL 量;读取关注副本和缓存未命中。
- **需要超级用户或某个特定扩展吗?**核对确切版本和脚注。需要超级用户,选项就缩小到 Crunchy Bridge、你自己的容器,或自行管理。
- **有什么合规要求?**认证和数据驻留情况随服务商和地域而异。索要报告,不要只看一墙的标志。
- **哪个地域?**应用所在的地域。跨地域往返会抵消本书中其他一切优化(往返的成本比查询更高)。
- **RPO 和 RTO 是多少?**先写下来:异步高可用可能丢失最近的提交,2 天的 PITR 窗口也无法挽回第 3 天才发现的错误。
- **采用哪种预算模型?**固定实例的费用可预测;按用量计费的计算资源空闲时便宜、忙碌时可能令人意外;按 I/O 定价的存储会让你为缺失的索引付费。
- **如何离开?**签约前先回答下一节的问题。
我们的看法是:今天起步的大多数团队,选择应用所在云上的传统托管服务,并配置足够内存容纳工作集,就能用得很好。只有能明确说出本地 NVMe、存算分离或无服务器替你解决什么问题时,再去选择它们。
在需要退出之前规划退出
每个服务商都让迁出成为可能,但很少有服务商让它变得容易。成本取决于你的系统有多少部分使用了 PostgreSQL 之外的东西。
社区 Postgres 能干净地迁走
只要坚持使用社区 PostgreSQL 和社区扩展,模式、数据、角色(大部分)和 SQL 都能跟你走。有两条迁移路径。
pg_dump(pg_dump)在哪里都能工作,但在它所需的数小时内,数据库要么只读,要么两边的数据开始分歧(逻辑备份);角色可能需要脚本处理,因为 pg_dumpall 需要超级用户。
逻辑复制,然后切换(逻辑复制),只需停机几分钟而不是几小时,前提是原服务商允许你发布数据。RDS、Aurora、Cloud SQL、AlloyDB(通过 pglogical)、Azure、Neon、Supabase 和 PlanetScale 都有相应文档;注意它的限制。
专有存储、功能和配套集成带不走
- **专有存储。**Aurora、AlloyDB 和 HorizonDB 在你带不走的存储上运行 Postgres,只能通过逻辑方式迁出。AlloyDB Omni 是部分例外,它把同一套引擎授权给你在自己的机器上运行。Neon 的存储是开源的,但自行运行它本身就是一项工程。
- **专有功能。**EDB 的 Oracle 兼容语法、AlloyDB 用于分析的列式引擎、Aurora 的 Babelfish(SQL Server 协议兼容),以及 Aurora Limitless Database 的分片表。使用它们没有问题,但每一项都要计为将来重做的工作。
- **平台服务。**Supabase Auth、Storage 和自动生成的 API;Heroku 的附加服务集成;Nile 按租户存储的模型。数据可以用
pg_dump导出,围绕它构建的应用却不能。 - **服务商扩展、角色和配套集成。**某家服务专属的扩展、
rds_superuser之类的角色、仪表盘、IAM 认证、私有网络、备份策略。这些不是代码,却要花数周来处理。
留好退路
- 坚持使用社区 PostgreSQL 功能,除非某项专有功能值得付出退出成本,并且要把这个决定写下来。
- 定期进行逻辑导出,存到服务商账户无法删除的位置,每季度在别处恢复一次。这样既演练了退出,也获得了经过验证的备份。
- **现在就检查发布支持:**让一台由你控制的原生 PostgreSQL 服务器订阅预发布环境。
- **保持大版本更新。**每个大版本支持五年:13 于 2025 年 11 月 13 日结束支持,14 将于 2026 年 11 月 12 日结束支持(PostgreSQL)。延长支持会向落后的版本收费,而较新的版本会让你有更多迁移去处。
本章要点
- 在缓冲区缓存之上,各服务商运行的是同一个 PostgreSQL。在它之下,一旦工作集超过内存,页面的位置就会主导基准测试结果。
- 网络存储每次未命中都要一次往返,但不会随主机故障消失;本地 NVMe 每次读取要快得多,却会随主机一起消失。
- 把每个公开基准测试都视作厂商公布的结果,并用自己的查询跑自己的测试。
- 为更快的存储而迁移之前,先证明读取占主导:对比工作集与内存,检查
IO等待和shared_blks_read。先修查询,再加内存。 - 超大规模云厂商胜在覆盖面,专业服务商胜在专注 Postgres,无服务器平台胜在空闲成本和分支。选定之前,找出各家文档中的限制。
- 依次按数据大小、写入量、扩展与超级用户需求、合规、地域、RPO 与 RTO,以及预算模型进行选择。
- 提前规划退出:能向外进行逻辑复制,定期执行由你控制的
pg_dump,并列出所依赖的全部专有功能。
延伸阅读
- Amazon EBS volume types,AWS 文档。各类网络卷的 IOPS、吞吐量、延迟和持久性。
- Amazon EBS-optimized instance types,AWS 文档。往往最先限制性能的各实例存储性能上限与突发窗口。
- Data persistence for instance store volumes,AWS 文档。本地 NVMe 数据究竟在什么时候消失。
- Benchmarking Postgres,PlanetScale 博客。最常被引用的服务商对比背后的方法;阅读时要带上前面提到的注意事项。
- Reaction to the PlanetScale PostgreSQL benchmarks,Xata 博客。竞争对手对同一方法的批评,以及支持高速网络存储的论据。
- sysbench-tpcc README,Percona。按作者自己的说法,这个最常用的类 TPCC 脚本是什么,又不是什么。
- Logical replication,PostgreSQL 文档。选择任何服务商时都应核对的退出路径。
- Versioning policy,PostgreSQL。每个大版本五年;各服务商的支持日程都依赖这些日期。
36 先优化工作,再升级机器
我们拿了一个小应用的工作负载,在一台笔记本上对本书的示例数据运行,每次只改一件事。同一台机器,同样的数据,同样的请求。最初每个事务读取 91,448 页,每秒完成 13 个事务。八次改动之后,每个事务读取 38 页,每秒运行一万多个事务。
这些改动没有一项是换更大的机器,也没有一项是加副本、做分区或换数据库。它们是三个索引、两次改写、一个表设置、把二十一条查询换成一条、一个连接池、几项配置,以及一张汇总表。
机器从来就不是问题所在。
这就是本章的主张:让 Postgres 变快,主要在于顺序。找出昂贵的工作,从成本最低的地方修起,每改一项都测量。硬件排在接近末尾的位置,横向扩展在那之后。
顺序就是方法
下面各节是可以采取的优化手段,按每投入一小时通常能获得的收益排序:便宜、收益大、容易撤销的在前;昂贵、收益小、难以撤销的在后。测量证明没有问题的项目可以跳过,但不要越级去做后面的事。
这份排名不是自然定律:一个有 3,000 个未使用连接池的客户端的系统,应先加连接池,再动索引。因此,第 1 项是测量。
整张清单都遵循两条规则。每次只改一件事,改动前后测量相同的工作负载(只改一件事,并端到端测量)。数页面,不数毫秒:每次调用访问的页面数在不同运行间几乎不变,因此即使机器上有干扰,它也能告诉你改动起了什么作用(缓冲区才是证据)。书末的检查清单也采用这个顺序,每个习惯一行。
1. 找出昂贵的工作
你正在想的那条慢查询,往往不是代价最高的那条。按总时间和每次调用的块数对 pg_stat_statements 排序,采样等待事件,判断会话是在工作、读取还是排队。然后在动手修改之前写下一句话:“我们的瓶颈是 X,因为 Y 显示了 Z。”
**相关内容:**用四种方式给同一视图排序,先看总时间、采样等待,看看时间花在哪里、慢查询的方法。
2. 修查询和索引
大多数收益都在这里。为了返回 20 行而读取 35,000 页的查询,问题是缺少索引,或谓词无法利用索引;修复只需一行 DDL 或改一下 where:本书的第一个索引就把一条查询的读取量从 35,249 页降到 91 页。深度 OFFSET 分页也属于这里:它会读取跳过的每一行,而键集分页(keyset pagination)只读取要返回的那一页。信号是:每次调用的块数很高,Rows Removed by Filter 远大于返回行数。
**相关内容:**从查询出发设计索引,而不是从列出发、保持索引列裸露、OFFSET 会读取它跳过的每一行、错误计划有四种原因。
3. 修模式
模式会长久地决定每行数据要花多少页面。可用的手段包括:窄类型、按对齐要求排列列顺序,把 8 字节类型放在前面(某张表上节省了 27%)、顺序键或 UUIDv7 键,以及适合 HOT 更新的表。它排在查询之后,只是因为重塑一张大表需要做迁移,不能只发一次版。信号是:HOT 占比低、行宽、每次插入产生的 WAL 量。
**相关内容:**每个字节都要按行付费、慎选键,少后悔、HOT 是一次性做出的设计决定。
4. 减少往返
一个请求发出 21 条很快的查询,就要付出 21 次往返的代价,而 pg_stat_statements 永远不会为它亮红灯,因为没有哪一条语句很慢。修复方式都是“更少、更大的语句”:用连接或 lateral 代替 N+1 循环,用批量写入代替每行一次插入。信号是:每个请求的查询数。
**相关内容:**N+1 是一个循环,不是慢查询、快速加载数据。
5. 保持清理和统计信息健康
这属于日常维护,不是调优。一旦落后,前面所有手段都会失效:死行会增加每次扫描的工作量,陈旧统计信息则按一张已经不存在的表来规划。信号是:n_dead_tup、最老事务的年龄、Heap Fetches。
**相关内容:**对大表来说,默认值不对、清理无法移除旧快照可能需要的内容、自动清理的分析会漏掉三类变化。
6. 使用连接池
每个连接都是一个进程。每个请求都新建连接,就要每次承担 fork、认证和冷缓存的代价;让几千个连接保持打开,就要付出内存和争用的代价。使用连接池,按核心数而不是用户数来确定池大小。信号是:连接速率,以及按状态统计的连接数。
**相关内容:**每个连接都是一个进程、根据核心数而不是用户数确定连接池大小。
7. 调整配置
配置为工作分配资源预算。它不能让查询少读页面:一次扫描要读 35,000 页,无论 shared_buffers 设为多少,都还是 35,000 页。它能做的是解除上限,因此要在你能说清上限在哪里时才调:临时文件、请求触发的检查点、未命中缓存的工作集。
**相关内容:**内存:先做预算,再调优、从这份 4 vCPU、16 GB 配置开始,然后测量。
8. 预计算与缓存
当每条查询都只读取所需数据之后,就别再把同一个昂贵的问题问两遍了。这一步排得这么靠后,是因为汇总表(rollup)或缓存都是同一份事实的第二份副本,需要持续维护它的新鲜度。信号是:每次调用的块数随租户规模增长。
**相关内容:**预先算好要展示的内容、把工作移出请求路径。
9. 购买耗尽的资源
现在,而且只有到现在,才轮到机器:购买测量表明已经耗尽的资源,而不是直接升到下一档。
**相关内容:**用数据争取更大的机器、迁移之前,先证明问题出在磁盘。
10. 只有相应信号出现时,才横向扩展
副本、分区和分片各自都带有永远不会消失的代价,因此每一种都要等到自己的信号出现。
**相关内容:**证据说到头了,纵向扩容才算到头。
以下是典型结果;有测量数据的地方,采用本书的测量。你的收益取决于起点离合理状态有多远。
| 手段 | 典型收益 | 投入 | 撤销 |
|---|---|---|---|
| 查询和索引 | 语句读页量的缩减倍数为 10 到 1,000 | 几小时 | 删除索引 |
| 模式 | 页数最多减少约 30%;非 HOT 更新更少 | 一次迁移 | 再做一次迁移 |
| 往返 | N 条查询变成 1 条;延迟的降低幅度取决于网络距离 | 一次代码改动 | 容易 |
| 清理和统计信息 | 防止性能衰退;修正坏计划 | 按表设置 | 容易 |
| 连接池 | 每个请求都建连接时,吞吐量达到原来的 5 到 70 倍 | 一天 | 容易 |
| 配置 | 消除上限;页面数不变 | 几小时,可能需要重启 | 容易 |
| 汇总表和缓存 | 聚合工作量不再随数据增长 | 几天,再加新鲜度维护 | 中等 |
| 更大的实例或存储 | 为耗尽的资源增加余量 | 每月付费 | 缩回原来的规格 |
| 副本 | 读容量;故障切换 | 几天,再加路由 | 中等 |
| 分区 | 低成本的保留期管理和清理 | 一个迁移项目 | 困难 |
| 分片 | 写入和存储容量 | 数月 | 很困难 |
去哪里寻找表明下一项该做什么的数字:查询和索引看 pg_stat_statements 与 EXPLAIN;模式看 pg_stat_user_tables 与 pg_column_size;往返看应用追踪;连接看 pg_stat_activity 和连接池统计;配置看日志和 pg_stat_checkpointer;汇总表看 pg_stat_statements 随时间的变化;硬件看等待采样和 pg_stat_io;分区看 pg_stat_progress_vacuum;分片看 pg_stat_wal 和写入等待。
实证:一个应用,八次改动
写一张清单不费什么事。所以我们拿本书的示例数据实际跑了一遍:同一份工作负载,按照这份操作指南的顺序,每次只调整一项,每次改完都测量。下面的每个结论,在实验中都有对应检查。
这个应用有四个端点,写法都是第一版常见的样子。仪表盘按天统计某个账户 30 天内的事件,筛选条件里有类型转换(created_at::date >= ...)。动态列表使用 OFFSET 分页。项目页加载 20 个项目,再分别为每个项目发送一条查询,获取其最新事件:这就是 ORM 替你写出的 N+1 循环。摄入端点插入一条部署事件,并递增项目计数器。而且应用每个请求都会新建连接,就像一个无服务器函数。events 最初只有主键。
页面数是确定的:你得到的数字应该只相差几个百分点。吞吐量属于我们的笔记本,而且在性能较高的阶段,实验各次执行的结果会相差两到三倍,所以表中并排列出了两次完整执行的结果。实验只验证差距足够大的变化方向。
实验还设置了 synchronous_commit = off,因为在 Docker Desktop 中,每次提交的刷新都要几十毫秒,会淹没其他所有效果。这样会抬高吞吐量,尤其是写入吞吐量,但它改变的是提交等待多久,不是读取了多少页面(提交意味着刷新)。在真实磁盘上启用持久提交后,预计数字会更低,但变化趋势相同。
每个端点都对应一份 pgbench 脚本,位于实验的 workload/playbook 文件夹中,按权重混合:30% 仪表盘、30% 动态列表、10% 项目页、30% 摄入。
每个请求新建连接,就是 pgbench -C。每次运行都按相同顺序发送相同请求。“每个事务的页面数”是各端点语句的 shared hit 加 read,除以其事务数,再按混合权重加权。
每次 pgbench 运行都用 4 个客户端。在实验的一次完整执行中,基线只运行一次,总共 120 个事务,因为它很慢;添加索引的步骤运行一次,共 1,000 个事务;后续每个步骤都运行三次,每次 4,000 个事务,吞吐量取三次的中位数。整个实验耗时两分半到四分钟,所以较快步骤的一次运行只有一两秒,这也是吞吐量波动的部分原因。结果表中的每个吞吐量列,都代表实验的一次完整执行。
基线:每个事务 91,448 页
没有索引时,仪表盘和动态列表各自读取整张 events 表的 35,173 页,分别返回 30 行和 20 行。项目页把整张表读了 20 遍:一次页面访问执行 21 条语句,读取约 703,000 页。混合负载平均每个事务读取 91,448 页,每秒运行 13 个事务。
35-playbook先调配置,重要的东西并没有改变
我们先做了那件看起来顺理成章的事:调优服务器。work_mem = 64MB、random_page_cost = 1.1、effective_cache_size = 8GB、jit = off,每条查询四个并行工作进程。
每个事务的页面数为 91,510,与基线的差距在 0.1% 以内。吞吐量一次为 8,另一次为 17,基线是 13。只是噪声。配置改变工作如何运行,却不改变有多少工作。
35-playbook按操作指南的顺序,做八次改动
每一步都保留前面所有步骤的改动。两列吞吐量来自实验的两次完整执行;每个数字都是该步骤各次运行的中位数。
| 步骤 | 手段 | 每事务页数 | 事务/秒,实验 1 | 事务/秒,实验 2 |
|---|---|---|---|---|
| 0 | 基线 | 91,448 | 13 | 13 |
| 先调配置(未保留) | 91,510 | 8 | 17 | |
| 1 | 索引 | 752 | 299 | 329 |
| 2 | 直接对列做日期范围筛选 | 214 | 1,024 | 1,197 |
| 3 | 键集分页 | 143 | 1,128 | 1,005 |
| 4 | 填充因子 90 | 143 | 1,185 | 1,260 |
| 5 | 一条查询,代替 21 条 | 144 | 1,113 | 1,273 |
| 6 | 连接池 | 81 | 10,624 | 9,076 |
| 7 | 配置 | 82 | 4,135 | 11,297 |
| 8 | 每日汇总表 | 38 | 13,978 | 17,028 |
页面数来自第一次完整执行;第二次与之相比,差异不超过 1%。
35-playbook**步骤 1,索引。**每个索引都从需要它的查询出发设计,等值列在前,排序列在后:
每个事务的页面数从 91,448 降至 752,缩减为约 1/120。项目页现在读取约 108 页:每次项目查找四页(三个索引页、一个堆页),再加项目列表。仪表盘每次调用仍读取约 1,960 页:created_at::date 给列套上了函数,因此索引找出了该账户一整年约 2,000 行数据,却无法将范围缩小到 30 天。
**步骤 2,裸列。**把同一个筛选条件写成 and created_at >= '2026-09-06'(实验会话使用 UTC,因此结果相同)。仪表盘降到约 172 页,吞吐量变为原来的三倍多。
**步骤 3,键集分页。**平均偏移量为 240 时,OFFSET 为了返回每页 20 行,会读取约 260 个页面,且随翻页深度增长。从用户看到的最后一行开始,同一个索引只需约 22 个页面就能提供任意一页结果:
每个事务的页面数从 214 降到 143。吞吐量几乎没变,步骤 6 会说明原因。
35-playbook**步骤 4,填充因子。**更新计数器不会修改索引列,因此是 HOT-safe 的,即满足 HOT 对不改索引列的要求。但 projects 加载时按填充因子 100 填满了页面,所以大多数页上的第一次更新找不到空间,只能进行非 HOT 更新,为每个索引写入新条目。步骤 0 到 3 中,有几百次这样的更新。
从那以后,每次计数器更新都是 HOT。在这么短的运行中,每个事务的页面数没有变化;收益在于索引不再增长、WAL 更少、清理工作更少(让更新保持 HOT)。
**步骤 5,一条查询。**把项目页改成单条 left join lateral (... order by created_at desc limit 1)。页数不变,约为 108,因为数据库仍要执行同样的 20 次索引查找;省掉的是 20 次往返、解析和规划。在同一主机上运行 pgbench 时,两次实验的平均延迟都下降了(3.3 ms 降到 1.5 ms,3.0 ms 降到 2.4 ms)。如果跨真实网络、每次往返半毫秒,每次页面访问就能省下 10 ms 或更多。
**步骤 6,连接池。**步骤 2 到 5 的吞吐量一直在 1,000 到 1,200 左右,而页面数已经减少了三分之一。瓶颈是建立连接,在我们的机器上约需 2 ms。保持四个连接打开后,吞吐量达到 9,000 到 10,600。页面数也从 144 降至 81,因为摄入从约 239 页降到了 36 页:新会话要读取系统目录页,为插入的外键检查做准备,而连接池中的会话只需做一次。
**步骤 7,配置。**和“先调配置”时相同的五项设置。页数为 82,之前是 81。这里没有哪项工作排序多到需要溢出、扫描多到需要并行,或代价高到需要 JIT。这不是在反对真正重要的配置,那些设置能预防一个持续几分钟的实验无法体现的问题。这里反对的是用调参代替修问题。
**步骤 8,汇总表。**一张包含 (account_id, day, events, failed_deploys)、主键为 (account_id, day) 的表,由增量刷新逐日写入和构建,只需约 34 页就能服务仪表盘。刷新任务不在混合负载中;它就是用插入或更新保持新鲜中的定时 upsert。
每个端点每次调用,页面花在了哪里:
| 步骤 | 仪表盘 | 动态列表 | 项目页 | 摄入 |
|---|---|---|---|---|
| 0 基线 | 35,182 | 35,208 | 702,683 | 207 |
| 1 索引 | 1,963 | 262 | 108 | 247 |
| 2 裸列范围筛选 | 172 | 261 | 108 | 245 |
| 3 键集分页 | 175 | 23 | 109 | 242 |
| 4 填充因子 90 | 178 | 23 | 108 | 239 |
| 5 一条查询 | 182 | 23 | 108 | 239 |
| 6 连接池 | 179 | 23 | 102 | 36 |
| 7 配置 | 182 | 23 | 102 | 36 |
| 8 汇总表 | 34 | 23 | 102 | 36 |
35-playbook表格告诉了我们什么
**第一项手段做了大部分工作。**仅靠索引,每个事务的页面数就降为原来的 1/120;后续所有改动又在此基础上降到约 1/20。几乎所有系统都是这个样子:一两条语句占据了大部分代价,而修好它们很便宜。
**瓶颈移到哪里,吞吐量才会随之变化。**添加索引、改写日期条件、使用连接池时,吞吐量都会跃升。在这些步骤之间,键集分页和 N+1 修复减少了实际工作,吞吐量却原地不动,因为每个请求仍要付出新建连接的代价,而这是 pg_stat_statements 看不到的。要测量整个请求。
**有些手段的收益要以后才显现。**填充因子在这里没有带来变化。它改变的是更新一个月之后,索引会变成什么样。
**更大的机器也帮不上忙。**每个事务依然要读 91,448 页。同一台笔记本,按这份操作指南花一个下午,处理的事务数就比原来多了三个数量级。有人要求更大的数据库时,先做这个实验。
横向扩展之前
你已经按操作指南做过一轮。如果测量仍然表明某项资源耗尽,现在可以考虑更大的机器。本书下一部分就从这里开始:先纵向扩容,再横向扩展把这些证据变成升级规格的申请,然后继续攀登后面的台阶。
本章要点
- 按顺序修:找出昂贵的工作、查询与索引、模式、往返、日常维护、连接池、配置、预计算。之后才购买硬件或横向扩展。
- 从
pg_stat_statements和一次等待采样开始,写下瓶颈是什么。 - 每次只改一件事;数页面,页面数不会随噪声波动。
- 仅靠索引,每个事务的页面数就缩减至原来的 1/120;八次改动将页数从 91,448 降至 38,在同一台笔记本上让吞吐量达到原来的约一千倍。
- 先调配置,页面数几乎没变。配置设置上限,却不能让一次扫描少读数据。
- 瓶颈移到哪里,吞吐量才会随之变化:每个请求新建连接,掩盖了所有查询修复的收益,直到我们使用连接池。
- 先用数据证明,该换更大的机器了:升级规格的申请应附带证据。
延伸阅读
- Performance Tips,PostgreSQL 文档。从源头介绍 EXPLAIN、统计信息和数据库装载。
- pg_stat_statements,PostgreSQL 文档。每个字段,包括本章用调用次数作分母计算的缓冲区计数。
- pgbench,PostgreSQL 文档。自定义脚本、权重、
--random-seed和-C,实验中都用到了。 - The cumulative statistics system,PostgreSQL 文档。等待事件,以及 HOT 占比背后的表统计信息。
- Server configuration: query planning,PostgreSQL 文档。
random_page_cost、effective_cache_size和代价模型的其他部分。 - Routine vacuuming,PostgreSQL 文档。为什么清理属于维护,而不是调优。
37 先纵向扩容,再横向扩展
八个客户端各自在每个事务中插入一个事件,在我们的测试容器上每秒能执行约 5,000 个事务。给每个事务加上一行 update account_totals set events = events + 1 where account_id = 42,作为仪表盘的“实时计数器”,吞吐量就降到 390 至 600。只剩原来的十分之一。
只读副本解决不了这个问题,分片、更大的实例或换个数据库也不行。八个会话正排队等待同一行,解决办法是别再每插入一条数据就更新它。
Postgres 数据库吃力时,人们的本能反应是买一台更大的机器。单台大机器确实能撑很久。但先要改进工作本身,每次升级都得有数据依据。
先改进工作,再升级硬件
操作指南已经给各种手段排了顺序:测量、修查询、改变工作的方式,然后才是硬件。更大的机器之后,还有副本、分区和分片,每一项都会带来无法消除的成本。证据要求你走到哪一步,就走到哪一步。
用数据争取更大的机器
有人向我们申请更大的数据库时,我们的回答是“不”。不是永远不行,而是在用尽眼前成本更低的修复手段、并拿出数据证明之前不行。升级机器是第一个会每月花钱的台阶,因此也是第一个设有门槛的台阶。
设门槛不是为了省钱。有三个理由值得坚持。
**更大的机器会掩盖查询的问题,却不会修好它。**一条读取 35,249 页才返回 30 行的查询,换到规格翻倍的实例上,仍然要读取 35,249 页,只是快了一点,直到表的大小也翻倍。此时账单更高,同一条语句仍排在榜首。硬件能换来时间。修好查询,才能把时间拿回来,并一直省下去。
**成本会叠加。**升级规格之后,每张账单上都会多出一笔费用;副本的规格又要与主库相配,因此主库越大,副本也越大。解决查询问题的索引则没有月费。
**大多数慢数据库都不缺硬件。**只是其中几条语句读取了远超所需的页面。实证:一个应用,八次改动在同一个应用上走完了这套步骤:同一台笔记本,吞吐量达到原来的约一千倍。
所以,申请必须附带证据,这样讨价还价就变成了审查。如果数据表明机器确实耗尽了工作所需的某项资源,我们就买,不再争论,而这些证据也会成为下次申请的基线。
升级规格的申请要附上六项证据
前面的章节已经介绍过如何收集每一项:
- **排在前面的语句,以及每条语句做了什么处理。**对
pg_stat_statements按总时间和共享块数排序(四种排名),取繁忙时段的统计差值。在前五条语句旁分别注明:已修复、为何无法修复,或为何已经足够便宜。 - 每项修复前后每次调用的页面数。用页面数,不用毫秒数,因为页面数不会随负载变化。第一个索引:35,249 页降到 91 页就是一条好的记录。
- 能指明某项资源的等待分布,在出现问题的负载下采样得到。更大的机器能帮助正在使用 CPU、等待
IO:DataFileRead或缺少内存的会话。对于Lock等待、连接耗尽或工作负载的组织方式不当,它无能为力。 - 工作集(working set)与 RAM 的对比(根据工作集配置 RAM),以及读取量的变化趋势。如果工作集已经放得下,增加 RAM 没有收益。
- 耗尽的资源与资源余量:峰值离上限还有多远,以你的增长速度,新规格能撑几个月,都要如实测量。
- 已经试过并排除的办法:索引、改写、汇总表、连接池、配置、清理,以及等待分布指向 CPU 时,把逐行处理的工作移出主库。每项写一句话,不能只打个勾。
把申请写成工单
把这个模板粘进工单并填好。每个空白都是上面清单中的一个数字或一句话。
这个模板最大的作用,往往在提交之前就体现出来了:填到第二节左右,填表的人就找到了那条有问题的查询。而一份填写完整的申请很容易获批,因为论证已经做完了。
买任何东西之前,先测量
“数据库很慢”至少有五种原因:CPU、I/O、锁、连接,或一条热点查询。每种原因都有不同的解法,所以选择之前先测量。在开头的基准测试中,pg_stat_statements 显示,计数器更新是在一张 1,000 行的表上按主键更新,平均耗时却达 14 ms,几乎占了全部时间。
一条简单语句平均耗时很长,说明它在等待,而不是在干活。等待事件(wait event)采样告诉了我们在等什么。先看仅插入,再看加上计数器后的情况:
这是两个不同的问题。前者在等 WAL 刷新(提交意味着刷新):应该批量提交,增加核心没用。后者在等行锁:Lock transactionid 表示“等另一个事务结束,我才能动它的行”,Lock tuple 则是在后面排队。更快的磁盘没用,改变工作的方式才有用。
36-scale各种瓶颈的表现及常见解法:
| 瓶颈 | 看到的现象 | 常见解法 |
|---|---|---|
| CPU | 核心满载,等待事件大多为空 | 先修执行工作的查询,再增加核心 |
| I/O | DataFileRead 等待,缓存未命中 | 索引、减少每次查询的数据量、增加 RAM |
| 锁 | Lock 等待:transactionid、tuple | 改变工作方式,让会话不再互相争用 |
| 连接 | 几百个空闲后端进程,连接池超时 | 使用连接池器,缩小连接池 |
| 一条热点查询 | 一条语句占据了大部分总时间 | 修好那条查询 |
开头基准测试中的排名:
插入执行了 120,225 次,每次 0.05 ms;更新执行了 10,612 次,每次 14 ms。这些样本是每秒从 pg_stat_activity 读取几次得到的;活跃会话的 wait_event 为 null,表示它正在 CPU 上运行(把 application_name 筛选条件换成你的应用):
省略的末尾几项:仅插入时为 1 LWLock BufferContent 和 1 Client ClientRead,加上计数器后为 2 CPU running。
修好找出来的查询
测量通常会指向一条查询,修法就在本书前面。我们的九月仪表盘查询,为找出某个账户的 154 行数据,读取了 35,249 页;在 (account_id, created_at) 上加索引后,只需 156 页,缩减至原来的 1/226。
但其中有 149 个堆页,每个事件一个,只为生成 30 行结果;每次查看仪表盘又要再读一遍。这个成本随账户规模增长,而最繁忙的账户最常查看仪表盘。
预先算好要展示的内容
仪表盘、用量计量器和计费汇总,反复对写入后就不再改变的数据提出同样的聚合问题。汇总表(rollup)存的是答案,而不是输入。统计一次,存下计数,再读取计数。
粒度(grain),也就是分组依据的列,决定了汇总表是否值得建。我们的两百万个事件形成了 175 万个项目日,几乎没起到汇总作用;但只有 363,496 个账户日,约每行汇总五个事件。因此选择 account_daily,每个账户每天一行,主键为 (account_id, day),它同时也是仪表盘所需的索引。
| 查询 | 原始事件 | 汇总表 |
|---|---|---|
| 一个账户,30 天(无索引) | 35,249 页 | 4 页 |
| 一个账户,30 天(有索引) | 156 页 | 4 页 |
| 一个季度中部署失败次数最多的 10 个账户 | 14,846 页 | 4,218 页 |
不论这个账户有 154 个还是 154,000 个事件,30 天都是 30 行。原始数据会一直增长,汇总表则每天只增加几千行。
36-scale它有 363,496 行:2,673 个堆页(21 MB),加上主键共 32 MB。这里特意用 UTC 定义日期:汇总表需要统一的“天”的定义,而会话的时区并不稳定。如果客户需要各自的时区,就按小时存储,再求和。(粒度检查比较的是 count(distinct (project_id, created_at::date)) 与把列换成 account_id 后的结果。)
九月图表变成了 Index Scan using account_daily_pkey,缓冲区统计为 Buffers: shared hit=2 read=2。批量插入按 (account_id, day) 顺序写入行,所以一个月的数据只占一两页;逐日填充的汇总表会把 30 行分散到最多 30 页,但也不过几十页。
季度“谁的部署失败最多”报表,先看原始数据,再看汇总表:
规划器对每个账户遍历一次汇总表的主键索引(PostgreSQL 18 的跳跃扫描),读取了 2,673 个堆页中的 1,662 个;普通扫描的代价也差不多。
用插入或更新保持新鲜
汇总表好不好,取决于数据够不够新。最稳妥的刷新方式,是定时任务从昨天零点开始重算最近的时间窗口,再用 on conflict (account_id, day) do update ... where (...) is distinct from (excluded...) 插入或更新(upsert)。它是幂等的(idempotent):执行两次,得到的表相同。午夜前后新增 5,000 个事件后,它用约 16 ms 重算了 1,998 个账户日:新增 1,000 行,改变 299 行,相同而跳过的有 699 行。再执行一次,就不会重写任何行。
那段 is distinct from 虽长,却值得写:少了它,每次刷新都会重写窗口中的每一行,死元组和 WAL 一个不少(更新就是插入)。要重算完整的天,而不是“上次看到的 id 之后的所有数据”,后者会漏掉晚提交的事务。每次只运行一个刷新任务,并显示“更新于一分钟前”。
不要用热点行计数
开头的基准测试展示了另一种很诱人的做法:在每次插入的事务里递增计数器,让总数始终精确。代价是串行化:每个写入者都要取得同一个行锁,等待前一个写入者提交(计数器触发器会让写入者串行化)。每秒约 5,000 个事务就这样变成了不到 600 个。应该改为批量聚合,或把计数器分散到多行中(account_id, slot,读取时求和)。
物化视图会全部重算
物化视图(materialized view)把查询结果存成一张表。普通 refresh 在执行期间会阻塞所有读取者;refresh ... concurrently 则通过与旧结果做差异比较来避免阻塞,但需要唯一索引。对于一份 30 天的汇总,并发刷新耗时 181 ms,普通刷新为 41 ms;写出的 WAL 分别是 27 KB 和 2.1 MB,因为自上次刷新以来,几乎没有行发生变化。当大多数行都改变时,普通刷新在这两方面都更省。
无论哪种方式,都要全部重算。如果源数据会不断增长,就用汇总表。
执行 create unique index on project_activity_30d (project_id) 后,pg_stat_statements 中的记录如下:
如果每次刷新大多数行都会改变,只要能忍受锁,普通刷新就更快、更省。汇总表还允许你自行选择索引,保留源查询会丢弃的历史数据。
36-scale在应用中缓存,算清失效成本
对于读取次数远多于修改次数的数据,缓存可以完全免去这些读取。成本在于缓存失效:每条写入路径都得知道自己会让哪些键过时。“写入时删除缓存”能一直有效,直到某次写入发生在你遗忘的地方。短 TTL 能限制数据过时的程度,带版本的键则能精确处理。还有,如果一次主键查找的成本与访问缓存的往返差不多,就别缓存它。
把工作移出请求路径
发送邮件、webhook 和重算汇总,在执行期间都会占着连接。把它们放进任务队列(Postgres 就能很好地胜任:Postgres 队列与业务写入一起提交),它们就会按固定速率执行,而不是跟着用户的点击频率跑。
能重新生成的数据,可以不写 WAL
即使数据能从源头重建,仍要支付完整的 WAL 成本。unlogged 表会省去 WAL(完整权衡见崩溃后,不记日志表会被清空):同样的 476,712 行,写入普通表产生了 77 MB 的 WAL,写入不记日志表则没有;这些字节既不必传给副本,也不必存进归档。它适合可重跑导入任务的暂存表。
它在崩溃后会被截断清空,而且不参与复制,因此故障切换后也是空的。只用于能重新生成的数据。事后再改成记日志表,会把全部数据写入 WAL(先使用不记日志表,再 SET LOGGED,只是把 WAL 开销后移)。
归档冷数据行
再也没人读取的行仍有成本:索引更大、清理更多、恢复更慢。控制节奏,分批把它们迁出去,偶尔做一次没问题;如果每晚都做,就永远都得逐行删除。如果数据按时间过期,就分区,一次直接删除一个月。
在我们的容器上,每批 10,000 行耗时 70 至 400 ms(第一批缓存是冷的,所以最慢)。像回填那样,在循环中短暂停顿,让副本和清理跟得上。
问题是哪项资源先耗尽
有了充分依据,换台更大的机器就是不错的一步:不用投入工程时间,可以撤回,还能腾出空间从容走后面的台阶。在写作时,主要云厂商已经提供远超 100 vCPU、数 TB RAM 的单机供租用(迁移之前,先证明问题出在磁盘)。所以,问题很少是“单机能装下我们吗”,而是哪项资源先耗尽。
所有写入都汇入同一条 WAL 流
读取能随核心数增加而扩展;所有写入却都汇入同一条 WAL 流。我们对 events 的单行插入,每次产生约 600 字节 WAL:每秒 50,000 次,就是 30 MB/s,每天约 2.6 TB,全部都要刷新、传输和归档。每个备库都用一个进程重放全部 WAL,因此主库只要足够忙,就会把所有副本甩在后面,无论副本多大(重放只有一个进程)。
pg_stat_statements 记录了开头基准测试中 120,225 次单行插入产生的 72,265,853 字节 WAL,平均每次约 601 字节。每次插入都记录一条携带该行的堆记录、一次主键索引插入和一条提交记录;不时还会遇到检查点后某页的第一次修改,需要记录整个 8 KB 页面,这也算进了平均值。每次提交多行,可以分摊提交记录,但行和索引记录仍在。实验用 1,000 次插入重复了这项测量。
36-scale一个进程清理整张表
自动清理用一个进程扫描一张表:50 GB 要几分钟,5 TB 要几天,而死行和事务 ID 年龄还在不断增加。冻结我们那张 275 MB 的 events 产生了 278 MB WAL,因为检查点后对每页的第一次修改都要记录整页,所以一张巨表第一次冻结时,会写出约等于自身大小的 WAL(回卷正是不能跳过这项工作的原因)。分区冻结一次后,后续清理就会跳过它们的页面。
更大的机器解决不了连接和恢复问题
更大的机器解决不了连接数问题:无论有多少核心,几千个进程都要消耗内存,所以要用连接池。人们还常忘记运维的上限:以 500 MB/s 恢复 10 TB,在开始重放 WAL 之前,就得花五个半小时。如果恢复时间目标(RTO)是一小时,那么对于从备份恢复的单个实例而言,这个数据库已经太大了。应在恢复时间决定你的架构之前,测量恢复。
证据说到头了,纵向扩容才算到头
下面每个信号都能测量。“账单看着有点大”不在其中。
- WAL 的产生速度超过消费速度:副本在正常负载下就落后,而且延迟还在增长。
- 最大的机器仍以写入等待为主,即使用了快速存储和批量提交。
- 最大的表无法完成清理。
- 工作集超出了你买得到的最大 RAM 容量。
- 恢复时间超过了 RTO。
- 硬性要求迫使数据分开:数据驻留要求,或合同规定必须隔离某个租户。
- 对数十亿行做分析,这是另一种引擎的工作(行存与列存)。
不在清单上的理由:CPU 很高,却没人看过 pg_stat_statements;或是“以后也许用得上”。当信号确实出现时,根据耗尽的资源选择下一步:读取或故障切换用副本;保留期限和清理用分区;单个主库的写入或存储不够用,就分片。
本章要点
- 用数据争取更大的机器:先修好排名靠前的语句,再在申请中指出耗尽了哪项资源并附上证据,才能升级。
- 简单语句平均耗时很长,说明它在等待,而不是在干活。应该解决等待问题,而不是换硬件。
- 预先算好仪表盘要展示的内容:汇总表把 35,249 页变成了 4 页,幂等的插入或更新能让它保持新鲜。
- 绝不要靠每个事务都更新同一行,来维护精确计数器。
- 不记日志表不写 WAL,崩溃或故障切换后为空。
- 单台大机器可以撑很久。真正的上限是 WAL 与副本重放、巨表清理,以及恢复时间。
延伸阅读
- pg_stat_statements,PostgreSQL 文档。所有字段,包括
wal_bytes,以及语句如何归一化。 - The cumulative statistics system,PostgreSQL 文档。等待事件类型与事件的完整列表,帮助理解会话在等什么。
- REFRESH MATERIALIZED VIEW,PostgreSQL 文档。
CONCURRENTLY的确切要求,以及何时普通刷新成本更低。 - Materialized views,PostgreSQL 文档。物化视图的工作原理,以及用它生成汇总的完整示例。
- CREATE TABLE,PostgreSQL 文档。明确说明
UNLOGGED的保证:崩溃后截断清空,不参与复制。 - Table partitioning,PostgreSQL 文档。下一个台阶,以及分区数量方面的最佳实践。
38 权威数据的副本
我们把一个备库放在与主库相隔五毫秒的地方,设为同步,再用一个客户端逐行插入。每秒提交数从 757 降到了 136。随后停掉备库,设置三秒的 statement_timeout,再执行一次插入。它等了两分八秒,直到我们手动取消;而返回时,这一行竟然已经提交了。
副本是换更大机器之后的第一个台阶。它不是缓存,不是备份,也不是第二个主库,而是主库页面的拷贝,总会稍微落后一点。本章就讲这一点:落后多少、缩小差距要花什么代价,以及落在这个差距里的读取和数据会怎样。(所有演示都在三个可随时销毁的容器上运行:一个主库、一个副本和一个逻辑订阅端。)
副本是一台始终处于恢复中的服务器
崩溃后,Postgres 会把上个检查点之后的 WAL 重新应用到数据页上(先记日志,再写数据)。流复制(streaming replication)的副本一直都在做这件事,只是 WAL 从网络传来。
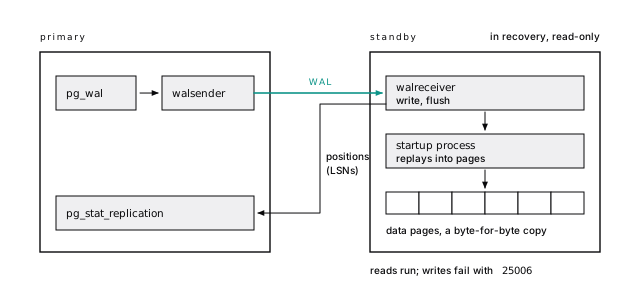
备库用 LSN 报告进度,即 WAL 流中的字节偏移量(LSN 是字节偏移量)。重放物理 WAL,使它成为整个集簇逐字节一致的拷贝:不能只复制单张表,不能给副本单独加索引,也不能混用版本。这些都该交给逻辑复制。
它接受读取,拒绝任何写操作,连临时表也不例外,返回 SQLSTATE 25006。在生产日志中,这个代码意味着某次写入被路由到了副本,或者故障切换把你的“主库”降级了。
MySQL 副本重放逻辑 binlog,并且可以写入。Postgres 流复制副本重放的是页面:模式完全相同,不允许写入。类似 binlog 的功能是逻辑复制(Postgres 不是 MySQL)。
上面依次是 insert、create temp table、analyze 和 select txid_current() 的结果(最后一个函数是 pg_current_xact_id() 的旧名称,所以错误里用的是新名称)。开启详细错误信息后,第一个错误是 ERROR: 25006: cannot execute INSERT in a read-only transaction;25006 对应 read_only_sql_transaction,应用可以捕获它。
37-replication.sh一条命令,把主库复制成备库
托管服务里,创建副本只需点一个按钮。手动操作时,需要 wal_level 至少为 replica(默认值),还要有一个带 replication 属性、获准通过 pg_hba.conf 连接的角色,然后用一条命令复制数据目录,建成备库:
-R 写入备库设置,--slot 与 --create-slot 一起创建复制槽(下一节详述),application_name 则是备库在各处显示的名称:每个备库都要命名。
复制连接用数据库名 replication 匹配 pg_hba.conf,而不是 all。我们第一次运行 pg_basebackup,在“waiting for checkpoint to complete”处停了两分多钟:默认请求的检查点会把写入分摊到一段时间内。如果不想等,就加上 --checkpoint=fast。-R 向 postgresql.auto.conf 追加了以下内容:
密码以明文保存在数据目录中;生产环境要用 .pgpass 或证书。副本启动后记录如下日志:
到了“consistent”,它已经重放到备份结束位置之后,可以安全读取了。
37-replication.sh复制槽承诺保留 WAL
复制槽(replication slot)是主库对某个消费者进度的记录,只要复制槽还需要某段 WAL,主库就不会回收它。有了复制槽,副本停机一小时也能追上。没有复制槽,副本落后太多后,就会发现所需 WAL 已被回收,只能重建。
默认情况下,这个承诺没有期限。我们的副本停机后,运行二十秒 pgbench,就让它的复制槽保留了 173 MB。一个被遗忘的复制槽会持续保留 WAL,直到磁盘写满,而 pg_wal 写满会让主库停摆。用 max_slot_wal_keep_size(PostgreSQL 13+)设上限后,被遗忘的槽会被标成 lost,主库则继续运行。花几分钟重新克隆副本,总比主库磁盘写满好。
在每个使用复制槽的主库上,把 max_slot_wal_keep_size 设得远低于磁盘容量。对不活跃的槽和保留的 WAL 量设告警。下线副本或订阅端时,在同一次变更中移除它的槽。
一个名为 forgotten 的槽没有消费者,上限为 256 MB。它先处于 unreserved 状态(保留 327 MB,safe_wal_size 为 -71 MB),下一个检查点后变成了以下状态(实验用更小的规模重现:100 MB 对 64 MB 上限):
invalidation_reason 和 inactive_since 从 PostgreSQL 17 起提供;PostgreSQL 18 又增加了 idle_replication_slot_timeout,让空闲过久的槽失效(默认关闭)。带有 xmin 的槽(来自后文的 hot_standby_feedback)还会阻碍清理。
37-replication.sh四个 LSN,指出备库落后在哪里
主库上的一个视图就能告诉你每个备库落后多少。pg_stat_replication 为每个已连接的备库保留一行,四个位置按处理顺序排列:sent_lsn(已发送)、write_lsn(已写入备库操作系统)、flush_lsn(已持久化到备库磁盘)、replay_lsn(已应用,查询可见)。flush_lsn 与 replay_lsn 之间有差距,意味着重放落后了,这是最常见的情况。按字节计的延迟为 pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn),replay_lag 则用时间表达这种延迟。
最重要的告警,是某个备库从视图中消失:它根本没有连接。
主库空闲后,*_lag 列变成 NULL,意思是“无从测量”,不是“坏了”。在备库上,pg_stat_wal_receiver 展示同一个连接(没有行就表示已断开)。备库上的 now() - pg_last_xact_replay_timestamp() 是人们容易理解的延迟,但只要主库空闲,它就会一直增长;应按字节延迟告警,或者每隔几秒写一次心跳,让这个时间值反映实际情况。
延迟随 WAL 量变化
16 个 pgbench 客户端运行时(每秒约 2,070 个事务),副本落后的数据量一直是 KB 级,最差的采样为 31 ms。一次覆盖 120 万行的批量 update,在 9.8 秒内产生了 574 MB WAL,副本最多落后 24 MB、0.7 秒,在更新结束半秒后追上。(实验用 400,000 行重现。)这是共享笔记本磁盘上测得的下限,不是预测,但趋势可以借鉴:延迟随 WAL 量变化,所以批量工作要分批做(大批量加载会触发检查点并淹没副本)。
每半秒采样一次:先是发送、刷盘和重放位置落后的字节数,再是 replay_lag;前三项用 pg_wal_lsn_diff(pg_current_wal_lsn(), ...) 根据 pg_stat_replication 中的位置计算:
37-replication.sh重放只有一个进程
主库的所有后端进程同时生成 WAL;备库却用单个 startup 进程按顺序逐条应用。直到 PostgreSQL 18,都没有并行重放。所以,主库用几十个核心写入,产生 WAL 的速度可能超过单个核心的应用速度,之后无论副本多大,重放延迟都会持续增长:增加备库核心数没有用,因为只有单个核心的速度及其背后的存储性能起作用。解法在主库一侧:少写 WAL(批量工作分批做、删除不用的索引、为整页镜像开启 wal_compression),或把写入拆到多个主库上(所有写入都汇入同一条 WAL 流给出了具体数据量)。对正常负载下持续上升的 replay_lag 告警:这是单个主库开始超出副本承受能力的第一个信号。
默认使用异步复制,可能丢失已提交的事务
延迟带来的不只是读到旧数据。默认情况下,WAL 在主库刷盘后,提交就会返回;副本几毫秒后才收到。如果主库在这个窗口内故障,而你提升了一个副本,应用已经看到成功的提交也会丢失(这里持久,不等于处处持久)。对大多数应用来说,这可以接受。把它写成恢复点目标(RPO),参见先写下 RPO 和 RTO。如果答案是“已提交事务零丢失”,你就需要同步复制,并承担它的代价。
同步提交要付出一次往返
同步复制(synchronous replication)让提交等待,直到 synchronous_standby_names 指定的某个备库确认;synchronous_commit 则规定它必须推进到哪一步。同步备库相隔 5 ms、一个客户端逐行插入时:
synchronous_commit | 满足什么条件后提交返回 | 平均延迟 | 提交数/秒 |
|---|---|---|---|
off | WAL 在主库内存中 | 0.051 ms | 19,571 |
local | 在主库刷盘 | 1.32 ms | 757 |
remote_write | ……并且在备库写入 | 6.41 ms | 156 |
on | ……并且在备库刷盘 | 7.35 ms | 136 |
remote_apply | ……并且在备库重放 | 7.62 ms | 131 |
关键的跃升是从 local 到 remote_write:五毫秒,一次往返。在同一可用区内,它会缩短到接近一毫秒;跨大陆时,每次提交都要付出 60 ms 或更多。换成 16 个客户端,组提交(group commit)可以共用往返,on 损失的吞吐量就从六分之五降到了一半。
不必处处都付这个代价。按事务设置,让付款等待备库,而页面浏览日志不等:
on 已经足以满足持久性要求。remote_apply 贵一点,换来的是另一样东西:提交返回时,备库上已经能看到这一行。这对写后读很重要。
我们设置了 synchronous_standby_names = 'FIRST 1 (replica1)',在备库加上 tc qdisc ... netem delay 5ms,按连接改变设置:每个级别十秒,跑五轮,取中位数(本地刷盘噪声较大,在 1.1 至 2.8 ms 之间)。16 个客户端时,local 每秒提交 1,708 次,延迟 9.37 ms;on 为 854 次、18.73 ms。应用并发越低,受影响越大,比如逐行提交的批处理任务。
未配置同步备库时,remote_write、on 和 remote_apply 的行为都与 local 相同,所以 on 是安全的默认值。set local synchronous_commit = off 则走向另一端,适合崩溃时可以丢失的写入(synchronous_commit = off 可能丢失约 600 ms 内的提交)。
这个列表指定一个数量,可按优先级或法定人数(quorum)选择:
使用 FIRST 时,replica2 要到 replica1 消失后才成为同步备库。使用 ANY 时,每次提交等待最先响应的那个,能减轻单个慢备库的影响;但故障切换时,工具必须判断哪个备库拥有全部提交。
37-replication.sh同步备库消失,写入就停了
这才是会咬人的地方。我们停掉同步备库,设置 statement_timeout = '3s' 后执行一次插入。它卡在等待事件 SyncRep 上,超时一直没触发。两分钟后,我们取消了它:
把 DETAIL 再读一遍。开始等待之前,提交就已经写到了本地,因此取消也撤不回去:这一行确实存在,但因超时而放弃的客户端却认为写入失败。每次写入都会这样排队,直到有同步备库回来。
只有一个同步备库时,任一服务器失联都会让写入停止。应运行两个候选备库(FIRST 1 (a, b) 或 ANY 1 (a, b)),监控 sync_state(见 pg_stat_replication)并设告警,还要提前决定故障切换时是否允许降级为异步。
statement_timeout 管的是语句执行,Postgres 会在提交开始前将其解除。等待同步备库发生在提交过程中,此时提交记录已经在本地刷盘,所以你设的超时无法打断这段等待。pg_cancel_backend() 或客户端取消,会结束等待并给出上面的警告;pg_terminate_backend() 会结束会话,但它们都撤不回提交。因此解决办法是增加第二个候选备库,而不是缩短超时。实验停掉备库,在后台发起插入,六秒后检查。
37-replication.sh只读副本扩展读取,不扩展写入
每个副本都要重放每次写入,因此副本不会增加写入容量,还会继承主库的膨胀、缺失索引和慢查询。读取 35,000 页的查询,在副本上也得读 35,000 页。先修查询(先纵向扩容,再横向扩展)。
当读取确实是瓶颈时,副本可以承担那些容忍稍微落后的读取:仪表盘、搜索、导出和报表。在应用中路由,建两个连接池,在每个调用点明确选择。靠猜的代理,会被调用写入函数的 select 骗过。
写入之后,副本可能仍显示旧值
经典的副本问题:用户改了名字,重定向后从尚未重放更新的副本读取,又看到了旧名字,于是再改一次,客服就收到了一张工单。(我们暂停重放复现了它:副本已经收到更新,却尚未重放。)解决办法由简到繁如下:
- 写入后几秒内固定读主库。对大多数应用已经足够。
- 按需求路由:凡是展示用户刚刚操作结果的内容,都读主库。
- 等待 LSN:写入提交后,用一条独立语句读取
pg_current_wal_lsn(),携带这个值;等副本的pg_last_wal_replay_lsn()越过它后再读副本,否则回退到主库。必须在提交之后取,不能在事务内取(returning pg_current_wal_lsn()太早):提交记录出现在 WAL 的更后面,副本即使越过了前一个 LSN,也仍可能看不到这一行。 remote_apply:对少数值得付出这个代价的写入,按事务设置。
更新提交后,在主库执行 select pg_current_wal_lsn(),返回 0/9FAFAB90。副本暂停重放时的状态如下:
select pg_last_wal_replay_lsn() >= '0/9FAFAB90'::pg_lsn 返回 f。调用 pg_wal_replay_resume() 后,紧接着检查仍是 f,因为恢复重放是异步的;稍后才变成 t。因此,应用先轮询,不满足条件再回退:
这个办法精确,副本多少都适用,代价是多一次往返。PostgreSQL 19(截至 2026 年 10 月仍在 beta 阶段)新增了 WAIT FOR 命令,让备库自行等待某个 LSN;在此之前,上面的循环适用于从 10 起的所有版本。
37-replication.sh副本查询会与重放冲突
副本上的查询持有快照(snapshot),而重放有时必须修改它依赖的页面。最常见的情况是:主库清理掉了主库查询不再需要的行版本,但副本上的查询仍然需要它们。主库根本不知道这个查询存在。于是重放开始等待,最长等到 max_standby_streaming_delay(默认 30 秒),延迟随之增长,然后副本会取消查询:
每条出路都只是把成本转移到别处。让重放多等一会儿,延迟就会增长。打开 hot_standby_feedback,主库清理时就会留下副本需要的行:查询不再被取消,但会产生膨胀,就像主库上运行了一个长事务(长事务会把一切都拖住)。或者选择重试(SQLSTATE 40001)。
因此要分开工作负载:服务应用读取的副本关闭反馈,并使用重试;报表副本打开反馈,并设置 statement_timeout。绝不要把可能落后几分钟的副本作为故障切换候选。
未开启反馈时,副本上一个可重复读查询持有快照,replay_lsn 因此停了半分钟;主库插入的一行在副本上一直不可见,查询在 33.7 秒后被取消。pg_stat_database_conflicts 把它计为 confl_snapshot。(confl_lock 来自重放 access exclusive 锁:drop table、truncate、许多形式的 alter table,以及清理时截断表尾。)
设置 hot_standby_feedback = on,运行同一个长查询,主库删除半张表后执行清理:
副本查询不受干扰,正常结束。反馈保存在副本复制槽的 xmin 中,值为 2492494,与清理界限相同,而不是保存在 backend_xmin 中。反馈每隔 wal_receiver_status_interval 发送一次(默认 10 秒);它推进后,下次清理就显示 tuples: 1133508 removed。
37-replication.sh把新副本的 primary_conninfo 指向已有副本,它就从那里接收 WAL 流。WAL 只需跨过一次昂贵的链路,抵达另一个地域的副本,再由它分发给附近副本,减轻主库的 walsender 负载。代价是延迟沿链路叠加;只有直接连接主库的备库才能作为同步备库;中间副本还得有自己的 max_wal_senders 设置和复制槽。
一次调用提升副本,开启新时间线
主库故障后,调用 select pg_promote() 就能提升副本。我们的副本在 200 ms 后开始接受写入,位于新的时间线(timeline)上,也就是从该点分叉出来的一段历史。(它的第一个 id 是 1035,旧主库却停在 1004:序列会提前记录值。如果应用认为 id 必须连续无缺口,那它本来就错了。)
旧主库并不知情
提升是容易的那一半。我们的旧主库还在运行,因为没人告诉它停下,它又接受了一次插入。两台服务器都接受写入,各自都有对方没有的行:这就是脑裂(split brain),也没有什么机制会把它们重新合并。仍指向旧主库的客户端,写入的都是一条即将被丢弃的分支。
37-replication.sh把旧主库作为新主库的备库重新启动,它拒绝跟随:
它已经写过了分叉点。pg_rewind 只复制回从那时起发生改变的块;它要求启用数据校验和(PostgreSQL 18 的 initdb 默认开启)或 wal_log_hints = on,还需要旧主库从分叉前最后一个检查点起的 WAL。我们的 WAL 已经被回收了:
如果有归档,pg_rewind -c 会通过 restore_command 取回 WAL;没有归档,就得重新克隆。(之后还要在新主库上重建复制槽:基础备份不包含复制槽。)“Written to the OLD primary”这一行没了。真正脑裂时,那些都是客户的写入,必须在清空旧服务器前手工挖出来。
不要自己拼凑故障切换
健康检查一失败就调用 pg_promote() 的脚本,等于主动制造脑裂。故障切换必须判断主库确实已死(慢也可能看起来像死了),用栅栏机制(fencing)隔离它,让它无法继续写入,挑选拥有最多 WAL 的副本,迁移客户端,再把旧主库接回去。
Patroni 是这方面使用最广泛的开源工具:节点在共识存储中争夺带有效期的领导者锁,主库如果无法续期就自行降级。在 Kubernetes 上,CloudNativePG 等 Operator 承担这项工作;在托管服务上,这就是你付费购买的服务。无论哪种,都要按计划主动演练故障切换:没有演练过的故障切换,就是可用性领域的未验证备份。
逻辑复制拷贝行,不拷贝页面
流复制拷贝页面。逻辑复制(logical replication)拷贝行变更:发布端把 WAL 解码成“插入这一行、更新那一行”,订阅端再将其应用到普通表。订阅端是一个正常、可写的数据库,有自己的索引和表,甚至可以使用不同的主版本。它要求发布端设置 wal_level = logical(修改需要重启,要提前安排),还需要一个发布和一个订阅:
它会在发布端创建逻辑复制槽,复制已有行,再开始流式传输;我们的变更在一秒内就应用了。前面关于复制槽的一切仍然适用:订阅端停滞,会让发布端保留 WAL。
逻辑复制不复制 DDL 和序列
逻辑复制会留下这些东西:DDL、序列状态(直到 PostgreSQL 18 都如此)、大对象和视图。其中两项尤其容易踩坑:
- **DDL。**在发布端新增一列并使用它,订阅就会停止(
missing replicated column: "region"),而复制槽继续保留 WAL。增加内容的 DDL 要先在订阅端执行。 - **序列。**订阅端的序列不会前进,所以第一次插入就撞上了 id 1。升级切换之前,要对每个序列执行
setval。(PostgreSQL 19,截至 2026 年 10 月仍在 beta 阶段,允许发布通过for all sequences包含序列,并按请求同步。)
还要给每张表一个主键:订阅端通过复制标识(replica identity)定位行,默认就是主键。发布中的表如果没有键,每次更新它都会在发布端失败,直接影响应用的写入路径。
加上主键就解决了。也可以用 replica identity using index 或 replica identity full,后者会记录整条旧行:WAL 更多,而且订阅端可能每处理一次变更就要扫描整张表。DDL 错误在订阅端日志中反复出现,直到我们在那里补上缺失列;pg_stat_subscription_stats(PostgreSQL 15+)会统计这类失败。初始复制是在发布端以订阅连接字符串中的用户身份执行普通 select,因此添加表时如果没做 grant select,它就会一直为空。
从 PostgreSQL 15 起,发布可以只发送部分行和列:
publish = 'insert' 是关键。如果发布包含更新或删除(默认如此),行过滤条件就只能引用复制标识列,且会在发布端的写入路径上检查:没有这个选项,此过滤条件会让每条 update 语句在更新 accounts 时都失败。
37-replication.sh37-replication.sh逻辑复制用于升级、迁移和变更数据流
当副本必须与源头不同时,就用它:停机仅几秒的主版本升级(切换)、把几张表同步到别处、迁移云服务商,或向变更数据捕获(change data capture)、搜索和缓存消费者提供数据流。
有一个陷阱:逻辑复制槽留在创建它的服务器上,因此我们提升副本后,订阅端仍然跟着旧主库。PostgreSQL 17 的故障切换槽(failover slots)解决了这个问题(failover = true、sync_replication_slots = on);17 之前,每次故障切换后都要重新同步。
从 PostgreSQL 16 起,可以在备库上进行逻辑解码(那里也要设置 wal_level = logical):
在备库上创建复制槽,要等待一条快照记录;在主库执行 pg_log_standby_snapshot() 就能生成。使用故障切换槽时,主库的 synchronized_standby_slots 会让逻辑消费者的进度不超过可能接替主库的备库。而 pg_createsubscriber(PostgreSQL 17+)可以把物理备库变成订阅端,省去初始复制。
故障切换用流复制,具体任务用逻辑复制
| 需求 | 选择 |
|---|---|
| 基本没有数据丢失窗口的故障切换目标 | 流复制,与两个备库中的至少一个同步 |
| 故障切换目标,可接受较短的数据丢失窗口 | 异步流复制 |
| 增加能容忍旧数据的读取容量 | 流复制副本,按调用点路由 |
| 不同的主版本,或升级 | 逻辑复制 |
| 把几张表或过滤后的子集放到别处 | 逻辑复制 |
| 向队列、搜索或缓存提供行变更 | 逻辑解码 |
| 更多写入容量 | 两者都不行。参见最后再考虑分片 |
多数生产部署最终两种都有:流复制备库用于故障切换,由懂得如何提升它们的工具管理;逻辑复制则为具体任务引入,而且常常只是临时使用。
本章要点
- 流复制副本是整个集簇完全一致的只读拷贝,总会稍微落后。
- 用
max_slot_wal_keep_size限制每个复制槽,并对不活跃的槽告警。 - 同步提交每次都要付出一次往返(备库相隔 5 ms 时,1.3 ms 变成了 7.4 ms)。按事务设置,并运行两个候选备库。
- 按调用点路由读取;要读到自己的写入,就固定读主库,或等待写入的 LSN。
- 副本上的长查询,要么被取消,要么拖慢重放,要么让主库膨胀。故障切换候选与报表副本分开。
- 绝不要自行拼凑故障切换,要按计划演练。
- 逻辑复制拷贝行,不拷贝 DDL 或序列:增加内容的 DDL 先在订阅端执行,每张表都要有主键。
延伸阅读
- Log-shipping standby servers,PostgreSQL 文档。从源头介绍流复制、复制槽、级联,以及使用
FIRST和ANY的同步复制。 - Hot standby,PostgreSQL 文档。备库可以运行哪些操作,各类重放冲突,以及每项设置如何改变它们。
- Replication settings,PostgreSQL 文档。本章所有设置的默认值与确切语义,包括复制槽限制和故障切换槽同步。
- Logical replication,PostgreSQL 文档。发布、订阅、行过滤、冲突、故障切换与升级。
- pg_rewind,PostgreSQL 文档。使用要求,以及所需 WAL 已丢失时如何处理。
- Patroni,GitHub。使用最广泛的开源故障切换管理器;其文档解释了领导者锁、栅栏机制和同步模式。
39 为删除而分区
我们从本书的 events 表中,用普通的 delete ... where created_at ... 删除了一个月的事件,共 164,383 行。它产生了 32 MB WAL,留下 164,383 个死元组(dead tuple),随后回收它们的清理又产生了 12 MB WAL。接着,我们在这张表的分区副本中,分离并删除一个分区,移除了同一个月的数据。这次产生的 WAL 不到 150 KB。
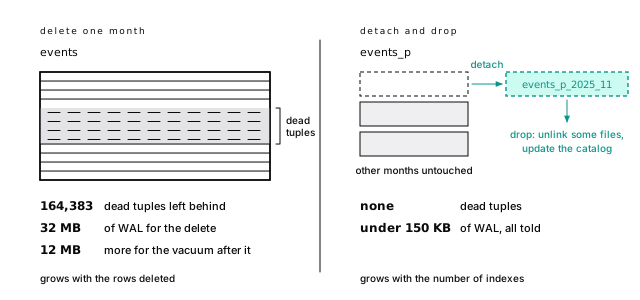
到了二十亿行,这个 delete 就变成了每晚运行数小时、淹没副本的任务。删除分区的工作量却不变:移除一些文件,更新系统目录。
这才是实在的理由。分区首先是一项数据生命周期功能。它不是通用的加速手段,对于不带分区键的查询,反而会更慢。
所有收益都来自拆成独立的表
分区表是一张不存放行的父表。每一行都恰好落在一个子表里,这个子表就是分区(partition),由分区键(partition key)的值决定。每个分区都是普通表,有自己的堆、索引、可见性映射和自动清理调度。拆开之后,有四项收益:
- **过期数据直接删表。**移除旧数据就是删除一张表:没有死元组,几乎没有 WAL,也没什么需要清理。
- **分块维护。**自动清理处理的是 30 GB 分区,而不是 3 TB 大表。旧分区冻结一次,后续清理便会跳过它们的页面。你可以一次只重建一个分区的索引,或重整一个分区。
- **热点索引保持小巧。**即使完整历史的索引放不进内存,当月的索引仍然能放下。
- **分区剪枝。**按分区键筛选的查询,只访问可能匹配的分区。
分区不会让查找更快
不论一百万行还是十亿行,沿 B-树向下查找都只需三四页(B-树是一棵由页组成的浅树),所以拆表不会让索引设计良好的查找更快。查询不指定分区键时,拆表反而会成倍增加查找次数:按 id 查找,在 events 上读取 7 页,在按月分区的副本 events_p 上则要读 39 页,因为每个分区的索引都得查。14 个分区时开销不大,1,000 个就不同了(每个无法剪枝的分区都要花规划时间)。
要加快时间范围查询,还有更便宜的工具:在 created_at 上建一个 24 KB 的 BRIN 索引(BRIN 为每个页范围保留一份汇总),统计三月事件时只读了 3,251 页;分区表剪枝到三月后则是 2,988 页。
所以,应该为了分区独有的收益而分区:低成本处理过期数据、逐分区维护,或解决清理和建索引已超出维护窗口的问题。不到几十 GB 的表,除非有保留期限要求,否则别动;还要等 pg_stat_statements 证实排名靠前的查询都带着分区键。
范围分区适合时间,列表和哈希各有专用场景
声明式分区(declarative partitioning,partition by,PostgreSQL 10+,此后每个版本都有改进)有三种策略:
| 策略 | 键 | 适合场景 |
|---|---|---|
| 范围 | 连续值,通常是时间 | 事件、日志、指标,以及有保留期限要求的数据 |
| 列表 | 离散值 | 地域、少数非常大的租户 |
| 哈希 | 对键求哈希,再对 N 取模 | 把一张热点巨表拆成大小均衡的几块 |
本章的 events_p 按月做范围分区:十四个分区,每个约 3,000 页;而 events 有 35,173 页。它的主键是 (id, created_at),这是必需的(原因见这里)。
列表分区适合少量、稳定的值,比如把欧盟数据放在独立存储上。哈希分区没有生命周期方面的收益;它只是把一张热点巨表拆成中等大小的表,方便维护。
范围边界包含下界、不包含上界,与查询中应该使用的半开区间相同。生成分区;在 psql 中,\gexec 会把结果的每一行当作语句执行:
然后用 insert ... overriding system value select ... from events 复制数据,用 setval 把标识列(identity column)的序列推进到已复制的 id 之后,再执行 vacuum analyze。按 tableoid::regclass(指出行实际存放在哪张表中的系统列)统计行数,可以确认路由结果:
第十四个分区,即 2026 年 11 月分区,已经提前建好,目前为空,等待数据到来。
如果行的键不匹配任何分区,列表分区会拒绝它(no partition of relation "audit_log" found for row)。哈希分区表 sessions_h 使用 modulus 4,把 400,000 行分到四个桶中,分别为 100,504、99,912、99,884 和 99,700 行;where user_id = 42 恰好只扫描一个桶。
38-partitioning按删除数据的条件选择分区键
分区键应该是你淘汰数据的依据,最好也是大多数查询的筛选条件。对于事件、日志和指标,两者都是同一列,即时间戳,因此它们很适合分区。
两者不同时,保留期限通常优先。SaaS 应用按 account_id 筛选,但按账户分区,又会让过期数据处理变回逐行删除。应该按时间分区,各分区的索引以 account_id 开头;把租户分散到多台机器,是分片的工作。
让保留期限决定粒度,目标是每个分区几 GB,总数几十到小几百个。按月保留十年,是 120 个分区;按天则是 3,650 个,你会感受到差别。
分区边界是免费的粗粒度索引
分区剪枝(partition pruning)就是跳过不可能包含匹配行的分区。不在 created_at 上建索引,统计三月事件,在 events_p 上读取 2,988 页,在 events 上则是 35,173 页:计划里甚至只出现了三月分区。
如果规划时还不知道值(now()、通用计划(generic plan)的参数),Postgres 会在执行开始时剪枝,计划显示 Subplans Removed: 11。两种情况都需要直接使用分区键:date_trunc('day', created_at) = ... 会扫描全部十四个分区,半开区间范围只扫描一个(保持索引列裸露)。
没有分区键,即使廉价查询也要在规划阶段付出代价:“账户 42 最近的 20 个事件”,按从新到旧的顺序读取分区,读到 23 页就停止了,与普通表相仿;但规划访问了 455 页,普通表只有 54 页。
38-partitioning其余十三个分区根本没出现。使用 where created_at >= now() - interval '7 days' 时(PostgreSQL 11+ 支持运行时剪枝):
预备语句的通用计划使用 where created_at >= $1 时,也显示 Subplans Removed: 11。标为 (never executed) 的分区也可能是运行时剪枝的结果,也可能像下面的计划一样,是 Limit 在到达它之前就停了。
从最新数据开始,提前停止(PostgreSQL 12+ 会按顺序追加范围分区,而不是归并它们):
规划耗时约为普通表的十倍(新会话中,1.25 ms 对比 0.1 ms)。
38-partitioning按分区执行的计划适合报表
剪枝一次只处理一张表。enable_partitionwise_join 会对分区方式相同的两张表逐分区连接,enable_partitionwise_aggregate 则逐分区聚合。两者默认都关闭,因为每个分区上的哈希或排序都有自己的一份 work_mem:涉及 100 个分区的计划,可能用掉预算的 100 倍。
把 events_p 与按相同月份分区的 deliveries_p 连接,生成季度报表时,逐分区连接把 46.9 ms 降到了 17.6 ms。但更简单的办法,是在两侧都写明范围,让各自独立剪枝。这些设置应只在报表会话中使用,绝不要用于 OLTP。
设置 set enable_partitionwise_join = on 后:
缓冲区命中更多了(51,723 对比 12,059),来自数千次命中缓存的索引探测,但不用再把十一个无用分区纳入哈希表构建。使用 enable_partitionwise_aggregate 时,按分区键分组,会在各分区内完成全部聚合;按其他内容分组,则先在各分区内部分聚合,再合并;按 date_trunc('month', created_at) 分组,这两种都不会发生。
38-partitioning约束必须带上分区键
唯一约束必须包含分区键
下面就是 events_p 的主键必须为 (id, created_at) 的原因:
Postgres 没有全局索引。分区表上的索引,其实是每个分区各有一个索引,因此唯一性只在单个分区内检查。如果唯一键包含分区键,相同的键就会落在一起;否则,重复值可以藏在不同月份里,不被发现。(同一个 id 分别插入五月和九月,没有报错。)on conflict 的目标也遵循同样的规则。
引用分区表也必须带上分区键
events_p 上的每个唯一键都包含 created_at,所以 references events_p (id) 会失败,引用它的表也必须带上分区键,就像 deliveries_p 的 (event_id, event_created_at)。事件表适合分区,部分原因就是很少有表引用它们。
开始前,列出所有涉及这张表的唯一约束和外键,决定如何替代每一项:带上分区键、另留一张小型非分区表保存唯一值,或不做分区。
索引也有自己的陷阱:分区父表不支持 create index concurrently。先以 on only 在父表上建索引,再并发构建各分区的索引并逐个挂接;最后一个挂接完成后,父表索引才变为有效。
避免默认分区
默认分区会接住不匹配其他分区的行,看起来像安全网,实际更像陷阱:创建新分区时必须持锁扫描它;如果里面有属于新范围的行,创建就会失败;它还会阻止 detach ... concurrently,而有外键指向这张表时,也不能直接删除它。
应该确保未来的分区始终提前建好,并把“no partition found”错误当作它应该触发的告警。
(我们先清空默认分区,再执行 detach partition events_p_default,随后 drop table 就成功了。)
38-partitioning处理过期数据:先分离,再删除
收益就在这里。用两种方式删除 2025 年 11 月的数据(164,383 行):
delete + 清理 | 分离 + 删除分区 | |
|---|---|---|
| 写入的 WAL | 32.5 MB + 12.5 MB | 约 140 KB |
| WAL 记录 | 175,000+ | 226 |
| 待清理的死元组 | 164,383 | 无 |
| 索引清理 | 每个索引、每一行 | 无 |
| 开销随什么增长 | 删除的行数 | 索引数量 |
数据量小且已缓存时,delete 不到 100 ms 就完成了。它的代价随行数增长,每个副本要重放的 WAL 也一样;删除分区则不会。在这里,两者都远不到一秒;到了十亿行,只有一种还能如此。
38-partitioningdelete 的 explain (analyze, wal) 结果:
它留下的清理工作:
分离和删除,在 pg_stat_statements 中分别是:135 条记录、103,569 字节,然后是 91 条记录、36,971 字节。多数数据来自整页镜像,因此总量随检查点时机变化:我们多次运行的结果在 80 至 150 KB 之间。
要并发分离,否则所有操作都排在后面
普通 detach 会在父表上取得 ACCESS EXCLUSIVE 锁,让所有操作排在它后面(锁队列)。detach partition ... concurrently(PostgreSQL 14+)不会阻塞查询。它不能在事务块内运行;如果被中断,分区会保持“detach pending”状态,直到执行 detach partition ... finalize。
外键决定操作顺序
deliveries_p 引用 events_p 时,先分离事件分区会违反外键而失败。必须先移除引用它的分区。
每天按顺序做:创建缺失的未来分区,完成待定的分离,并发分离过期分区(先处理引用方),需要时归档,然后删除,再对父表执行 analyze。设置 lock_timeout,让它放弃而不是排队,留待下一轮重试。
38-partitioning在需要之前创建分区
过期数据处理在一端移除分区,总得有任务在另一端添加。缺少分区时不会平稳降级:那个范围里的每次插入都会失败。用定时任务提前建好几个未来分区;如果最远的未来分区距离现在还不到几周,就发告警。这个任务的大部分工作,前面的 \gexec 生成器已经完成。如果不想自己维护,大多数团队用的扩展是 pg_partman(pg_cron 和 pg_partman 帮你把时间掌握在自己手里);务必阅读所用版本的默认值,因为它们很重要。
- 版本 5 只管理原生声明式分区;旧的触发器方式已经移除。
create_parent()用控制列和间隔注册一张已有分区表,并提前创建分区(p_premake默认为 4)。run_maintenance()(或run_maintenance_proc(),后者每处理完一组分区就提交)创建新分区并执行过期数据处理。通过它的后台工作进程或pg_cron这样的调度器运行。- 保留策略放在
part_config表中:retention设置保留时长,retention_keep_table(默认 true)会分离并保留旧分区,而不是删除它们。 create_parent()会创建默认分区,除非传入p_default_table := false。考虑到前面的问题,可以关闭它,至少也要监控里面是否出现行。
不停机地改造现有表
不能直接执行 alter table ... partition by。可以把整张现有表变成第一个分区,覆盖全部历史数据,再让新分区承接未来。诀窍是用一个 check 约束,证明每行都在范围内,这样 attach partition 就会跳过验证扫描:
- **在线操作:**并发构建
(id, created_at)上的唯一索引,添加check (created_at < '2026-11-01')并标为not valid,再用validate验证,不阻塞写入(两步法)。 - **一个短事务,设置
lock_timeout:**重命名旧表,用那个索引作为主键,把标识列定义移到新的分区父表,将旧表按边界挂接进来,创建后续分区,再用setval把父表序列推进到旧 id 之后。分区不能保留自己的标识列定义,因此跳过这一步,挂接就会失败。
在一个 180 万行的副本上,事务耗时约 20 ms。没有这个约束,挂接就要持锁扫描每一行:到了 TB 级,要几分钟甚至几小时。(批量填充新分区,参见冻结分区,挂接已构建的分区,再分析父表。)
我们第一次尝试挂接时失败了两次,先是 The new partition may not contain an identity column.,再是 multiple primary keys for table "events_copy_old" are not allowed。必须移除旧的 (id) 主键,把步骤 1 的索引变成新主键(attach 会直接采用它,避免持锁建索引),并把标识列定义移到父表:
设置 client_min_messages = debug1 后,挂接显示 partition constraint for table "events_copy_old" is implied by existing constraints,耗时 0.468 ms。之后插入两行,一行是当前时间,一行是 2026-11-15,分别得到 id 2000001 和 2000002,落在 events_copy_old 与 events_copy_2026_11 中。
旧分区包含全部历史数据,在整个范围过期之前,仍要靠 delete 处理其中的过期数据(或者在后台把各个月份拆出去)。实际动手前,检查引用旧表的外键、触发器和授权(它们不会自行迁移),以及显式指定序列名的代码。
38-partitioning查询无法剪枝时,分区代价最大
每个无法剪枝的分区都要花规划时间
能剪枝的查询,几乎感觉不到分区数量。不能剪枝的查询,则要为每个分区付出规划时间、内存和锁的代价。我们在 12 到 3,000 个按日分区上,分别规划一条带分区键的查询和一条不带的查询(where account_id = 42):
| 分区数 | 带键,预热后 | 不带键,预热后 | 不带键,新会话 | 规划器内存,不带键 |
|---|---|---|---|---|
| 12 | 0.02 ms | 0.05 ms | 0.9 ms | 124 KB |
| 365 | 0.13 ms | 4.2 ms | 19 ms | 3.1 MB |
| 1,000 | 0.13 ms | 15.0 ms | 55 ms | 8.4 MB |
| 3,000 | 0.14 ms | 52.0 ms | 170 ms | 27 MB |
带分区键时,数量几乎无关紧要;不带时,规划要 52 ms,每个新连接的第一次查询则约为这个数的三倍。无法剪枝的查询还要锁住每个分区及索引,锁会溢出到共享锁表,最终可能耗尽它,报出“out of shared memory”。把数量控制在几十到小几百个,并让热点查询能剪枝。
预热后的数字是同一会话中运行 15 次的中位数;新会话的数字是五次首次规划的中位数,每次都用新会话。每张表都有主键和 account_id 上的索引。规划器内存来自 PostgreSQL 17+ 的 explain (memory)。实验重新执行了表中的前三行。
在事务中执行 select count(*) from pt_N where account_id = 42 所持有的锁:
| 分区数 | 快速路径锁 | 共享锁表中的锁 |
|---|---|---|
| 12 | 40 | 0 |
| 365 | 64 | 1,035 |
| 1,000 | 64 | 2,940 |
| 3,000 | 64 | 8,940 |
每个后端进程都有少量快速路径锁槽,避免使用共享内存。在 PostgreSQL 18 中,槽数随 max_locks_per_transaction 增长(这里为 64);早期版本固定为 16。其余锁进入共享锁表(并发时会出现 LWLock LockManager 等待),容量约为 max_locks_per_transaction 乘以连接数。
38-partitioning分区表还有四个小陷阱
- 只按 id 查找会搜索每个分区。把时间放进 URL,或使用编码了时间的 id(UUIDv7 就是如此)。
- 自动清理永远不会分析父表。在过期数据处理任务中分析它。
- 更新分区键会移动行:一次删除加一次插入,绝不会是 HOT。选择不会变化的键。
- **表太小也做分区。**把 5 GB 的表拆成 365 个日分区,开销全有,收益全无。
本章要点
- 为数据生命周期而分区。删除一个月产生了 45 MB WAL 和 164,383 个死元组;删除对应分区,不到 150 KB。
- 分区不是 OLTP 加速器:不带分区键的查询会搜索全部分区,BRIN 则能取得时间范围查询的大部分收益。
- 按删除数据的依据分区,通常是时间;数量控制在几十到小几百个。
- 用半开区间直接比较分区键,并在
EXPLAIN中检查剪枝。 - 每个唯一键都必须包含分区键,引用也必须带上它。
- 用
detach ... concurrently和drop移除过期分区,先处理引用方,并设置lock_timeout。避免默认分区。 - 提前创建未来分区,快用完时告警。
- 改造现有表时,将它整体挂接为分区,先验证
check约束,让挂接跳过扫描。
延伸阅读
- Table partitioning,PostgreSQL 文档。声明式分区的参考资料、限制,以及分区数量的最佳实践。
- ALTER TABLE,PostgreSQL 文档。
ATTACH与DETACH PARTITION的确切锁行为、让挂接跳过扫描的check约束,以及CONCURRENTLY的规则。 - Query planning configuration,PostgreSQL 文档。
enable_partitionwise_join和enable_partitionwise_aggregate的作用,以及它们为什么消耗内存。 - CREATE TABLE,PostgreSQL 文档。
partition by和partition of语法,包括列表、哈希和默认分区。 - pg_partman,GitHub。提前创建分区并执行过期数据处理的常用扩展;阅读你所用版本的默认设置文档。
40 最后再考虑分片
我们为本章搭建了一个小型分片集群。同样是连接 projects 和 users,一种写法耗时约 10 毫秒,另一种约 950 毫秒。行相同,机器相同,结果也相同,区别只在于 on 子句里多了一项等式:u.account_id = p.account_id。有了它,每个分片在本地连接自己的行;没有它,集群就得先通过网络重新分配两张表的数据,而且默认会拒绝执行。
分片就是这样。每个查询,要么靠分片键留在本地,要么付出网络开销。选定分片键的那一天,你就决定了它会走哪条路。
我们认为,多数团队分片过早,而在分片之前就为它做好设计的团队又太少。从第一天起就为分片做好设计,然后能等多久就等多久。等到那一天,工具的重要性远不及分片键。
分片让一切成倍增加
分片把一个逻辑数据库拆到多个独立的主库上。分片(shard)是行的一个子集;分片键(shard key,也称分布列)决定一行落在哪个分片上。本章用的是 account_id,前面有一个路由器,知道每个账户在哪。
除按功能拆分数据库以外,这是扩展阶梯中唯一能抬高写入量和数据总量上限的一阶。代价是:PostgreSQL 原本在一台服务器内替你处理的所有事情,现在都被一道边界切开了:
- 查询不指定一个分片键值,就会发到所有分片,再合并结果;跨分片连接则要通过网络传送行。
- 跨分片的事务需要两阶段提交(two-phase commit)来保持原子性。
- 约束只管一个分片:
(account_id, email)可以唯一,单独的email却不行。 - 迁移与运维要做 N 遍:N 套副本、备份、清理积压,以及可能在凌晨 3 点发来告警的地方。
这都不是永远不分片的理由,而是提醒你:先确认其他选择更糟。
一个主库再也扛不住写入或装不下数据时,才分片
即便用了你愿意运维的最大机器,以下三个信号仍说明,一个主库已经扛不住你的写入,或装不下你的数据:
- 写入吞吐量碰顶:即使调优了WAL 和检查点,也做了批处理,写入仍让主库饱和。这里说的是写入,不是读取。
- 从运维角度看,数据已经超出单机容量:恢复时间超过恢复时间目标,清理永远追不上。
- 硬性要求必须隔离租户:数据驻留要求,或合同约定的专用硬件。这是应当提前分片的唯一情形。
以下都不是信号:“我们以后可能会很大”、慢查询、连接数、读取负载。先试成本更低的几级阶梯,包括经常被低估的那一级:按功能拆分。把 events 和写入它的程序迁到独立的数据库,两边仍然各自像一个 PostgreSQL 那样运作。
测量 WAL 生成速率(对 pg_current_wal_lsn() 间隔一分钟采样)、最大表每月的增长量,以及恢复时间。向前推算一年,与能买到的最大实例比较。如果三年后才会触及上限,你现在还没有分片问题,只需要在日历里设个提醒。
分片键就是整个设计的核心
选择分片键时,要让负载最高的查询,以及不能拆开的事务,都留在同一个分片上。好的分片键几乎出现在每个高频查询的过滤条件里,被一起连接或写入的行共用,而且取值众多、分布均匀。
对于多租户 SaaS,这就是租户 ID:应用一次服务一个账户,同一账户的行会相互连接,却从不与其他账户的行连接。若把 events 按 id 分片,每个“我这个账户的事件”查询都会访问所有分片;若按 created_at 分片,今天的所有写入都会落到同一个分片。跨租户报表则变成扇出(fan-out)查询:只要不常做,就没问题。
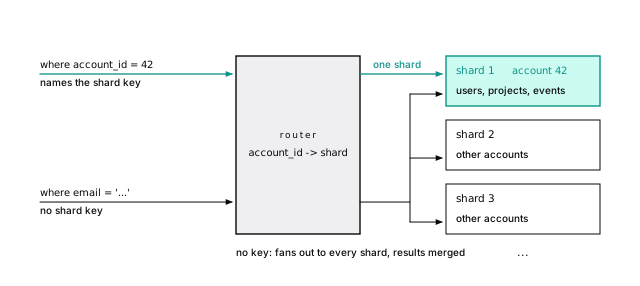
**哈希分散的是租户,不是负载。**一个客户的 CI 系统新增 400,000 个事件,就把它所在的分片从 13 MB 撑到了 61 MB,而哈希到这里的其他账户也共用这个分片。大租户需要独立分片,所以迁移单个租户必须成为日常操作。
共置(colocation)让连接留在本地。把 users、projects 和 events 用相同的方式按 account_id 分片,账户 42 的行就会放在一起,在本地连接——前提是连接条件包含分片键。这就是 10 ms 与 950 ms 的差别。每个租户都要读取的小表,则作为参考表(reference table)复制到每个分片上。
这是 citus_shards 中 events 的结果,按大小降序排列。如果一个租户单独就超过了最大机器的容量,还需要在租户内部再引入一个键;极少有产品走到这一步。
39-sharding.sh从第一天就留好余地
不实际分片,也能让将来的分片成本降低。同样的习惯还能让行级安全更简单,让跨租户的 bug 更难出现。每张属于租户的表都加上 account_id,每个主键、唯一约束、外键,以及每个查询的 where 子句都带上它(让租户无处不在、让跨租户引用不可能发生)。在单机上,这些复合键防止跨租户引用;分片后,只有这种键才能得到强制约束。
已经用了单列键?先在单机上逐步迁移:复合唯一约束、复合外键(先 not valid,再 validate),最后改查询。每一步本身都值得做。
分片表无法在整个系统内强制保证一个邮箱只对应一个账户。在一个未分片的数据库里保留一张小型 (email, account_id) 表,对 email 加唯一约束,先在这里占用邮箱,再到相应分片上创建用户。如果创建失败,就释放这次占用。没有两阶段提交,独立数据库就无法与用户创建共用一个事务,因此必须先占用,再用清理任务移除那些超过几分钟、却始终没有对应用户的占用记录。(在 Citus 中,可以用参考表保存占用记录,与用户创建在同一个分布式事务中写入。)分片前就要决定好。
按租户路由,绝不按 ID 路由
每个分片都有自己的序列,因此两个分片都会分配出 id = 1。如果 ID 要在数据库之外使用,就采用分片位(shard bits,用 bigint 的高位标识分片,类似 Snowflake)或 UUIDv7(无需协调,PostgreSQL 18 中有 uuidv7());ID 格式概览比较了其他选择。
用 16 位标识分片,每个分片就能分配 281 万亿个 ID。但 ID 说明的是一行创建时所在的位置,不是租户迁移后的所在位置:按租户路由,绝不按 ID 路由。
Citus 的标识列采用分片位。在协调节点(coordinator)和各工作节点(worker)上执行相同的插入(returning id, id >> 48 as node_bits):
每个节点的序列起点,都是该节点的组号左移 48 位。(协调节点属于组 0,因此它的 ID 看起来很普通。)
39-sharding.sh跨分片查询会扇出
查询不带分片键,就会发往每个分片,并由某个组件合并结果:求和可以直接相加,平均值需要总和与计数,limit 10 需要每个分片的前 10 条,去重计数需要拿到各个值。延迟取决于最慢的分片;32 个分片上每秒 100 次这样的查询,就是每秒 3,200 个任务。增加分片后,租户内查询给每个节点带来的开销会下降,扇出查询却不会。把它限于后台作业和内部工具。
跨分片事务需要两阶段提交
写入也有同样的边界。向两个分片写入,就是两个事务;如果其中一个失败,转账就只做了一半。两阶段提交会先让所有分片执行 prepare transaction,然后才允许提交。直到第二阶段,它都在各处持有锁;如果协调节点在两个阶段之间宕机,留下的预备事务(prepared transaction)会继续持锁,阻碍清理。普通 PostgreSQL 默认关闭这项功能(max_prepared_transactions = 0),postgres_fdw 也不使用它。最好的跨分片事务,是分片键让你根本不必执行的那一种。
在 Citus 上,一次没有租户过滤条件的更新,向两个工作节点先后发送了 PREPARE TRANSACTION 和 COMMIT PREPARED。在两条命令之间,每个工作节点都持有一个预备事务:它能跨重启保留状态,继续持有行锁,并阻止清理界限向前推进,直到有人提交或回滚它。Citus 会在自己的元数据中记录每个预备事务,由维护守护进程自行提交或中止残留事务;如果你自己实现 2PC,这就是你的工作,可以在 pg_prepared_xacts 中找出滞留的事务。
39-sharding.sh重新分片就是迁移租户
迟早会有一个租户需要独占一台机器。带行过滤的逻辑复制(PostgreSQL 15+,参见它的用途)会复制一个租户的行,然后持续传送变更。
有了租户目录——记录每个租户属于哪个分片的表——迁移只需四步:发布 where (account_id = 42) 所匹配的数据并订阅;延迟接近零时,把租户标为只读;延迟归零时,把目录指向目标;分批清理源端。只读窗口持续几秒钟。逻辑复制不复制序列,因此目标端生成的 ID 不能与迁入的 ID 冲突。这也是采用分片位或 UUIDv7 的又一个理由。
Citus(在 PostgreSQL 内部分片的扩展,下文介绍)的分片迁移,以及 PgDog(分片代理,下文介绍)的重新分片,都使用同一个协议。这很好地说明,选它作为基础机制是合适的。
PostgreSQL 负载有七种分片方式
七种方式的区别在于:路由在哪里,谁来合并跨分片结果,以及保留多少 PostgreSQL 功能。本节关于其他项目的每项事实,都取自截至 2026 年 10 月它们自己的文档;选定之前请再核查。我们运行了 postgres_fdw 和 Citus,因为两者都是开源软件,能在任何地方运行:便于演示,并非默认答案。
应用路由器把每个难题都交给你
你运行普通主库,由代码中的路由器查询每个租户所在的分片。托管或自建的 PostgreSQL 都行,但每个难题——合并、迁移、原子性——都归你解决。
哈希范围无需查询目录,却不能单独迁移一个租户。目录可以把每个租户放到任意位置;SaaS 就选它:
不提供账户 ID,就拿不到数据库句柄,因此任何查询都无法跳过路由。租户迁移的几秒内,目录仍可能过时,这正是 state 列的用途:状态变化时重载目录,并拒绝向标为 read_only 或 moving 的租户写入。**适合:**数量不多的大租户,以及无法安装扩展的托管 PostgreSQL。**成本:**扇出结果合并、迁移、模式变更工具,以及所需的两阶段提交,都要自己实现。
postgres_fdw 是一块积木
把哈希分区表的每个分区都设为另一台服务器上的外部表,父表就能把行路由到不同机器。租户内查询会把过滤条件下推到一台服务器;跨租户聚合则会把所有行拉回来。没有两阶段提交、约束或再均衡:它是一套零件,不是一辆整车。
在一个普通的 PostgreSQL 18 数据库上,指向 Citus 工作节点主机上的两个普通数据库(这里没有用到 Citus):
100 个账户的 50,000 行分别被路由成 26,000 行和 24,000 行。账户 42 的查询只向一台服务器发送 WHERE ((account_id = 42))。按分片键分组并启用 enable_partitionwise_aggregate 时,完整聚合会并发下推到两台服务器(async_capable,PostgreSQL 14+);按 kind 分组时,则把所有行拉回本地计数,因为 PostgreSQL 18 的 postgres_fdw 不下推部分聚合。
39-sharding.shCitus 在 PostgreSQL 内部路由与合并
Citus 是一个开源扩展(AGPL-3.0),把一组 PostgreSQL 服务器组成一个分布式数据库:你连接协调节点,工作节点保存分片,路由、合并、两阶段提交、DDL 和再均衡都由它代劳。
最新版本是 14.2.0(14.0 加入了 PostgreSQL 18 支持)。我们的集群使用 Citus 14.2.0,运行在镜像自带的 PostgreSQL 18.4 上;两个工作节点,按 account_id 划分的 32 个共置分片。租户内查询是在一个工作节点上执行的一个任务,跨租户查询是由协调节点合并的 32 个任务,而本章开头那个不带 account_id 的连接则被拒绝执行。
约束必须包含分布列
分片只能检查自己的行,因此 Citus 会拒绝任何不带分布列的主键、唯一约束或排他约束:原来的 primary key (id) 无法按 account_id 分布,unique (email) 也不行。外键必须通过分布列连接共置的表,或指向参考表。从第一天就采用的复合键全部得到了接受。
每张表通过哈希分成 32 个分片(citus.shard_count 的默认值);在笔记本电脑上的集群中,把一份 240 万行的 events 副本转为分布式表花了约十秒钟。(先分布,再添加外键;反过来会失败。)约束错误如下:
按类型统计账户 42 上周的事件:
任务内部是普通的执行计划(照常读它:1,100 个堆页,因为主键能找到账户 42,却无法筛选上周)。跨租户版本是 Task Count: 32,协调节点对 160 行部分结果求和。count(distinct ...) 和窗口函数未按 account_id 分区,则会把原始行拉上来。
不带 account_id 的连接报错:ERROR: the query contains a join that requires repartitioning。启用 citus.enable_repartition_joins = on 后,两个 MapMergeJob 先重新分配两张表的数据,再由 12 个任务执行连接:一个 count(*) 耗时约 950 ms,而加上 u.account_id = p.account_id 后约为 10 ms(这是笔记本电脑上的计时,重点在差距)。
39-sharding.shselect id from users where email = 'user4242@example.com' 在分片集群上是合法查询。它的计划显示 Task Count: 32:单机上一次索引查找能做完的事,现在每个分片都要查一遍。不会报任何错误。分片前后都要检查负载最高的查询的执行计划,把请求路径上的扇出视为 bug。
从 Citus 11 起,元数据会同步到工作节点,因此任何节点都能路由(按租户路由,绝不按 ID 路由中的工作节点插入就是这样);协调节点上的 DDL 则在一个分布式事务中传到每个分片:模式变更规则,乘以 32。
这给了账户 7 自己的分片(哈希范围只有一个值),也拆分了与之共置的 users 和 projects 分片。citus_move_shard_placement(..., shard_transfer_mode => 'force_logical') 通过逻辑复制迁移它们,期间仍允许写入:51 MB 用时约 2 秒。早先有一次实验,在线拆分因一个无法复现的重复键冲突而停滞,所以一定要在生产数据副本上演练;call citus_cleanup_orphaned_resources() 可以清理中断迁移留下的资源。再均衡器(citus_rebalance_start())从 Citus 10 起就已开源,Citus 11 又开放了非阻塞迁移。
Citus 12 及更高版本也能按模式分片(citus.enable_schema_based_sharding):每个模式成为一个位于单个节点上的共置组。我们的实验把 tenant_acme 和 tenant_globex 放在不同的工作节点上,在同一个模式内做连接只需一个任务。它也继承了下文所述每租户一个模式的成本。
39-sharding.sh代理让分片保持普通 PostgreSQL
分片代理放在通常放连接池的位置,解析每条查询,再把它发给正确的普通 PostgreSQL 主库,因此分片无需安装扩展。有三个项目公开了代码:PgDog、SPQR 和 Multigres。代理能合并哪些跨分片结果,取决于它目前的解析器支持什么;要拿自己的查询去测试。
- PgDog 自称 “an open source proxy for scaling PostgreSQL”(AGPL-3.0,Rust),也提供连接池和读取负载均衡。它用 PostgreSQL 解析器找出分片键,对其余查询做扇出与合并(部分
count、sum、min、max、avg及排序),支持两阶段提交,并通过逻辑复制协议重新分片。它的 README 说它 “is used in production and at scale”,但部分功能仍处于实验阶段。 - SPQR(Stateless Postgres Query Router)来自 Yandex Cloud 的数据平台团队,自称能为按分片键 “well splitted by a sharding key” 的数据库提供 “production-ready” 的 “single-shard OLTP queries”。
- Multigres 是 Supabase 与 Vitess 的一位联合创始人共同开发的 “a Vitess adaptation for Postgres”(Apache-2.0),“currently in the early stages of development”。
托管分片的代价是功能受限,也更难退出
三家服务商替你运行集群:Amazon Aurora PostgreSQL Limitless Database(自 2024 年 10 月 31 日起正式可用)、Azure Database for PostgreSQL elastic clusters(托管 Citus),以及 PlanetScale Neki(自 2026 年 9 月 10 日起进入平台预览)。你要接受服务商提供的版本和功能子集,退出也更困难(参见托管平台本身)。
- Aurora PostgreSQL Limitless Database:路由器持有元数据、拆解查询,并负责 “manage distributed transactions”;分片是 Aurora PostgreSQL 实例;表分为分片表(仅支持哈希)、参考表和标准表。自 2024 年 10 月 31 日起正式可用,发布时兼容 PostgreSQL 16.4。要求页面列出的限制包括:仅支持专用的
16.X-limitless引擎版本(目前列出的最新版是 16.13-limitless,没有 17 或 18 的构建版本);不支持可串行化隔离级别;分片键不可更新;可拆分但不可合并;只支持一部分扩展和 Aurora 功能。 - Azure Database for PostgreSQL elastic clusters 是 “a managed offering of the open-source Citus extension”,支持按行和按模式分片。更早的 Cosmos DB for PostgreSQL 同样基于 Citus,目前 “is on a retirement path and no longer recommended for new projects”。
- PlanetScale Neki 是 Vitess 背后的团队从头构建的 “sharded Postgres”:在普通 PostgreSQL 分片前放置无状态路由器,路由器包含完整的 PostgreSQL 解析器和分布式规划器(跨可用区至少部署三个),每个分片至少有两个副本。JSON 数据拓扑通过哈希(
xxhash)或整数range函数映射分片键;参考表和全局二级索引用于其他查找;重新分片采用带校验的在线复制与变更流传送流程。它在 2026 年 9 月 10 日进入平台预览(适用 beta 条款,无 SLA),文档也直陈不足:多分片读取不共用同一个快照;多分片写入逐个分片提交,没有两阶段提交;DDL 会扇出,但不具备原子性。single事务模式会拒绝任何需要访问第二个分片的事务。
Neki 的分片是普通 PostgreSQL,但它的路由器无法由你自行运行;elastic clusters 使用的扩展则可以自行托管。
分布式 SQL 会说 PostgreSQL 的话,却不是 PostgreSQL
CockroachDB 和 YugabyteDB 支持 PostgreSQL 协议及其大部分 SQL,但底下是不同的数据库:由 Raft 复制的小单元组成,能自行拆分和再均衡,内置分布式事务。本书关于页、清理和堆的论述描述的是 PostgreSQL,不是它们。选择其中一个,就是迁移到另一种引擎。
- CockroachDB 有自己的实现。其 v26.3 兼容性页面列出的不支持功能包括触发器、范围类型、外部数据包装器,以及会话级咨询锁;一些行为也有差异(整数除法返回小数)。事务默认使用
SERIALIZABLE。自 24.3 版本起,它采用专有的 CockroachDB Software License,并为较小规模的企业提供免费档位。 - YugabyteDB 在自有存储引擎 DocDB 上运行 PostgreSQL 查询层的一个分支。v2025.1 把这个分支的基线从 PostgreSQL 11.2 升到了 15.0,因此落后于当前的 PostgreSQL。数据库核心采用 Apache-2.0 许可证。
每租户一个模式,成本随租户数增长
技术上最简单的选择,是为每个租户分配一个模式,甚至一整个数据库,放在你想放的服务器上。结构本身就实现了隔离,迁移一个租户只需导出一次。成本随租户数增长:1,000 个租户,每个只有三张空表,还没存一行数据,就新增了 16,000 个关系和超过 40 MB 的系统目录;每次模式变更都要执行 1,000 遍,每一遍都有自己的锁,也有失败的可能。
按难题落在哪里来选择
每种方案都把难题移到别处
各种方案如何处理这些难题:
| 方案 | 路由所在位置 | 跨分片连接 | 跨分片写入 |
|---|---|---|---|
| 应用路由器 | 你的代码 | 自己写 | 自己实现(需要 2PC 就自己做) |
postgres_fdw | 路由数据库 | 拉到路由数据库 | 不具备原子性 |
| Citus | 协调节点或任意节点 | 共置时在本地,否则需显式开启 | 自动使用 2PC |
| 代理 | 代理中 | 由解析器支持范围决定如何合并 | PgDog:2PC |
| 托管服务 | 服务商的路由器 | 共置时在本地 | 因服务而异(注 1) |
| 分布式 SQL | 任意节点 | 支持 | 内置 |
| 每租户一个模式 | 你的代码 | 同一数据库内 | 同一数据库内 |
长期使用它们的成本:
| 方案 | 再均衡 | 运维负担 | 锁定程度 |
|---|---|---|---|
| 应用路由器 | 自己实现 | 高 | 无 |
postgres_fdw | 手动 | 高 | 无 |
| Citus | 在线迁移 | 中 | 低 |
| 代理 | 取决于工具 | 中 | 低 |
| 托管服务 | 服务负责(注 2) | 低 | 高(注 3) |
| 分布式 SQL | 自动 | 中 | 高 |
| 每租户一个模式 | 迁移单个租户 | 随租户数增长 | 无 |
托管服务一行的注释:(1)Limitless 和 elastic clusters 的跨分片写入具备原子性;处于预览阶段的 Neki 则逐个分片提交。(2)Limitless 能拆分分片,却不能合并;Neki 能在线重新分片。(3)Limitless 和 Neki 的锁定程度高,elastic clusters 较低,因为它使用的 Citus 可以自行运行。“代理”指 PgDog 及前述其他项目;Citus 的“任意节点”能力始于 Citus 11。自行构建的方案运维负担高,因为你要运行 N 个主库,加上自己开发的工具;代理在关键路径上增加了一个服务;分布式 SQL 则是一种需要重新学习的数据库。
多数团队还不需要分片
- 你还不需要分片:如果更大的机器、副本、分区,或拆出一项负载能再撑两年。多数团队都属于这种情况。
- **几十个大租户,或有数据驻留要求:**每租户一个数据库,或者带目录的应用路由器。
- **许多租户共用表,希望由 PostgreSQL 合并结果:**自建或托管的 Citus(Azure elastic clusters),或者采用分片代理,让分片无需安装扩展。两种方案都做原型测试。
- **深度依赖 AWS,也接受它的功能子集:**Aurora PostgreSQL Limitless Database。先读它不支持的功能清单。
- **想在普通 PostgreSQL 上使用托管路由器,暂时不要求跨分片写入原子性:**预览阶段的 PlanetScale Neki。先读它的限制。
- **比起完整兼容性,更看重多地域写入或自动重新分片:**分布式 SQL 数据库,同时明白它是另一种引擎。
无论考虑哪一种,都拿最重要的十条查询去运行,并阅读执行计划。
本章要点
- 最后再分片。除按功能拆分以外,这是唯一能让写入量和存储容量超越单机的一级阶梯,也会让每个跨分片查询、事务、约束和模式变更都更难。
- 真正的信号是:写入让最大的主库饱和,数据多到无法在 RTO 内恢复,或存在数据驻留要求。不是读取负载,也不是“将来某一天”。
- 多租户 SaaS 按租户 ID 分片,从今天就开始准备:每张租户表、每个键、每条查询都带上
account_id。 - 按分片键做共置连接,就能留在本地:把
account_id写入on子句时约 10 ms,没有时约 950 ms。 - 邮箱之类需要全局唯一的值,都需要独立的未分片表。
- 为迁移热点租户做好准备:目录,加上带行过滤的逻辑复制。
- 按路由、合并和两阶段提交应放在哪里来选择方案,并检查负载最高的查询的计划中是否存在扇出。
延伸阅读
- postgres_fdw,PostgreSQL 文档。外部表、下推、
async_capable,以及不支持两阶段提交的说明。 - Citus,源码仓库。本章所用的扩展、许可证,以及按行和按模式分片。
- Aurora PostgreSQL Limitless Database architecture,AWS 文档。路由器、分片和表类型;同时阅读旁边的要求页面。
- PgDog,源码仓库。从分片代理的角度介绍路由、合并、两阶段提交与重新分片。
- Neki query planning,PlanetScale 文档。路由器如何选择一个分片或所有分片,以及跨分片操作不提供哪些保证。
- CockroachDB PostgreSQL compatibility,CockroachDB 文档。具体差异清单。
41 PostgreSQL 输在哪里
此前的每一章都在展示,一个 PostgreSQL 能走多远。文档、队列、搜索、向量、时序、租户,还有把整表扫描变成十来页读取的汇总表。多数产品从来不需要别的数据库,我们依然坚持这个判断。
但“多数”不是“全部”,只讲一面的书没有告诉你真相。某些负载在另一类系统上能快一个数量级,原因就在 PostgreSQL 存储和搬运数据的方式里。你应当知道是哪些负载、原因何在、界限大致在哪,这样引入第二个数据库时,才有可以测量的理由。
我们用相同的两百万条事件,在 PostgreSQL 和两个列式存储系统上测量差距最大的一项:分析查询。然后梳理其余差距,并给出引入新系统的一条规则。
行式存储为了用两列,必须读取所有列
PostgreSQL 按行存储。每个堆页都保存完整的行,连同行首部一起(每个页都有相同的布局)。这非常适合“取出这个订单”和“更新这个用户”:一个页里,就有需要的所有列。
分析查询的需求恰好相反。“按类型和日期统计全年每天的事件数”会访问每一行,却只用两列,而行式存储仍要读取每一页。列式存储(column store)将每一列分别压缩后保存在各自的文件里,只读取查询指定的列。下面是实测出的差距。
每个系统返回的答案逐行相同
实验运行以下系统,每个都限制为 3 GB 内存:载入本书种子数据的 PostgreSQL 18.6;面向列的数据库服务器 ClickHouse 26.8(镜像标签 26.8.18.2);嵌入式列式引擎 DuckDB 1.5.6;以及另一台装有 pg_duckdb 扩展的 PostgreSQL 18.1(pg_duckdb 镜像自带的版本)。它们都是开源软件,由同一个 docker compose 文件启动,各自代表一类系统。
为了公平对待 PostgreSQL,实验还创建了 events_flat,将 payload 中的字段展开为具有具体类型的列。接着运行三条仪表盘查询:每天各类型的事件数、每个地域的 duration_ms 的 p95,以及 20,000 个项目中最繁忙的十个。三个系统的答案逐行一致。若比较的是不同答案,基准测试就什么也没测出来。
每个系统都用自己的方言(ClickHouse 用 toDate 和 quantileExactInclusive,DuckDB 用 quantile_cont):1,826 个类型与日期的组合,计数相同,p95 相同(各地域均为 4,745 至 4,749 ms),最繁忙的十个项目相同,平均值也相同。ClickHouse 中的表使用 MergeTree,按 (project_id, created_at) 排序,短文本列按文档建议采用 LowCardinality(String);DuckDB 则与 PostgreSQL 一样,使用普通类型和主键。
40-limits.sh列式存储只占十分之一的字节数
同样的两百万行,磁盘占用如下:
| 系统 | 大小 |
|---|---|
PostgreSQL,events(jsonb),堆 + 索引 | 317.8 MB |
PostgreSQL,events_flat,堆 + 索引 | 220.9 MB |
| ClickHouse,压缩后的数据片段 | 32.1 MB |
| DuckDB,数据库文件 | 33.3 MB |
列式存储占用的字节数,不到字段拆列后的 PostgreSQL 表的五分之一(大约七分之一),约为本书原有存储方式的十分之一。PostgreSQL 的两个大小都包含 id 上的主键索引;DuckDB 的文件也包含自己的主键,而 ClickHouse 没有这样的索引需要存储。
差距来自两方面。字段拆列后的表,其堆有 22,784 页、178 MB,其中一半都是管理开销:按 ClickHouse 的统计,值本身约 92 MB,而且其中的短文本列已经做了字典编码;每行还要加上 24 字节首部、一个行指针和填充字节(一行的成本高于它的列),这是 MVCC 的代价。另一方面,相似的值放在一起,能压缩到几乎不占空间。
project_id:15.3 MB 的值(每行 8 字节)压缩成了 0.2 MB。表按项目排序,因此列文件中会有长段连续相同的值;account_id 和 user_id 随项目排列,也能很好地压缩。看起来随机的 duration_ms 几乎压不小。列式存储的压缩并非魔法:相似的值挨在一起,自然会这样,而排序键决定哪些值能挨在一起。把 payload 拆成类型列,让 PostgreSQL 的体积缩小了三分之一,因为 jsonb 会在每一行重复存储每个键名,但即便如此仍然相差很远。
40-limits.sh每条查询,PostgreSQL 都读取了所有页
每条查询,PostgreSQL 都读取 events 的全部 35,173 页,共 275 MB,尽管每条查询只指定了两列。ClickHouse 同样读取了全部 2,000,000 行,但只读指定的列,而且是压缩后的数据:
| 查询 | PostgreSQL 读取量 | ClickHouse 读取量(压缩后) |
|---|---|---|
| 每天各类型事件数 | 275 MB | 14.6 MB |
| 各地域 p95 | 275 MB | 6.9 MB |
| 最繁忙的项目 | 275 MB | 6.0 MB |
p95 查询指定了 region 和 duration_ms,ClickHouse 恰好读取了 10,000,000 字节的列数据,每行 5 字节(从磁盘取出时是压缩后的 6.9 MB)。为了取得同样的 5 字节,PostgreSQL 每行读取了 144 字节。
一个数字就说明了整个机制。行式存储每次扫描都要为整行的宽度付费;列式存储只为问题涉及的宽度付费。
并行工作进程会对少量页重复计数,因此 explain 报出的页数最高为 35,257。字段拆列后的 events_flat 只是因为体积更小而有所帮助:22,784 页,每次仍然全部读取。
ClickHouse 的数据来自 system.query_log:每条查询的 read_rows 和 read_bytes(未压缩的列数据),再加上表示磁盘读取量的 ReadCompressedBytes 性能分析事件。未压缩时,三条查询分别读取 17.2、9.5 和 22.9 MB;最繁忙项目查询读取的列数据最多(两个 8 字节列),却压缩得最好,因为 project_id 是排序键。压缩后,各查询读取量约为 PostgreSQL 的 275 MB 的 5%,甚至更少。
40-limits.sh列式存储快约十倍,单核上仍然更快
字节数是证据,时间则是用户的感受。下面是实验一次运行中,缓存预热后测三次取最快值的结果,单位为毫秒:桌面电脑上的 Docker,容器可见第 13 代 Intel i9 的 8 个核心、16 GB 内存,与其他数据库共享。每个系统都在服务端自行计时,丢弃结果:PostgreSQL 在 PL/pgSQL 函数中用 clock_timestamp() 包住每条查询;ClickHouse 从查询日志取时间;DuckDB 用命令行的 .timer。
PostgreSQL 的默认配置有意保持保守,因此实验用了三种方式。默认:默认设置,work_mem 为 4 MB,导致 p95 排序溢写磁盘,最多使用两个并行工作进程。字段拆列:相同设置,表换为 events_flat。调优:使用 events_flat,设置 work_mem = '256MB'(不再溢写),并允许最多八个并行工作进程。这是我们能给它的最公平的行式存储基线。
| 毫秒,默认设置 | 每天各类型事件数 | 各地域 p95 | 最繁忙的项目 |
|---|---|---|---|
| PostgreSQL,默认 | 324 | 816 | 158 |
| PostgreSQL,字段拆列 | 312 | 675 | 108 |
| PostgreSQL,调优 | 354 | 474 | 82 |
| ClickHouse | 43 | 16 | 15 |
| DuckDB | 57 | 6 | 13 |
调优后的 PostgreSQL 执行三条查询合计耗时 910 ms;ClickHouse 用了 74 ms,DuckDB 用了 76 ms,快约十二倍。第一个查询中,更多工作进程没能帮上 PostgreSQL:规划器只用了其中几个,跨进程分配行的开销与省下的时间大致相当。
列式存储默认使用所有核心,因此实验又在各用一个核心的条件下重跑了一遍(PostgreSQL 不使用并行工作进程):
| 毫秒,各用单核 | 每天各类型事件数 | 各地域 p95 | 最繁忙的项目 |
|---|---|---|---|
| PostgreSQL,默认 | 313 | 1,087 | 363 |
| PostgreSQL,字段拆列 | 315 | 675 | 199 |
| PostgreSQL,调优 | 334 | 474 | 191 |
| ClickHouse | 81 | 26 | 24 |
| DuckDB | 278 | 22 | 15 |
单核上,调优后的 PostgreSQL 合计耗时 999 ms,ClickHouse 为 131 ms(快约 7.6 倍),DuckDB 为 315 ms(快约 3.2 倍)。第一个查询的差距几乎消失:按天把时间戳分桶时,单核 DuckDB 仅比 PostgreSQL 快一点。其余两个查询的差距仍然很大。精确 p95 是最极端的例子:即使排序完全在内存中,PostgreSQL 仍要逐个元组对两百万个值排序,而列式存储遍历的是紧凑、已经解码的整数列。
一个小数据集、三条查询、一台机器、一次运行,只调了 PostgreSQL 最明显的几个设置,列式存储则保持默认配置。它展示的是一种机制和一个数量级,既不能判定哪个列式存储更快,也不能代表你的数据扩大一百倍后的情况。如实测量一章给出了自己做测试的规则。
三种机制,而且效果会叠加。
**布局。**列式存储的开销随查询访问的列而增长,而不是随表的宽度增长。PostgreSQL 的开销随页数增长,每个页又包含完整的行。
**压缩。**一列只保存一种类型的值,常常有序或重复,因此低开销的编解码算法就能有很好的效果(根据 CREATE TABLE 文档,自建 ClickHouse 服务器默认使用 LZ4;根据存储文档,DuckDB 会在字典编码、游程编码和位打包编码之间选择)。PostgreSQL 只通过 TOAST 逐个压缩大值(大值会先压缩,再移出行外)。100 字节的行根本不会被压缩。
向量化执行(vectorized execution)。两个列式存储都一次处理一列中的一批值,用紧凑循环让 CPU 流水线发挥作用。PostgreSQL 的执行器则逐行从每个计划节点拉取数据,解构每个元组以找出其中的列。OLTP 查询只访问几行时,这样很好;两百万行都这么做,就全是开销。
40-limits.sh列式存储牺牲的,恰是应用数据库的职责
为了换取速度,列式存储牺牲的恰是应用数据库要做好的事。实验检查了四项:
- **点查。**PostgreSQL 按
id找一个事件,读取 4 页。ClickHouse 只为排序键(project_id, created_at)建索引,因此按id查找会读取全部 2,000,000 行;即便按排序键查找,也会读取整个包含 8,192 行的粒度单元(granule)。 - **约束。**ClickHouse 的主键只规定排序,不作唯一性保证:它存下了第二个
id为 1 的事件。(DuckDB 会强制检查键约束,因此拒绝了它。) - **更新与事务。**在 ClickHouse 中更新一个事件,重写了一个含 2,000,000 行的数据片段(part);PostgreSQL 只写了 264 字节 WAL。
begin transaction返回 “Transactions are not supported”。 - **并发写入者。**DuckDB 在你的进程内部运行,只有一个进程可以写入:第二个进程得到 “Could not set lock on file”。
列式存储最适合的是一张主要追加写入的宽表。你的应用数据模式恰好相反。
ClickHouse 在文档中描述了稀疏索引,并明确说明:主键允许多行具有相同的值。它在插入时检查 CHECK 约束;表的文档中没有外键之类的机制。其文档将变更操作(mutation)称为 “a heavy operation not designed for frequent use”,默认异步执行。也有更轻量的选择:轻量 DELETE 先隐藏行,直到合并时再移除;轻量 UPDATE 写入小型补丁片段,目前标为 beta,需要开启两项表设置。它们有帮助,但不会把 ClickHouse 变成 OLTP 存储。事务需要 ClickHouse Keeper(事务指南)。连接也能做,有多种算法可选,但连接指南建议使用反规范化、字典和物化视图,并提醒:哈希连接需要把右表放进内存。
DuckDB 的并发文档描述了单写入者模型。它对多写入者的回答是 Quack:一种客户端—服务器协议,2026 年以 beta 扩展发布,计划随 DuckDB 2.0 走向成熟(公告)。就目前而言,嵌入式分析引擎非常适合报表、交互式笔记本或流水线中的一个步骤,却不适合让一百台应用服务器同时向它写入。
40-limits.sh40-limits.sh40-limits.sh汇总表和列式扩展能大幅缩小差距
添一台服务器之前,先在 PostgreSQL 内试两件事。
**汇总表。**如果问题事先已知,就提前算好。按类型和日期做每日汇总,只有 1,826 行、12 页,却能给出与扫描 35,173 页相同的答案(预先算好要展示的内容)。没有哪个列式存储能胜过只读 12 页。问题变成临时分析时,汇总表就帮不上忙了。
以扩展形式提供的列式引擎(目前的选择)。pg_duckdb 在普通 PostgreSQL 表上运行 DuckDB 的向量化执行器。p95 查询快了约五倍,答案相同;另外两个查询几乎没变(最繁忙项目查询还稍慢了一点)。它仍然读取了字段拆列后的表副本的全部 22,752 个堆页(在独立服务器上,因此与前面的 22,784 页略有不同),所以使用自己列式文件的 DuckDB 还能再快约六倍(三条查询合计 76 ms,对比 474 ms)。向量化执行解决 CPU 这一半,只有列式存储才能解决 I/O 那一半。
一台 pg_duckdb 服务器上三条查询的耗时,单位为毫秒:
| 毫秒,同一服务器 | 每天各类型事件数 | 各地域 p95 | 最繁忙的项目 |
|---|---|---|---|
| PostgreSQL 执行器 | 292 | 623 | 92 |
| DuckDB 执行器 | 252 | 113 | 109 |
| DuckDB,自有文件 | 57 | 6 | 13 |
因此,这种执行器最适合搭配列式文件:对象存储中的 Parquet 或 Iceberg,或者 pg_mooncake 那样的镜像。另一种方式是列式表访问方法(Citus 和 Hydra 都有),直接按列存储表。Citus 的实现只允许追加写入,README也如此说明:在 PostgreSQL 18.4 上运行 Citus 14.2 时,对列式表执行 update 失败,报错 “UPDATE and CTID scans not supported for ColumnarScan”。TimescaleDB 的列式存储会把超表的旧数据块转换成压缩列;前文实测时,它把本书的事件从 324 MB 缩到了 30 MB,与这里的列式存储处于同一数量级。
40-limits.sh四个条件同时成立时,再把分析移出去
如果是两亿多条事件,相同的扫描就要读取约一百倍的页。这是算术推算,不是实测,但正是这种算术,让一次仪表盘查询变成了喝杯咖啡的等待。
四个条件同时成立时,再把分析移出去:查询是临时提出的,会扫描大表的大部分数据,数据以追加写入为主,而在主库或副本上运行它们会造成可以测量的损害。在此之前,带汇总表的副本能长期支撑报表。迁出之后,列式存储也只是从 PostgreSQL 接收数据的副本,绝不能成为行诞生的地方。
其他差距,只有规模上来才显现
分析查询是我们能在笔记本电脑上测出的差距。其他差距要到规模上来才显现,因此对每一项,我们都会说明机制、表现更好的系统类别和分界线;依据是资料,而非基准测试。提到的名字只是某类系统的例子,不是推荐。
搜索:PostgreSQL 排名不使用语料库统计信息
PostgreSQL 的排名函数 “do not use any global information”(Ranking Search Results),并且会读取每个匹配项。Elasticsearch、OpenSearch 这类引擎用语料库统计信息评分(BM25),增加同义词和分面功能,并对索引分片。分界线是:相关性已经成为有人专门负责的产品功能(参见何时 PostgreSQL 已经够用;先试 BM25 扩展)。
缓存:数据库不是缓存
让 PostgreSQL 在自己前面充当缓存,会被自身机制拖累:每个连接都是一个进程,每次写入都是一个新行版本(更新就是插入),数据不会自行过期,而且还与它本该保护的数据库共用一台机器。Valkey(采用 BSD 许可证的 Redis 分支)和 Redis 这类存储把数据放在内存中,支持生存时间,并允许调节持久性。分界线是:请求速率高到连接和单次写入开销已在测量中显现;在此之前,用不记日志表就好。
流:表不是日志
PostgreSQL 中的作业队列很好用。但供许多消费者使用、保留多日的事件日志就不合适了:消费会产生死元组,每个消费者的位置都要靠你自己实现的游标记录。Apache Kafka 这类日志系统在消费之后仍保留事件(根据主题配置,默认七天),各消费者可以按自己的节奏读取。通过 Debezium 这类 CDC 工具,从逻辑解码向它传送数据,不要再额外写一次。分界线是:需要扇出,以及以天计的重放。
时序:写入路径就是瓶颈
BRIN 和分区很适合处理按时间排序的数据(时序适合 BRIN 和按月分区)。摄入速率极高时,写入路径成了瓶颈:每行 24 字节的首部,每次单行插入约 600 字节 WAL(所有写入都汇入同一条 WAL 流),每个副本只有一个重放进程(重放只有一个进程)。时序数据库把数据批量写入压缩的列式块;TimescaleDB 在 PostgreSQL 内部完成这件事(有主张的分区)。分界线是:即使做了批处理,WAL 或重放仍跟不上摄入速度。
全球写入:每次提交都要付出往返时间
悉尼的用户向弗吉尼亚写入,每次提交都要承受一次往返延迟;地域级故障切换还可能丢失尚未传送的数据。分布式 SQL 数据库(Spanner、CockroachDB、YugabyteDB;后两者支持 PostgreSQL 协议,但有差异)通过共识提交,能承受一个地域的失效。它们无法打破物理规律,只是选择把往返开销放在哪里。分界线是:确实需要多大陆低延迟写入,或地域故障时零数据丢失。
向量:可建索引的列最多 2,000 维
pgvector 让相似度搜索就在数据旁边完成(向量搜索会找到临近的点,不在乎文字是什么),但也有限制:可建索引的列最多 2,000 维(使用 halfvec 时为 4,000 维,见 pgvector README),而过滤条件与近似索引会相互掣肘。专用向量数据库会分布式存储并量化索引。分界线(何时该用它)是:数亿个向量,或者索引比最大机器的内存还大。
图:每一跳仍是一次连接
递归 CTE 和闭包表可以处理树和少量跳转(Postgres 用三种方式存储图),但每一跳都是一次连接,指数增长的搜索前沿会让每次连接越来越大。图数据库直接沿存储好的关系走;Apache AGE把 openCypher 带进 PostgreSQL,但每一跳仍然是连接。分界线是:在大规模稠密图上运行图算法,或在请求路径上做多跳匹配。组织架构图远没到这个程度。
二进制大对象:字节应放进对象存储
存进去的每个字节都要经过 WAL,进入每个副本、备份和恢复过程。一张经过 TOAST 存储的 20 MB 图片,即使只为了生成缩略图,也得完整读取。对象存储放在 CDN 后面,可以容纳数十 TB 的对象(Amazon S3 为 50 TB)。分界线很低:超过几 KB、又不需要当作数据查询的内容,从第一天起就放进桶里,把元数据留在 PostgreSQL 的一行中。
用到之前,先认清信号
| 负载 | PostgreSQL 靠什么能走很远 | 引入另一系统的信号 | 系统类别 |
|---|---|---|---|
| 分析 | 汇总表、分区、副本、pg_duckdb | 扫描大表大部分数据的临时分析损害 OLTP | 列式存储 |
| 搜索 | tsvector、GIN、BM25 扩展 | 相关性已成为产品功能;需要对海量结果做分面 | 搜索引擎 |
| 缓存 | 主键、不记日志表 | 请求速率高到连接和写入开销显现 | 内存键值存储 |
| 事件流 | skip locked 队列、事务发件箱 | 扇出、保留多日、重放 | 分布式日志 |
| 时序 | BRIN、分区、TimescaleDB | 批处理后,摄入速度仍超过 WAL 与重放的承受能力 | 时序数据库或列式存储 |
| 全球写入 | 一个主库、只读副本 | 多个大陆上的低延迟写入、地域失效 | 分布式 SQL |
| 向量 | pgvector、halfvec、量化 | 数亿个向量,索引超出内存 | 向量数据库 |
| 图 | 递归 CTE、ltree、闭包表 | 大图上的多跳遍历和图算法 | 图数据库 |
| 二进制大对象 | 元数据行 | 几乎总是:超过几 KB 的文件 | 对象存储 |
有实测理由,再引入第二个系统
这张表的每一行都有相同的结构:一种机制、一个信号,以及一个可以测量的数字。这就是规则。
能说清 PostgreSQL 缺少什么特性,并拿出测量结果证明需要它时,再增加一个系统。“p95 仪表盘查询要扫描 300 GB,花四分钟,而且每周的问题都在变”,这是理由。“我们迟早会需要分析”,不是理由。也要如实核算第二个系统的成本:又多一个需要备份、升级、保障安全,并在出问题时叫人处理的东西。
**让 PostgreSQL 始终作为权威数据源。**一行数据在 PostgreSQL 的事务中诞生,接受约束检查。索引、缓存、列式存储和流都由它派生,也都能从它重建。
**用变更数据捕获(change data capture,CDC)向外传送数据,不做双写。**先写 PostgreSQL,再写第二个系统,两次写入之间可能失败,而且无人察觉。用逻辑解码读取已提交的变更流(并监控复制槽),或者在同一个事务中写入一行事务发件箱记录。让消费者具有幂等性:某些变更会被它们看到两次。
从 PostgreSQL 起步不会把你锁死。借助逻辑解码和事务发件箱,可以在 PostgreSQL 旁搭起列式存储或搜索引擎,回填历史数据,持续传送变更,比对结果,再逐条查询地把读取迁过去。反过来,过早引入第二个数据库之后,要撤回这个决定就困难得多:两边数据已经偏离,写入代码也散落各处。
凭证据离开
这条规则,就是最后再重申一次本书的两个习惯。
**数一数页面。**本书开头的查询访问了 35,173 页,却几乎没返回什么。到这里,同样的 35,173 页,只为回答关于两列的问题而读取,就成了把分析迁出去的理由;若用汇总表的 12 页回答同一个问题,就可以留在原地。
**先用数据证明,该换更大的机器了。**第二个数据库是最大的一台“机器”,还自带一套值班告警,也必须通过同一道关。
这两条合起来,就是本书开篇的原则:从一个数据库开始,凭证据离开。多数时候,证据会让你留下。逐页读懂一个 PostgreSQL,它能走得比名声所及更远。等证据告诉你该走时,你也会知道为什么,理由就在数字里。
本章要点
- 行式存储读取每行的所有列:我们的三条查询,每条都读取 35,173 页,无论只指定了多少列。
- ClickHouse 和 DuckDB 存储相同事件所用的字节数不到五分之一,每条查询的读取量不到十分之一,响应速度比调优后的 PostgreSQL 快约十二倍;单核上分别快约七倍和三倍(我们的机器,一次运行)。
- 列式存储牺牲了应用所需的能力:点查、强制键约束、低成本更新、事务、并发写入者。
- 先试折中办法:汇总表(12 页,而非 35,173 页)、专供报表的副本、pg_duckdb。
- 搜索、缓存、流、极高摄入速率、全球写入、海量向量、深层图和二进制大对象,各自都有相应的机制和信号;用到之前先了解。
- 只有能说清需要的特性,并能测出相应数字,才增加系统,而且要让 PostgreSQL 继续作为权威数据源。
- 数一数页面,先用数据证明该换更大的机器,从一个数据库开始:只有证据充分,才离开。
延伸阅读
- Parallel query,PostgreSQL 文档。PostgreSQL 何时使用多个进程扫描,以及限制它的设置;这些因素决定了行式存储在本章这类基准测试中的表现。
- Logical Decoding,PostgreSQL 文档。所有 CDC 工具赖以构建的变更流。
- A Practical Introduction to Primary Indexes,ClickHouse 文档。粒度单元、稀疏索引,以及为什么排序键就是整个设计的核心。
- Concurrency,DuckDB 文档。嵌入式引擎在进程之间能够、不能够共享什么。
- pg_duckdb,DuckDB 项目。在 PostgreSQL 内部运行 DuckDB 执行器,以及通过 SQL 读取数据湖格式。
- Debezium connector for PostgreSQL,Debezium 文档。从 PostgreSQL 捕获变更数据的完整参考:复制槽、快照及故障模式。
- What Goes Around Comes Around… And Around…,Michael Stonebraker 和 Andrew Pavlo,SIGMOD Record 2024。为何专用系统不断出现,关系模型又不断吸收它们。
42 检查清单
检查清单,就是去掉论证的这本书:每个习惯一行,都链接到说明理由的小节。各节遵循实战手册的顺序,先用成本最低的办法(顺序就是方法)。找出昂贵的工作,修好计划、索引和模式,做好日常维护、连接和配置,之后才考虑换更大的机器。
从上往下做。只有测量证明某项没问题,才跳过它;不能因为后面的项目看起来更容易就先跳过去。最后一节留给数据库已经很慢的那一天。
动手修之前,先找出昂贵的工作
你想到的那条慢查询,很少就是成本最高的那条。先测量,每次改动后继续测量。
- 安装
pg_stat_statements并开启track_io_timing = on(设置方法),在繁忙时段取两份快照,比较差值(快照与差值)。 - 按总耗时和每次调用访问的共享块数给语句排名(四种排名)。
- 在造成问题的负载下采样等待事件,说清楚受限的资源是什么(等待采样)。
- 改动前先写一句话:瓶颈是 X,因为 Y 显示 Z(找出昂贵的工作)。
- 每次只改一件事,在具有生产数据特征的数据上,用相同负载测量改动前后的结果(端到端测量)。
- 每次修复都记录前后每次调用访问的页数;从 35,249 到 91,就是一条好记录(第一个索引)。
审查的是计划,不是代码
一条看似无害的 ORM 调用,可能读取整张表。每条随请求执行的查询,上线前都跑一次 explain (analyze, buffers)。
- 在具有生产数据特征的数据上运行计划;写入语句用
begin和rollback包起来(EXPLAIN 负责猜测;EXPLAIN ANALYZE 负责运行)。 - 先读
Buffers行,比较访问的页数与返回的行数(缓冲区才是证据)。 - 评价一个节点前,先把
actual time和rows乘以它的loops:70 ms 乘以loops=20,就是 1.4 秒(乘上循环次数;缓冲区已经是总数)。 - 自下而上比较估算行数与实际行数;找到最底层偏差达到十倍或以上的节点,先修它的估算,再管上面的节点;相关列用扩展统计信息(扩展统计信息)。
- 索引列保持裸列:不套函数或类型转换,参数采用该列的类型(列上的函数、隐式类型转换)。
- 时间范围写成半开区间(日期范围)。
- 用匹配索引的键集分页,绝不做很深的
OFFSET(OFFSET 会读取它跳过的每一行)。 - 把 N+1 循环换成连接、一个
= any($1)数组,或lateral(N+1 是一个循环,不是慢查询)。 - 在代码里搜索
not in (select,逐个改成not exists,这样子查询返回 NULL 时也正确(NOT IN 是陷阱;使用 NOT EXISTS)。 - 不要每个请求都对大表做
count(*):用估算、设上限,或读取汇总表(精确计数)。 - 若跨两个连接表的
or让计划任意一侧出现顺序扫描,就改写为两个走索引的查询的union(跨连接使用 OR 会击败两个索引)。 - 用 CTE 改善可读性,只有明确需要时才加
materialized(只使用一次的 CTE 会被内联,而不是设栅栏)。 - 应用的插入或更新用
on conflict,批处理作业用merge,重试写入用幂等键(幂等键)。 - 读—改—写的算术放在 SQL 中做,不要在应用里算(读已提交)。
- 按批提交:在线表每几千至几十万行一批,绝不逐行提交;大批数据用
COPY加载(每批提交一次)。 - 只选择要展示的列;大值放在 TOAST 中(大值会先压缩,再移出行外)。
- 只有逻辑能缩减数据量、保持规则的原子性或省下一次往返,才留在主库;格式化放在应用里(我们的立场)。
- 预备查询在调用五次后变慢,就怀疑通用计划(预备语句)。
- 索引扫描丢弃了大部分读到的数据,其上的
Limit就值得怀疑;为过滤条件建索引(Limit 押注于尽早找到行)。 - 绝不让事务跨着网络调用或用户思考时间保持打开(长事务)。
吃过一次亏才会记住的边界
下面这些语句都能运行,返回看似合理的结果,或规规矩矩地报错,却往往让团队吃过一次亏才记住。在审查时抓住它们,让意外发生在测试里。
能运行,却不正确的 SQL
- 要的是实际时钟时间,就用
clock_timestamp();now()是事务开始的时间(时间戳)。 - 整数相除前,把一侧转换为
numeric;7/2是 3(除法、|| 与 NULL 排序)。 - 拼接可能含 NULL 的字符串,用
concat_ws()或coalesce(),不要直接用||(同节)。 - 可空列按最新在前排序时,加上
nulls last,服务这个查询的索引也要加(同节)。 - 按所有选出的列或主键分组;任意值都行时,明确写
any_value()(其他小差异)。 - 按键选取批次来更新;没有
UPDATE ... LIMIT(回填)。 - 跳过没有任何变化的更新;空操作仍会写入一个行版本及其 WAL(WAL 从哪里来)。
事务
- 记住:一个错误会中止整个事务;用
on conflict避免它,或用保存点限制影响(一个错误就会中止)。 - 不要在循环里放保存点、异常块和 ORM 嵌套事务;一个事务里超过 64 个,所有会话都要付出代价(子事务)。
- 只对
40001和40P01重试整个事务,使用有上限、带抖动的退避;其他错误不重试(重试)。 - 锁父行用
for no key update,除非要删除它或修改它的键;for update会阻塞子行插入(行锁)。 -
truncate只留给暂存表和测试;旧快照会看到空表(删除只给行盖章)。
索引要对得起写入成本,否则就删掉
每个索引都是一场押注:换来某些查询更快的读取,但只要它还在,每次写入就得交税。每个索引都要说清自己服务的是哪条查询。
- 从查询出发设计:等值条件列在前,接着一个范围列或排序列,并说清服务的是哪条查询(逐步设计)。
- 只有少数取值的列,不要单独建索引(为什么 2% 的行会读到 68% 的表)。
- 对热点子集用部分索引,把谓词写成字面量(部分索引)。
- 查询必须用某个表达式时,就建表达式索引,例如
lower(email)(表达式索引)。 - 日期表达式固定时区,例如
((created_at at time zone 'UTC')::date);绝不为通过检查就把函数标为immutable(为什么 created_at::date 不能建索引)。 - 在语言学排序规则下,
like 'abc%'用text_pattern_ops索引,'%abc%'用三字符组(前缀搜索)。 - 用
include覆盖热点查询,不求覆盖所有查询(覆盖索引)。 - 每个
Index Only Scan都要比较Heap Fetches与返回行数;若接近行数,说明清理没有让可见性映射保持最新(仅索引扫描)。 - 按运算符选择索引类型:GIN、三字符组、GiST、BRIN 或哈希(选择索引类型)。
- 包含查询用
jsonb_path_ops;没有哪种 GIN 能服务payload->>'key' = 'x'(jsonb 包含查询)。 - 找出没有索引的外键,为它们建索引(查询语句)。
- 新增索引前先算写入税:每次插入都会访问每个索引,它还可能让更新变成非 HOT 更新(写入税)。
- 长时间窗口内
idx_scan = 0的索引,在每个副本上都检查过后就删除,支撑约束的除外;重复索引也删除(未使用与重复索引)。 - 在大表上动工前先问 HypoPG(假设性问题)。
- 用
reindex concurrently重建膨胀索引(测量膨胀)。 - 普通
create index只用于新表、空表或没有写入的表;所有有写入的表都用concurrently(判断规则)。 - 并发构建后,检查是否留下
INVALID索引;重试前先删除它(构建失败时)。 - 每次升级操作系统、glibc 或 ICU 后,重建文本索引,然后才能刷新记录的排序规则版本(排序规则、发现问题)。
添搜索引擎之前,先在 PostgreSQL 内搜索
全文搜索和向量搜索也是索引,有各自的成本。像测量其他查询那样,测量召回率和页数。
- 每次调用都传入文本搜索配置,例如
'english';按一种配置建的索引不能服务另一种配置(配置)。 - 把
tsvector存在生成列里,建 GIN 索引;通过表达式索引做排名耗时 170 ms,而前者只需 4.6 ms(存储 tsvector)。 - 用户键入的任何内容都用
websearch_to_tsquery解析(用户输入)。 - 排名前先按租户或日期缩小范围,只对返回的行运行
ts_headline(摘要片段)。 - 信任近似向量索引之前,先用自己的查询,对照精确搜索测量 recall@10(精确搜索)。
- HNSW 的
hnsw.ef_search保持在 40 或以上(我们测试中的召回率为 0.97);漏召代价高的查询,单独提高它(ef_search 用延迟换召回率)。 - IVFFlat 的
ivfflat.probes绝不能停在 1:探测一次时 recall@10 是 0.636,五次时是 1.000(IVFFlat 的默认一次探测是陷阱)。 - 向量搜索有过滤条件时,开启
hnsw.iterative_scan,或让 B-树在高选择性过滤下完成精确搜索(过滤条件)。 - 用倒数排名融合合并关键词与向量结果,不要把分数直接相加(混合搜索)。
第一行插入前,先审查模式
只要表还在,模式就决定着每一行的成本。事后修改它是一场模式变更,不是发个版就行。
类型
- 每个 ID 及引用它的列都用
bigint(ID 使用 bigint)。 - 每个时刻都用
timestamptz,会话采用 UTC(始终用 timestamptz)。 - 用
text加检查约束,不用varchar(n),更不用char(n)(就用 text)。 - 金额用
numeric或以分为单位的bigint存储,旁边放货币列,绝不用浮点数(金额)。 - 用
archived_at代替is_archived;将来可能改变的枚举,改用text加检查约束(小型取值集合)。 - 每列选定一种不区分大小写的策略,并在模式中强制执行(选定一种)。
- 新数据库默认采用内置的
C.UTF-8排序规则,只有人要看排序结果的地方才选语言学排序规则(三种提供者)。 - 标识符绝不加引号:用不带引号的
snake_case,第一次模式变更前就设置好 ORM 的命名策略(其他小差异)。 - 用标识列,不用
serial;避开money、char(n)和timetz(应避开的类型)。
键与公开 ID
- 每张表都给一个
bigint generated always as identity代理键;自然键用unique(自然键会变)。 - 绝不用序列生成发票号码或构建变更流:序列会有空缺,也不按提交排序(空缺)。
- 需要 UUID 时,用
uuidv7(),存为uuid;随机 v4 键产生的 WAL 是其 3.8 倍(随机键)。 - 客户端生成 ID 时,保留服务端的
created_at,校验每个 ID;发生冲突,用do nothing再在调用者账户范围内查询,绝不用do update(客户端的 UUIDv7 是输入,不是时钟)。 - 绝不对外暴露计数器:另设公开 ID,存为
uuid,输出时加前缀(存储 uuid,打印前缀)。 - 每张租户表都带
account_id,键也以它开头(带上租户)。 - 用复合外键,让引用无法跨越租户(让跨租户引用不可能发生)。
有意选择约束
- 每个事实只存一次,每个有意保留的副本都恰好指定一个写入者(一个写入者)。
- 账户、用户、项目、成员关系和钱款保留外键(我们保留外键的地方)。
- 事件、日志、指标、审计记录、跨边界引用和导入,删除外键或声明为
not enforced(同节)。 - 每条停止强制检查的引用,都安排孤立记录检查(检查你不再强制执行的规则)。
- 每个强制执行的外键,都在引用方建索引(引发扫描的删除)。
- 级联删除只用于数量少的依赖行(谨慎使用级联)。
- 除非“未知”确实是一种状态,否则列都设为
not null,其余规则用check表达(检查约束)。 - 不要信任可空列上的
unique,因为它允许任意多个 NULL:把列设为not null,或写unique nulls not distinct(NULL 默认互不相同)。 - “不允许重叠”用排他约束,不用应用代码(排他约束)。
- 采用软删除的表,配上部分唯一索引(软删除)。
- 把多态
type/id对换成真正的外键列(多态关联)。 - 跨行规则用约束、可串行化隔离或父行锁来保证,绝不用读取其他行的检查约束(约束看不见的规则)。
布局与 HOT
- 定长列按 8 字节到 1 字节的顺序排列,变长列放最后(列顺序就是空闲空间)。
- 更新密集的表设
fillfactor = 90;仅追加写入的表保持 100(留出空间)。 - 不要为
updated_at或大多数更新都会修改的列建索引(不要给 updated_at 建索引)。 - 不停变化的计数器移到窄表里(热点计数器)。
- 监控更新密集表的 HOT 比例,下降时查清原因(测量 HOT)。
jsonb 还是列
- 文档用
jsonb,绝不用json(jsonb)。 - 任何用于过滤、连接、排序或约束的字段,都提升为有明确类型的列;规划器看不到
jsonb内部(何时提升为列)。 - 绝不建实体—属性—值表(一个陷阱)。
函数与触发器
- 只有一条查询的函数,用 SQL 编写,标为
stable或immutable,让规划器能将其内联(内联)。 - 易变性标注在符合事实的前提下尽可能严格,绝不能比事实更严格(易变性)。
- 给要跑批处理作业的表加触发器前,先按每行约一微秒估算行触发器成本,审计触发器则约两微秒(触发器成本)。
- 绝不通过子表触发器维护父表计数器;这会让所有写入者在同一个父行上串行排队(计数器触发器)。
- 只有工作必须与写入保持原子性,且对每个写入者都必须执行时,才添加触发器(证明它值得存在)。
- 开启
track_functions,让函数出现在pg_stat_user_functions中;设置pg_stat_statements.track = all,让函数内部语句也有自己的条目(跟踪)。
每次模式变更,都检查它在等什么锁
模式变更不会让整个站点排在它后面等,才算安全。ALTER 本身很少慢;等待它的锁才会造成故障。
- 每个模式变更会话都把
lock_timeout设为 1 至 5 秒,配合重试,并设置较宽裕的statement_timeout(第一条规则)。 - 绝不让 DDL 在锁队列里等待:一个等待中的
ALTER会阻塞该表上后来的所有查询,包括读取(锁队列)。 - 开始前检查长事务和事务中空闲的会话(长事务)。
- 执行前,给每一步标明:只改系统目录、扫描,还是重写(元数据、扫描或重写)。
- 添加列时用常量默认值;大表绝不一步加入带易变默认值的列(默认值)。
- 添加
check约束时用not valid,再在另一个事务中validate(检查约束)。 - 外键先
not valid,再validate;两步都会锁住子表和父表(外键)。 - 通过已验证的检查约束实现
not null,或在 PostgreSQL 18 上用not null ... not valid(先通过 CHECK,再设置 NOT NULL)。 - 根据表的访问流量选择索引构建方式(选择构建方式)。
- 并发构建在事务块外单独运行,关闭
lock_timeout,然后检查indisvalid(四条规则)。 - 用并发构建的唯一索引建立唯一约束和主键(唯一约束)。
- 在线表绝不运行普通
reindex(用 REINDEX CONCURRENTLY 重建;普通 REINDEX 也会阻塞读取)。 - 除扩宽以外,类型变更都按重写来对待;
int转bigint按在线替换规划(int 转 bigint 的问题)。 - 重命名按先扩展、后收缩的方式跨多个版本发布(先扩展,后收缩)。
- 回填按主键范围分批,在模式变更之外执行,每批一个事务(回填)。
- 先删除代码,再删除列(先删代码)。
- 每个模式变更事务都保持简短;DDL 的所有锁都持有到提交(事务性 DDL)。
- 挂接分区时带上已经验证的
check,分离时用concurrently(改造在线表)。 - 在与生产规模相当的克隆上演练(复制生产环境)。
批量加载与分区
- 加载用
COPY,或用unnest数组(如果必须insert);绝不每行执行一次自动提交的插入(COPY 是批量加载路径)。 - 先加载到没有索引和外键的表,再建索引,以
not valid加上validate添加外键:我们的加载实验快了六倍,WAL 减半(加载之后)。 - 对同一事务内创建或截断的表用
copy ... freeze,让首次读取不必写入(COPY FREEZE 会写入已完成的行)。 - 大批加载前提高
max_wal_size;结束后,在业务访问表之前,执行vacuum (freeze, analyze),至少也要执行analyze(开放访问之前)。 - 从去重后的暂存表出发,用一条语句批量插入或更新(批量插入或更新)。
- 按删除数据所用的键分区,通常是时间;分区数量保持在几十到小几百(选择键)。
- 对分区表的每条热点查询运行
explain,确认发生剪枝:只出现匹配的分区,或Subplans Removed大于零(剪枝)。 - 提前创建未来的分区,剩余数量不足时告警(提前创建)。
- 加载和按保留期限清理后,自己对分区父表做分析;自动清理从不做这件事(其他小陷阱)。
生产就绪检查
本书中的多数故障,都是悄悄积累几个月,再突然爆发。上线前检查这些项目,之后数据每增长十倍,再检查一次。
备份与恢复
- 先写下 RPO 和 RTO;副本不是备份(先写下 RPO 和 RTO)。
- 做物理基础备份,并持续归档 WAL,存到数据库主机无法删除的存储上(使用备份工具)。
- 在另一台服务器上演练时间点恢复,设置
recovery_target_action = 'pause'(恢复到时间点)。 - 自动执行恢复测试,记录真实 RTO(测试恢复)。
- 托管服务也要实际恢复一次并计时;它会创建新服务器(恢复时间)。
监控与告警
连接与超时
- 应用都要用连接池;进程很多或采用 serverless 时,再加外部连接池(两处都用连接池)。
- 按核心与磁盘设置连接池大小,不按用户数(连接池大小)。
-
max_connections保持在小几百,并给管理员预留连接槽位(max_connections)。 - 在应用角色上设置超时,从
statement_timeout = '5s'、lock_timeout = '3s'、idle_in_transaction_session_timeout = '30s'开始,PostgreSQL 17+ 再加transaction_timeout = '5min';模式变更和批处理作业使用独立角色,各设自己的限制(超时)。 - 应用要能在故障切换过程中重连并重试(故障切换就是 DNS)。
- 连接池改为事务模式前,替换会话级
set、会话级咨询锁、listen、SQLprepare和临时表(事务连接池)。 - 事务模式要支持预备语句,运行 PgBouncer 1.21 或更高版本;1.24 默认开启这项支持(新版 PgBouncer)。
- 用表构建队列,以
for update skip locked领取任务,与业务写入一起提交;listen/notify的使用保持克制(队列)。
配置与机器
- 调优前先算内存预算:先算
shared_buffers,再算work_mem乘以计划节点数、再乘以连接数(内存)。 - 按角色为报表提高
work_mem,绝不全局提高(work_mem)。 - SSD 上设置
random_page_cost = 1.1(代价模型)。 - 提高
max_wal_size,让检查点按时间触发,并开启wal_compression(错开检查点,并按 WAL 速率设置 max_wal_size)。 - 别让 OOM killer 杀掉 postmaster(OOM killer)。
- 绝不在
fsync = off或full_page_writes = off下运行(持久性)。
清理与回卷
- 大表逐表把缩放因子设为 0.01 至 0.05,并把代价上限提高到远高于 200(默认值不合适)。
- 找出阻碍清理界限前进的因素:会话、复制槽、反馈、预备事务(什么会阻碍清理)。
-
age(datfrozenxid)达到 5 亿至 10 亿时告警,绝不杀掉防回卷清理(回卷)。 - 把序列值与其类型最大值画在图上比较(int 转 bigint 的问题)。
复制与故障切换
- 用
max_slot_wal_keep_size限制每个复制槽,对非活跃复制槽告警(复制槽)。 - 决定故障切换最多允许丢失多少已确认的提交(异步是默认方式)。
- 使用故障切换管理器,绝不用脚本自行实现,并定期演练(不要自己拼凑故障切换)。
- 把故障切换候选节点与报表副本分开(副本查询会与重放冲突)。
- 需要读取自身写入时,路由到主库,或等待该次写入的 LSN(读取自身写入)。
安全与租户隔离
- 应用连接所用的角色既不是超级用户,也没有
BYPASSRLS,更不拥有表(应用永远不拥有自己的数据表)。 - 设置默认权限,让新表得到正确授权(默认权限)。
- 每张租户表都启用并强制执行行级安全(除非强制执行,否则 RLS 会跳过表所有者)。
- 通过统一的辅助函数,在每个事务中设置租户(连接池会泄露租户)。
- 索引以租户列开头;策略就是谓词(RLS 性能:策略就是谓词)。
- 固定
search_path,每个security definer函数都要如此(SECURITY DEFINER 函数需要固定的 search_path)。 - 强制使用
hostssl、scram-sha-256和sslmode=verify-full(使用 scram-sha-256 和 verify-full,绝不用 trust)。
托管还是自建
- 在预算内尽量多买托管服务;只有说得清理由、又有人负责时才自建(我们的选择)。
- 记下存储卷和实例两种 I/O 上限中的较低者(两道上限)。
- 围绕某个扩展做设计前,先检查扩展允许列表(允许列表)。
- 在克隆环境上演练大版本升级(升级)。
- 用到之前,先规划退路(规划退路)。
申请更大的数据库之前
在前面各节做完、数据也证明有必要之前,我们都不会批准扩容申请(用数据争取更大的机器)。在一个应用上,实战手册让每个事务访问的页数在同一台笔记本上从 91,448 降到 38,没有增加任何硬件(证据)。
- 在排名前五的每条语句旁写清:已修复,为什么无法修复,或为什么已经足够便宜(扩容申请要带什么)。
- 性能画像若显示
Lock、LWLock或Client,就停下来:更大的机器不会缩短队列(购买之前先测量)。 - 买更多核心前,先找找是否所有事务都在更新同一个热点行(不要用热点行计数)。
- 测量工作集并与内存比较;已经放得下的话,更多内存毫无收益(根据工作集配置 RAM)。
- 花钱买更快的存储前,先证明读取占据主要开销(存储是你的瓶颈吗?)。
- CPU 是瓶颈时,先把逐行格式化和副作用移出主库(主库是你最昂贵的 CPU)。
- 逐一排除索引、改写、往返、连接池、配置、清理和汇总表,每项写一句话(预先算好要展示的内容)。
- 说明余量:目前的峰值用量、新规格提供什么,以及按当前增长能撑几个月(只问一个问题)。
- 按模板提交申请(把申请写成工单)。
- 不要为修一条慢查询就上副本、分区或分片;它们各自回应不同的信号(上限)。
如果证据表明,机器已经耗尽负载所需的某项资源,就不必争论,直接升级;把证据留下,作为下一次的基线。
横向扩展或引入第二个系统之前
跨出单个主库后的每一步,都回应一个信号,也都会成倍增加运维工作。迈步前,先说清信号和数字。
- 为读取负载或故障切换增加只读副本,绝不为一条慢查询加副本;必须看到自身写入的读取,路由到主库(读取自身写入)。
- 为保留期限和维护而分区,不为查找速度;不按分区键过滤的查询会搜索每个分区(查找不会更快)。
- 只有真正出现信号时才分片:调优和批处理后,写入仍让最大主库饱和;数据多到无法在 RTO 内恢复;或有数据驻留要求(何时分片)。
- 在此之前,留好余地:每张租户表、每个键、每条查询都带
account_id(留好余地)。 - 选分片方案之前,检查负载最高的查询的计划中是否有扇出(跨分片查询)。
- 分析负载先试汇总表、报表副本或 pg_duckdb,再考虑列式存储;整表要读 35,173 页,汇总表只读 12 页(折中办法)。
- 只有能说清特性、又有实测数字,才增加第二个系统,同时让 PostgreSQL 继续作为权威数据源(实测理由)。
故障排查:数据库现在就很慢
先看,再动手。重启会把证据和缓存一起清掉,流量恢复后,原因也会回来(重启后预热缓存)。按顺序执行下面的步骤;每个答案都会告诉你,接下来哪一步才重要。
**1. 按状态和等待事件统计会话。**遇到任何慢服务器,先跑这条查询:
- 解读结果:
active且没有等待事件,表示在用 CPU,要与核心数比较;Lock表示转到第 2 步;IO的DataFileRead是读页;LWLock表示内部结构拥挤;大量idle in transaction指向应用问题(等待事件)。 - 将总数与
max_connections比较:select count(*), current_setting('max_connections') from pg_stat_activity;(统计连接)。
**2. 找出阻塞链的根源。**列出每个等待锁的会话,以及每个阻塞别人的会话:
- 找根源:
blocked_by为空的那一行,往往处于idle in transaction状态(找到根阻塞者)。
**3. 列出最老的事务。**它们持有锁,也阻碍清理:
- 在
idle in transaction状态下停留几分钟就是 bug;query是它的上一条语句,不是当前语句(寻找长事务)。
4. 结束正确的会话。select pg_cancel_backend(pid) 会停止正在运行的语句;事务中空闲的会话没有正在运行的语句,因此用 select pg_terminate_backend(pid),它会回滚该会话的事务。
- 记下结束了什么、为什么结束,再修复那个让事务一直开着的问题(同节)。
**5. 对等待采样一分钟。**看一眼只是照片;每秒十次、持续一分钟,才是性能画像。
**6. 给问题发生后运行的语句排名。**对 pg_stat_statements 取快照,等一分钟,再算差值:
- 找那些语句很简单、平均耗时却很长的:它在等,不是在干活(购买之前先测量)。
- 用真实参数,对排在最前的语句运行
explain (analyze, buffers)(排查方法)。 - 怀疑计划发生了切换:通用计划,或加载后过时的统计信息(计划出错时)。
7. 检查查询背后还在运行什么。
- 检查清理进度:
select pid, relid::regclass, phase from pg_stat_progress_vacuum;(监控清理)。 - 检查副本延迟:
select application_name, state, replay_lag from pg_stat_replication;(监控复制)。 - 检查归档:
select failed_count, last_failed_time from pg_stat_archiver;(归档)。 - 检查回卷:
select datname, age(datfrozenxid) from pg_database order by 2 desc;(回卷)。 - 检查主机:CPU 使用量与核心数的关系、磁盘延迟,以及 IOPS 是否平在存储卷的上限(I/O 被节流时,会表现为 IOPS 持平而延迟上升)。
8. 收尾闭环。
43 术语表
Postgres 的大多数术语都有具体实物所指:页上的一个槽位、元组头里的一个计数器,或表旁边的一个文件。这里的每个词条都链接到用真实输出展示该事物的小节,你可以前去亲眼看看它如何运作。
词头采用统一约定:SQL 命令和关键字用大写(VACUUM、NOT VALID),配置项、函数及其他标识符保留实际输入时的写法(work_mem、ctid),其余英文词头仅首词首字母大写。词条按英文字母逐字排序,忽略大小写和标点。
A
ACID
事务给出的四项承诺:原子性、一致性、隔离性和持久性。在 Postgres 中,每一项都对应一种可以观察到的具体机制,从提交记录到 fsync。参见四项承诺,四种机制。
咨询锁(Advisory lock)
加在整数键上的锁,键的含义由应用自行定义,用于对行以外的事物实现互斥(例如“每次只运行一个夜间汇总任务”)。优先使用事务级咨询锁,提交时会自动释放。参见按事务取得咨询锁,而不是按会话取得。
ANALYZE
对表进行采样并保存统计信息的命令,规划器据此估算。足够多的行发生变化后,自动清理会运行该命令。参见ANALYZE 读取样本,而不是整张表。
异常(Anomaly)
一种无法由事务按任何先后顺序逐个执行而产生的结果,例如丢失更新或写偏差。隔离级别以其允许哪些异常来定义。参见只有可串行化能排除所有异常。
自动清理(Autovacuum)
当表的死元组数、插入行数或事务 ID 年龄超过阈值时,对表执行清理和分析的后台工作进程。阈值随表大小增加,因此默认值对大表来说过于迟钝。即使关闭自动清理,它在事务年龄达到 2 亿时强制触发的防回卷清理仍会运行。参见自动清理会因死行、插入或年龄而触发。
B
后端进程(Backend)
Postgres 为每个连接启动的操作系统进程。它解析、规划并执行该会话的查询,保存其状态,不为其他会话服务。参见每个连接都是一个进程。
基础备份(Base backup)
通过 pg_basebackup 或备份工具,在服务器运行时复制整个数据目录得到的物理副本。还原这一副本,再从备份开始的位置重放归档 WAL,就是物理恢复和时间点恢复的工作方式。参见数据量大时,只有物理备份恢复得快。
位图扫描(Bitmap scan)
先从索引收集所有匹配行的地址,再按物理顺序访问堆页、每页只访问一次的扫描方式。超过 work_mem 后,位图会变为有损形式,只记录页,不再记录行。参见索引能帮多少忙,取决于匹配行有多集中。
膨胀(Bloat)
表或索引中既不存放存活数据、近期也不会复用的空间,由两次清理之间积累的死元组留下。如果表占用的空间是存活数据大小的五倍,每次扫描就得读取五倍的页。参见清理释放表内空间,而不是磁盘空间。
BM25
一种相关度评分,将词在文档中的出现频率与其在整个语料库中的稀有程度结合起来衡量。内置排名不具备这一能力;较新的搜索扩展会在索引中保存所需统计信息。参见搜索扩展把 BM25 放进索引。
BRIN
块范围索引(Block Range INdex):为每一段页记录最小值和最大值,就像搬家纸箱上的标签。体积很小;当物理顺序与该列的顺序一致时,效果几乎与 B-树一样好,不一致时则毫无用处。参见BRIN 为每个页范围保留一份汇总。
B-树(B-tree)
默认索引:由 8 KB 页组成的浅层有序树,叶子按顺序保存每个键及其行地址。读取三四个页,就能从几百万行中找到一行。参见B-树是一棵由页组成的浅树。
缓冲区(Buffer)
共享内存中的一个 8 KB 槽位,容纳一个页。每个进程都通过缓冲区读写页,从不直接从文件中读写。参见shared_buffers 是一个页数组。
环形缓冲区(Buffer ring)
大型扫描、清理和批量写入会循环使用的一小组专用缓冲区,让这些操作淘汰自己的页,而不是你的页。在 PostgreSQL 18 中,大型顺序扫描的环形缓冲区大小为 2,304 KB。参见大型操作会使用环。
Buffers(执行计划中的字段)
explain (analyze) 中统计节点访问页数的一行:hit 表示在共享缓冲区中命中,read 表示从下一层读取,此外还有 dirtied 和 written。与耗时不同,这些计数不会随负载变化,因此是本书的主要证据。参见缓冲区才是证据。
C
检查点(Checkpoint)
定期将所有脏缓冲区写入数据文件并执行 fsync,让崩溃恢复可以从这里开始,而不必从最初的历史开始。参见检查点为恢复设定上限。
检查点进程(Checkpointer)
执行检查点的后台进程,将脏缓冲区的写入分散到检查点间隔的大部分时间里(由 checkpoint_completion_target 控制,默认值为 0.9)。与它配合的后台写进程会赶在时钟扫描之前写出脏缓冲区,因此后端进程很少需要自己写出脏缓冲区。参见你的查询不该负责写出脏页。
Citus
一个开源扩展(AGPL-3.0),将一组 Postgres 服务器组成一个分布式数据库:你连接协调节点,工作节点保存分片,而路由、合并和两阶段提交都在 Postgres 内部处理。参见Citus 在 PostgreSQL 内部路由与合并。
时钟扫描(Clock sweep)
Postgres 选择要淘汰的缓冲区所用的算法:指针循环扫过缓冲区,跳过被钉住的缓冲区,将遇到的使用计数减一,并淘汰遇到的第一个使用计数为零的缓冲区。冷数据的一次扫描无法挤掉热点页。参见时钟扫描挑选受害者。
排序规则(Collation)
比较和排序文本的规则:'a' 是否排在 'B' 前面,两种拼写是否相等。每个文本索引都依据某种排序规则建立;如果操作系统升级改变了规则,索引就可能损坏。参见排序规则决定什么算相等。
共置(Colocation)
一种分片布局,按相同的键拆分相关表,让同一租户在所有这些表中的行落在同一分片,并就地连接。所有租户都会读取的小表则作为引用表复制到每个节点。参见分片键就是整个设计的核心。
列式存储(Column store)
将每一列保存在各自的压缩文件中、只读取查询指定列的数据库。它擅长扫描数十亿行,在点查和更新上则处于劣势。参见行式存储为了用两列,必须读取所有列。
协调遗漏(Coordinated omission)
一种基准测试错误:负载生成器等到缓慢的响应返回后才继续发送请求,因此从未测量那些被停顿延迟的请求。闭环测试天生就有这一问题。参见闭环会隐藏停顿。
COPY
批量加载通道:一条语句以流的方式传送许多行,每行开销远低于逐行插入。其 freeze 选项能将已冻结的行写入在同一事务中创建或截断的表。参见COPY 是批量加载路径。
相关性(Correlation)
取值范围为 -1 到 1 的统计量,衡量列值顺序与行的物理顺序有多接近。规划器使用它的平方来估算索引扫描的代价。参见相关性决定索引扫描的代价。
代价(Cost)
规划器对执行计划的估价,使用以顺序读取一个页为基准的自定义单位(seq_page_cost = 1.0)。它根据估计行数推算而来,并非耗时。参见代价是用虚构单位做出的猜测。
覆盖索引(Covering index)
包含查询所需全部列的索引,常借助 include 实现,从而可以用仅索引扫描完成查询。应覆盖热点查询,而不是所有查询。参见覆盖索引:覆盖热点查询,而不是每个查询。
CREATE INDEX CONCURRENTLY
一种不阻塞写入的索引构建方式,代价是两次全表扫描,并等待较早的事务结束。构建失败会留下一个 INVALID 索引,查询会忽略它;删除后重试即可。参见选择与表流量匹配的索引构建方式。
公用表表达式(CTE)
公用表表达式,即 with 子句。自 PostgreSQL 12 起,只引用一次的 CTE 会被内联;materialized 会强制它单独执行,这可能让外层查询无法利用你的索引。参见只使用一次的 CTE 会被内联,而不是设栅栏。
ctid
行版本的物理地址,由页号和行指针号组成,例如 (0,3)。每张表都有这个隐藏列,每个索引都指向它。参见行指针让元组移动而不改变地址。
D
数据校验和(Data checksums)
每个数据页上的校验和,让磁盘上的位翻转触发错误,而不是悄悄返回错误的行。自 PostgreSQL 18 起,initdb 默认启用。参见启用校验和后,连读取也会写 WAL。
死锁(Deadlock)
两个事务各自等待对方所持有锁的僵局。经过 deadlock_timeout 指定的时间后,Postgres 会检测到死锁并中止其中一个事务;解决办法是按一致的顺序获取锁。参见死锁是顺序错误。
死元组(Dead tuple)
任何事务都不可能再看到的行版本:它已被删除或替换,而且早于所有仍在使用的快照。页内剪枝和清理会回收它的空间;在此之前,它仍占用页。参见只有没有快照能看到的版本才是死版本。
去重(Deduplication)
B-树在 PostgreSQL 13+ 中采用的存储方式:重复键只保存一份,后面跟上拥有该键的各行的倒排列表。它能让外键和状态列上的索引缩小到原来的约三分之一。参见去重:重复的键只存一次(PostgreSQL 13+)。
脏缓冲区(Dirty buffer)
在内存中已被修改、尚未写入文件的页。修改已经安全地保存在 WAL 中;检查点进程、后台写进程或需要该缓冲区的后端进程稍后会把它写出。参见你的查询不该负责写出脏页。
计算与存储分离(Disaggregated storage)
一种托管数据库设计(Aurora、AlloyDB、Neon):让 Postgres 运行在缓冲区缓存之上,并用根据传来的 WAL 构建页的存储服务替代磁盘。在这些系统中,检查点调优和副本行为都会发生变化。参见分离式存储改变了部分规则。
E
排他约束(Exclusion constraint)
唯一约束的推广:不允许任意两行同时满足一组操作符条件,例如“同一房间的任意两条预订时间都不得重叠”。它通过 GiST 索引强制执行。参见排他约束让重叠变得不可能。
扩展与收缩(Expand and contract)
分步发布不兼容模式变更的方法,让新旧代码都能正常运行:先添加新结构,部署使用它的代码,回填数据,再在后续部署中删除旧结构。参见重命名要用扩展与收缩发布。
EXPLAIN
显示 Postgres 所选执行计划的命令。单独的 explain 只做估算;explain analyze 会执行查询,并将实际结果与预测并列显示,因此对写操作应使用事务包裹,并在之后回滚。参见EXPLAIN 负责猜测;EXPLAIN ANALYZE 负责运行。
表达式索引(Expression index)
基于表达式结果建立的索引,例如 lower(email),为使用完全相同表达式的查询服务。ANALYZE 还会收集其统计信息,以修正估算。参见索引只存储你交给它的值。
扩展统计信息(Extended statistics)
通过 create statistics 创建的跨列统计信息,用于规划器“各列相互独立”的假设不成立时。ndistinct 修正分组数估算,mcv 修正相关列过滤条件的估算。参见扩展统计信息联合测量多列。
扩展(Extension)
由类型、函数和索引方法组成的包,通过 create extension 安装,按版本跟踪管理。托管服务只允许安装其允许列表中的扩展。参见扩展是数据库跟踪的一个软件包。
F
故障切换(Failover)
主库故障时,将副本提升为主库。难点在于确认原主库确实已故障,并将其隔离;任何一步没做好,都可能让两台服务器同时接受写入(脑裂),而没有机制能合并两边的数据。应使用专门的工具,不要自行写脚本。参见一次调用提升副本,开启新时间线。
填充因子(Fillfactor)
一个存储参数,让插入操作在页填满前就停下来,留出空间;对表而言,默认值为 100%。预留空间供更新使用:新版本如果能放在同一页中,就可能实现 HOT 更新。参见填充因子为更新留下空间。
外键(Foreign key)
要求某个值必须存在于另一张表的键中的约束。插入子表记录时,检查父表的代价很低;删除父表记录时,则会扫描子表,除非你自行在引用列上建立索引。参见外键要从两个方向检查,代价各不相同。
分支文件(Fork)
构成一张表的文件之一:main 保存行,_fsm 保存空闲空间映射,_vm 保存可见性映射,不记日志表还会有一个空的 _init。参见表不只有主文件。
空闲空间映射(Free space map)
一个小型分支文件,粗略记录每个页还有多少空间,让插入和更新可以填充已有页,而不是扩展文件。清理会保持其信息更新。参见插入无需扫描表也能找到空间。
冻结(Freezing)
清理过程中的一个步骤:当插入事务足够老时,将元组标记为永久对所有事务可见,使其能跨越事务 ID 回卷。全冻结页以后无需再为冻结而访问。参见旧行必须在 XID 计数器回卷前被冻结。
fsync
强制将已写入的数据落到持久化存储上的系统调用。每次提交都要等待对 WAL 的一次 fsync,因此磁盘的 fsync 延迟决定了提交速率。参见每次提交都要等待磁盘。
整页写入(Full-page write)
每次检查点之后,页首次修改时记入日志的 8 KB 页镜像,让恢复过程能修复撕裂页(断电时只写了一半的页)。这就是检查点之后 WAL 量会骤增的原因。参见检查点后的第一次变化会记录整页。
G
通用计划(Generic plan)
在不知道参数值的情况下,为预备语句生成的执行计划。从第六次执行起,如果它看起来不比定制计划更昂贵,Postgres 就会一直改用它,这可能让原本很快的查询变慢。参见预备语句运行五次后切换计划。
遗传查询优化器(GEQO)
遗传查询优化器:从连接 12 张表开始(geqo_threshold),以随机搜索替代穷举来寻找连接顺序。规划仍然很快;计划追求足够好,而不保证最优。参见连接顺序是一场搜索,而且搜索会变得昂贵。
GIN
通用倒排索引(Generalized Inverted iNdex):每个不同的元素(jsonb 的键、数组标签或词)对应一个条目,记录包含该元素的行,就像书末的索引。参见GIN 搜索很快,更新很贵。
GiST
通用搜索树(Generalized Search Tree),其条目保存一个边界值,覆盖下层所有内容。它索引的是重叠关系和距离,可用于范围、几何数据、三字符组相似度以及排他约束。参见GiST 为没有顺序的数据建立索引。
组提交(Group commit)
一次 WAL 刷新涵盖多个几乎同时提交的事务。Postgres 会自动完成这一点,这也是吞吐量可以超过“每次 fsync 提交一个事务”的原因。参见许多提交可以共享一次刷新。
H
哈希索引(Hash index)
保存 32 位哈希码的索引,只支持一个操作符 =,大小不取决于键的宽度。对令牌之类的长随机值做等值查询时值得使用;其他情况都用 B-树。参见哈希索引只有在长键等值查询上才占优。
哈希连接(Hash join)
先将内侧输入加载到哈希表,再以流式方式逐条处理外侧输入的连接方式。它是大型无序输入的主力;超过 work_mem 乘以 hash_mem_multiplier 的内存限额后,会拆成多个批次落盘处理。参见每种连接方法只适合某些行数。
堆(Heap)
Postgres 的表:一堆无序的页,哪里有空间,行就放在哪里。每个索引,包括主键索引,都通过 ctid 指向堆中的行。参见行指针让元组移动而不改变地址。
提示位(Hint bits)
元组上的标志位,缓存相关事务是否已提交,由第一个检查提交日志(pg_xact)的读取者设置。设置提示位会弄脏页,因此 select 也可能产生写入。参见读取也可能写入。
直方图(Histogram)
即 histogram_bounds 统计信息:将列中不属于高频值列表的值分成约 100 个行数相等的桶。规划器据此估算范围过滤条件。参见pg_stats 是规划器看到的全部信息。
HNSW
分层可导航小世界(Hierarchical Navigable Small World),一种近似向量索引:它是分层图,每个向量都与近邻相连,少数向量还位于更稀疏的上层,如同快车停靠站;搜索时以贪心方式沿图行进。参见HNSW 会贪心地遍历图,也可能漏掉结果。
HOT 链(HOT chain)
同一行的多个版本,由 HOT 更新通过元组头链接起来,全部位于同一页。索引指向链的第一个槽位;页内剪枝随后会将链头变为重定向行指针。参见HOT 查找会沿着版本链走,不离开所在页。
HOT 更新(HOT update)
堆内元组(heap-only tuple)更新:不改动索引列,且新版本能放在同一页中,因此无需通知任何索引。非 HOT 更新(冷更新)则会向每个索引写入一个条目。参见HOT 需要一次未被索引覆盖的变化,以及页上的空间。
I
标识列(Identity column)
由序列填充的整数键,写作 generated always as identity,用来替代 serial。序列从不回滚,因此出现空号很正常。参见让数据库为行编号,永远不要相信顺序。
事务中空闲(Idle in transaction)
开启事务后便不再发出请求的会话,常见于应用等待网络调用时。它仍持有锁和快照,因此清理无法回收被它拖住的旧版本。参见idle_in_transaction_session_timeout 最重要。
不安全的直接对象引用(IDOR)
不安全的直接对象引用(insecure direct object reference):接口收到什么 ID 就加载什么对象,却不检查调用者是否有权查看。连续递增的 ID 会让这种漏洞轻易遭到利用。参见计数器是在邀请攻击。
仅索引扫描(Index-only scan)
只从索引获取查询所需内容的扫描方式;对可见性映射标记为全可见的每个页,都会跳过堆访问。计划中的 Heap Fetches 统计仍然不得不回堆检查的行数。参见最好的堆页,是你永远不会读到的。
索引扫描(Index scan)
读取索引并随即从堆中取出每个匹配行的扫描方式,因此行按索引顺序输出。只取少量行时代价很低;匹配行散布在很多页上时则很昂贵。参见索引能帮多少忙,取决于匹配行有多集中。
IOPS
每秒 I/O 操作数,与延迟和吞吐量一起作为存储服务的指标出售。预置 IOPS 只是上限:实际能获得的是这个上限与“在途 I/O 数除以延迟”两者中的较小值。参见IOPS 受在途读取限制,而不是由你付费购买的数量决定。
隔离级别(Isolation level)
决定事务能看到其他事务多少工作的设置。读已提交(默认级别)每条语句获取一次快照,可重复读每个事务获取一次快照,可串行化还保证结果等价于某种逐个执行事务的顺序。参见有目的地选择隔离级别。
IVFFlat
一种近似向量索引,将向量聚成 lists 个簇,只搜索离查询向量最近的 probes 个簇。默认只探测一个簇是个陷阱:在我们的测试中,recall@10 为 0.636,探测五个簇时则为 1.000。参见IVFFlat 的默认一次探测是陷阱。
J
即时编译(JIT)
将查询表达式即时编译为机器码的机制,在估算代价超过 jit_above_cost 时触发。这是基于估算的一次押注:长时间的分析扫描可以获益,短查询则会吃亏。参见JIT 是规划器根据自身估算下的一次赌注。
K
键集分页(Keyset pagination)
记住上一页结束位置的分页方式(where (created_at, id) < ($1, $2))。每一页的代价都一样;offset 则会读取它跳过的每一行。参见OFFSET 会读取它跳过的每一行。
L
词素(Lexeme)
全文搜索所存储的规范化单词:转为小写、提取词干、去除停用词,并保留位置。“The deploys failed” 会变成 'deploy' 和 'fail'。参见文本会变成词素。
行指针(Line pointer)
位于页头部的 4 字节槽位,指向页内更靠后的一个元组。索引指向行指针,因此元组可以在页内移动而不改变地址。参见行指针让元组移动而不改变地址。
锁模式(Lock modes)
八种表锁级别,从 ACCESS SHARE(每条 select 都会获取)到 ACCESS EXCLUSIVE(大多数 alter table 形式都会获取,连读取也会阻塞)。每条语句都会获取某种锁,因此要问清楚是什么锁、持有多久。参见八种模式、冲突矩阵,以及每种 DDL 取得了什么锁。
锁队列(Lock queue)
等待锁的会话队列。如果某个请求与已在等待的请求冲突,就会排到后者后面。因此,一条等待长查询结束的 alter table 会阻塞排在它后面的所有查询。参见一个等待中的锁会阻塞后面的所有人。
lock_timeout
控制语句等待锁多久后报错的设置。设为几秒并配合重试,就能把迁移引起的锁队列停机变成一个无害的错误。参见规则一:lock_timeout 和重试。
逻辑解码(Logical decoding)
将 WAL 转换为行变更流的机制,通过逻辑复制槽和输出插件读取。逻辑复制建立在它之上,变更数据捕获工具也是如此。参见逻辑复制拷贝行,不拷贝页面。
逻辑复制(Logical replication)
复制行变更而非页的复制方式:发布端将 WAL 解码为行的插入和更新,由可写的订阅端应用。用于升级、选择性同步以及迁出服务商。参见逻辑复制拷贝行,不拷贝页面。
丢失更新(Lost update)
两个事务读取同一个值、各自计算出新值,而第二次写入悄悄覆盖第一次写入的异常。应在 update 内完成运算,或先锁住该行。参见Read committed 会丢失在应用中计算的更新。
日志序列号(LSN)
日志序列号(log sequence number):无限延伸的 WAL 流中的字节偏移,写作 2/8BE4C8B0 这样的形式。两个 LSN 相减,就是它们之间的 WAL 字节数。参见LSN 是字节偏移量。
轻量级锁(LWLock)
保护共享内存、持有时间以微秒计的轻量级锁。大量 LWLock 等待意味着太多会话在做同一种内部操作,而不是有人锁住了你的行。参见解决 LWLock 等待要调整负载,而不是查询。
M
物化视图(Materialized view)
以表的形式保存的查询结果。普通 refresh 执行期间会阻塞读取;refresh ... concurrently 不会,但需要唯一索引。两种方式都要重新计算全部结果,因此对持续增长的数据应使用汇总表。参见物化视图会全部重算。
高频值列表(MCV list)
列中最常见的值及各自的出现频率(most_common_vals 和 most_common_freqs)。对于这些值的等值过滤,规划器直接依据列表估算。参见pg_stats 是规划器看到的全部信息。
Memoize
一种执行计划节点(PostgreSQL 14+),按连接值缓存嵌套循环的内侧结果,相当于带记忆的嵌套循环。Hits 是它省下的查找次数。参见交叉点、归并连接和 Memoize。
归并连接(Merge join)
按连接键顺序同时遍历两侧输入的连接方式,就像合并两个有序列表。当两侧通过索引输出、已经有序时,代价很低。参见每种连接方法只适合某些行数。
多事务 ID(Multixact)
多个事务同时锁住一行时,写入该行 xmax 的 ID,指向持锁者列表。对同一条父表记录并发检查外键,会迅速产生大量多事务 ID;它们也有自己的回卷限制。参见共享行锁会产生 multixact,而 multixact 也会回卷。
多版本并发控制(MVCC)
多版本并发控制(multiversion concurrency control):在这种设计下,Postgres 从不原地覆盖行,因此读取者无需等待写入者。更新就是插入,膨胀和清理也由此而来。参见更新就是插入。
N
N+1 查询(N+1 queries)
先用一次查询取列表,再对每个条目分别查询一次的模式,通常藏在 ORM 的循环里。每次查询都很快,但往返开销会累积。用连接或一个数组参数来解决。参见N+1 是一个循环,不是慢查询。
嵌套循环(Nested loop)
对外侧每一行都执行一次内侧操作的连接方式。外侧很小、内侧是索引查找时效果很好;外侧行数估错时则会很糟。参见每种连接方法只适合某些行数。
网络块存储(Network block storage)
通过网络访问、按 IOPS 和吞吐量计费的云磁盘:持久可靠、可以分离,但每个未命中内存的页都意味着向远端存储服务器发出一次请求。本地 NVMe 快得多,但会随主机丢失。参见存储决定基准测试结果。
节点(Node)
查询计划中的一个步骤:扫描、连接、排序或聚合,从下层节点拉取行,再向上层传递行。读计划要从缩进最深的节点向外读。参见计划是一棵树;从里向外读取。
NOT VALID
添加约束时不检查已有行的选项,只短暂持锁;之后再用 validate constraint 在较弱的锁下检查已有行。这是在大表上添加外键和检查约束的安全方式。参见先添加 NOT VALID 外键,再验证。
O
在线事务处理(OLTP)
在线事务处理(online transaction processing):大量短事务,每个只读写少量行,正是 Postgres 的行式存储和 B-树所针对的负载。分析查询扫描许多行、却只使用少量列,是列式存储占优的场景。参见行式存储为了用两列,必须读取所有列。
操作符类(Operator class)
索引定义中说明某种类型如何比较、索引能支持哪些操作符的部分。text_pattern_ops 让 B-树在语言相关的排序规则下也能支持 like 'abc%';jsonb_path_ops 则是用于包含关系查询、体积更小的 GIN 操作符类。参见前缀查询需要正确的操作符类。
对象关系映射(ORM)
对象关系映射器(object-relational mapper),将对象转换为 SQL 的库。典型应用发送的大部分查询都由它生成,因此要阅读它生成的 SQL:N+1 循环和重写所有列的更新都源于这里。参见N+1 是一个循环,不是慢查询。
操作系统页缓存(OS page cache)
内核利用空闲内存缓存的文件内容,位于 shared_buffers 之下的第二层缓存。执行计划中的 read 可能只花几微秒就从这里完成,热点页也可能同时存在于两层缓存中(双重缓冲)。参见一页可能位于三种位置之一。
事务发件箱(Outbox)
与业务变更在同一事务中写入的表,保存应通知其他系统的消息。转发程序发布消息并删除已发送的记录,因此不可能出现提交了业务变更却没有对应消息,或有消息却没有对应提交的情况。参见把消息和订单放进同一个事务。
P
页(Page)
Postgres 读取、写入、缓存和记入日志的 8 KB 单位:页头、从前端排列的行指针、从后端排列的元组,以及两者之间的空闲空间。查询的代价主要取决于它访问多少个页。参见每个页都有相同的布局。
并行查询(Parallel query)
将大型扫描或聚合分给 Gather 节点下的多个工作进程的执行计划。它让一条查询更早完成,读取的页数却相同,因此消耗的服务器资源更多,而不是更少。参见并行查询更快,但不更便宜。
部分索引(Partial index)
只为满足其 where 子句的行建立的索引,例如尚未处理的任务或存活行。它体积小、维护代价低,但查询条件必须蕴含该谓词才能使用。参见只为要查询的行建索引,而不是整张表。
分区(Partition)
分区表的一张子表,保存分区键落在其范围或列表中的行。每个分区都有自己的堆、索引和清理安排,因此执行保留策略时,只需快速删除整张子表。参见所有收益都来自拆成独立的表。
分区剪枝(Partition pruning)
在规划时或执行时跳过不可能包含匹配行的分区的步骤。只有查询按分区键过滤时才会发生。不要与清除单个页内死元组的页内剪枝混淆。参见分区边界是免费的粗粒度索引。
pgbench
Postgres 自带的基准测试工具。它按你指定的客户端数运行 SQL 脚本,并报告吞吐量和延迟。内置的类 TPC-B 测试主要衡量磁盘的 fsync,因此应编写贴近实际负载的脚本。参见pgbench 已经安装好了。
PgBouncer
外部连接池:用一个事件驱动的进程,将少量、固定数量的服务器连接借给众多客户端。应与应用自身的连接池配合使用。参见在应用中并在数据库前面使用连接池。
pg_stat_statements
汇总每条规范化语句的调用次数、耗时、行数和页数的扩展。寻找昂贵操作,应从这里开始。参见从 pg_stat_statements 开始。
时间点恢复(PITR)
时间点恢复(point-in-time recovery):还原基础备份,然后重放归档 WAL(每个 16 MB 段写满后就复制出去),直到误操作发生之前。参见时间点恢复就是持续重放。
连接池模式(Pooling modes)
连接池借出服务器连接的三种方式。会话池在整个会话期间保留连接。事务池只在事务内保留连接:收益最大,但会破坏 set 等会话状态。语句池禁止包含多条语句的事务。参见事务池模式会破坏会话状态。
Postmaster
Postgres 启动的第一个进程,也是所有其他进程的父进程。它监听连接,为每个连接启动一个后端进程,并启动后台进程。要避免它被 OOM 杀手终止。参见每个连接都是一个进程。
页内剪枝(Pruning)
查询读取一个接近填满的页时,顺手清除页内死元组的操作:代价低,每次只处理一页,不处理索引。完整清理工作由 VACUUM 完成。不要与跳过整个分区的分区剪枝混淆。参见页接近填满时才进行页内剪枝。
R
Recall@k
真正最近的 k 个邻居中,被近似搜索返回的比例。Recall@10 为 0.9,意味着真正最近的十个邻居返回了九个;近似索引用召回率换速度。参见ef_search 用延迟换召回率。
倒数排名融合(Reciprocal rank fusion)
合并评分尺度不同的排名的方法,用于文本与向量的混合搜索:每份返回某文档的列表,都为它贡献 1 / (60 + rank) 分,各项之和决定排序。参见关键词和向量的失败方式不同,所以要融合。
重定向行指针(Redirect)
指向同一页上另一个行指针的行指针,在页内剪枝或清理移除 HOT 链头时留下。索引仍指向旧槽位,由重定向行指针继续转向目标。参见只有没有快照能看到的版本才是死版本。
复制槽(Replication slot)
主库记录某个消费者已读取到哪里,并承诺保留它仍然需要的 WAL。废弃的复制槽会一直保留 WAL,直到撑满磁盘。参见复制槽承诺保留 WAL。
汇总表(Rollup)
存储聚合结果的表,例如每个账户每天的事件数;新行到来时持续更新,通常通过幂等的插入或更新实现。仪表盘读取汇总表而非原始行:在我们的测试中,只读 4 个页,而不是 35,249 个。参见预先算好要展示的内容。
行级安全(Row-level security)
Postgres 添加到针对某张表的每次查询中的策略;策略条件不为真的行无法读取或写入。将租户记录在会话设置中,即使应用忘记了 where,策略仍然有效。参见策略会让其他租户的行不可见。
RPO 与 RTO(RPO and RTO)
恢复点目标,表示你能容忍丢失多少数据,以时间衡量;恢复时间目标,表示你能容忍多长的停机恢复时间。选择备份方法前,先写下这两项目标。参见先写下 RPO 和 RTO。
S
可利用索引的(Sargable)
将未经包装的列与扫描前已知的值相比较的谓词,因此可以利用索引。如果给列套上函数或类型转换,索引就帮不上忙了。参见保持索引列裸露。
保存点(Savepoint)
事务内一个带名字的位置,可以回滚到这里,而不丢掉整个事务,用于限制单条语句失败造成的影响。保存点内一旦写入,就会分配独立的子事务,因此不要在循环中使用。参见保存点可以把损害控制住。
search_path
Postgres 查找未限定名称时依次搜索的模式。以所有者权限运行的 security definer 函数必须固定它,否则调用者就可能放入一个以函数所有者身份执行的对象。参见较旧的数据库仍允许任何人在 public 中创建对象。
选择率(Selectivity)
规划器预计过滤后会保留的行的比例,依据高频值列表、直方图或兜底估算得出。后续每项选择都建立在它之上。参见手算规划器的算术。
顺序扫描(Sequential scan)
按物理顺序读取表中每个页,并逐行检查过滤条件的扫描方式。需要表中很大一部分数据时,它是合适的计划;只要少量行时则不合适,此时会表现为 Seq Scan 配上很大的 Rows Removed by Filter。参见Filter 表示行已经被读出并丢弃。
可串行化(Serializable)
最严格的隔离级别:结果必须等价于某种逐个执行事务的顺序,否则某个事务会以 SQLSTATE 40001 失败,由你的代码重试。参见Serializable 能捕获 repeatable read 漏掉的写偏差。
分片(Shard)
由独立主库承载的一部分行。分片键决定每一行存在哪里;查询若没有指定分片键,就会发往每个分片。参见分片让一切成倍增加。
shared_buffers
Postgres 在共享内存中维护的页缓存。默认大小为 128 MB;专用服务器可从物理内存的约 25% 起步。参见shared_buffers 是一个页数组。
SKIP LOCKED
一个行锁选项:遇到其他事务锁住的行时跳过,而不等待。它让多个工作进程可以从同一张队列表领取任务,互不阻塞。参见Postgres 队列与业务写入一起提交。
跳跃扫描(Skip scan)
PostgreSQL 18 在未指定多列 B-树首列时使用该索引的方式:首列的每个值各沿树向下查找一次。首列不同值很少时有效,但不要围绕它来做设计。参见先等值,再范围或排序。
快照(Snapshot)
在语句或事务开始时,记录哪些事务已经提交。行版本若在快照之前诞生、到那时还没有死亡,就是可见的。参见一个快照选择一个版本。
SP-GiST
空间分区 GiST(Space-partitioned GiST),适用于能划分为互不重叠区域的数据(前缀、点、IP 网络),搜索因此可以沿树中的一条路径向下进行。参见你很少会需要 SP-GiST。
脑裂(Split brain)
两台服务器同时作为主库接受写入,通常是因为故障切换提升了副本,却没有隔离旧主库。两边的历史会分叉,而且没有机制合并。应使用能隔离旧主库的故障切换管理工具,绝不要自行写脚本。参见不要自己拼凑故障切换。
可串行化快照隔离(SSI)
可串行化快照隔离(serializable snapshot isolation),Postgres 实现可串行化的方式:在可重复读的快照上,额外跟踪读写依赖;一旦形成危险的环,就中止一个事务。无需阻塞任何事务,但有事务需要重试。参见serializable 如何在不阻塞任何人的情况下捕获它。
statement_timeout
控制一条语句可以运行多久、超时后即取消的设置。应设得比请求截止时间更短,让已被放弃的工作不再继续持锁。参见每个超时默认都是关闭的。
流复制(Streaming replication)
备库随主库 WAL 到来而重放,形成逐字节一致、可响应读取的副本(热备库)。默认异步,因此故障切换可能丢失最后几次提交。参见副本是一台始终处于恢复中的服务器。
子事务(Subtransaction)
保存点或 PL/pgSQL 的 exception 块发生写入时取得的事务 ID。每个后端进程缓存 64 个;超过后,可见性检查就要回到磁盘查找。参见子事务并非没有代价。
synchronous_commit
控制提交要等待什么的设置。设为 off 时,提交会在 WAL 刷新前返回;崩溃可能丢失一个短时间窗口内、其他事务已经见过的事务,但不会造成数据损坏。参见synchronous_commit = off 会丢失一个窗口。
同步复制(Synchronous replication)
每次提交都等待备库确认 WAL 的复制方式,因此故障切换不会丢失数据。每次提交都要付出一次网络往返的代价;如果备库不可用,写入就会停止。参见同步提交要付出一次往返。
T
租户(Tenant)
多租户应用中的一个客户账户,多个客户共用同一批表。本书在每张租户表上都设置 account_id,并将它放在键的开头,让查询、行级安全以及将来的分片键保持一致。参见让租户无处不在。
文本搜索配置(Text search configuration)
解析器与每种词元所经过的词典的组合,例如 'english'。它是索引所存内容的一部分,因此始终应显式传入。参见配置是索引的一部分。
时间线(Timeline)
WAL 历史中带编号的分支。每次提升都会开启一条新时间线,WAL 文件名中包含其编号,因此恢复过程和 pg_rewind 能分辨一个段属于哪段历史。参见一次调用提升副本,开启新时间线。
TOAST
超长属性存储技术(The Oversized-Attribute Storage Technique):当一行超过约 2 KB 时,大字段值会被压缩,必要时分块移到附属表中。修改一个经过 TOAST 处理的值,会重写整个值。参见大值会先压缩,再移出行外。
事务 ID(Transaction ID)
事务首次写入时取得的 32 位编号(XID);只读事务从不取得这一编号。行版本中会记录事务 ID,因此计数器回卷至关重要。参见每次写入都会取得一个事务 ID。
触发器(Trigger)
表发生变化时,数据库运行的函数:可以在每行变化之前或之后执行,也可以每条语句执行一次。它对每个写入者都会触发,这正是它的意义;行级触发器即使几乎什么也不做,每行也要花费约一微秒。外键同样由触发器强制执行。参见触发器逐行运行,除非你另有指定。
三字符组(Trigram)
字符串中连续三个字符组成的序列。pg_trgm 扩展通过 GIN 或 GiST 为每个三字符组建立索引,让 like '%x%' 和相似度搜索可以利用索引。参见pg_trgm 让前置通配符也能使用索引。
tsvector
全文搜索类型:带位置信息、按顺序排列的词素,与 tsquery 通过 @@ 匹配。应将它存入一列,并在该列上建立索引。参见存储 tsvector;不要索引表达式。
元组(Tuple)
存储在页上的一个行版本。更新会写入新元组;旧元组会一直保留,直到死亡并被清理。参见每个页都有相同的布局。
元组头(Tuple header)
每个元组开头的 23 字节:xmin、xmax、ctid(自身或更新版本的地址)以及标志位;若有空值位图,则紧随其后。参见一行的成本高于它的列。
两阶段提交(Two-phase commit)
跨多个数据库的一笔事务:各方先准备,再全部提交。锁会一直持有到第二阶段;如果协调者在两阶段之间故障,就会留下已准备的事务。参见两阶段提交很少是答案。
TypeID
带前缀 ID 的一种规范:小写类型前缀、下划线,再接 base32 编码的 UUIDv7,例如 prj_01j6b7yh69fq2vyabwvmba4nr5。存储 uuid,显示时再带上前缀。参见前缀让 ID 说明自己的类型。
U
ULID
一个 128 位 ID,布局类似 UUIDv7(48 位毫秒时间戳、80 位随机数),没有版本位,以 26 个 Crockford base32 字符表示。它可以逐字节放入 uuid 列。参见ULID 与 uuid 列逐字节匹配。
不记日志表(Unlogged table)
不写 WAL 的表:写入便宜得多,崩溃后会被清空,也不会复制。适合暂存和可丢弃的数据。参见崩溃后,不记日志表会被清空。
插入或更新(Upsert)
键已存在时改为更新已有行的插入操作,以一条原子语句完成:insert ... on conflict。它指定用于裁决冲突的唯一索引,在并发下也是安全的。参见ON CONFLICT 是安全的插入或更新。
UUIDv4
包含 122 个随机位的 UUID。随机键可能落到 B-树的任何位置;在我们的测试中,100 万个这样的键写出了 551 MB WAL,而 UUIDv7 为 143 MB。参见UUIDv4 隐藏创建时间,但 WAL 是 3.8 倍。
UUIDv7
以 48 位毫秒时间戳开头的 UUID,因此新键落在索引最右端。自 PostgreSQL 18 起内置 uuidv7();它会暴露行的创建时间。参见UUIDv7 是默认选择,而且会泄露创建时间。
V
VACUUM
维护命令,用于移除死元组及其索引条目、记录空闲空间、截断尾部空页、冻结旧元组,并维护可见性映射。它让空间可以复用,很少会缩小文件。参见清理要做五件事。
VACUUM FULL
将表重写为一个新的紧凑文件的命令,在整个运行期间持有 ACCESS EXCLUSIVE。应安排维护窗口,或使用在线重建工具。参见大表执行 VACUUM FULL 会造成停机。
可见性映射(Visibility map)
每个堆页对应两个位:全可见和全冻结。仅索引扫描和清理依据它们跳过页;对页的任何修改都会清除它们。参见每页两位让扫描和清理跳过工作。
易变性(Volatility)
函数向规划器给出的承诺:immutable、stable 或 volatile(默认值)。错误地声明为 immutable 会返回过时的结果。参见易变性是给规划器的承诺。
W
等待事件(Wait event)
pg_stat_activity 中显示的会话正在等待的对象:Lock、LWLock、IO 或 Client。对这些事件采样,就能了解时间花在哪里。参见没有等待事件的活动会话正在占用 CPU。
预写式日志(WAL)
预写式日志(write-ahead log):在写入数据页之前,先将每次变更作为紧凑记录追加进去。提交只需等待日志;恢复、复制和时间点恢复都通过重放它完成。参见先写日志,而不是写数据页。
工作集(Working set)
负载在某段时间(例如一小时)内访问的页:是实际使用的那部分,而非整个数据库。应按工作集配置内存,超过它再加内存也没有收益。参见根据工作集配置 RAM。
work_mem
一个排序或哈希节点在溢写到临时文件之前可以使用的内存,默认 4 MB。它按节点、按连接分别计算,因此调高前先算乘法。参见work_mem 是按节点计算的,而且可以看到。
回卷(Wraparound)
32 位事务 ID 计数器转过一整圈、追上未冻结行的时刻,旧行会突然看起来像来自未来。Postgres 会在此之前停止接受写入,因此冻结必须跟上。参见回卷会在任何内容损坏前停止写入。
写偏差(Write skew)
两个事务读取相同数据、各自修改不同的行,合起来却破坏了一条各自单独执行时都不会破坏的规则的异常。只有可串行化级别能捕获它。参见Serializable 能捕获 repeatable read 漏掉的写偏差。
X
xmin 与 xmax
每个元组头中的两个事务 ID:xmin 插入了这个版本;xmax 删除、替换或锁住了它(均未发生时为 0)。将它们与快照对照,就能决定谁能看到这行。参见每次写入都会取得一个事务 ID。
xmin 清理界限(xmin horizon)
仍在使用的最老快照。早于它死亡的版本可以移除,其余必须保留。因此,一笔长事务会拖住整个数据库的清理;复制槽则会拖住整个集簇的清理。参见长事务会把一切都拖住。
44 参考文献
各章在“延伸阅读”或正文中引用的所有来源,都在这里列出一次,让你不必四处寻找,就能找到每项论述背后的原始资料。先从手册读起。想知道某种机制为什么这样设计时,再读源码说明和论文。把服务商页面视为某一时刻的快照。
每个条目列出标题、作者或出版者、适用时的年份,以及引用它的章节。各章的“延伸阅读”说明某项资料适合用来了解什么;本页说明它在哪里被引用。持续更新的文档不标年份,因此各章会注明核查服务商相关事实的时间。
引用章节时使用简称:序言(开始之前);基本概念(先认识这些基本概念);延迟(时间都花在哪里);存储(一切都从页说起);缓冲区(缓冲区缓存决定哪些页留下);MVCC(更新就是插入);HOT(让更新保持 HOT);WAL(先记日志,再写数据);ACID(如实看待 ACID);清理(清理不可省);不是 MySQL(Postgres 不是 MySQL);类型(类型是一份契约);键(慎选键,少后悔);关系(有目的地选择约束);数据模型(你还不需要另一个数据库);扩展(值得了解的扩展);B-树(B-树挑起大梁);更多索引(B-树之外);EXPLAIN(读计划,不看时钟);规划器(规划器也在估算);执行计划(代价最低的计划胜出);查询(经得住数据增长的查询);搜索(不用搜索引擎,也能搜索);函数(数据库中的代码);并发(大家都得排队);模式变更(变更模式,服务照常);数据加载(快速加载数据);连接(连接并非免费);基准测试(如实测量);配置(真正重要的配置);可观测性(观察数据库运行);备份(未经验证的备份只是传闻);安全(不要信任任何租户);托管数据库(别人来运行这台机器);服务商(选择一个你能离开的服务商);调优指南(先优化工作,再升级机器);扩容(先纵向扩容,再横向扩展);复制(权威数据的副本);分区(为删除而分区);分片(最后再考虑分片);局限(PostgreSQL 输在哪里)。
PostgreSQL 文档
PostgreSQL Global Development Group 编写的手册,除非条目另有说明,均指第 18 版(/docs/18/)。它是本书几乎所有论述的一手来源,版本变化时也应首先查阅这里。
- Additional Supplied Modules and Extensions。引用章节:扩展。
- ALTER DEFAULT PRIVILEGES。引用章节:安全。
- ALTER TABLE。引用章节:模式变更、分区。
- amcheck。引用章节:类型、备份。
- Architectural Fundamentals。引用章节:基本概念。
- Asynchronous Commit。引用章节:WAL、ACID。
- auto_explain。引用章节:EXPLAIN、函数。
- Backup and Restore。引用章节:备份。
- BRIN Indexes。引用章节:更多索引。
- B-Tree Indexes。引用章节:HOT、B-树。
- Collation Support。引用章节:类型。
- Concurrency Control。引用章节:不是 MySQL。
- Concurrency Control: introduction。引用章节:MVCC。
- Constraints。引用章节:关系。
- Continuous Archiving and Point-in-Time Recovery (PITR)。引用章节:备份。
- Controlling Text Search。引用章节:搜索、局限。
- COPY。引用章节:数据加载。
- CREATE FUNCTION。引用章节:安全。
- CREATE INDEX (including CONCURRENTLY)。引用章节:模式变更。
- CREATE POLICY。引用章节:安全。
- CREATE STATISTICS。引用章节:规划器。
- CREATE TABLE。引用章节:关系、扩容、分区。
- CREATE TRIGGER。引用章节:函数。
- Database Page Layout。引用章节:存储。
- Database Roles。引用章节:基本概念。
- Data Types。引用章节:类型。
- Date/Time Functions and Operators。引用章节:类型。
- EXPLAIN。引用章节:EXPLAIN。
- Explicit Locking。引用章节:并发。
- Free Space Map。引用章节:存储。
- Full Text Search。引用章节:搜索。
- Function Volatility Categories。引用章节:函数。
- GIN Indexes。引用章节:更多索引。
- GiST Indexes。引用章节:更多索引。
- Hash Indexes。引用章节:更多索引。
- Heap-Only Tuples (HOT)。引用章节:HOT。
- Hot Standby。引用章节:复制。
- How Connections Are Established。引用章节:连接。
- How the Planner Uses Statistics。引用章节:规划器。
- Indexes。引用章节:B-树。
- Index Types。引用章节:更多索引。
- INSERT (including ON CONFLICT)。引用章节:查询、数据加载。
- JSON Functions and Operators。引用章节:数据模型。
- JSON Types。引用章节:数据模型、更多索引。
- Just-in-Time Compilation (JIT)。引用章节:执行计划。
- Large Objects: introduction。引用章节:局限。
- Lexical Structure。引用章节:不是 MySQL。
- LIMIT and OFFSET。引用章节:查询。
- Logical Decoding。引用章节:局限。
- Logical Replication。引用章节:服务商、复制。
- Log-Shipping Standby Servers。引用章节:复制。
- ltree。引用章节:数据模型。
- Managing Kernel Resources。引用章节:配置。
- Materialized Views。引用章节:扩容。
- MERGE。引用章节:查询。
- NOTIFY。引用章节:数据模型。
- Operator Classes and Operator Families。引用章节:更多索引。
- Packaging Related Objects into an Extension。引用章节:扩展。
- pageinspect。引用章节:存储。
- Parallel Query。引用章节:执行计划。
- Performance Tips。引用章节:调优指南。
- pg_basebackup。引用章节:备份。
- pgbench。引用章节:基准测试、调优指南。
- pg_buffercache。引用章节:缓冲区。
- pg_combinebackup。引用章节:备份。
- pg_dump。引用章节:基准测试、备份、服务商。
- pg_prewarm。引用章节:缓冲区。
- pg_rewind。引用章节:复制。
- pg_stat_statements。引用章节:基准测试、可观测性、调优指南、扩容。
- pgstattuple。引用章节:清理。
- pg_test_fsync。引用章节:延迟。
- pg_trgm。引用章节:更多索引。
- pg_upgrade。引用章节:备份。
- Planner/Optimizer。引用章节:执行计划。
- PL/pgSQL: Transaction Management。引用章节:函数。
- PL/pgSQL under the Hood。引用章节:函数。
- Populating a Database。引用章节:数据加载。
- postgres_fdw。引用章节:分片。
- PostgreSQL 18.6 release notes。引用章节:扩展。
- PostgreSQL 18 documentation。引用章节:序言。
- PostgreSQL 18 release notes. 2025。引用章节:序言、B-树。
- PostgreSQL 19 Beta 4 Released!. 2026。引用章节:服务商。
- PostgreSQL Limits。引用章节:局限。
- Predefined Roles。引用章节:托管数据库。
- PREPARE。引用章节:规划器。
- Privileges。引用章节:安全。
- Progress Reporting。引用章节:可观测性。
- psql。引用章节:序言、基本概念。
- REFRESH MATERIALIZED VIEW。引用章节:扩容。
- REINDEX。引用章节:模式变更。
- Reliability。引用章节:延迟、ACID。
- REPACK (development version)。引用章节:扩展。
- Routine Vacuuming。引用章节:MVCC、清理、并发、调优指南。
- Row Security Policies。引用章节:安全。
- Schemas。引用章节:基本概念。
- Sequence Manipulation Functions。引用章节:键。
- Serialization Failure Handling。引用章节:并发。
- Server Configuration: Client Connection Defaults。引用章节:连接。
- Server Configuration: Connections and Authentication。引用章节:连接。
- Server Configuration: Error Reporting and Logging。引用章节:配置。
- Server Configuration: Query Planning。引用章节:规划器、调优指南、分区。
- Server Configuration: Replication。引用章节:复制。
- Server Configuration: Resource Consumption。引用章节:延迟、缓冲区、配置。
- Server Configuration: Vacuuming。引用章节:清理。
- Server Configuration: Write Ahead Log。引用章节:WAL、数据加载、配置。
- Set Returning Functions。引用章节:序言。
- Setting Parameters。引用章节:配置。
- Sorting Rows (ORDER BY)。引用章节:不是 MySQL。
- SP-GiST Indexes。引用章节:更多索引。
- Statistics Used by the Planner。引用章节:规划器。
- Subquery Expressions。引用章节:查询。
- Subtransactions。引用章节:并发。
- System Catalogs。引用章节:基本概念。
- Table Partitioning。引用章节:扩容、分区。
- The Cumulative Statistics System。引用章节:可观测性、调优指南、扩容。
- The pg_hba.conf File。引用章节:安全。
- The SQL Language。引用章节:基本概念。
- TOAST。引用章节:存储。
- Transaction Isolation。引用章节:MVCC、ACID、并发。
- Triggers。引用章节:函数。
- TRUNCATE。引用章节:MVCC。
- User-Defined Functions。引用章节:函数。
- Using EXPLAIN。引用章节:EXPLAIN。
- UUID Functions。引用章节:键。
- Versioning Policy。引用章节:序言、服务商。
- Viewing Locks。引用章节:可观测性。
- Visibility Map。引用章节:存储。
- WAL Configuration。引用章节:WAL。
- WITH Queries (Common Table Expressions)。引用章节:数据模型。
- Write-Ahead Logging (WAL)。引用章节:WAL。
PostgreSQL 源码、提交和 Wiki
手册告诉你“是什么”之后,README 会由构建这些机制的人亲自解释“为什么”。本节收录这些设计说明、两个提交以及社区 Wiki,均来自 PostgreSQL 项目。源码链接指向不断变化的 master 分支。
- A Guide to CVE-2018-1058: Protect Your Search Path. PostgreSQL Wiki。引用章节:安全。
- BRIN access method (src/backend/access/brin/brin.c). PostgreSQL 源码。引用章节:更多索引。
- BRIN design notes (src/backend/access/brin/README). PostgreSQL 源码。引用章节:更多索引。
- B-tree implementation (src/backend/access/nbtree/README). PostgreSQL 源码。引用章节:B-树。
- Buffer manager design notes (src/backend/storage/buffer/README). PostgreSQL 源码。引用章节:缓冲区。
- Count estimate. PostgreSQL Wiki。引用章节:查询。
- Don’t Do This. PostgreSQL Wiki。引用章节:类型。
- Fsync Errors. PostgreSQL Wiki。引用章节:ACID。
- Heap-only tuples (src/backend/access/heap/README.HOT). PostgreSQL 源码。引用章节:HOT。
- Hint Bits. PostgreSQL Wiki。引用章节:MVCC。
- Increase the number of fast-path lock slots (commit c4d5cb71d). Tomas Vondra, 2024。引用章节:并发。
- Inlining of SQL functions. PostgreSQL Wiki。引用章节:函数。
- Lazy vacuum (src/backend/access/heap/vacuumlazy.c). PostgreSQL 源码。引用章节:清理。
- Locale data changes. PostgreSQL Wiki。引用章节:类型。
- Lock manager design notes (src/backend/storage/lmgr/README). PostgreSQL 源码。引用章节:并发。
- Memory context design notes (src/backend/utils/mmgr/README). PostgreSQL 源码。引用章节:缓冲区。
- Number Of Database Connections. PostgreSQL Wiki。引用章节:连接。
- OptimizerHintsDiscussion. PostgreSQL Wiki。引用章节:规划器。
- Row locking and MultiXacts (src/backend/access/heap/README.tuplock). PostgreSQL 源码。引用章节:MVCC。
- Slow Counting. PostgreSQL Wiki。引用章节:查询。
- SSI. PostgreSQL Wiki。引用章节:ACID。
- Transaction system and WAL (src/backend/access/transam/README). PostgreSQL 源码。引用章节:WAL。
- Use ExtendBufferedRelBy() to extend tables more efficiently (commit 00d1e02be). Andres Freund, 2023。引用章节:并发。
论文
机制背后的研究:预写日志恢复、隔离性、B-link 树、基于代价的规划,以及向量搜索和混合搜索背后的索引。运行 Postgres 不需要先读这些论文。当某一章让你想追问一种机制的来历时,再找一篇来读。
- A Critique of ANSI SQL Isolation Levels. Hal Berenson, Phil Bernstein, Jim Gray, Jim Melton, Elizabeth O’Neil, and Patrick O’Neil, SIGMOD, 1995。引用章节:ACID。
- A Simple Guide to Five Normal Forms in Relational Database Theory. William Kent, Communications of the ACM, 1983。引用章节:关系。
- Access Path Selection in a Relational Database Management System. P. Griffiths Selinger, M. M. Astrahan, D. D. Chamberlin, R. A. Lorie, and T. G. Price, SIGMOD, 1979。引用章节:执行计划。
- ARIES: A Transaction Recovery Method Supporting Fine-Granularity Locking and Partial Rollbacks Using Write-Ahead Logging. C. Mohan, Don Haderle, Bruce Lindsay, Hamid Pirahesh, and Peter Schwarz, ACM TODS, 1992。引用章节:WAL。
- Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. Yu. A. Malkov and D. A. Yashunin, arXiv, 2016。引用章节:搜索。
- Efficient Locking for Concurrent Operations on B-Trees. Philip L. Lehman and S. Bing Yao, ACM TODS, 1981。引用章节:B-树。
- How Good Are Query Optimizers, Really?. Viktor Leis, Andrey Gubichev, Atanas Mirchev, Peter Boncz, Alfons Kemper, and Thomas Neumann, PVLDB, 2015。引用章节:规划器、执行计划。
- Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods. Gordon V. Cormack, Charles L. A. Clarke, and Stefan Büttcher, SIGIR, 2009。引用章节:搜索。
- Serializable Snapshot Isolation in PostgreSQL. Dan R. K. Ports and Kevin Grittner, PVLDB, 2012。引用章节:ACID。
- What Goes Around Comes Around… And Around…. Michael Stonebraker and Andrew Pavlo, SIGMOD Record, 2024。引用章节:数据模型、局限。
书籍
两部系统讲解的著作,都可以在线免费阅读。如果你想换一种讲解方式理解同样的概念,它们就是存储、MVCC 和 B-树三章最好的配套读物。
- The Internals of PostgreSQL. Hironobu Suzuki, 2015 年至今. Heap Table Structure, Concurrency Control。引用章节:存储、MVCC。
- Use The Index, Luke: Anatomy of an SQL Index. Markus Winand。引用章节:B-树。
规范与 RFC
本书关于标识符和访问控制的建议所依据的标准。
- Insecure Direct Object Reference Prevention Cheat Sheet. OWASP。引用章节:键。
- RFC 9562: Universally Unique IDentifiers (UUIDs). K. Davis, B. Peabody, and P. Leach, IETF, 2024。引用章节:键。
- TypeID specification. Jetify。引用章节:键。
- ULID specification. ulid 项目。引用章节:键。
服务商与项目文档
服务商页面经常变化,因此在依据某项价格、限制或版本作决定之前,要重新查看页面。各章都注明所引事实的日期,大多截至 2026 年 10 月。条目按来源分组,并为每个被引页面附上链接。
- About Pool Sizing. Brett Wooldridge, HikariCP wiki。引用章节:连接。
- Aiven for PostgreSQL documentation. Aiven. Aiven service and tool version lifecycle, High availability, Aiven for PostgreSQL backups, Pricing。引用章节:服务商。
- AlloyDB for PostgreSQL documentation. Google Cloud. Manage PostgreSQL users with built-in authentication, Supported database extensions, Improve query performance using query insights, AlloyDB high availability overview, Pricing, AlloyDB overview, About the AlloyDB columnar engine, Database version policies, Data backup and recovery overview, AlloyDB Omni overview, Export a DMP file。引用章节:托管数据库、服务商。
- Amazon Aurora User Guide and Aurora PostgreSQL release notes. AWS. Amazon Aurora PostgreSQL parameters, Extensions supported, Amazon Aurora storage, Replication with Amazon Aurora, High availability for Amazon Aurora, Amazon Aurora DB clusters, Release calendars, Using Amazon Aurora Global Database, How Aurora serverless works, Scaling to Zero ACUs with automatic pause and resume, Overview of PostgreSQL logical replication, Aurora PostgreSQL Limitless Database requirements and considerations, Amazon Aurora PostgreSQL Limitless Database updates, Aurora PostgreSQL Limitless Database architecture。引用章节:托管数据库、服务商、分片。
- Amazon EBS, EC2, S3, and Aurora DSQL documentation. AWS. Amazon EBS volume types, Amazon EBS General Purpose SSD volumes, Amazon EBS-optimized instance types, Specifications for Amazon EC2 storage optimized instances, Data persistence for Amazon EC2 instance store volumes, Migrating from PostgreSQL to Aurora DSQL, Uploading objects。引用章节:延迟、服务商、局限。
- Amazon RDS User Guide and RDS for PostgreSQL release notes. AWS. Understanding the rds_superuser role, Overview of parameter groups, Extension versions, Supported PostgreSQL extension versions, Amazon RDS DB instance storage, Amazon CloudWatch metrics, IO:DataFileRead, Database load, Avoiding pinning an RDS Proxy, Backup retention period, Restoring a DB instance to a specified time, Introduction to backups, Restoring to a DB instance, Upgrades of the RDS for PostgreSQL DB engine, PostgreSQL replication methods for blue/green deployments, Limitations and considerations blue/green deployments, Failing over a Multi-AZ DB instance, Failing over a Multi-AZ DB cluster, Parameters for logging in RDS for PostgreSQL, Improving query performance, Release calendars, Working with the Database Preview environment, Multi-AZ DB cluster deployments, Importing data into PostgreSQL on Amazon RDS, Amazon RDS Extended Support。引用章节:托管数据库、服务商。
- Apache AGE. Apache Software Foundation. Repository, Board meeting minutes。引用章节:扩展。
- Apache Kafka documentation. Apache Software Foundation. Introduction, Topic Configs。引用章节:局限。
- AWS pricing and announcements. AWS. Amazon RDS pricing, Amazon RDS for PostgreSQL pricing, Amazon Aurora PostgreSQL Limitless Database is now generally available (2024)。引用章节:托管数据库、服务商、分片。
- Azure Database for PostgreSQL and Azure HorizonDB documentation. Microsoft. Access Management, Load Libraries, List of Extensions and Modules by Name, Allow Extensions, Storage options, Monitor Using Metrics and Logs, Query Store, PgBouncer, Backup and Restore, Major Version Upgrades, High Availability, What is Azure Database for PostgreSQL?, Compute Options, Supported versions of PostgreSQL, Read replicas, Elastic Clusters, Extended Support, Pricing, What Is Azure HorizonDB?。引用章节:托管数据库、服务商。
- Barman. Barman 项目。引用章节:备份、服务商。
- Citus. Citus Data. Repository, Columnar storage。引用章节:分片、局限。
- ClickHouse documentation. ClickHouse. CREATE TABLE, A practical introduction to primary indexes, Transactional (ACID) support, Using JOINs。引用章节:局限。
- Cloud SQL for PostgreSQL documentation. Google Cloud. About PostgreSQL users and roles, Configure database flags, Configure PostgreSQL extensions, Choose a storage option, Use query insights to improve query performance, Managed Connection Pooling overview, Perform point-in-time recovery (PITR), Cloud SQL backups overview, Upgrade the database major version in-place, About high availability, Cloud SQL overview, Database versions and version policies, Cloud SQL editions overview, Cloud SQL for PostgreSQL features, Extended support for Cloud SQL, Pricing。引用章节:托管数据库、服务商。
- CockroachDB documentation. Cockroach Labs. PostgreSQL Compatibility, Replication Layer。引用章节:分片、局限。
- Compute Engine and Spanner documentation. Google Cloud. About Local SSD disks, Spanner: TrueTime and external consistency。引用章节:服务商、局限。
- Crunchy Bridge documentation. Crunchy Data. PostgreSQL versions, User management, High availability, Plans and pricing。引用章节:服务商。
- Debezium connector for PostgreSQL. Debezium 项目。引用章节:局限。
- DigitalOcean Managed PostgreSQL documentation. DigitalOcean. PostgreSQL Limits, PostgreSQL Features。引用章节:服务商。
- DuckDB documentation. DuckDB. Storage Versions and Format, Concurrency。引用章节:局限。
- EDB documentation. EnterpriseDB. EDB Postgres AI Cloud Service, Enterprise Postgres (Oracle Compatible) v18, Pricing and billing。引用章节:服务商。
- explain.dalibo.com. Dalibo。引用章节:EXPLAIN。
- explain.depesz.com. Hubert Lubaczewski。引用章节:EXPLAIN。
- Fly.io Postgres documentation. Fly.io. Managed Postgres, Unmanaged Postgres。引用章节:服务商。
- Hermitage. Martin Kleppmann 及贡献者。引用章节:不是 MySQL。
- Heroku Dev Center: Heroku Postgres. Heroku. Choosing the Right Heroku Postgres Plan, Heroku Postgres Advanced (Limited GA), Heroku Postgres Version Support, Heroku Postgres Credentials, High Availability。引用章节:服务商。
- HypoPG. HypoPG 项目. Repository, Documentation。引用章节:扩展。
- KSUID. Segment。引用章节:键。
- Kubernetes operators for PostgreSQL. CloudNativePG, CloudNativePG at the CNCF, Crunchy Postgres for Kubernetes, Zalando postgres-operator, StackGres, Percona Operator for PostgreSQL。引用章节:服务商。
- Lead. PlanetScale。引用章节:搜索。
- Linux kernel documentation. Linux kernel. Control Group v2, Documentation for /proc/sys/vm。引用章节:配置。
- MySQL 8.4 Reference Manual. Oracle. Clustered and Secondary Indexes, InnoDB Multi-Versioning, Transaction Isolation Levels。引用章节:不是 MySQL。
- NanoID. Andrey Sitnik。引用章节:键。
- Neon documentation. Neon. Manage roles, Postgres extensions, The lakebase architecture, Scale to Zero, Connection pooling, Postgres version support, Branching, Logical replication, Neon plans。引用章节:托管数据库、服务商。
- Nile documentation. Nile. Architecture of Nile Postgres, Postgres Compatibility。引用章节:服务商。
- ParadeDB architecture. ParadeDB。引用章节:搜索。
- Patroni. Patroni 项目。引用章节:服务商、复制。
- pgAudit. pgAudit 项目。引用章节:扩展、安全。
- pgBackRest. pgBackRest 项目. Home, User Guide, News。引用章节:备份、服务商。
- PgBouncer documentation. PgBouncer 项目. Features, Configuration, Changelog。引用章节:连接。
- pg_cron. Citus Data。引用章节:扩展。
- PgDog. PgDog 项目。引用章节:分片。
- pg_duckdb. DuckDB 项目。引用章节:扩展、局限。
- pg_hint_plan. NTT OSS Center。引用章节:扩展、执行计划。
- pg_lake. Snowflake Labs。引用章节:扩展。
- pg_mooncake. Mooncake Labs。引用章节:扩展。
- pgmq. pgmq 项目。引用章节:扩展。
- pg_partman. pg_partman 项目。引用章节:扩展、分区。
- pg_repack. reorg 项目. Repository, Documentation。引用章节:扩展。
- pgroll. Xata。引用章节:模式变更。
- PGroonga. PGroonga 项目。引用章节:扩展。
- pg_search. ParadeDB。引用章节:搜索。
- pg_squeeze. CYBERTEC。引用章节:扩展。
- pg_textsearch. Tiger Data。引用章节:搜索。
- pgvector. pgvector 项目。引用章节:搜索、局限。
- pg_wait_sampling. Postgres Professional。引用章节:可观测性。
- PlanetScale documentation, benchmarks, and pricing. PlanetScale. PlanetScale benchmarks, PlanetScale vs Amazon Aurora benchmarks, PlanetScale vs Neon / Lakebase benchmarks, PlanetScale Postgres architecture, PlanetScale vs Xata benchmarks, Supported versions, Logical replication and Change Data Capture (CDC), Point-in-time recovery, Horizontal sharding for Postgres, Pricing, Query planning。引用章节:服务商、分片。
- PLJS. plv8 项目。引用章节:扩展。
- PL/v8. plv8 项目。引用章节:扩展。
- PostGIS. PostGIS 项目. Home, Spatial Queries, PostGIS_Extensions_Upgrade, License。引用章节:扩展。
- PostgreSQL Anonymizer. PostgreSQL Anonymizer 项目。引用章节:基准测试。
- Prisma Postgres FAQ. Prisma。引用章节:服务商。
- Railway documentation. Railway. Databases, Upgrading PostgreSQL to High Availability, Backups。引用章节:服务商。
- Render documentation. Render. Upgrading Your Render Postgres Version, High Availability, Render Postgres Recovery and Backups, Deploy for Free。引用章节:服务商。
- Similarity settings. Elastic。引用章节:局限。
- Snowflake (2010 release). Twitter。引用章节:键。
- Snowflake Postgres documentation. Snowflake. Snowflake Postgres, Snowflake Postgres Roles。引用章节:服务商。
- Sqids. Sqids 项目。引用章节:键。
- Squawk. Squawk 项目。引用章节:模式变更。
- strong_migrations. Andrew Kane。引用章节:模式变更。
- Supabase documentation. Supabase. Postgres Roles, Postgres Extensions Overview, Compute and Disk, Connect to your database, Architecture, Upgrading, Replicate to another Postgres database using Logical Replication, Branching, OrioleDB Overview, Pricing。引用章节:托管数据库、服务商。
- sysbench-tpcc. Percona。引用章节:服务商。
- Tiger Data documentation. Tiger Data. Maintenance and upgrades, Manage data security in your service, Pricing。引用章节:服务商。
- TimescaleDB. Tiger Data. Repository, Apache 2.0 license, Timescale License, Compare TimescaleDB editions。引用章节:扩展。
- Valkey documentation. Valkey 项目. Introduction, Persistence。引用章节:局限。
- VectorChord-bm25. VectorChord 项目。引用章节:搜索。
- Volumes. Kubernetes。引用章节:配置。
- WAL-G. WAL-G 项目。引用章节:备份、服务商。
- wrk2. Gil Tene。引用章节:基准测试。
- Xata documentation and pricing. Xata. Branching, Extensions, Pricing。引用章节:服务商。
- YugabyteDB Query Layer. Yugabyte。引用章节:局限。
参考资料
- German tank problem. Wikipedia,未注明日期。引用章节:键。
文章、演讲与事故复盘
按作者或出版者列出的工程文章、演讲、公告和事故记录。先读事故复盘:让亲历者讲述其他团队的停机事故,比自己经历一次代价低得多。
- Abusing SECURITY DEFINER functions. Laurenz Albe, CYBERTEC, 2019。引用章节:安全。
- AlloyDB for PostgreSQL intelligent scalable storage. Google Cloud 博客, 2022。引用章节:托管数据库。
- An Update on Heroku. Heroku, 2026。引用章节:服务商。
- Analyzing the Limits of Connection Scalability in Postgres. Andres Freund, Microsoft, 2020。引用章节:连接。
- Benchmarking Postgres. Ben Dicken, PlanetScale, 2025。引用章节:服务商。
- Case-insensitive pattern matching in PostgreSQL. Laurenz Albe, CYBERTEC, 2022。引用章节:类型。
- Databricks Agrees to Acquire Neon to Deliver Serverless Postgres for Developers + AI Agents. Databricks, 2025。引用章节:服务商。
- Designing APIs for humans: Object IDs. Paul Asjes, Stripe, 2022。引用章节:键。
- HOT updates in PostgreSQL for better performance. Laurenz Albe, CYBERTEC, 2020。引用章节:HOT。
- How NOT to Measure Latency. Gil Tene, QCon San Francisco, 2015。引用章节:基准测试。
- How To Correct and Identify Indexes Affected by the GNU C 2.28 Update. David Thomas, Crunchy Data, 2019。引用章节:类型。
- Introducing TIN: full-text search for Postgres. PlanetScale, 2026。引用章节:搜索。
- Meet the Team Behind Snowflake Postgres. Elizabeth Garrett Christensen, Snowflake, 2025。引用章节:服务商。
- Numbers Every Programmer Should Know By Year. Colin Scott,未注明日期。引用章节:延迟。
- On Uber’s Choice of Databases. Markus Winand, 2016。引用章节:不是 MySQL。
- PlanetScale for Postgres is now GA. PlanetScale, 2025。引用章节:服务商。
- Postgres LISTEN/NOTIFY does not scale. Recall.ai, 2025。引用章节:数据模型。
- Postmortem of database outage of January 31. GitLab, 2017。引用章节:备份。
- Quack: The DuckDB Client-Server Protocol. DuckDB, 2026。引用章节:局限。
- Reaction to the PlanetScale PostgreSQL benchmarks. Xata, 2025。引用章节:服务商。
- Separation of storage and compute without a performance tradeoff. Neon, 2025。引用章节:服务商。
- Snowflake Acquires Crunchy Data to Bring Enterprise Ready Postgres Offering to the AI Data Cloud. Snowflake, 2025。引用章节:服务商。
- Speed Without Sacrifice: Building the Modern PostgreSQL for the Analytical and Agentic Era. Ajay Kulkarni and Mike Freedman, Tiger Data, 2025。引用章节:服务商。
- The Part of PostgreSQL We Hate the Most. Andy Pavlo and Bohan Zhang, 2023。引用章节:HOT。
- The USE Method. Brendan Gregg,未注明日期。引用章节:可观测性。
- Thoughts on Uber’s List of Postgres Limitations. Simon Riggs, EDB, 2016。引用章节:不是 MySQL。
- Transaction ID Wraparound in Postgres. Sentry, 2015。引用章节:清理。
- Uber’s move away from PostgreSQL. Robert Haas, 2016。引用章节:不是 MySQL。
- VACUUM won’t remove dead rows: 4 reasons why. Laurenz Albe, CYBERTEC, 2018。引用章节:清理。
- We need tool support for keyset pagination. Markus Winand, 2014。引用章节:查询。
- What We Learned from the Recent Mandrill Outage. Mailchimp, 2019。引用章节:清理。
- Why Uber Engineering Switched from Postgres to MySQL. Evan Klitzke, Uber, 2016。引用章节:不是 MySQL。
- Why we spent the last month eliminating PostgreSQL subtransactions. GitLab, 2021。引用章节:并发。
- Zero-downtime Postgres migrations: the hard parts. Chris Sinjakli, GoCardless,未注明日期。引用章节:模式变更。
- Zero-downtime Postgres schema migrations need this: lock_timeout and retries. Nikolay Samokhvalov, PostgresAI, 2021。引用章节:模式变更。