40 最后再考虑分片
我们为本章搭建了一个小型分片集群。同样是连接 projects 和 users,一种写法耗时约 10 毫秒,另一种约 950 毫秒。行相同,机器相同,结果也相同,区别只在于 on 子句里多了一项等式:u.account_id = p.account_id。有了它,每个分片在本地连接自己的行;没有它,集群就得先通过网络重新分配两张表的数据,而且默认会拒绝执行。
分片就是这样。每个查询,要么靠分片键留在本地,要么付出网络开销。选定分片键的那一天,你就决定了它会走哪条路。
我们认为,多数团队分片过早,而在分片之前就为它做好设计的团队又太少。从第一天起就为分片做好设计,然后能等多久就等多久。等到那一天,工具的重要性远不及分片键。
分片让一切成倍增加
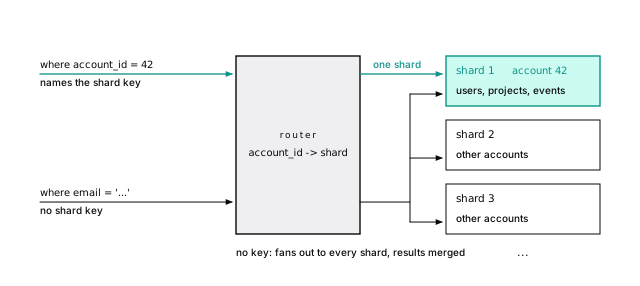
分片把一个逻辑数据库拆到多个独立的主库上。分片(shard)是行的一个子集;分片键(shard key,也称分布列)决定一行落在哪个分片上。本章用的是 account_id,前面有一个路由器,知道每个账户在哪。
除按功能拆分数据库以外,这是扩展阶梯中唯一能抬高写入量和数据总量上限的一阶。代价是:PostgreSQL 原本在一台服务器内替你处理的所有事情,现在都被一道边界切开了:
- 查询不指定一个分片键值,就会发到所有分片,再合并结果;跨分片连接则要通过网络传送行。
- 跨分片的事务需要两阶段提交(two-phase commit)来保持原子性。
- 约束只管一个分片:
(account_id, email)可以唯一,单独的email却不行。 - 迁移与运维要做 N 遍:N 套副本、备份、清理积压,以及可能在凌晨 3 点发来告警的地方。
这都不是永远不分片的理由,而是提醒你:先确认其他选择更糟。
一个主库再也扛不住写入或装不下数据时,才分片
即便用了你愿意运维的最大机器,以下三个信号仍说明,一个主库已经扛不住你的写入,或装不下你的数据:
- 写入吞吐量碰顶:即使调优了WAL 和检查点,也做了批处理,写入仍让主库饱和。这里说的是写入,不是读取。
- 从运维角度看,数据已经超出单机容量:恢复时间超过恢复时间目标,清理永远追不上。
- 硬性要求必须隔离租户:数据驻留要求,或合同约定的专用硬件。这是应当提前分片的唯一情形。
以下都不是信号:“我们以后可能会很大”、慢查询、连接数、读取负载。先试成本更低的几级阶梯,包括经常被低估的那一级:按功能拆分。把 events 和写入它的程序迁到独立的数据库,两边仍然各自像一个 PostgreSQL 那样运作。
测量 WAL 生成速率(对 pg_current_wal_lsn() 间隔一分钟采样)、最大表每月的增长量,以及恢复时间。向前推算一年,与能买到的最大实例比较。如果三年后才会触及上限,你现在还没有分片问题,只需要在日历里设个提醒。
分片键就是整个设计的核心
选择分片键时,要让负载最高的查询,以及不能拆开的事务,都留在同一个分片上。好的分片键几乎出现在每个高频查询的过滤条件里,被一起连接或写入的行共用,而且取值众多、分布均匀。
对于多租户 SaaS,这就是租户 ID:应用一次服务一个账户,同一账户的行会相互连接,却从不与其他账户的行连接。若把 events 按 id 分片,每个“我这个账户的事件”查询都会访问所有分片;若按 created_at 分片,今天的所有写入都会落到同一个分片。跨租户报表则变成扇出(fan-out)查询:只要不常做,就没问题。
**哈希分散的是租户,不是负载。**一个客户的 CI 系统新增 400,000 个事件,就把它所在的分片从 13 MB 撑到了 61 MB,而哈希到这里的其他账户也共用这个分片。大租户需要独立分片,所以迁移单个租户必须成为日常操作。
共置(colocation)让连接留在本地。把 users、projects 和 events 用相同的方式按 account_id 分片,账户 42 的行就会放在一起,在本地连接——前提是连接条件包含分片键。这就是 10 ms 与 950 ms 的差别。每个租户都要读取的小表,则作为参考表(reference table)复制到每个分片上。
深入阅读:一个热点租户怎样改变了分片大小
这是 citus_shards 中 events 的结果,按大小降序排列。如果一个租户单独就超过了最大机器的容量,还需要在租户内部再引入一个键;极少有产品走到这一步。
动手验证 · lab 39-sharding.sh
从第一天就留好余地
不实际分片,也能让将来的分片成本降低。同样的习惯还能让行级安全更简单,让跨租户的 bug 更难出现。每张属于租户的表都加上 account_id,每个主键、唯一约束、外键,以及每个查询的 where 子句都带上它(让租户无处不在、让跨租户引用不可能发生)。在单机上,这些复合键防止跨租户引用;分片后,只有这种键才能得到强制约束。
已经用了单列键?先在单机上逐步迁移:复合唯一约束、复合外键(先 not valid,再 validate),最后改查询。每一步本身都值得做。
分片表无法在整个系统内强制保证一个邮箱只对应一个账户。在一个未分片的数据库里保留一张小型 (email, account_id) 表,对 email 加唯一约束,先在这里占用邮箱,再到相应分片上创建用户。如果创建失败,就释放这次占用。没有两阶段提交,独立数据库就无法与用户创建共用一个事务,因此必须先占用,再用清理任务移除那些超过几分钟、却始终没有对应用户的占用记录。(在 Citus 中,可以用参考表保存占用记录,与用户创建在同一个分布式事务中写入。)分片前就要决定好。
按租户路由,绝不按 ID 路由
每个分片都有自己的序列,因此两个分片都会分配出 id = 1。如果 ID 要在数据库之外使用,就采用分片位(shard bits,用 bigint 的高位标识分片,类似 Snowflake)或 UUIDv7(无需协调,PostgreSQL 18 中有 uuidv7());ID 格式概览比较了其他选择。
用 16 位标识分片,每个分片就能分配 281 万亿个 ID。但 ID 说明的是一行创建时所在的位置,不是租户迁移后的所在位置:按租户路由,绝不按 ID 路由。
深入阅读:Citus 如何分配带分片位的 ID
Citus 的标识列采用分片位。在协调节点(coordinator)和各工作节点(worker)上执行相同的插入(returning id, id >> 48 as node_bits):
每个节点的序列起点,都是该节点的组号左移 48 位。(协调节点属于组 0,因此它的 ID 看起来很普通。)
动手验证 · lab 39-sharding.sh
跨分片查询会扇出
查询不带分片键,就会发往每个分片,并由某个组件合并结果:求和可以直接相加,平均值需要总和与计数,limit 10 需要每个分片的前 10 条,去重计数需要拿到各个值。延迟取决于最慢的分片;32 个分片上每秒 100 次这样的查询,就是每秒 3,200 个任务。增加分片后,租户内查询给每个节点带来的开销会下降,扇出查询却不会。把它限于后台作业和内部工具。
跨分片事务需要两阶段提交
写入也有同样的边界。向两个分片写入,就是两个事务;如果其中一个失败,转账就只做了一半。两阶段提交会先让所有分片执行 prepare transaction,然后才允许提交。直到第二阶段,它都在各处持有锁;如果协调节点在两个阶段之间宕机,留下的预备事务(prepared transaction)会继续持锁,阻碍清理。普通 PostgreSQL 默认关闭这项功能(max_prepared_transactions = 0),postgres_fdw 也不使用它。最好的跨分片事务,是分片键让你根本不必执行的那一种。
深入阅读:远程命令日志中的两阶段提交
在 Citus 上,一次没有租户过滤条件的更新,向两个工作节点先后发送了 PREPARE TRANSACTION 和 COMMIT PREPARED。在两条命令之间,每个工作节点都持有一个预备事务:它能跨重启保留状态,继续持有行锁,并阻止清理界限向前推进,直到有人提交或回滚它。Citus 会在自己的元数据中记录每个预备事务,由维护守护进程自行提交或中止残留事务;如果你自己实现 2PC,这就是你的工作,可以在 pg_prepared_xacts 中找出滞留的事务。
动手验证 · lab 39-sharding.sh
重新分片就是迁移租户
迟早会有一个租户需要独占一台机器。带行过滤的逻辑复制(PostgreSQL 15+,参见它的用途)会复制一个租户的行,然后持续传送变更。
有了租户目录——记录每个租户属于哪个分片的表——迁移只需四步:发布 where (account_id = 42) 所匹配的数据并订阅;延迟接近零时,把租户标为只读;延迟归零时,把目录指向目标;分批清理源端。只读窗口持续几秒钟。逻辑复制不复制序列,因此目标端生成的 ID 不能与迁入的 ID 冲突。这也是采用分片位或 UUIDv7 的又一个理由。
Citus(在 PostgreSQL 内部分片的扩展,下文介绍)的分片迁移,以及 PgDog(分片代理,下文介绍)的重新分片,都使用同一个协议。这很好地说明,选它作为基础机制是合适的。
深入阅读:在两个普通 PostgreSQL 数据库间迁移账户 42
PostgreSQL 负载有七种分片方式
七种方式的区别在于:路由在哪里,谁来合并跨分片结果,以及保留多少 PostgreSQL 功能。本节关于其他项目的每项事实,都取自截至 2026 年 10 月它们自己的文档;选定之前请再核查。我们运行了 postgres_fdw 和 Citus,因为两者都是开源软件,能在任何地方运行:便于演示,并非默认答案。
应用路由器把每个难题都交给你
你运行普通主库,由代码中的路由器查询每个租户所在的分片。托管或自建的 PostgreSQL 都行,但每个难题——合并、迁移、原子性——都归你解决。
深入阅读:租户目录,以及无法绕过的路由器
哈希范围无需查询目录,却不能单独迁移一个租户。目录可以把每个租户放到任意位置;SaaS 就选它:
不提供账户 ID,就拿不到数据库句柄,因此任何查询都无法跳过路由。租户迁移的几秒内,目录仍可能过时,这正是 state 列的用途:状态变化时重载目录,并拒绝向标为 read_only 或 moving 的租户写入。**适合:**数量不多的大租户,以及无法安装扩展的托管 PostgreSQL。**成本:**扇出结果合并、迁移、模式变更工具,以及所需的两阶段提交,都要自己实现。
postgres_fdw 是一块积木
把哈希分区表的每个分区都设为另一台服务器上的外部表,父表就能把行路由到不同机器。租户内查询会把过滤条件下推到一台服务器;跨租户聚合则会把所有行拉回来。没有两阶段提交、约束或再均衡:它是一套零件,不是一辆整车。
深入阅读:用分区和外部表手工分片
在一个普通的 PostgreSQL 18 数据库上,指向 Citus 工作节点主机上的两个普通数据库(这里没有用到 Citus):
100 个账户的 50,000 行分别被路由成 26,000 行和 24,000 行。账户 42 的查询只向一台服务器发送 WHERE ((account_id = 42))。按分片键分组并启用 enable_partitionwise_aggregate 时,完整聚合会并发下推到两台服务器(async_capable,PostgreSQL 14+);按 kind 分组时,则把所有行拉回本地计数,因为 PostgreSQL 18 的 postgres_fdw 不下推部分聚合。
动手验证 · lab 39-sharding.sh
Citus 在 PostgreSQL 内部路由与合并
Citus 是一个开源扩展(AGPL-3.0),把一组 PostgreSQL 服务器组成一个分布式数据库:你连接协调节点,工作节点保存分片,路由、合并、两阶段提交、DDL 和再均衡都由它代劳。
最新版本是 14.2.0(14.0 加入了 PostgreSQL 18 支持)。我们的集群使用 Citus 14.2.0,运行在镜像自带的 PostgreSQL 18.4 上;两个工作节点,按 account_id 划分的 32 个共置分片。租户内查询是在一个工作节点上执行的一个任务,跨租户查询是由协调节点合并的 32 个任务,而本章开头那个不带 account_id 的连接则被拒绝执行。
约束必须包含分布列
分片只能检查自己的行,因此 Citus 会拒绝任何不带分布列的主键、唯一约束或排他约束:原来的 primary key (id) 无法按 account_id 分布,unique (email) 也不行。外键必须通过分布列连接共置的表,或指向参考表。从第一天就采用的复合键全部得到了接受。
深入阅读:实测 Citus 的数据分布、路由查询、扇出与连接
每张表通过哈希分成 32 个分片(citus.shard_count 的默认值);在笔记本电脑上的集群中,把一份 240 万行的 events 副本转为分布式表花了约十秒钟。(先分布,再添加外键;反过来会失败。)约束错误如下:
按类型统计账户 42 上周的事件:
任务内部是普通的执行计划(照常读它:1,100 个堆页,因为主键能找到账户 42,却无法筛选上周)。跨租户版本是 Task Count: 32,协调节点对 160 行部分结果求和。count(distinct ...) 和窗口函数未按 account_id 分区,则会把原始行拉上来。
不带 account_id 的连接报错:ERROR: the query contains a join that requires repartitioning。启用 citus.enable_repartition_joins = on 后,两个 MapMergeJob 先重新分配两张表的数据,再由 12 个任务执行连接:一个 count(*) 耗时约 950 ms,而加上 u.account_id = p.account_id 后约为 10 ms(这是笔记本电脑上的计时,重点在差距)。
动手验证 · lab 39-sharding.sh
select id from users where email = 'user4242@example.com' 在分片集群上是合法查询。它的计划显示 Task Count: 32:单机上一次索引查找能做完的事,现在每个分片都要查一遍。不会报任何错误。分片前后都要检查负载最高的查询的执行计划,把请求路径上的扇出视为 bug。
深入阅读:Citus 迁移热点租户与按模式分片
从 Citus 11 起,元数据会同步到工作节点,因此任何节点都能路由(按租户路由,绝不按 ID 路由中的工作节点插入就是这样);协调节点上的 DDL 则在一个分布式事务中传到每个分片:模式变更规则,乘以 32。
这给了账户 7 自己的分片(哈希范围只有一个值),也拆分了与之共置的 users 和 projects 分片。citus_move_shard_placement(..., shard_transfer_mode => 'force_logical') 通过逻辑复制迁移它们,期间仍允许写入:51 MB 用时约 2 秒。早先有一次实验,在线拆分因一个无法复现的重复键冲突而停滞,所以一定要在生产数据副本上演练;call citus_cleanup_orphaned_resources() 可以清理中断迁移留下的资源。再均衡器(citus_rebalance_start())从 Citus 10 起就已开源,Citus 11 又开放了非阻塞迁移。
Citus 12 及更高版本也能按模式分片(citus.enable_schema_based_sharding):每个模式成为一个位于单个节点上的共置组。我们的实验把 tenant_acme 和 tenant_globex 放在不同的工作节点上,在同一个模式内做连接只需一个任务。它也继承了下文所述每租户一个模式的成本。
动手验证 · lab 39-sharding.sh
代理让分片保持普通 PostgreSQL
分片代理放在通常放连接池的位置,解析每条查询,再把它发给正确的普通 PostgreSQL 主库,因此分片无需安装扩展。有三个项目公开了代码:PgDog、SPQR 和 Multigres。代理能合并哪些跨分片结果,取决于它目前的解析器支持什么;要拿自己的查询去测试。
深入阅读:PgDog、SPQR 和 Multigres 的自我介绍
- PgDog 自称 “an open source proxy for scaling PostgreSQL”(AGPL-3.0,Rust),也提供连接池和读取负载均衡。它用 PostgreSQL 解析器找出分片键,对其余查询做扇出与合并(部分
count、sum、min、max、avg及排序),支持两阶段提交,并通过逻辑复制协议重新分片。它的 README 说它 “is used in production and at scale”,但部分功能仍处于实验阶段。 - SPQR(Stateless Postgres Query Router)来自 Yandex Cloud 的数据平台团队,自称能为按分片键 “well splitted by a sharding key” 的数据库提供 “production-ready” 的 “single-shard OLTP queries”。
- Multigres 是 Supabase 与 Vitess 的一位联合创始人共同开发的 “a Vitess adaptation for Postgres”(Apache-2.0),“currently in the early stages of development”。
托管分片的代价是功能受限,也更难退出
三家服务商替你运行集群:Amazon Aurora PostgreSQL Limitless Database(自 2024 年 10 月 31 日起正式可用)、Azure Database for PostgreSQL elastic clusters(托管 Citus),以及 PlanetScale Neki(自 2026 年 9 月 10 日起进入平台预览)。你要接受服务商提供的版本和功能子集,退出也更困难(参见托管平台本身)。
深入阅读:Limitless、elastic clusters 和 Neki 的架构与文档所列限制
- Aurora PostgreSQL Limitless Database:路由器持有元数据、拆解查询,并负责 “manage distributed transactions”;分片是 Aurora PostgreSQL 实例;表分为分片表(仅支持哈希)、参考表和标准表。自 2024 年 10 月 31 日起正式可用,发布时兼容 PostgreSQL 16.4。要求页面列出的限制包括:仅支持专用的
16.X-limitless引擎版本(目前列出的最新版是 16.13-limitless,没有 17 或 18 的构建版本);不支持可串行化隔离级别;分片键不可更新;可拆分但不可合并;只支持一部分扩展和 Aurora 功能。 - Azure Database for PostgreSQL elastic clusters 是 “a managed offering of the open-source Citus extension”,支持按行和按模式分片。更早的 Cosmos DB for PostgreSQL 同样基于 Citus,目前 “is on a retirement path and no longer recommended for new projects”。
- PlanetScale Neki 是 Vitess 背后的团队从头构建的 “sharded Postgres”:在普通 PostgreSQL 分片前放置无状态路由器,路由器包含完整的 PostgreSQL 解析器和分布式规划器(跨可用区至少部署三个),每个分片至少有两个副本。JSON 数据拓扑通过哈希(
xxhash)或整数range函数映射分片键;参考表和全局二级索引用于其他查找;重新分片采用带校验的在线复制与变更流传送流程。它在 2026 年 9 月 10 日进入平台预览(适用 beta 条款,无 SLA),文档也直陈不足:多分片读取不共用同一个快照;多分片写入逐个分片提交,没有两阶段提交;DDL 会扇出,但不具备原子性。single事务模式会拒绝任何需要访问第二个分片的事务。
Neki 的分片是普通 PostgreSQL,但它的路由器无法由你自行运行;elastic clusters 使用的扩展则可以自行托管。
分布式 SQL 会说 PostgreSQL 的话,却不是 PostgreSQL
CockroachDB 和 YugabyteDB 支持 PostgreSQL 协议及其大部分 SQL,但底下是不同的数据库:由 Raft 复制的小单元组成,能自行拆分和再均衡,内置分布式事务。本书关于页、清理和堆的论述描述的是 PostgreSQL,不是它们。选择其中一个,就是迁移到另一种引擎。
深入阅读:CockroachDB 与 YugabyteDB 文档所述的差异
- CockroachDB 有自己的实现。其 v26.3 兼容性页面列出的不支持功能包括触发器、范围类型、外部数据包装器,以及会话级咨询锁;一些行为也有差异(整数除法返回小数)。事务默认使用
SERIALIZABLE。自 24.3 版本起,它采用专有的 CockroachDB Software License,并为较小规模的企业提供免费档位。 - YugabyteDB 在自有存储引擎 DocDB 上运行 PostgreSQL 查询层的一个分支。v2025.1 把这个分支的基线从 PostgreSQL 11.2 升到了 15.0,因此落后于当前的 PostgreSQL。数据库核心采用 Apache-2.0 许可证。
每租户一个模式,成本随租户数增长
技术上最简单的选择,是为每个租户分配一个模式,甚至一整个数据库,放在你想放的服务器上。结构本身就实现了隔离,迁移一个租户只需导出一次。成本随租户数增长:1,000 个租户,每个只有三张空表,还没存一行数据,就新增了 16,000 个关系和超过 40 MB 的系统目录;每次模式变更都要执行 1,000 遍,每一遍都有自己的锁,也有失败的可能。
深入阅读:1,000 个空租户模式的成本
按难题落在哪里来选择
每种方案都把难题移到别处
各种方案如何处理这些难题:
| 方案 | 路由所在位置 | 跨分片连接 | 跨分片写入 |
|---|---|---|---|
| 应用路由器 | 你的代码 | 自己写 | 自己实现(需要 2PC 就自己做) |
postgres_fdw | 路由数据库 | 拉到路由数据库 | 不具备原子性 |
| Citus | 协调节点或任意节点 | 共置时在本地,否则需显式开启 | 自动使用 2PC |
| 代理 | 代理中 | 由解析器支持范围决定如何合并 | PgDog:2PC |
| 托管服务 | 服务商的路由器 | 共置时在本地 | 因服务而异(注 1) |
| 分布式 SQL | 任意节点 | 支持 | 内置 |
| 每租户一个模式 | 你的代码 | 同一数据库内 | 同一数据库内 |
长期使用它们的成本:
| 方案 | 再均衡 | 运维负担 | 锁定程度 |
|---|---|---|---|
| 应用路由器 | 自己实现 | 高 | 无 |
postgres_fdw | 手动 | 高 | 无 |
| Citus | 在线迁移 | 中 | 低 |
| 代理 | 取决于工具 | 中 | 低 |
| 托管服务 | 服务负责(注 2) | 低 | 高(注 3) |
| 分布式 SQL | 自动 | 中 | 高 |
| 每租户一个模式 | 迁移单个租户 | 随租户数增长 | 无 |
托管服务一行的注释:(1)Limitless 和 elastic clusters 的跨分片写入具备原子性;处于预览阶段的 Neki 则逐个分片提交。(2)Limitless 能拆分分片,却不能合并;Neki 能在线重新分片。(3)Limitless 和 Neki 的锁定程度高,elastic clusters 较低,因为它使用的 Citus 可以自行运行。“代理”指 PgDog 及前述其他项目;Citus 的“任意节点”能力始于 Citus 11。自行构建的方案运维负担高,因为你要运行 N 个主库,加上自己开发的工具;代理在关键路径上增加了一个服务;分布式 SQL 则是一种需要重新学习的数据库。
多数团队还不需要分片
- 你还不需要分片:如果更大的机器、副本、分区,或拆出一项负载能再撑两年。多数团队都属于这种情况。
- **几十个大租户,或有数据驻留要求:**每租户一个数据库,或者带目录的应用路由器。
- **许多租户共用表,希望由 PostgreSQL 合并结果:**自建或托管的 Citus(Azure elastic clusters),或者采用分片代理,让分片无需安装扩展。两种方案都做原型测试。
- **深度依赖 AWS,也接受它的功能子集:**Aurora PostgreSQL Limitless Database。先读它不支持的功能清单。
- **想在普通 PostgreSQL 上使用托管路由器,暂时不要求跨分片写入原子性:**预览阶段的 PlanetScale Neki。先读它的限制。
- **比起完整兼容性,更看重多地域写入或自动重新分片:**分布式 SQL 数据库,同时明白它是另一种引擎。
无论考虑哪一种,都拿最重要的十条查询去运行,并阅读执行计划。
本章要点
- 最后再分片。除按功能拆分以外,这是唯一能让写入量和存储容量超越单机的一级阶梯,也会让每个跨分片查询、事务、约束和模式变更都更难。
- 真正的信号是:写入让最大的主库饱和,数据多到无法在 RTO 内恢复,或存在数据驻留要求。不是读取负载,也不是“将来某一天”。
- 多租户 SaaS 按租户 ID 分片,从今天就开始准备:每张租户表、每个键、每条查询都带上
account_id。 - 按分片键做共置连接,就能留在本地:把
account_id写入on子句时约 10 ms,没有时约 950 ms。 - 邮箱之类需要全局唯一的值,都需要独立的未分片表。
- 为迁移热点租户做好准备:目录,加上带行过滤的逻辑复制。
- 按路由、合并和两阶段提交应放在哪里来选择方案,并检查负载最高的查询的计划中是否存在扇出。
延伸阅读
- postgres_fdw,PostgreSQL 文档。外部表、下推、
async_capable,以及不支持两阶段提交的说明。 - Citus,源码仓库。本章所用的扩展、许可证,以及按行和按模式分片。
- Aurora PostgreSQL Limitless Database architecture,AWS 文档。路由器、分片和表类型;同时阅读旁边的要求页面。
- PgDog,源码仓库。从分片代理的角度介绍路由、合并、两阶段提交与重新分片。
- Neki query planning,PlanetScale 文档。路由器如何选择一个分片或所有分片,以及跨分片操作不提供哪些保证。
- CockroachDB PostgreSQL compatibility,CockroachDB 文档。具体差异清单。