# 为删除而分区
> 为大规模时序表的保留期限和维护需求分区,从真实计划中读懂分区剪枝,避开陷阱,并在不停机的情况下改造现有表。
---
LLMS 索引: [llms.txt](/llms.txt)
---
我们从本书的 `events` 表中,用普通的 `delete ... where created_at ...` 删除了一个月的事件,共 164,383 行。它产生了 32 MB WAL,留下 164,383 个[死元组](/43-glossary/#dead-tuple)(dead tuple),随后回收它们的清理又产生了 12 MB WAL。接着,我们在这张表的分区副本中,分离并删除一个分区,移除了同一个月的数据。这次产生的 WAL 不到 150 KB。
**图 39-1.** 逐行删除一个月是做一番工作;删除一个月分区是移除文件。逐行删除留下了 164\,383 个死元组,产生 32 MB WAL,后续清理又产生了 12 MB。分离并删除该月分区会移除它的文件,产生的 WAL 不到 150 KB。
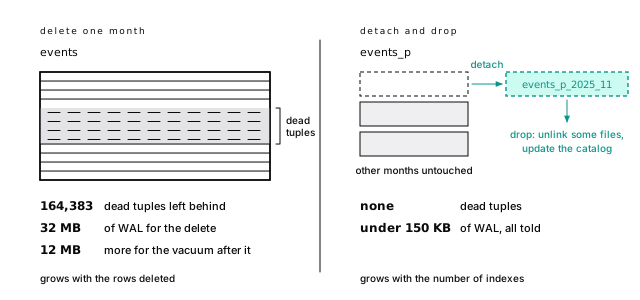
到了二十亿行,这个 `delete` 就变成了每晚运行数小时、淹没副本的任务。删除分区的工作量却不变:移除一些文件,更新系统目录。
这才是实在的理由。分区首先是一项数据生命周期功能。它不是通用的加速手段,对于不带分区键的查询,反而会更慢。
## 所有收益都来自拆成独立的表 {#every-benefit-comes-from-separate-tables}
分区表是一张不存放行的父表。每一行都恰好落在一个子表里,这个子表就是**分区**(partition),由**分区键**(partition key)的值决定。每个分区都是普通表,有自己的堆、索引、可见性映射和自动清理调度。拆开之后,有四项收益:
- **过期数据直接删表。**移除旧数据就是删除一张表:没有死元组,几乎没有 WAL,也没什么需要清理。
- **分块维护。**自动清理处理的是 30 GB 分区,而不是 3 TB 大表。旧分区冻结一次,后续清理便会跳过它们的页面。你可以一次只重建一个分区的索引,或重整一个分区。
- **热点索引保持小巧。**即使完整历史的索引放不进内存,当月的索引仍然能放下。
- **分区剪枝。**按分区键筛选的查询,只访问可能匹配的分区。
## 分区不会让查找更快 {#partitioning-doesnt-make-lookups-faster}
不论一百万行还是十亿行,沿 B-树向下查找都只需三四页([B-树是一棵由页组成的浅树](/17-btree/#a-b-tree-is-a-shallow-tree-of-pages)),所以拆表不会让索引设计良好的查找更快。查询不指定分区键时,拆表反而会成倍增加查找次数:按 `id` 查找,在 `events` 上读取 7 页,在按月分区的副本 `events_p` 上则要读 39 页,因为每个分区的索引都得查。14 个分区时开销不大,1,000 个就不同了([每个无法剪枝的分区都要花规划时间](#every-partition-a-query-cant-prune-costs-planning-time))。
要加快时间范围查询,还有更便宜的工具:在 `created_at` 上建一个 24 KB 的 BRIN 索引([BRIN 为每个页范围保留一份汇总](/18-more-indexes/#brin-keeps-one-summary-per-range-of-pages)),统计三月事件时只读了 3,251 页;分区表剪枝到三月后则是 2,988 页。
所以,应该为了分区独有的收益而分区:低成本处理过期数据、逐分区维护,或解决清理和建索引已超出维护窗口的问题。不到几十 GB 的表,除非有保留期限要求,否则别动;还要等 `pg_stat_statements` 证实排名靠前的查询都带着分区键。
> [!DETAILS]- 深入阅读:按 id 查找,一张表对比十四张表
>
> ```text
> Index Scan using events_pkey on events (actual rows=1.00 loops=1)
> Index Cond: (id = 1234567)
> Buffers: shared hit=3 read=4
> Planning:
> Buffers: shared hit=22 read=1
> ```
>
> ```text
> Append (actual rows=1.00 loops=1)
> Buffers: shared hit=31 read=8
> -> Index Scan using events_p_2025_10_pkey on ... (actual rows=0.00 ...)
> Index Cond: (id = 1234567)
> Buffers: shared hit=3
> ... (one scan per partition, 14 in all)
> Planning:
> Buffers: shared hit=202 read=4 dirtied=4
> ```
>
> 规划时间从 0.055 ms 增加到 0.284 ms(在新会话中测量;你的数字会略有不同),因为规划器必须考虑每个分区。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('a lookup by id alone: one index scan per partition on events_p',
> > (select count(distinct r) from unnest(rels('select * from events_p where id = 1234567')) r) = :nparts);
> >
> > select lab.prove('a lookup by id: about 7 pages on events, several times that on events_p',
> > lab.buffers('select * from events where id = 1234567') <= 10
> > and lab.buffers('select * from events_p where id = 1234567') > 3 * lab.buffers('select * from events where id = 1234567'));
> >
> > select lab.prove('with BRIN, the unpartitioned month read is within 15% of the pruned partition read',
> > lab.buffers(:'q_mid') < 1.15 * lab.buffers(:'q_mid_p'));
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 范围分区适合时间,列表和哈希各有专用场景 {#range-fits-time-list-and-hash-have-narrow-jobs}
声明式分区(declarative partitioning,`partition by`,PostgreSQL 10+,此后每个版本都有改进)有三种策略:
| 策略 | 键 | 适合场景 |
|---|---|---|
| 范围 | 连续值,通常是时间 | 事件、日志、指标,以及有保留期限要求的数据 |
| 列表 | 离散值 | 地域、少数非常大的租户 |
| 哈希 | 对键求哈希,再对 N 取模 | 把一张热点巨表拆成大小均衡的几块 |
**Table 39-1.** 范围分区适合时间,列表和哈希各有专用场景
本章的 `events_p` 按月做范围分区:十四个分区,每个约 3,000 页;而 `events` 有 35,173 页。它的主键是 `(id, created_at)`,这是必需的([原因见这里](#unique-constraints-must-include-the-key))。
列表分区适合少量、稳定的值,比如把欧盟数据放在独立存储上。哈希分区没有生命周期方面的收益;它只是把一张热点巨表拆成中等大小的表,方便维护。
> [!DETAILS]- 深入阅读:构建 events_p,以及列表与哈希分区的样子
>
> ```sql
> create table events_p (
> id bigint generated always as identity,
> account_id bigint not null,
> project_id bigint not null,
> user_id bigint,
> kind text not null,
> payload jsonb not null default '{}',
> created_at timestamptz not null default now(),
> primary key (id, created_at)
> ) partition by range (created_at);
> ```
>
> 范围边界包含下界、不包含上界,与查询中应该使用的半开区间相同。生成分区;在 psql 中,`\gexec` 会把结果的每一行当作语句执行:
>
> ```sql
> select format(
> 'create table events_p_%s partition of events_p '
> 'for values from (%L) to (%L)',
> to_char(m, 'YYYY_MM'), m, m + interval '1 month')
> from generate_series(date_trunc('month', timestamptz '2025-10-06'),
> date_trunc('month', timestamptz '2026-11-01'),
> interval '1 month') as m
> \gexec
> ```
>
> 然后用 `insert ... overriding system value select ... from events` 复制数据,用 `setval` 把标识列(identity column)的序列推进到已复制的 id 之后,再执行 `vacuum analyze`。按 `tableoid::regclass`(指出行实际存放在哪张表中的系统列)统计行数,可以确认路由结果:
>
> ```text
> partition | count | pages
> ------------------+--------+-------
> events_p_2025_10 | 141830 | 2495
> events_p_2025_11 | 164383 | 2891
> ...
> events_p_2026_10 | 28034 | 493
> (13 rows)
> ```
>
> 第十四个分区,即 2026 年 11 月分区,已经提前建好,目前为空,等待数据到来。
>
> 如果行的键不匹配任何分区,列表分区会拒绝它(`no partition of relation "audit_log" found for row`)。哈希分区表 `sessions_h` 使用 `modulus 4`,把 400,000 行分到四个桶中,分别为 100,504、99,912、99,884 和 99,700 行;`where user_id = 42` 恰好只扫描一个桶。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('every row lands in exactly one partition, and the copy keeps all 2,000,000',
> > (select count(*) from events_p) = 2000000
> > and (select count(*) from only events_p) = 0);
> >
> > select lab.prove('a full month is about 3,000 pages; the unpartitioned events is about 35,000',
> > (select max(pg_relation_size(inhrelid)) / 8192 from pg_inherits
> > where inhparent = 'events_p'::regclass) between 2800 and 3100
> > and pg_relation_size('events') / 8192 between 34000 and 36500);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 按删除数据的条件选择分区键 {#choose-the-key-you-delete-by}
分区键应该是你淘汰数据的依据,最好也是大多数查询的筛选条件。对于事件、日志和指标,两者都是同一列,即时间戳,因此它们很适合分区。
两者不同时,保留期限通常优先。SaaS 应用按 `account_id` 筛选,但按账户分区,又会让过期数据处理变回逐行删除。应该按时间分区,各分区的索引以 `account_id` 开头;把租户分散到多台机器,是[分片](/40-sharding/#basics-chapter-40)的工作。
让保留期限决定粒度,目标是每个分区几 GB,总数几十到小几百个。按月保留十年,是 120 个分区;按天则是 3,650 个,你会感受到差别。
## 分区边界是免费的粗粒度索引 {#the-bounds-are-a-free-coarse-index}
**分区剪枝**(partition pruning)就是跳过不可能包含匹配行的分区。不在 `created_at` 上建索引,统计三月事件,在 `events_p` 上读取 2,988 页,在 `events` 上则是 35,173 页:计划里甚至只出现了三月分区。
如果规划时还不知道值(`now()`、[通用计划](/43-glossary/#generic-plan)(generic plan)的参数),Postgres 会在执行开始时剪枝,计划显示 `Subplans Removed: 11`。两种情况都需要直接使用分区键:`date_trunc('day', created_at) = ...` 会扫描全部十四个分区,半开区间范围只扫描一个([保持索引列裸露](/22-queries/#keep-the-indexed-column-bare))。
没有分区键,即使廉价查询也要在规划阶段付出代价:“账户 42 最近的 20 个事件”,按从新到旧的顺序读取分区,读到 23 页就停止了,与普通表相仿;但规划访问了 455 页,普通表只有 54 页。
> [!EXAMPLE]- 动手验证 · lab `38-partitioning`
>
> ```sql
> select lab.prove('one month on events_p: only that partition appears in the plan',
> (select count(distinct r) from unnest(rels(:'q_mid_p')) r) = 1);
>
> select lab.prove('one month reads about 3,000 pages on events_p and all ~35,000 on events',
> lab.buffers(:'q_mid_p') < 3100 and lab.buffers(:'q_mid') > 34000);
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
> [!DETAILS]- 深入阅读:计划中的剪枝,规划时、运行时与提前停止
>
> ```text
> Finalize Aggregate (actual rows=1.00 loops=1)
> Buffers: shared hit=149 read=2839
> ...
> -> Parallel Seq Scan on events_p_2026_03 events_p
> (actual rows=84931.50 loops=2)
> ```
>
> 其余十三个分区根本没出现。使用 `where created_at >= now() - interval '7 days'` 时(PostgreSQL 11+ 支持运行时剪枝):
>
> ```text
> Aggregate (actual rows=1.00 loops=1)
> Buffers: shared hit=12 read=737
> -> Append (actual rows=38235.00 loops=1)
> Subplans Removed: 11
> -> Index Only Scan using events_p_2026_09_pkey on events_p_2026_09 ...
> -> Index Only Scan using events_p_2026_10_pkey on events_p_2026_10 ...
> -> Seq Scan on events_p_2026_11 events_p_3 (actual rows=0.00 loops=1)
> ```
>
> 预备语句的通用计划使用 `where created_at >= $1` 时,也显示 `Subplans Removed: 11`。标为 `(never executed)` 的分区也可能是运行时剪枝的结果,也可能像下面的计划一样,是 `Limit` 在到达它之前就停了。
>
> 从最新数据开始,提前停止(PostgreSQL 12+ 会按顺序追加范围分区,而不是归并它们):
>
> ```text
> Limit (actual rows=20.00 loops=1)
> Buffers: shared hit=21 read=2
> -> Append (actual rows=20.00 loops=1)
> -> Index Scan Backward using events_p_2026_11_account_id_created_at_idx
> Buffers: shared hit=2
> -> Index Scan Backward using events_p_2026_10_account_id_created_at_idx
> Buffers: shared hit=19 read=2
> -> Index Scan Backward using events_p_2026_09_account_id_created_at_idx
> Index Searches: 0
> ... (the other 11 also never executed)
> Planning:
> Buffers: shared hit=431 read=24
> Planning Time: 1.251 ms
> ```
>
> 规划耗时约为普通表的十倍(新会话中,1.25 ms 对比 0.1 ms)。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('a filter on now() prunes when execution starts: Subplans Removed > 0',
> > (lab.plan($$ select count(*) from events_p where created_at >= now() - interval '7 days' $$)
> > @? '$.** ? (@."Subplans Removed" > 0)'));
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 按分区执行的计划适合报表 {#partition-wise-plans-are-for-reports}
剪枝一次只处理一张表。`enable_partitionwise_join` 会对分区方式相同的两张表逐分区连接,`enable_partitionwise_aggregate` 则逐分区聚合。两者默认都关闭,因为每个分区上的哈希或排序都有自己的一份 [`work_mem`](/43-glossary/#work_mem):涉及 100 个分区的计划,可能用掉预算的 100 倍。
把 `events_p` 与按相同月份分区的 `deliveries_p` 连接,生成季度报表时,逐分区连接把 46.9 ms 降到了 17.6 ms。但更简单的办法,是在两侧都写明范围,让各自独立剪枝。这些设置应只在报表会话中使用,绝不要用于 OLTP。
> [!DETAILS]- 深入阅读:连接前后的对比,以及聚合如何拆分
>
> ```text
> GroupAggregate (actual rows=9398.00 loops=1)
> Buffers: shared hit=11878 read=181 written=83
> ...
> -> Parallel Hash Join (actual rows=4243.00 loops=3)
> -> Parallel Append (actual rows=168036.33 loops=3)
> -> Parallel Seq Scan on events_p_2026_07 e_1 ...
> ...
> -> Parallel Hash (actual rows=16741.00 loops=3)
> -> Parallel Append (actual rows=16741.00 loops=3)
> ... (all 14 deliveries partitions)
> Execution Time: 46.935 ms
> ```
>
> 设置 `set enable_partitionwise_join = on` 后:
>
> ```text
> GroupAggregate (actual rows=9398.00 loops=1)
> Buffers: shared hit=51723 read=2
> ...
> -> Parallel Append (actual rows=4243.00 loops=3)
> -> Nested Loop (actual rows=1452.33 loops=3)
> -> Parallel Seq Scan on deliveries_p_2026_08 d_2 ...
> -> Index Scan using events_p_2026_08_pkey ...
> (actual rows=1.00 loops=4357)
> -> Nested Loop ... (July)
> -> Nested Loop ... (September)
> Execution Time: 17.637 ms
> ```
>
> 缓冲区命中更多了(51,723 对比 12,059),来自数千次命中缓存的索引探测,但不用再把十一个无用分区纳入哈希表构建。使用 `enable_partitionwise_aggregate` 时,按分区键分组,会在各分区内完成全部聚合;按其他内容分组,则先在各分区内部分聚合,再合并;按 `date_trunc('month', created_at)` 分组,这两种都不会发生。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('default: the events side prunes to 3 months, the deliveries side scans every partition',
> > (select count(distinct r) filter (where r like 'events_p%') from unnest(rels(:'q_join')) r) = 3
> > and (select count(distinct r) filter (where r like 'deliveries_p%') from unnest(rels(:'q_join')) r) = :nparts);
> >
> > set enable_partitionwise_join = on;
> >
> > select lab.prove('partition-wise: only the 3 matching deliveries partitions are read',
> > (select count(distinct r) filter (where r like 'deliveries_p%') from unnest(rels(:'q_join')) r) = 3);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 约束必须带上分区键 {#constraints-must-carry-the-partition-key}
### 唯一约束必须包含分区键 {#unique-constraints-must-include-the-key}
下面就是 `events_p` 的主键必须为 `(id, created_at)` 的原因:
```text
ERROR: unique constraint on partitioned table must include all partitioning columns
DETAIL: UNIQUE constraint on table "events_p" lacks column "created_at"
which is part of the partition key.
```
Postgres 没有全局索引。分区表上的索引,其实是每个分区各有一个索引,因此唯一性只在单个分区内检查。如果唯一键包含分区键,相同的键就会落在一起;否则,重复值可以藏在不同月份里,不被发现。(同一个 `id` 分别插入五月和九月,没有报错。)`on conflict` 的目标也遵循同样的规则。
### 引用分区表也必须带上分区键 {#references-into-a-partitioned-table-must-carry-the-key}
`events_p` 上的每个唯一键都包含 `created_at`,所以 `references events_p (id)` 会失败,引用它的表也必须带上分区键,就像 `deliveries_p` 的 `(event_id, event_created_at)`。事件表适合分区,部分原因就是很少有表引用它们。
> [!DANGER] 分区之前,先决定要放弃哪些保证
>
> 开始前,列出所有涉及这张表的唯一约束和外键,决定如何替代每一项:带上分区键、另留一张小型非分区表保存唯一值,或不做分区。
索引也有自己的陷阱:分区父表不支持 `create index concurrently`。先以 `on only` 在父表上建索引,再并发构建各分区的索引并逐个挂接;最后一个挂接完成后,父表索引才变为有效。
> [!DETAILS]- 深入阅读:约束错误,以及逐分区构建索引
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('a unique index on id alone is rejected: it lacks the partition key',
> > lab.try('create unique index on events_p (id)')
> > = '0A000: unique constraint on partitioned table must include all partitioning columns');
> >
> > select lab.prove('a foreign key to events_p (id) alone is rejected (42830)',
> > lab.try($$ create table event_comments (
> > id bigint generated always as identity primary key,
> > event_id bigint not null references events_p (id),
> > body text not null) $$)
> > = '42830: there is no unique constraint matching given keys for referenced table "events_p"');
> >
> > select lab.prove('the same id can exist twice, in different partitions',
> > (select count(*) = 2 and count(distinct tableoid) = 2 from events_p where id = 1234567));
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
>
> 出现重复值,需要显式提供 id(如导入、`overriding system value`);标识列自行分配的值是唯一的。
>
> 为每个分区生成索引构建语句:
>
> ```sql
> create index events_p_kind_idx on only events_p (kind); -- indisvalid = f
>
> select format('create index concurrently %I on %s (kind)',
> c.relname || '_kind_idx', c.oid::regclass),
> format('alter index events_p_kind_idx attach partition %I',
> c.relname || '_kind_idx')
> from pg_inherits i join pg_class c on c.oid = i.inhrelid
> where i.inhparent = 'events_p'::regclass
> order by c.relname
> \gexec
> ```
>
> `create index concurrently` 不能在事务块内运行,所以要逐条执行(psql 的 `\gexec` 在 `begin` 外就是这样做的)。如果一次构建失败,会在该分区留下无效索引;删除后重建([并发构建失败时](/26-migrations/#basics-26-when-a-concurrent-build-fails))。
## 避免默认分区 {#avoid-the-default-partition}
默认分区会接住不匹配其他分区的行,看起来像安全网,实际更像陷阱:创建新分区时必须持锁扫描它;如果里面有属于新范围的行,创建就会失败;它还会阻止 `detach ... concurrently`,而有外键指向这张表时,也不能直接删除它。
应该确保未来的分区始终提前建好,并把“no partition found”错误当作它应该触发的告警。
> [!DETAILS]- 深入阅读:默认分区招来的三种错误
>
> ```text
> ERROR: updated partition constraint for default partition "events_p_default"
> would be violated by some row
> ```
>
> ```text
> ERROR: cannot detach partitions concurrently when a default partition exists
> ```
>
> ```text
> ERROR: cannot drop table events_p_default because other objects depend on it
> DETAIL: constraint deliveries_p_event_id_event_created_at_fkey on table
> deliveries_p depends on table events_p_default
> ```
>
> (我们先清空默认分区,再执行 `detach partition events_p_default`,随后 `drop table` 就成功了。)
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('with a stray row in the default, creating its month fails (23514)',
> > lab.try(format('create table events_p_future partition of events_p for values from (%L) to (%L)',
> > :'last_month'::timestamptz + interval '2 months',
> > :'last_month'::timestamptz + interval '3 months'))
> > like '23514: updated partition constraint for default partition "events_p_default" would be violated%');
> >
> > select lab.prove('a default partition blocks DETACH ... CONCURRENTLY',
> > lab.try(format('select dblink_exec(%L, %L)', 'dbname=' || current_database(),
> > format('alter table events_p detach partition %I concurrently',
> > 'events_p_' || to_char(:'first_month'::timestamptz, 'YYYY_MM'))))
> > = '55000: cannot detach partitions concurrently when a default partition exists');
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 处理过期数据:先分离,再删除 {#retention-detach-then-drop}
收益就在这里。用两种方式删除 2025 年 11 月的数据(164,383 行):
| | `delete` + 清理 | 分离 + 删除分区 |
|---|---|---|
| 写入的 WAL | 32.5 MB + 12.5 MB | 约 140 KB |
| WAL 记录 | 175,000+ | 226 |
| 待清理的死元组 | 164,383 | 无 |
| 索引清理 | 每个索引、每一行 | 无 |
| 开销随什么增长 | 删除的行数 | 索引数量 |
**Table 39-2.** 处理过期数据:先分离,再删除
数据量小且已缓存时,`delete` 不到 100 ms 就完成了。它的代价随行数增长,每个副本要重放的 WAL 也一样;删除分区则不会。在这里,两者都远不到一秒;到了十亿行,只有一种还能如此。
```sql
alter table events_p detach partition events_p_2025_11 concurrently;
drop table events_p_2025_11;
```
> [!DETAILS]- 深入阅读:表中数字从何而来
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.wal_bytes(format($$ delete from events where created_at >= %L and created_at < %L $$,
> > :'old_month'::timestamptz, :'old_month'::timestamptz + interval '1 month')) as delete_wal \gset
> > vacuum events;
> >
> > alter table deliveries_p detach partition :old_deliveries concurrently;
> > drop table :old_deliveries;
> > alter table events_p detach partition :old_events concurrently;
> > drop table :old_events;
> >
> > -- vacuum_wal and drop_wal come from pg_stat_statements
> > select lab.prove('deleting a month writes about 32 MB of WAL',
> > :delete_wal between 25e6 and 40e6);
> > select lab.prove('detach + drop writes over 100 times less WAL than delete + vacuum',
> > :drop_wal > 0 and (:delete_wal + :vacuum_wal) > 100 * :drop_wal);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
>
> `delete` 的 `explain (analyze, wal)` 结果:
>
> ```text
> Delete on events (actual rows=0.00 loops=1)
> Buffers: shared hit=169243 read=5223 dirtied=2893
> WAL: records=164383 fpi=2893 bytes=32465375 buffers full=3503
> Execution Time: 85.682 ms
> ```
>
> 它留下的清理工作:
>
> ```text
> tuples: 164383 removed, 1835626 remain, 0 are dead but not yet removable
> WAL usage: 11670 records, 2098 full page images, 12504570 bytes, 181 buffers full
> ```
>
> 分离和删除,在 `pg_stat_statements` 中分别是:135 条记录、103,569 字节,然后是 91 条记录、36,971 字节。多数数据来自整页镜像,因此总量随检查点时机变化:我们多次运行的结果在 80 至 150 KB 之间。
### 要并发分离,否则所有操作都排在后面 {#detach-concurrently-or-everything-queues-behind-you}
普通 `detach` 会在父表上取得 `ACCESS EXCLUSIVE` 锁,让所有操作排在它后面([锁队列](/25-concurrency/#a-waiting-lock-blocks-everyone-behind-it))。`detach partition ... concurrently`(PostgreSQL 14+)不会阻塞查询。它不能在事务块内运行;如果被中断,分区会保持“detach pending”状态,直到执行 `detach partition ... finalize`。
### 外键决定操作顺序 {#foreign-keys-set-the-order}
`deliveries_p` 引用 `events_p` 时,先分离事件分区会违反外键而失败。必须先移除引用它的分区。
> [!TIP] 一个不会把你叫醒的过期数据处理任务
>
> 每天按顺序做:创建缺失的未来分区,完成待定的分离,并发分离过期分区(先处理引用方),需要时归档,然后删除,再对父表执行 `analyze`。设置 `lock_timeout`,让它放弃而不是排队,留待下一轮重试。
> [!DETAILS]- 深入阅读:决定顺序的那个外键
>
> ```text
> ERROR: removing partition "events_p_2025_12" violates foreign key constraint
> "deliveries_p_event_id_event_created_at_fkey_3"
> DETAIL: Key (event_id, event_created_at)=(306216, 2025-12-01 00:00:38.330131+00)
> is still referenced from table "deliveries_p".
> ```
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > select lab.prove('foreign keys set the order: the events partition can''t go before its deliveries (23503)',
> > lab.try(format('alter table events_p detach partition %I', :'old_events')) like '23503: removing partition%violates foreign key constraint%');
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 在需要之前创建分区 {#create-partitions-before-you-need-them}
过期数据处理在一端移除分区,总得有任务在另一端添加。缺少分区时不会平稳降级:那个范围里的每次插入都会失败。用定时任务提前建好几个未来分区;如果最远的未来分区距离现在还不到几周,就发告警。这个任务的大部分工作,前面的 `\gexec` 生成器已经完成。如果不想自己维护,大多数团队用的扩展是 `pg_partman`([pg_cron 和 pg_partman 帮你把时间掌握在自己手里](/16-extensions/#pg_cron-and-pg_partman-keep-time-on-your-side));务必阅读所用版本的默认值,因为它们很重要。
> [!DETAILS]- 深入阅读:pg_partman 做什么,以及它创建的默认分区
>
> - 版本 5 只管理原生声明式分区;旧的触发器方式已经移除。
> - `create_parent()` 用控制列和间隔注册一张已有分区表,并提前创建分区(`p_premake` 默认为 4)。
> - `run_maintenance()`(或 `run_maintenance_proc()`,后者每处理完一组分区就提交)创建新分区并执行过期数据处理。通过它的后台工作进程或 `pg_cron` 这样的调度器运行。
> - 保留策略放在 `part_config` 表中:`retention` 设置保留时长,`retention_keep_table`(默认 true)会分离并保留旧分区,而不是删除它们。
> - `create_parent()` 会创建默认分区,除非传入 `p_default_table := false`。考虑到前面的问题,可以关闭它,至少也要监控里面是否出现行。
## 不停机地改造现有表 {#convert-a-live-table-without-downtime}
不能直接执行 `alter table ... partition by`。可以把整张现有表变成第一个分区,覆盖全部历史数据,再让新分区承接未来。诀窍是用一个 `check` 约束,证明每行都在范围内,这样 `attach partition` 就会跳过验证扫描:
1. **在线操作:**并发构建 `(id, created_at)` 上的唯一索引,添加 `check (created_at < '2026-11-01')` 并标为 `not valid`,再用 `validate` 验证,不阻塞写入([两步法](/26-migrations/#add-a-check-not-valid-then-validate-it))。
2. **一个短事务,设置 `lock_timeout`:**重命名旧表,用那个索引作为主键,把标识列定义移到新的分区父表,将旧表按边界挂接进来,创建后续分区,再用 `setval` 把父表序列推进到旧 id 之后。分区不能保留自己的标识列定义,因此跳过这一步,挂接就会失败。
在一个 180 万行的副本上,事务耗时约 20 ms。没有这个约束,挂接就要持锁扫描每一行:到了 TB 级,要几分钟甚至几小时。(批量填充新分区,参见[冻结分区,挂接已构建的分区,再分析父表](/27-loading/#freeze-the-partition-attach-it-built-analyze-the-parent)。)
> [!DETAILS]- 深入阅读:逐条语句看改造过程
>
> ```sql
> create unique index concurrently events_copy_id_created_at_key
> on events_copy (id, created_at);
>
> alter table events_copy add constraint events_copy_old_range
> check (created_at < '2026-11-01') not valid;
> alter table events_copy validate constraint events_copy_old_range;
> ```
>
> 我们第一次尝试挂接时失败了两次,先是 `The new partition may not contain an identity column.`,再是 `multiple primary keys for table "events_copy_old" are not allowed`。必须移除旧的 `(id)` 主键,把步骤 1 的索引变成新主键(`attach` 会直接采用它,避免持锁建索引),并把标识列定义移到父表:
>
> ```sql
> begin;
> set local lock_timeout = '2s';
>
> alter table events_copy rename to events_copy_old;
> alter table events_copy_old drop constraint events_copy_pkey;
> alter table events_copy_old
> add constraint events_copy_old_pkey
> primary key using index events_copy_id_created_at_key;
> alter table events_copy_old alter column id drop identity;
>
> create table events_copy (
> id bigint generated always as identity,
> account_id bigint not null,
> project_id bigint not null,
> user_id bigint,
> kind text not null,
> payload jsonb not null default '{}',
> created_at timestamptz not null default now(),
> primary key (id, created_at)
> ) partition by range (created_at);
>
> alter table events_copy attach partition events_copy_old
> for values from (minvalue) to ('2026-11-01');
>
> create table events_copy_2026_11 partition of events_copy
> for values from ('2026-11-01') to ('2026-12-01');
> create table events_copy_2026_12 partition of events_copy
> for values from ('2026-12-01') to ('2027-01-01');
>
> select setval(pg_get_serial_sequence('events_copy', 'id'),
> (select max(id) from events_copy_old));
> commit;
> ```
>
> 设置 `client_min_messages = debug1` 后,挂接显示 `partition constraint for table "events_copy_old" is implied by existing constraints`,耗时 0.468 ms。之后插入两行,一行是当前时间,一行是 2026-11-15,分别得到 id 2000001 和 2000002,落在 `events_copy_old` 与 `events_copy_2026_11` 中。
>
> 旧分区包含全部历史数据,在整个范围过期之前,仍要靠 `delete` 处理其中的过期数据(或者在后台把各个月份拆出去)。实际动手前,检查引用旧表的外键、触发器和授权(它们不会自行迁移),以及显式指定序列名的代码。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > -- scan_nocheck / scan_check: seq scans of the old table counted (in
> > -- pg_stat_xact_user_tables) across the attach, without and with the constraint
> > select lab.prove('without the check constraint, attach scans the whole table',
> > :scan_nocheck = 1);
> > select lab.prove('with a validated check constraint, attach skips the scan',
> > :scan_check = 0);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
## 查询无法剪枝时,分区代价最大 {#partitioning-costs-most-when-queries-cant-prune}
### 每个无法剪枝的分区都要花规划时间 {#every-partition-a-query-cant-prune-costs-planning-time}
能剪枝的查询,几乎感觉不到分区数量。不能剪枝的查询,则要为每个分区付出规划时间、内存和锁的代价。我们在 12 到 3,000 个按日分区上,分别规划一条带分区键的查询和一条不带的查询(`where account_id = 42`):
| 分区数 | 带键,预热后 | 不带键,预热后 | 不带键,新会话 | 规划器内存,不带键 |
|---|---|---|---|---|
| 12 | 0.02 ms | 0.05 ms | 0.9 ms | 124 KB |
| 365 | 0.13 ms | 4.2 ms | 19 ms | 3.1 MB |
| 1,000 | 0.13 ms | 15.0 ms | 55 ms | 8.4 MB |
| 3,000 | 0.14 ms | 52.0 ms | 170 ms | 27 MB |
**Table 39-3.** 每个无法剪枝的分区都要花规划时间
带分区键时,数量几乎无关紧要;不带时,规划要 52 ms,每个新连接的第一次查询则约为这个数的三倍。无法剪枝的查询还要锁住每个分区及索引,锁会溢出到共享锁表,最终可能耗尽它,报出“out of shared memory”。把数量控制在几十到小几百个,并让热点查询能剪枝。
> [!DETAILS]- 深入阅读:如何测量规划,以及它取得的锁
>
> 预热后的数字是同一会话中运行 15 次的中位数;新会话的数字是五次首次规划的中位数,每次都用新会话。每张表都有主键和 `account_id` 上的索引。规划器内存来自 PostgreSQL 17+ 的 `explain (memory)`。实验重新执行了表中的前三行。
>
> 在事务中执行 `select count(*) from pt_N where account_id = 42` 所持有的锁:
>
> | 分区数 | 快速路径锁 | 共享锁表中的锁 |
> |---|---|---|
> | 12 | 40 | 0 |
> | 365 | 64 | 1,035 |
> | 1,000 | 64 | 2,940 |
> | 3,000 | 64 | 8,940 |
>
>
>
> **Table 39-4.** 每个无法剪枝的分区都要花规划时间
>
> 每个后端进程都有少量快速路径锁槽,避免使用共享内存。在 PostgreSQL 18 中,槽数随 `max_locks_per_transaction` 增长(这里为 64);早期版本固定为 16。其余锁进入共享锁表(并发时会出现 `LWLock LockManager` 等待),容量约为 `max_locks_per_transaction` 乘以连接数。
>
> > [!EXAMPLE]- 动手验证 · lab `38-partitioning`
> >
> > ```sql
> > -- planning: median planning time of 15 runs per table, with and without the key
> > select lab.prove('without the key, planning grows with the partition count (1,000 is over 20 times 12)',
> > (select without_key from planning where n = 1000) > 20 * (select without_key from planning where n = 12)
> > and (select without_key from planning where n = 365) > 5 * (select without_key from planning where n = 12));
> >
> > select lab.prove('with the key, pruning keeps 1,000 partitions planning over 20 times faster than without it',
> > (select with_key * 20 < without_key from planning where n = 1000));
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/38-partitioning.sql)
### 分区表还有四个小陷阱 {#four-smaller-traps-catch-partitioned-tables}
- **只按 id 查找**会搜索每个分区。把时间放进 URL,或使用编码了时间的 id([UUIDv7](/13-keys/#uuidv7-is-the-default-and-it-reveals-creation-time) 就是如此)。
- **自动清理永远不会分析父表**。在过期数据处理任务中分析它。
- **更新分区键会移动行**:一次删除加一次插入,绝不会是 [HOT](/07-hot/#basics-chapter-7)。选择不会变化的键。
- **表太小也做分区。**把 5 GB 的表拆成 365 个日分区,开销全有,收益全无。
## 本章要点 {#the-short-version}
- 为数据生命周期而分区。删除一个月产生了 45 MB WAL 和 164,383 个死元组;删除对应分区,不到 150 KB。
- 分区不是 OLTP 加速器:不带分区键的查询会搜索全部分区,BRIN 则能取得时间范围查询的大部分收益。
- 按删除数据的依据分区,通常是时间;数量控制在几十到小几百个。
- 用半开区间直接比较分区键,并在 `EXPLAIN` 中检查剪枝。
- 每个唯一键都必须包含分区键,引用也必须带上它。
- 用 `detach ... concurrently` 和 `drop` 移除过期分区,先处理引用方,并设置 `lock_timeout`。避免默认分区。
- 提前创建未来分区,快用完时告警。
- 改造现有表时,将它整体挂接为分区,先验证 `check` 约束,让挂接跳过扫描。
## 延伸阅读 {#further-reading}
- [Table partitioning](https://www.postgresql.org/docs/18/ddl-partitioning.html),PostgreSQL 文档。声明式分区的参考资料、限制,以及分区数量的最佳实践。
- [ALTER TABLE](https://www.postgresql.org/docs/18/sql-altertable.html),PostgreSQL 文档。`ATTACH` 与 `DETACH PARTITION` 的确切锁行为、让挂接跳过扫描的 `check` 约束,以及 `CONCURRENTLY` 的规则。
- [Query planning configuration](https://www.postgresql.org/docs/18/runtime-config-query.html),PostgreSQL 文档。`enable_partitionwise_join` 和 `enable_partitionwise_aggregate` 的作用,以及它们为什么消耗内存。
- [CREATE TABLE](https://www.postgresql.org/docs/18/sql-createtable.html),PostgreSQL 文档。`partition by` 和 `partition of` 语法,包括列表、哈希和默认分区。
- [pg_partman](https://github.com/pgpartman/pg_partman),GitHub。提前创建分区并执行过期数据处理的常用扩展;阅读你所用版本的默认设置文档。