32 未经验证的备份只是传闻
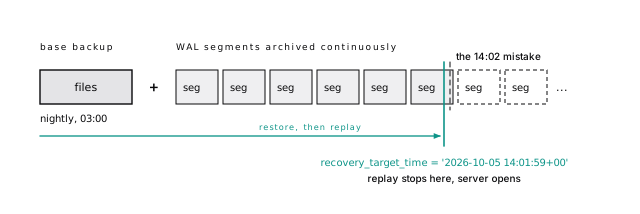
设想周一 14:02。有人把迁移脚本跑在了错误的数据库上,删掉了存放三年账单地址的列。夜间备份在 03:00 完成。如果你只有这份备份,为了找回一列数据,你将丢失这 11 小时内系统中的所有写入。持续归档 WAL,就能恢复到 14:01:59,除了这次错误之外什么都不会丢。
备份只做到大致正确,结果和错误一样。无法在足够短的时间内恢复到你需要的时刻,就不算备份。除非你试过,否则不知道手里的备份属于哪一种。
先写下 RPO 和 RTO
**RPO,恢复点目标:**按时间计算,你能承受丢失多少数据。每晚转储:最多 24 小时。持续归档:几秒或几分钟。同步复制:服务器故障时为零,但人为错误不是,因为人为错误会立即复制。
**RTO,恢复时间目标:**恢复期间你能停机多久。重新加载一个 2 TB 的逻辑转储并重建所有索引,可能要花大半天;物理副本受限于移动 2 TB 数据并重放 WAL 的速度。
| 方法 | 典型 RPO | 决定 RTO 的因素 |
|---|---|---|
每晚 pg_dump | 最多 24 小时 | 重新加载数据,重建所有索引 |
| 仅物理基础备份 | 距上次备份的时间 | 复制文件 |
| 基础备份 + WAL 归档(PITR) | 几秒到几分钟 | 复制文件 + 重放 WAL |
| 流式复制副本(故障切换) | 几秒(异步) | 提升为主库:几秒 |
副本不是备份。它能覆盖硬件故障,却覆盖不了 drop table、错误的迁移或应用缺陷,因为这些错误会在几毫秒内复制过去。两者都需要。
pg_dump 可移植、小巧,但恢复很慢
pg_dump 读取一个快照,也就是启动时所有已提交内容的冻结视图(更新就是插入),然后写出 SQL 定义和数据行;即使应用仍在写入,这个视图也保持一致。
它会在转储的每张表上持有最弱的表锁。读写不受影响,但迁移会等待转储,而每个查询又会排在迁移后面(等待中的锁会阻塞后面的所有人)。
我们的示例数据库(345 MB,200 万条事件)复制到 scratch 后,以自定义格式转储:
一个 345 MB 的数据库变成了 47 MB 的转储:它经过压缩,而且不包含索引数据,只有 create index 语句。这就是转储很小而恢复很慢的原因。恢复会重新插入每一行,并重建每个索引。
动手验证 · lab 31-backups.sh
使用自定义(-Fc)或目录(-Fd -j N)格式:两者都会压缩、支持并行恢复,也能从整份转储中只恢复一张表。小数据库以及需要阅读内容时,保留纯 SQL 格式。
任何逻辑恢复之后都要运行 analyze,否则最初的查询会根据猜测生成计划。PostgreSQL 18 的 pg_dump --statistics 可以把规划器统计信息和数据一起带走,但它默认关闭;只依靠它而没有数据,无法复现生产环境的计划(测试计划,而不只是测试速度)。
pg_dump 不包含角色;单独转储它们
pg_dump 只转储一个数据库。角色、成员关系和表空间属于整个集簇,所以它会把这些内容排除在外。单独转储它们:
没有这些内容,恢复到新服务器时,每条 alter ... owner to app_owner 都会报错。把全局对象和每份转储放在一起。在托管服务上,你没有超级用户权限读取密码哈希,因此要加上 --no-role-passwords,并在恢复后重新设置密码。
运行 pg_dump 时使用能看到每一行的角色。如果租户表强制实施行级安全策略,所有者也会受策略约束,pg_dump 会报错退出,而不是写出一张不完整的表;给备份任务一个超级用户或 BYPASSRLS 角色(除非强制执行,RLS 会跳过表所有者)。
深入阅读:哪种格式支持并行转储,以及凌晨 3 点你会用到的 pg_restore 选项
| 格式 | 选项 | 并行转储 | 并行恢复 | 选择性恢复 |
|---|---|---|---|---|
| 纯 SQL | -Fp | 否 | 否(psql) | 否 |
| 自定义 | -Fc | 否 | 是 | 是 |
| 目录 | -Fd | 是 | 是 | 是 |
| Tar | -Ft | 否 | 否 | 是 |
目录格式使用 -j 4 按表并行,连接数为 -j 指定的数值加 1,这些连接共享一个快照。按表并行的局限也在这里:我们的示例数据中,一张表 events 几乎包含全部行,所以 -j 4(45 MB 的目录)并不比 -Fc 快(在我们的机器上两者都耗时 3.5 到 4.5 秒)。当数据分散在许多表中时,并行转储才有收益。从 PostgreSQL 16 开始,-Z 还接受 lz4 和 zstd;在我们的示例数据上,zstd 目录转储和 gzip 一样都是 45 MB。
动手验证 · lab 31-backups.sh
自定义格式或目录格式的转储都带有目录表,pg_restore -l 会列出它:
createdb scratch_restore && pg_restore -j 4 -d scratch_restore scratch.dir 恢复了全部 2,000,000 条事件。实际恢复时会用到的选项如下:
-t table恢复一张表(数据和定义);-n schema恢复一个模式。-l把目录表写入文件;用;注释掉不需要的行,再用-L file把它传回去,就能只恢复你保留的内容。--section=pre-data、data、post-data把定义、行,以及索引和约束分开。- 对于角色名不同的环境(例如笔记本电脑),使用
--no-owner --no-privileges。 -1(--single-transaction)让恢复要么全部成功,要么全部回滚。它不能和-j组合使用。
动手验证 · lab 31-backups.sh
动手验证 · lab 31-backups.sh
关于统计信息:普通转储的目录表中有 0 条 STATISTICS DATA,加入 --statistics 后就会包含它们。
动手验证 · lab 31-backups.sh
角色确实不在转储中,而 pg_dumpall --globals-only 会包含它们。
动手验证 · lab 31-backups.sh
数据库超过几百 GB 时,逻辑恢复会花费数小时,因为它要重建每一个索引。保留 pg_dump,用于可移植性、单表恢复和迁移;灾难恢复则使用带 WAL 归档的物理备份。
数据量大时,只有物理备份恢复得快
物理备份会原样复制磁盘上的 8 KB 页面,包括索引和膨胀。恢复就是把文件复制回去并启动服务器:不重新插入数据行,也不重建索引。数据量大时,这是唯一恢复得快的方式。
直接用 cp -r 复制运行中服务器的数据,会得到每次写入前后页面混杂的撕裂副本。pg_basebackup 用 WAL 修复了这个问题;WAL 是在变更本身之前写下的每项变更的日志(先记日志,再写数据):重放从复制开始到结束这段时间内的 WAL,会像崩溃恢复一样修复每个撕裂页面。
然后对它运行 pg_verifybackup。它会根据备份清单检查每个文件(PostgreSQL 13+),在你需要它之前发现截断或损坏的副本。
限制也很明确:它是整个集簇,只能恢复到相同的大版本和平台上;要找回一张表,首先必须把全部内容恢复到某个地方。
深入阅读:每个 pg_basebackup 选项带来什么,以及 pg_verifybackup 能检查什么
一条典型命令:
-Ft -z写入压缩的 tar 文件,而不是目录树。-X stream将备份期间生成的 WAL 一并流式传输,备份因此自包含。--checkpoint=fast让起始检查点全速执行,而不是把工作分散到一段时间内完成,这样复制会立即开始。backup角色需要REPLICATION属性,并且需要一条replication规则写在pg_hba.conf中。
对于这样的 tar 格式备份,运行 pg_verifybackup -n /backups/base/2026-10-05:在 PostgreSQL 18 中,它会根据清单检查 tar 文件,但只有在普通文件格式(plain)的备份中才能解析 WAL。
动手验证 · lab 31-backups.sh
时间点恢复就是持续重放
单独的基础备份仍只是一个快照。但重放不必在 B 停止:保留备份之后的每个 WAL 段,就能把它向前推进到这个窗口内的任意时刻。这就是时间点恢复(point-in-time recovery,PITR),它把“丢失 11 个小时”变成“除了这次错误之外什么都不丢”。
归档失败会填满磁盘并让主库停止
PITR 依赖一份连续完整的归档,所以应从这里开始。16 MB 的 WAL 段填满后,服务器会把它交给你的 archive_command。打开归档需要重启:
那个 cp 只是示意:它不会把副本刷新到磁盘,所以崩溃可能留下一个归档认为已经存在、实际却不完整的段。在生产环境中,使用备份工具的归档命令(使用备份工具)。
在安静系统上,archive_timeout 为 RPO 设上限:需要一小时才能填满的段,意味着磁盘故障时会丢失一小时数据。
监控归档器。如果 archive_command 持续失败,Postgres 会把所有未归档的段留在 pg_wal 中,磁盘会填满,主库也会停止。pg_stat_archiver.last_failed_time 晚于 last_archived_time 时,或者最新归档段已经超过几分钟时,就应告警。
恢复会在目标处暂停,让你先检查
要撤销 14:02 的错误,请把错误发生前的最后一份基础备份复制到新服务器上的空数据目录中,然后告诉它归档在哪里、何时停止:
服务器会重放在目标时刻或之前提交的每一笔事务,并在第一笔晚于目标时刻提交的事务之前停止,不应用那笔事务。使用 'pause'(默认值;这里明确写出来,免得有人疑惑)时,服务器会开放只读访问并等待。检查该列是否恢复,然后执行 select pg_wal_replay_resume() 以开放读写访问,或者调整目标时刻后重试。凌晨 3 点时,你会希望它暂停。(它需要 hot_standby = on,这也默认开启;没有它时,暂停的效果与关闭服务器相同。)
动手验证 · lab 31-backups.sh
对于人为错误(误删数据、删掉一列),请在另一台服务器上恢复到某个时间点,然后用 pg_dump -t 或 copy 把受影响的行复制回来。直接把生产环境回滚,也会丢掉目标时刻之后每一笔合法写入。
深入阅读:其他恢复目标、时间线,以及重放速度为何制约 RTO
除了时间之外,还可以在 recovery_target_lsn(精确的 WAL 位置)、recovery_target_xid(某个事务的 XID)或 recovery_target_name 处停止;后者是先前用 select pg_create_restore_point('before_billing_migration') 创建的标签。在有风险的迁移之前创建一个命名恢复点,是成本很低的好习惯。
恢复会启动一条新的时间线,也就是 WAL 历史的一条新分支,这样恢复服务器的 WAL 就不会和归档中的旧历史冲突。.history 文件也要保留。
重放大致只运行在一个进程中,所以重放繁忙系统一周产生的 WAL 可能要花几小时。这就是为什么仍然要每天或每周做基础备份:每份备份都会限制重放范围,也就限制了 RTO。
关于 archive_timeout:60 秒时,最坏情况大约会丢失一分钟的数据;代价是每个安静但有过写入的分钟都会产生一个大多为空的 16 MB 段。还有上面告警所需的归档器计数器:
增量备份的好坏取决于它的链条
一个 2 TB 数据库的完整基础备份每次都要复制 2 TB,即使只有 20 GB 发生了变化。PostgreSQL 17 把增量备份加入了核心。
启用 summarize_wal = on(默认关闭)后,服务器会跟踪哪些块发生了变化。把上一份备份的清单交给 pg_basebackup --incremental,它就只复制这些块。pg_combinebackup 会把完整备份和它的增量备份链拼成一份可以恢复的完整备份。
问题在于这条链。每个环节都必须存在且完整;丢了周一的备份,周二的就没用了。逐个验证每个环节。
深入阅读:一周的增量备份,以及缺失的环节是什么样
使用备份工具
手工构建一次 PITR,先理解它的工作方式。在生产环境中,使用 pgBackRest、WAL-G 或 Barman;它们都是开源项目,前两个使用得最广泛。每个工具都会压缩、加密 WAL,再将其上传到对象存储,并在上传失败时重试;并行执行完整和增量基础备份;清理过期备份,并且只清理不再需要的 WAL;还可以用一条命令恢复到指定时刻。
选一个,不要混用,并检查它是否有人维护:pgBackRest 的维护在 2026 年 4 月停止,在获得赞助资金后于 5 月恢复(pgBackRest news,截至 2026 年 10 月)。把备份存放在数据库服务器的凭据无法删除它们的位置(单独的账户、对象锁、版本化存储桶)。勒索软件和错误的清理脚本会以同样的方式删除备份。
托管备份仍需要一份由你掌握的副本
托管服务会内置快照、WAL 归档和“恢复到某个时间点”按钮。这个按钮有局限:恢复会创建一台新服务器,保留期是以天或周计的固定窗口,自动备份存放在实例自己的账户中,有时还会随实例一起删除。把快照复制到其他地方,并定期保留自己的 pg_dump,这是你唯一可移植的副本。备份是快照加 WAL,而恢复会创建新服务器说明了恢复按钮遗漏的内容。
测试恢复
备份会静默失败:归档命令失败了一周,生命周期规则删除了需要的 WAL,加密密钥留在已经损坏的服务器上,恢复要花 9 个小时而你的 RTO 只有 1 小时。你只能在恢复时发现这些问题,所以要在不得不恢复之前先恢复一次。
GitLab 的 2017 年 1 月故障 是标准教训。一名工程师以为那是备库,结果擦掉了主库的数据目录。随后每种备份都接连失败:pg_dump 一直静默失败(9.2 二进制文件连接 9.6 服务器),磁盘快照从未启用,而备库刚刚被擦掉以重新同步。一个六小时前的 LVM 快照花了大约 18 小时才复制回来,约 5,000 个项目丢失。纸面上每种方法都存在,但没有一种经过恢复验证。
把它自动化。按计划用正常流程把最新备份恢复到一台临时测试服务器,然后检查服务器能否启动、关键行数是否接近生产环境、最新一行的时间与目标恢复时刻之差是否在 RPO 允许范围内,以及 amcheck 在一部分索引上是否通过。为每一步计时:那才是你的真实 RTO。拆掉这台服务器,任何一步失败都要告警。
每年几次,让一个没有构建备份的人只依据运行手册来恢复。让他找出缺口,总好过让事故找出缺口。
“备份任务以 0 退出”不是证据。应针对最近一次成功基础备份的年龄、最近归档 WAL 段的年龄、不断升高的 pg_stat_archiver.failed_count,以及上一次自动恢复测试的结果设置告警。
及时采用小版本;演练大版本
升级属于本章,因为大版本升级就是一次由你安排的恢复:同样需要复制、回退方案和演练。小版本升级(18.5 到 18.6)保持磁盘格式不变:阅读发行说明,以防它要求重建索引;安装二进制文件并重启。大版本升级(17 到 18)会改变系统目录格式,所以新服务器无法打开旧数据目录。
跨越大版本有三种方式。转储并恢复适用于任何版本,也不会留下膨胀,但停机时间等于转储加恢复的全部时间,所以只适合小数据库。另外两种方式可以扩展到更大规模。
pg_upgrade –link 快速且只能单向进行
pg_upgrade 会建立新的系统目录并原样复用旧数据文件。使用 --link 时,它会创建硬链接而不是复制文件,所以 TB 级升级只需几分钟。代价是:新服务器一旦写入共享文件,旧集簇就不能再使用,因此回退方案只能是备份或副本。先做备份,并在正式操作前运行 pg_upgrade --check。
升级当晚有两个 PostgreSQL 18 的变化很重要。好的变化是:pg_upgrade 现在会迁移大部分规划器统计信息,因此之后的一小时里查询不会一直依赖猜测(来自create statistics的扩展统计信息仍需执行 analyze)。陷阱是:initdb 现在默认打开数据校验和,而 pg_upgrade 拒绝配对校验和设置不同的集簇。对于没有校验和的 17 集簇,应使用 initdb --no-data-checksums 创建新集簇。
副本也要规划:它们无法跨大版本跟随主库,所以要重建,或者按文档中的 rsync 流程升级。
深入阅读:pg_upgrade 移动文件的四种方式,以及首先运行的检查
| 模式 | 做法 | 速度 | 旧集簇之后是否仍可用? |
|---|---|---|---|
--copy(默认) | 复制每个文件 | 慢,需要 2 倍磁盘空间 | 是 |
--link | 为文件创建硬链接 | 几秒到几分钟 | 否,新服务器启动后不可用 |
--clone | 写时复制克隆(需要文件系统支持) | 快 | 是 |
--swap(PostgreSQL 18+) | 把数据目录移动到新集簇中 | 可能是最快的 | 否 |
之所以可以复用文件,是因为近几个大版本之间用户表和索引格式一直兼容;使用 --link 时,工作量取决于文件数量,而不是文件大小。要在旧集簇中打开校验和,而不是在新集簇中关闭它,请在旧集簇停机时运行 pg_checksums --enable;它会重写每个页面,所以停机时间取决于集簇大小,而不是文件数量。--no-statistics 会跳过 PostgreSQL 18 的统计信息传输,最后 pg_upgrade 会打印 vacuumdb --analyze-in-stages --missing-stats-only 命令,供你补齐未迁移的统计信息。
动手验证 · lab 31-backups.sh
逻辑复制把升级停机时间压缩到切换阶段
要实现最短停机时间,可以让新版本集簇通过逻辑复制订阅旧集簇:它会先复制每一行,再持续流式传输变更,直到你切换;切换只需几秒到一两分钟。代价包括:冻结模式变更(DDL 不会复制)、每张表都必须有主键或副本标识、通过网络完成一次完整复制,以及序列和大对象也不会复制。新集簇接管写入前,要把每个序列推进到旧值之后,否则第一条插入就会因键重复而失败。好处是得到一个没有膨胀的集簇,还能随时演练切换。一些托管服务把这叫作蓝绿升级。
深入阅读:逻辑切换,逐步进行
先复制模式(pg_dump --schema-only),创建订阅并等待初始复制。然后在切换时:
- 停止向旧集簇写入(维护模式,或撤销写权限)。
- 等待订阅者追上(槽的确认位置等于旧主库当前的 WAL 位置)。
- 把新集簇中的每个序列推进到旧值之后,因为序列不会复制。
- 把应用指向新集簇。
无论采用哪种方式,都要先在生产环境的恢复副本上演练。
本章要点
- 先写下 RPO 和 RTO;它们决定你需要哪些备份。副本不是备份。
- 用
pg_dump -Fd -j N(或-Fc)做可移植、可选择性恢复的备份,再用pg_dumpall --globals-only备份角色(托管服务上加--no-role-passwords)。任何逻辑恢复后都运行analyze。 - 灾难恢复使用物理基础备份加持续 WAL 归档,通过 pgBackRest 或 WAL-G 之类的工具,把备份放到数据库主机无法删除的存储中。
- 要撤销人为错误,请在另一台服务器上恢复到某个时间点,设置
recovery_target_action = 'pause',再把数据行复制回来。 - 在
pg_stat_archiver报告失败时、pg_wal填满磁盘前发出告警。 - 增量备份自 PostgreSQL 17 起进入核心;验证链条中的每个环节。
- 自动执行恢复测试并测量真实 RTO。未经恢复验证的备份只是传闻。
- 使用
pg_upgrade --link获得速度,或用逻辑复制实现接近零停机的大版本升级(切换时推进序列);在 18 中留意校验和默认值。
延伸阅读
- Backup and Restore 和 Continuous Archiving and PITR,PostgreSQL 文档。完整流程,包括每个恢复目标设置。
- pg_basebackup 和 pg_combinebackup,PostgreSQL 文档。增量备份及其链条。
- pg_dump 和 pg_upgrade,PostgreSQL 文档。格式、并行处理、升级模式和副本流程。
- pgBackRest User Guide,pgBackRest 项目。完整且带有明确观点的生产备份操作指南。
- WAL-G 和 Barman。如果 pgBackRest 不合适,可选的其他广泛使用的备份工具。
- Postmortem of database outage of January 31,GitLab,2017 年。四种备份和复制方法都没能挽救局面;在相信自己的备份之前先读读它。
- amcheck,PostgreSQL 文档。在恢复副本中验证索引和堆的完整性。