# 代价最低的计划胜出
> 跟着一条查询从 SQL 走到计划,手算规划器的算术,准确看清它为什么选择每种扫描、连接、工作进程数量和 JIT。
---
LLMS 索引: [llms.txt](/llms.txt)
---
这是每个多租户应用迟早都会写的一种连接。每行都带有 `account_id`,所以为了保险,到处都按它匹配:
```sql
select count(*)
from events e
join projects p on p.id = e.project_id and p.account_id = e.account_id
join users u on u.id = p.owner_id and u.account_id = p.account_id;
```
租户条件是多余的:项目只属于一个账户,项目所有者也只属于一个账户。它们不会改变答案,却会彻底改变计划:
```text
Aggregate (cost=67569.72..67569.73 rows=1 width=8)
(actual time=3366.344..3366.347 rows=1.00 loops=1)
Buffers: shared hit=5998602 read=36762
-> Nested Loop (cost=691.29..67569.72 rows=2 width=0)
(actual time=3.700..3268.819 rows=2000000.00 loops=1)
```
规划器预计得到 2 行,实际得到 2,000,000 行。它选择了一个适合 2 行的完美计划,却进行了 6,035,364 次页访问。删掉多余条件后,同样的计数只需 36,490 次页访问。
[规划器也在估算](/20-planner/#basics-chapter-20)已经讲过估算。本章讲规划器如何处理这些估算,好消息是:它并不聪明,但始终一致。它在能够计算代价的计划中选择代价最低的那个,而且每个选择都可以用算术核对。计划不对时,要么代价错了,要么行数错了;你可以找出究竟是哪一个。
计划来自 PostgreSQL 18;除非某节专门讨论并行或 JIT,否则它们都关闭了这两项功能。
## 你的查询在计算代价之前就已被重写 {#your-query-is-rewritten-before-its-priced}
在计算任何一个代价之前,你的查询已经被重写了两次:
```text
SQL
|
v
parse resolve names and types against the catalog
|
v
rewrite views become subqueries; RLS policies become
| WHERE conditions
v
preprocess (no costs yet, only logic)
| - pull subqueries and IN/EXISTS up into joins
| - push filters down toward the tables
| - fold constants, drop contradictions
| - turn outer joins into inner joins
| - remove joins nobody reads; inline CTEs
| - PG 18: remove self-joins, OR lists to ANY
v
paths every way to scan each table, every join
| order and method, priced; cheapest survives
v
plan one tree, plus the JIT decision
```
每次重写都会让搜索面对一个更简单的问题,而且每次重写都会显示在 `EXPLAIN` 中。因此,**不要手动优化预处理器已经完成的工作。** `IN (subquery)` 会变成规划器可以重新排序的连接,而只使用一次的 CTE 会被内联([CTE:内联还是物化](/22-queries/#a-cte-used-once-is-inlined-not-fenced))。
### 视图和策略只是文本替换 {#views-and-policies-are-text-substitution}
视图就是粘贴到你的查询中的已保存查询,因此在运行时不产生额外开销。[行级安全](/43-glossary/#row-level-security)策略也会以同样方式粘贴进来,成为又一个 `WHERE` 条件:你从未写过的策略会出现在 `Index Cond` 中,这就是租户列需要索引的原因([RLS 性能:策略就是谓词](/33-security/#rls-performance-policies-are-predicates))。“不产生额外开销”有一个例外:策略和 `security_barrier` 视图不会让你自己的条件先于它们执行,除非你自己的条件中的函数标记为 `leakproof`;因此,本来可以下推到索引中的过滤条件,最后可能变成逐行检查。
### 常量会被折叠 {#constants-are-folded}
不包含列的表达式会在计划时计算一次:`where id = 2 * 21` 会变成 `Index Cond: (id = 42)`,而 `and 1 = 2` 会规划为 `Result`,带有 `One-Time Filter: false`,什么也不读取。像 `now()` 这样的稳定函数不会被折叠(预备语句可能明天才执行),但规划器会计算它们来估算行数;这就是 `created_at >= now() - interval '1 day'` 能得到真实估算并使用索引的原因。
> [!DETAILS]- 深入阅读:在 EXPLAIN 中观察每次重写
>
> **过滤条件下推。** 对分组子查询的分组列施加的过滤条件会落到聚合下面,因此 Postgres 只统计一个项目的行,而不是先统计全部 20,000 个项目的行再丢掉其中 19,999 个(`GroupAggregate` 位于 `Seq Scan ... Filter: (project_id = 42)` 之上)。
>
> **外连接变成内连接。** `projects p left join events e ... where e.kind = 'deploy'` 无法保留空项目(它们的 `e.kind` 是 null),因此规划结果是普通的 `Hash Join`,搜索过程可以重新排序。如果你本来想保留这些项目,过滤条件就应该放进 `ON` 子句。
>
> **没人读取的连接会消失。** `select p.* from projects p left join users u on u.id = p.owner_id` 的计划只有 `Seq Scan on projects p`。ORM 经常生成这样的连接;正是这次重写让它们的代价低于表面看起来的样子。
>
> **PostgreSQL 18 会消除自连接并折叠 `OR` 列表。** 一个表按主键与自身连接时,第二次扫描会消失;`id = 1 or id = 2 or id = 3` 会变成一次探测:`Index Cond: (id = ANY ('{1,2,3}'::integer[]))`。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('a filter on a grouped subquery is pushed below the aggregate',
> > lab.est_nodes($$ select * from (select project_id, count(*) from events
> > group by project_id) s
> > where project_id = 42 $$) = '{Aggregate,Seq Scan}'
> > and lab.est_rows($$ select * from (select project_id, count(*) from events
> > group by project_id) s
> > where project_id = 42 $$) = 1);
> >
> > select lab.prove('an unused LEFT JOIN to a unique key is removed entirely',
> > lab.est_nodes($$ select p.* from projects p left join users u on u.id = p.owner_id $$)
> > = '{Seq Scan}');
> >
> > select lab.prove('PostgreSQL 18 removes a self-join on the primary key',
> > lab.est_nodes($$ select e1.* from events e1 join events e2 on e2.id = e1.id
> > where e2.kind = 'deploy' and e1.id < 100 $$) = '{Index Scan}');
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 误差会沿连接树向上累积 {#errors-compound-up-the-join-tree}
回到开头的查询。连接估算值等于两侧输入行数的乘积再乘以[选择率](/43-glossary/#selectivity);有两个连接条件时,规划器会把它们当成彼此独立,分别相乘([规划器假设各列彼此独立](/20-planner/#the-planner-assumes-your-columns-are-independent)):
```text
events x projects 2,000,034 x 20,000
x 1/20,000 (e.project_id = p.id)
x 1/1,000 (e.account_id = p.account_id)
= about 2,000 rows (actual: 2,000,000)
```
第二个条件什么也不会排除,因此估算值低了 1,000 倍。接着,这个误差变成了一个*输入*。与 `users` 的连接还有自己的多余条件,于是又除以约 1,000:得到 2 行。对于 2 行,通过索引探测 `users` 的嵌套循环是正确计划;对于 2,000,000 行,这意味着两百万次探测,每次大约三个页。
删除多余条件后,每个估算都正确,两个连接都会使用哈希连接,查询的页访问次数降到了原来的一百六十五分之一。在两个层级各有 10 倍误差,到第三层就会变成 100 倍。
> [!WARNING] 多余的连接条件并非没有代价
>
> 在每次连接中都匹配 `account_id` 感觉更安全,而带有复合键的 ORM 会生成这样的条件。每个多余条件都会让估算值除以该列的不同值数量。应按决定该行的键连接。若要保证账户匹配,请使用复合外键:`events (project_id, account_id) references projects (id, account_id)`。它既约束数据,规划器又会在估算连接时读取外键;因此,有了它之后,包含两个条件的连接也能得到正确估算。
> [!DETAILS]- 深入阅读:两个计划并排比较
>
> ```text
> -> Nested Loop (... rows=2 ...) (actual ... rows=2000000.00 loops=1)
> -> Hash Join (... rows=1999 ...) (actual ... rows=2000000.00 loops=1)
> Hash Cond: ((e.project_id = p.id) AND (e.account_id = p.account_id))
> -> Index Scan using users_pkey on users u (... rows=1 ...)
> (actual ... rows=1.00 loops=2000000)
> ```
>
> 没有多余条件时:
>
> ```text
> Buffers: shared hit=1126 read=35364
> -> Hash Join (... rows=2000034 ...) (actual rows=2000000.00 loops=1)
> ```
>
> `users` 的哈希代价是 1,126 次命中(整张 `users` 表),读取则来自 `events` 和 `projects`。下面的断言也确认了提示框中复合外键的修复。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('a redundant tenant clause divides the join estimate by about 1,000',
> > lab.est_rows($$ select * from events e join projects p
> > on p.id = e.project_id and p.account_id = e.account_id $$)
> > between 1500 and 2500
> > and lab.est_rows($$ select * from events e join projects p on p.id = e.project_id $$)
> > > 1900000);
> >
> > select lab.prove('the compounded misestimate costs over 100x the pages of the plain join',
> > lab.buffers($$ select count(*) from events e
> > join projects p on p.id = e.project_id and p.account_id = e.account_id
> > join users u on u.id = p.owner_id and u.account_id = p.account_id $$)
> > > 100 * lab.buffers($$ select count(*) from events e
> > join projects p on p.id = e.project_id
> > join users u on u.id = p.owner_id $$));
> >
> > begin;
> > alter table projects add constraint projects_id_account_key unique (id, account_id);
> > alter table events add constraint events_project_account_fkey
> > foreign key (project_id, account_id) references projects (id, account_id);
> > analyze projects;
> > select lab.prove('with a composite foreign key, the two-condition join is estimated at about 2 million rows',
> > lab.est_rows($$ select * from events e join projects p
> > on p.id = e.project_id and p.account_id = e.account_id $$) > 1900000);
> > rollback;
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 访问路径是按代价计算的,不是按排名决定的 {#access-paths-are-priced-not-ranked}
对于每张表,规划器都会构建它可以使用的每一种扫描方式([读取索引的三种方式](/17-btree/#an-index-helps-only-as-much-as-its-rows-sit-together),再加上顺序扫描),并为每一种计算代价。没有“索引一定胜过顺序扫描”这种规则,只有算术;对结果影响最大的数字是[相关性](/43-glossary/#correlation)。
### 相关性决定索引扫描的代价 {#correlation-prices-the-index-scan}
索引扫描的 I/O 代价会在两个极端之间变化。相关性为 0 时,每个匹配行都位于不同的页上,需要按随机顺序获取。相关性为 1 时,匹配行位于连续页上,几乎可以按顺序读取。规划器会按**相关性的平方**进行折算,所以只有很强的相关性才能获得明显折扣:相关性为 0.5 时,只能得到四分之一的折扣。
为了隔离这个因素,给 `events` 在 `created_at` 上建立索引,再以随机顺序复制这张表,并使用相同的索引:行相同,唯一不同的是物理顺序。在查询最近一天事件时强制使用索引扫描(为当前会话关闭位图扫描),乱序副本的代价是有序表的 82 倍;如果不强制,规划器会选择位图扫描。
### 5% 规则在两个方向上都不对 {#the-5-rule-is-wrong-in-both-directions}
扩大时间窗口后,每张表都会在某个窗口宽度切换计划:
| 表 | 计划 | 截止(窗口) | 估算行数 |
|---|---|---|---|
| events(相关性 1) | Index Scan | 235 天 | 1,293,301(65%) |
| events(相关性 1) | Seq Scan | 超过 | |
| events_shuffled | Index Scan | 2 分钟 | 8 |
| events_shuffled | Bitmap Heap Scan | 143 天 | 781,520(39%) |
| events_shuffled | Seq Scan | 超过 | |
**Table 21-1.** 5% 规则在两个方向上都不对
“表中低于 5% 就使用索引”这句话可以休矣。对于有序数据,索引扫描一直适用到表的 65%。对于乱序数据,普通索引扫描只有在行数很少时才胜出,而位图扫描可以一直适用到 39%,因为一旦触及大多数页,它就会按物理顺序读取这些页。
在我们的机器上,所有数据都已缓存;在计划切换点,顺序扫描实际上比它替代的计划更快(有序表切换点约为 115 ms,对比 210 ms):这说明当内存能容纳全部数据时,可以降低 `random_page_cost`,并且要一次性为整台服务器设置。
> [!DETAILS]- 深入阅读:插值,以及表格背后的实验
>
> ```text
> max_IO = pages fetched x random_page_cost (correlation 0)
> min_IO = 1 x random_page_cost
> + (rest of the pages) x seq_page_cost (correlation 1)
>
> IO cost = max_IO - correlation^2 x (max_IO - min_IO)
> ```
>
> ```sql
> create index events_created_at_idx on events (created_at);
> create table events_shuffled as select * from events order by random();
> create index events_shuffled_created_at_idx on events_shuffled (created_at);
> analyze events_shuffled;
> -- correlation of created_at: 1 on events, -0.004 on events_shuffled
> ```
>
> 对于 `created_at >= '2026-10-05'`,在两张表上都强制使用索引扫描:
>
> ```text
> Index Scan using events_created_at_idx on events
> (cost=0.43..242.75 rows=5104 width=112)
>
> Index Scan using events_shuffled_created_at_idx on events_shuffled
> (cost=0.43..19884.52 rows=5304 width=112)
> ```
>
> 如果不强制,规划器会为乱序表选择代价为 14,360 的位图扫描。实验通过对窗口宽度进行二分搜索,找出表中的每个切换点。仅索引扫描会根据全可见页另行折算代价,折算依据来自 `pg_class.relallvisible`。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('correlated: the index scan holds until 50 to 80 percent of the table, then a seq scan',
> > path_at('events', 60) = 'Index Scan'
> > and path_at('events', current_setting('plans.flip_corr')::int + 1) = 'Seq Scan'
> > and rows_at('events', current_setting('plans.flip_corr')::int)
> > / (select reltuples from pg_class where relname = 'events') between 0.5 and 0.8);
> >
> > select lab.prove('shuffled: index scan only for a handful of rows (under 100), then bitmap',
> > path_at('events_shuffled', 1) = 'Index Scan'
> > and path_at('events_shuffled', current_setting('plans.flip_ib')::int + 1) = 'Bitmap Heap Scan'
> > and rows_at('events_shuffled', current_setting('plans.flip_ib')::int) < 100);
> >
> > select lab.prove('shuffled: bitmap until 20 to 60 percent of the table, then a seq scan',
> > path_at('events_shuffled', current_setting('plans.flip_bs')::int + 1) = 'Seq Scan'
> > and rows_at('events_shuffled', current_setting('plans.flip_bs')::int)
> > / (select reltuples from pg_class where relname = 'events_shuffled') between 0.2 and 0.6);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 排序顺序是访问路径的属性 {#sorted-order-is-a-property-of-a-path}
一条访问路径还携带它输出行的顺序(规划器称之为**pathkeys**),因此,如果一条代价更高的路径可能省掉后续排序,它也会在搜索中保留下来。`ORDER BY ... LIMIT` 正是这种情况发挥作用的地方:`order by created_at desc limit 10` 反向遍历索引,读取 4 个页后停止;`Limit` 只为它实际读取的那一小部分付出代价。若要求一个没有索引提供的顺序(`order by kind, created_at desc`),就必须先读取并排序全部行,才能输出第一行:35,179 个页。
介于两者之间的是**增量排序**(PostgreSQL 13+):它使用索引提供第一个排序键,再在每个组内排序;`order by created_at desc, kind limit 10` 读取了 8 个页。
意外出现排序,说明没有任何访问路径提供所需顺序([Limit 押注于尽早找到行](/19-explain/#limit-bets-on-finding-rows-early)展示了代价高昂的版本)。
> [!DETAILS]- 深入阅读:三个 ORDER BY ... LIMIT 计划
>
> 反向索引扫描报告 `Buffers: shared read=4`,排序报告 `shared hit=6 read=35173`;增量排序显示 `Presorted Key: created_at`。第一个索引扫描的总代价是 87,124,但它的 `Limit` 代价是 0.86。排序的启动代价(98,392)几乎等于总代价:直到它看完每一行,才会有任何东西输出。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('ORDER BY created_at DESC LIMIT 10 walks the index backward: no Sort, under 20 pages',
> > lab.est_nodes($$ select id, kind, created_at from events
> > order by created_at desc limit 10 $$) = '{Limit,Index Scan}'
> > and lab.buffers($$ select id, kind, created_at from events
> > order by created_at desc limit 10 $$) < 20);
> >
> > select lab.prove('ORDER BY created_at DESC, kind LIMIT 10 uses an incremental sort on the index order',
> > lab.est_nodes($$ select id, kind, created_at from events
> > order by created_at desc, kind limit 10 $$)
> > = '{Limit,Incremental Sort,Index Scan}'
> > and lab.buffers($$ select id, kind, created_at from events
> > order by created_at desc, kind limit 10 $$) < 20);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 连接顺序是一场搜索,而且搜索会变得昂贵 {#join-order-is-a-search-and-searches-get-expensive}
有了每张表的最低代价路径后,规划器会寻找组合它们的最低代价方式,采用的是 1979 年 System R 论文提出的做法:动态规划。它会为每一对表找出最佳计划,再每次增加一张表,并为每组表只保留代价最低的计划。这样的剪枝让搜索变得可行,但规模仍然增长很快。下面使用 4 到 13 份同一张 1,000 行表的副本,它们都按一个键连接,分别在穷举规划(`geqo = off`)和默认设置下进行规划:
| 表数量 | 穷举规划耗时 | 默认设置规划耗时 |
|---|---|---|
| 4 | 0.4 ms | 0.5 ms |
| 8 | 8.1 ms | 10.5 ms |
| 10 | 75.7 ms | 112.5 ms |
| 11 | 217 ms | 211 ms |
| 12 | 962 ms | 41.8 ms |
| 13 | 2,609 ms | 37.6 ms |
**Table 21-2.** 连接顺序是一场搜索,而且搜索会变得昂贵
每增加一张表,穷举规划的时间大约会变成原来的三倍;直到 12 张表时,默认设置那一列突然掉下悬崖。这就是 `geqo_threshold = 12`:从这里开始,**遗传查询优化器**(GEQO)会用随机搜索替代穷举搜索,并在固定的工作量后停止。规划时间保持平稳,但计划只是很好,并不保证是最佳计划。
`join_collapse_limit`(默认值为 8)避免大查询进行完整搜索:超过 8 个项目的显式 `JOIN` 会按你写下的顺序分块规划,每一块都单独求最优。相同的 12 张表用显式 `JOIN ... ON` 时规划耗时 9.2 ms,而用逗号列表并进行穷举规划时需要 962 ms。因此,只有逗号列表才会穷举搜索到 11 张表;对于 ORM 编写的 `JOIN` 语法,它在 8 张表处就停止。`join_collapse_limit = 1` 会让规划器严格遵循你的连接顺序。只在会话内调整这些设置,绝不要全局调整。超过十二张表后,在责怪执行器之前先检查 `Planning Time`:ORM 的预加载可能花在规划上的时间比执行还多。
> [!DETAILS]- 深入阅读:测量规划时间
>
> 这是我们机器上三次运行中最好的一次;重要的是形状,而不是这些数字。GEQO 从 `geqo_seed` 取得种子,因此相同的查询和统计信息会得到相同的计划。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('exhaustive planning time grows steeply: 11 tables take over 10x as long as 7',
> > current_setting('plans.ms11')::numeric > 10 * current_setting('plans.ms7')::numeric);
> >
> > select lab.prove('at 12 tables GEQO takes over, planning at least 3x faster than exhaustive search',
> > current_setting('plans.ms12')::numeric > 3 * current_setting('plans.ms12g')::numeric);
> >
> > select lab.prove('explicit JOINs past join_collapse_limit (8) are planned in pieces, far faster',
> > current_setting('plans.ms12')::numeric > 5 * current_setting('plans.ms12j')::numeric);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 每种连接方法都在某条代价曲线上胜出 {#each-join-method-wins-on-a-cost-curve}
[每种连接方法只适合某些行数](/19-explain/#each-join-method-is-right-only-for-some-row-counts)展示了如何读取三个连接节点。下面解释为什么每种方法会被选中:
```text
nested loop cost ~ outer rows x (cost of one inner lookup)
grows linearly with the outer side
hash join cost ~ build inner hash + scan outer once
mostly fixed; jumps if it needs batches
merge join cost ~ sort both sides (unless already sorted)
+ one pass over each
```
规划器会为每一对输入计算三种方法的代价,并保留代价最低的那个,因此行数变化时选择也会变化。一个账户的 20 个项目与其事件连接时,会采用嵌套循环:每个项目的索引查找代价约为 383 个单位,而哈希连接要先扫描全部 `events`(约 55,000)才行。把范围扩大到 `account_id <= k`:8 个账户(190 个项目)时仍是嵌套循环;到 9 个账户(212 个项目)时就切换为哈希连接。
这也解释了为什么当外侧估算值偏低时,嵌套循环是最危险的计划:它是为小数量选择的,而代价会随着真实数量增长。
内存也会改变选择,而且不一定是在你想象的位置。按 `order by e.user_id` 把全部 events 与 users 连接,在默认的[`work_mem`](/43-glossary/#work_mem) 4 MB 下得到的是归并连接。哈希连接本身不是问题:100,000 个用户的哈希在 4 MB 下只需一个批次,因为 `hash_mem_multiplier` 会给哈希两倍于 `work_mem` 的内存;在 4 MB 和 8 MB 下,哈希连接本身的代价也相同。问题是哈希连接之后所需的排序:两百万个连接结果,每行约 35 字节,需要在磁盘上排序。归并连接只需在连接前排序较窄的 `events` 一侧(每行 14 字节),因此在 4 MB 下更便宜。到 8 MB 时,大排序需要的归并轮次减少,估算代价下降,同一查询变成哈希连接加排序:一个设置导致不同的连接,这也是应当为报表角色提高 `work_mem`,而不是为整台服务器提高它的好理由。
**Memoize**(PostgreSQL 14+)是一种带记忆能力的嵌套循环:它在内侧建立以连接值为键的缓存;当外侧的不同键远少于行数时,规划器会添加它。在计划节点中,`Misses` 是内侧真正执行的次数,`Hits` 是节省下来的执行次数。归档项目及其账户的用户数:外侧有 3,911 行,但只有 989 个不同账户,因此子查询只运行 989 次;启用 Memoize 时,查询读取了 3,444 个页,而设置 `enable_memoize = off` 时读取了 13,075 个页。需要关注的输入是连接列上的 `n_distinct`。
> [!DETAILS]- 深入阅读:交叉点、归并连接和 Memoize
>
> 单账户嵌套循环的内侧是一条**参数化路径**:索引扫描(`Index Cond: (project_id = p.id)`)从当前外侧行获取键,这正是嵌套循环很快的原因。在 `k = 8` 时,嵌套循环的代价是 60,105;在 `k = 9` 时,哈希连接的代价是 60,688。交叉点大约是 19,000 个事件,即表的 1%。在 4 MB 下,归并连接的代价为 371,832,而哈希连接加排序为 387,490;在 8 MB 下,哈希连接加排序的代价为 332,802。在这两种内存设置下,哈希连接本身的代价都是 63,799,并使用 7,274 KB 在一个批次内运行,这和上一章在一个批次内运行的哈希相同([每种连接方法只适合某些行数](/19-explain/#each-join-method-is-right-only-for-some-row-counts))。全部差异都来自顶层排序:4 MB 时启动代价为 382,490,8 MB 时为 327,802,而这个排序无论哪种设置都溢写了约 96 MB。Memoize 节点:
>
> ```text
> -> Memoize (cost=6.43..6.44 rows=1 width=8) (actual rows=1.00 loops=3911)
> Cache Key: p.account_id
> Hits: 2922 Misses: 989 Evictions: 0 Overflows: 0 ...
> ```
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('more outer rows flip it to a hash join, somewhere between 2 and 30 accounts',
> > current_setting('plans.nl_flip')::int between 2 and 30
> > and join_node($$ select count(e.payload) from projects p
> > join events e on e.project_id = p.id where p.account_id <= 50 $$) = 'Hash Join');
> >
> > set work_mem = '4MB';
> > select lab.prove('at work_mem 4MB, events x users ORDER BY user_id is a merge join',
> > join_node($$ select e.kind, u.email from events e join users u on u.id = e.user_id
> > order by e.user_id $$) = 'Merge Join');
> > select set_config('plans.merge_cost', est_cost($$ select e.kind, u.email from events e
> > join users u on u.id = e.user_id order by e.user_id $$)::text, false) \g /dev/null
> > set enable_mergejoin = off;
> > select set_config('plans.hj4', hj_cost($$ select e.kind, u.email from events e
> > join users u on u.id = e.user_id order by e.user_id $$)::text, false),
> > set_config('plans.hashsort4', est_cost($$ select e.kind, u.email from events e
> > join users u on u.id = e.user_id order by e.user_id $$)::text, false) \g /dev/null
> > select lab.prove('at 4MB the rejected hash join plus sort costs more than the merge join',
> > join_node($$ select e.kind, u.email from events e join users u on u.id = e.user_id
> > order by e.user_id $$) = 'Hash Join'
> > and current_setting('plans.hashsort4')::numeric
> > > current_setting('plans.merge_cost')::numeric);
> > reset enable_mergejoin;
> > set work_mem = '8MB';
> > select lab.prove('at work_mem 8MB the same query becomes a hash join plus a sort',
> > join_node($$ select e.kind, u.email from events e join users u on u.id = e.user_id
> > order by e.user_id $$) = 'Hash Join');
> > select lab.prove('the hash join costs the same at 4MB and 8MB; only the sort above it got cheaper',
> > hj_cost($$ select e.kind, u.email from events e join users u on u.id = e.user_id
> > order by e.user_id $$) = current_setting('plans.hj4')::numeric
> > and est_cost($$ select e.kind, u.email from events e join users u on u.id = e.user_id
> > order by e.user_id $$) < current_setting('plans.hashsort4')::numeric);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 并行计划和其他计划一样按代价计算 {#parallel-plans-are-priced-like-everything-else}
并行计划只是多一条访问路径,同时多出两项代价:启动工作进程的 `parallel_setup_cost`(1000),以及工作进程交给领导进程的每一行所需的 `parallel_tuple_cost`(0.1,是 `cpu_tuple_cost` 的十倍)。因此,小表永远不符合条件,返回数百万行的扫描很少符合条件,而最终只得到少数几行的扫描最合适。
工作进程数量来自表的大小,而不是查询:表达到 8 MB(`min_parallel_table_scan_size`)时有一个工作进程,此后表大小每增加到原来的三倍就增加一个;因此 275 MB 的 `events` 得到 4 个工作进程,但会受 `max_parallel_workers_per_gather` 限制(默认值为 2)。
### 一个没有标注的函数会让查询保持串行 {#one-unlabeled-function-keeps-a-query-serial}
规划器拒绝为写入或锁定行的查询使用并行计划(`create table ... as` 和 `create materialized view` 是例外:它们内部的 `select` 可以并行),也拒绝游标,以及调用标记为 `PARALLEL UNSAFE` 的函数的任何查询;而且**用户定义函数默认都是 `PARALLEL UNSAFE`**。`WHERE` 子句中只要有一个未标注的辅助函数,两百万行的扫描就会由一个进程完成。把纯计算标记为 `parallel safe`([并行安全需要显式选择](/24-functions/#parallel-safety-is-opt-in))。
> [!DETAILS]- 深入阅读:按表大小计算工作进程,以及实测不安全函数
>
> 执行相同的 `count(*)` 查询,作用于 `events` 的副本;设置 `max_parallel_workers_per_gather = 8` 且两个并行代价都为零,因此规划器总会选择并行:`projects`(1.5 MB)没有工作进程;10 MB、28 MB 和 83 MB 的副本分别得到 1、2 和 3 个工作进程;`events`(275 MB)得到 4 个。使用默认代价时,`ev_70k` 根本不会得到并行计划。用 `alter table events set (parallel_workers = 6)` 可以按表覆盖大小规则。一个未标注的 PL/pgSQL `is_slow(payload)` 过滤器规划时没有 `Gather`;执行 `alter function is_slow(jsonb) parallel safe` 后得到 `Workers Planned: 2`。即使是已经内联的 `language sql` 函数,只要仍标记为不安全,也会阻止并行:检查依据的是你写下的查询。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('workers grow with table size: one more each time the table triples past 8 MB',
> > (select relpages from pg_class where relname = 'ev_70k') between 1024 and 3071
> > and (select relpages from pg_class where relname = 'ev_200k') between 3072 and 9215
> > and (select relpages from pg_class where relname = 'ev_600k') between 9216 and 27647
> > and (select relpages from pg_class where relname = 'events') between 27648 and 82943
> > and workers($$ select count(*) from ev_70k where kind = 'alert' $$) = 1
> > and workers($$ select count(*) from ev_200k where kind = 'alert' $$) = 2
> > and workers($$ select count(*) from ev_600k where kind = 'alert' $$) = 3
> > and workers($$ select count(*) from events where kind = 'alert' $$) = 4);
> >
> > select lab.prove('one unsafe function in WHERE and the query gets no parallel plan',
> > workers($$ select count(*) from events where is_slow(payload) $$) is null);
> >
> > select lab.prove('even an inlined SQL function blocks parallelism while marked unsafe',
> > workers($$ select count(*) from events where is_slow_sql(payload) $$) is null
> > and workers($$ select count(*) from events
> > where (payload ->> 'duration_ms')::int > 4000 $$) = 2);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## JIT 是规划器根据自身估算下的一次赌注 {#jit-is-a-bet-the-planner-places-on-its-own-estimate}
即时编译会把查询表达式转换为机器码。只要 Postgres 构建时带有 LLVM,它默认就是开启的;编译需要几毫秒,因此规划器只有在*估算*代价较高时才下注:超过 100,000(`jit_above_cost`)时进行编译,超过 500,000 时还会内联并运行 LLVM 的昂贵优化。
按 `kind` 分组的报表估算代价刚超过 100,000,编译约 5 ms,却没有获得可测量的收益,因为它的工作是 JIT 无法加速的 jsonb 调用。开启内联和优化后,同一查询花了 607 ms 编译,运行时间几乎翻倍。JIT 在处理数亿行的长分析查询时有收益;只要估算过高,它就会得不偿失:一个估算代价为 600,000、实际运行 20 ms 的查询,会为编译付出数百毫秒。
我们的默认做法是:**OLTP 主库关闭**;对会扫描整张表的分析角色按角色开启。
> [!DETAILS]- 深入阅读:读懂 JIT 信息块
>
> 在我们的机器上,该报表的计划显示 `JIT: Functions: 9`、`Emission 5.030 ms, Total 5.584 ms` 和 `Execution Time: 723.054 ms`。查询为:`select kind, count(*), avg((payload->>'duration_ms')::int), count(*) filter (where payload->>'status' = 'failed') from events group by kind`。去掉 `filter` 聚合后,代价降为 85,172:不再使用 JIT。开启 JIT 时,两次运行分别耗时 723 和 778 ms;设置 `jit = off` 时,则为 716 和 641 ms。将内联和优化阈值设为 0 后,`Timing` 显示 `Inlining 347.702 ms, Optimization 209.518 ms ... Total 606.963 ms`,`Execution Time: 1321.098 ms`(在更安静的运行中编译耗时 175 ms;它会变化,但始终很大)。缓存的通用计划会使用准备时的设置作出 JIT 决定。
>
> > [!EXAMPLE]- 动手验证 · lab `20-plans`
> >
> > ```sql
> > select lab.prove('the kind report costs just over jit_above_cost (100,000) and gets JIT',
> > est_cost($$ select kind, count(*), avg((payload ->> 'duration_ms')::int),
> > count(*) filter (where payload ->> 'status' = 'failed')
> > from events group by kind $$) between 100000 and 105000
> > and est($$ select kind, count(*), avg((payload ->> 'duration_ms')::int),
> > count(*) filter (where payload ->> 'status' = 'failed')
> > from events group by kind $$) ? 'JIT');
> >
> > select lab.prove('with inlining and optimization on, compiling takes over 10x longer',
> > current_setting('plans.jit_full')::numeric > 10 * current_setting('plans.jit_basic')::numeric);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
## 错误计划有四种原因 {#a-wrong-plan-has-one-of-four-causes}
上面的内容都可以归结为一句话:规划器根据估算和代价选择最低代价计划。因此,错误计划有四种原因,应按以下顺序检查:错误的行数估算、隐藏统计信息的查询形状、缺失或错误的索引,或者无法描述硬件的代价参数。
**图 21-1.** 找到节点,然后修复估算或工作量。如果估算行数与实际行数相差 10 倍或更多,就修复统计信息或误导统计信息的查询;如果行数正确,就修复索引、查询形状或代价。只有最后才考虑 enable\_\* 和提示。
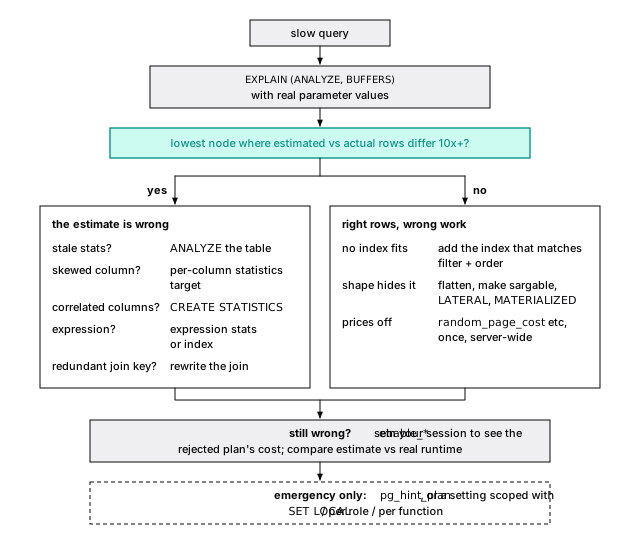
[慢查询的方法](/19-explain/#a-method-for-slow-queries)可以找到节点;[规划器也在估算](/20-planner/#basics-chapter-20)包含统计信息修复方法。如果你能根据 `pg_stats` 重现规划器的估算,问题就在统计信息。如果你甚至无法写出公式,因为它退回到了常量,问题就在查询形状。你需要的是生产环境中的计划,带有生产环境的参数;`auto_explain` 会记录它([auto_explain 会记录以后无法重现的计划](/30-configuration/#auto_explain-logs-the-plan-you-cant-reproduce-later))。
### enable_* 展示规划器没有走的路 {#enable_-shows-you-the-road-not-taken}
在会话中关闭 `enable_*` 设置,`EXPLAIN` 就会显示规划器拒绝的计划,以及它认为该计划的代价。在 PostgreSQL 18 中,禁用的计划类型不再通过巨大的惩罚来计算代价:规划器会统计被禁用的节点数,偏好禁用节点更少的计划,并标记仍然不得不使用的禁用节点。对一张没有其他访问方式的表设置 `enable_seqscan = off` 后:
```text
-> Seq Scan on ev_70k (cost=0.00..2155.00 rows=8780 width=0)
Disabled: true
```
如果被拒绝的计划运行更快,却被计算出更高代价,那么它下面的某个估算是错的,或者代价参数错了。
> [!EXAMPLE]- 动手验证 · lab `20-plans`
>
> ```sql
> set enable_seqscan = off;
> select lab.prove('PostgreSQL 18 marks a forced disabled node instead of adding a huge cost',
> lab.plan_text($$ select count(*) from ev_70k where kind = 'alert' $$) like '%Disabled: true%'
> and est_cost($$ select count(*) from ev_70k where kind = 'alert' $$) < 10000);
> reset enable_seqscan;
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/20-plans.sql)
> [!DANGER] enable_* 是显微镜,不是修复方法
>
> 只在你自己的会话中设置 `enable_*`,用于观察。全局修改会悄悄重塑服务器上的每个计划,而写进应用代码的设置会比当初支持它的数据活得更久。如果必须把它限定到一条查询,就在该事务中使用 `set local`,并写下原因。
### pg_hint_plan 适用于计划翻转的那一晚 {#pg_hint_plan-is-for-the-night-a-plan-flips}
核心 Postgres 有意不提供提示([提示会冻结计划;应该修复估算](/20-planner/#a-hint-freezes-a-plan-fix-the-estimate-instead))。`pg_hint_plan` 扩展提供了提示,适合生产查询在某个夜晚突然翻到糟糕计划、而统计信息修复还需要先测试的情况。
提示放在 `/*+ ... */` 注释中。它们可以强制指定扫描方法、连接方法或连接顺序;最有用的是,还能修正行数估算(`Rows`),从而修复根因,而不是硬性规定计划。它的提示表会把提示绑定到查询 ID,因此无需修改应用就能修复 ORM 生成的 SQL。每个提示都是在赌数据的形状永远不会改变:在每个提示旁边都留一张工单,以便最终删除它。
## 本章要点 {#the-short-version}
- Postgres 会在计算代价之前重写你的查询。不要手动优化它已经完成的工作。
- 连接估算会相乘,因此误差会沿树向上累积:一个多余的租户条件让 2,000,000 行看起来像 2 行,代价是页访问次数达到原来的一百六十五倍。
- 索引扫描的代价跟随相关性的平方变化。在有序数据上,索引扫描一直胜出到表的 65%,所以 5% 经验法则在两个方向上都不对。
- 连接搜索会穷举到 8 个显式 `JOIN`(`join_collapse_limit`),或者 11 张逗号列表中的表,每增加一张表,规划时间大约变为原来的三倍;到 12 张表时由遗传优化器接管。
- 嵌套循环在数量较小时胜出,而外侧估算值偏低时会输得很惨。
- 用户函数在标记之前都是 `PARALLEL UNSAFE`。JIT 押注于估算;OLTP 主库应将它关闭。
- 计划不对时,依次检查估算、查询形状、索引和代价。`pg_hint_plan` 留给紧急情况。
## 延伸阅读 {#further-reading}
- [Planner/Optimizer](https://www.postgresql.org/docs/18/planner-optimizer.html),PostgreSQL 文档。路径生成、三种连接策略,以及 GEQO 何时接管。
- [Parallel Query](https://www.postgresql.org/docs/18/parallel-query.html) 和 [JIT](https://www.postgresql.org/docs/18/jit.html),PostgreSQL 文档。并行安全规则和 JIT 代价阈值的一手说明。
- [Access Path Selection in a Relational Database Management System](https://courses.cs.duke.edu/compsci516/cps216/spring03/papers/selinger-etal-1979.pdf),Selinger 等,SIGMOD 1979。关于基于代价的访问路径和动态规划连接搜索的论文。
- [How Good Are Query Optimizers, Really?](https://www.vldb.org/pvldb/vol9/p204-leis.pdf),Leis 等,PVLDB 2015。基于 PostgreSQL 的测量表明,随着连接增加的基数估算错误,远比代价模型重要。
- [pg_hint_plan](https://github.com/ossc-db/pg_hint_plan),NTT OSS Center。该提示扩展及其提示表。