跳转到主要内容

13 慎选键,少后悔

用真实数据了解 bigint、随机 UUID 和 UUIDv7 对索引大小、页密度和 WAL 的影响,选择主键和公开 ID。

取三张各有一百万行的表,它们的差别只有主键;再向每张表插入第二百万行,沿途像真实服务器一样执行检查点。使用随机 UUID 键时,这一百万行写入了 551 MB 的预写式日志。使用按时间排序的 UUIDv7 时是 143 MB。使用普通 bigint 时是 130 MB。

WAL 总量几乎是四倍,原因全在于每个新键落在索引的什么位置。而这还只是键设计发生在数据库内部的一半。另一半是你展示给世界的 ID;如果它是一个计数器,就会告诉陌生人你的规模有多大。

键是以后无法低成本更换的列。一次性、分开决定两件事:你用什么连接,以及你发布什么。

自然键会变;代理键不会

**自然键(natural key)**标识现实世界中的事物,比如电子邮件。**代理键(surrogate key)**由数据库发明,比如标识列(identity column)。自然键会变化(而改变主键意味着更新每一行子记录),它们很宽,还会把个人数据泄露到 URL 和日志中。

我们的规则是:每张表都使用代理主键,自然键变成 unique 约束,例如 unique (account_id, email) 约束用于 users。例外是永远不会改变的代码('USD')以及连接表;连接表的复合键(composite key)(primary key (project_id, user_id))就是那一对外键(连接表需要在两个方向上都有索引)。

让数据库为行编号,永远不要相信顺序

Postgres 用序列生成整数键。序列是一个发放递增数字的小型关系,并通过标识列与表关联起来:id bigint generated always as identity primary key。generated always 会拒绝手工指定、以后可能与序列冲突的 ID(serial展示了这个 bug),而且每个外键列都使用与它匹配的 bigint(ID 使用 bigint)。

这些数字用于标识,而不是排序。序列会有间隔,因为 nextval() 从不回滚。它们也不按提交顺序排列:A 取到 100,B 取到 101 并先提交,而一个执行 where id > last_seen_id 的轮询器会永远跳过 100。不要用它们建立发票编号,也不要用它们建立变更流。

深入阅读:间隔、发生冲突的导入和逻辑复制

回滚的事务不会归还它的序列值,因 on conflict 跳过的插入也不会(序列函数)。缓存的值会随会话一起消失,崩溃也可能跳过一些值。无间隔计数器是另一行数据,在锁下更新。

导入保留旧 ID 的行(overriding system value)会让序列落后,因此下一次普通插入会在 ID 1 上发生冲突。每次批量加载后执行 select setval(pg_get_serial_sequence('imported', 'id'), (select max(id) from imported));。而且逻辑复制不会复制序列状态(截至 PostgreSQL 18),所以做逻辑复制升级后要重置每个序列(及时采用小版本,演练大版本)。

动手验证 · lab 12-keys
create sequence gap_demo;
select nextval('gap_demo') is not null as first \gset
begin;
select nextval('gap_demo') is not null as taken \gset
rollback;
select lab.prove('nextval is never rolled back: after an aborted transaction took 2, the next value is 3',
  nextval('gap_demo') = 3);
select lab.prove('after importing ids 1 to 3, the next normal insert collides on id 1',
  lab.try($$ insert into imported (v) values ('d') $$)
    like '23505: duplicate key value violates unique constraint "imported_pkey"%');
select lab.prove('after setval to max(id), the next insert gets 4',
  (select max(id) from imported) = 4);

完整实验脚本

递增键追加;随机键落在任何位置

UUID 是存储在 16 字节中的 128 位数字。其中一位十六进制数字表示它的版本:4 版有 122 个随机位,7 版以 48 位毫秒时间戳开头,后面跟着随机位。下面是各四个:

01a10f20-21b7-71a1-8d90-e6f8de20e3c7      b1a6404e-028b-4ade-8feb-7f86e74e2b51
01a10f20-21b7-71bf-bbef-258ac7147265      b47e0075-6a9c-4f5e-8fb7-a5c9d4a02509
01a10f20-21b7-71c2-bf17-8708d1b74560      0f4464c6-706d-48d9-b9a5-48e946db9a74
01a10f20-21b7-71c4-bf35-fefb06056477      68f1407b-2358-4853-8892-061d566ee2ac

左边的 v7 值共享前缀,并且递增。右边的 v4 值会落在任何位置。故事就是这么简单,因为 B-树会在 8 KB 的叶子页之间保持键的顺序(B-树挑起大梁),所以新键落在哪里只取决于它的值。

递增键(标识列、UUIDv7)总是落在最右侧叶子上,而最右侧叶子会留在内存中,就像只能追加的账本。随机键(UUIDv4)会落在任意位置,就像把每一页新纸随机塞进活页夹。由此产生三件事:

  1. 半满的页。 中间的满页会按 50/50 拆分;页最终大约有 70% 满,而追加写入时是 90%。
  2. 巨大的热点集合。 下一次可能写入任何叶子,因此整个索引都必须留在缓存中。
  3. 整页写入。 检查点之后第一次修改某个页时,会记录整页的镜像(检查点后的第一次修改会记录整页)。追加写入在每个检查点只需为右边缘的少数几个页付出这个代价。随机键则要为自上次检查点后首次触碰的每一个叶子付出这个代价,而在大型索引中,每个检查点就是数千个叶子:一个 16 字节键最多要写入 8 KB 的 WAL。
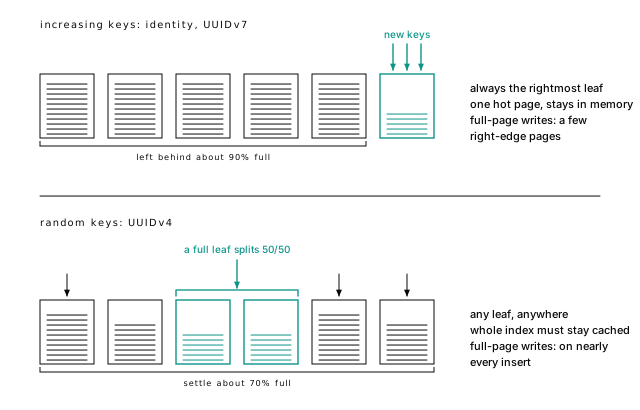
递增键追加;随机键散落。新的标识列或 UUIDv7 键都落在最右侧叶子上,叶子会留在内存中。UUIDv4 键会落在任意叶子上,满叶子会按 50/50 拆分,页最终大约有 70% 满,而追加写入时是 90%。
图 13-1 递增键追加;随机键散落。新的标识列或 UUIDv7 键都落在最右侧叶子上,叶子会留在内存中。UUIDv4 键会落在任意叶子上,满叶子会按 50/50 拆分,页最终大约有 70% 满,而追加写入时是 90%。

深入阅读:UUIDv7 中有什么,以及为什么一个会话的 ID 永远不会倒退

RFC 9562(2024)定义了这些版本;除了 4 和 7 之外,1 版会泄露 MAC 地址,3 和 5 版会对名称进行哈希。gen_random_uuid() 生成 v4;PostgreSQL 18 增加了 uuidv7() 和别名 uuidv4(),PostgreSQL 17 增加了查看 UUID 内部信息的函数:

select u, uuid_extract_version(u) as version, uuid_extract_timestamp(u) as ts
from (select uuidv7() as u) x;
                  u                   | version |             ts
--------------------------------------+---------+----------------------------
 01a10f20-21b6-7697-8e50-2eeedd76f055 |       7 | 2026-10-06 02:52:06.454+00

对 v4,它返回 null:其中没有时间。Postgres 会用 v7 版本数字之后的 12 位填入亚毫秒时间,并保证每个值都比该后端上一个值前进一小步,因此紧密循环永远不会倒退。一个语句中的一百万次调用跨越大约 500 毫秒,大约每个毫秒有 2,000 个 ID,而且每一个都比前一个大。

动手验证 · lab 12-keys
select lab.prove('uuid_extract_timestamp of a v7 is its creation time; of a v4 it is null',
  abs(extract(epoch from uuid_extract_timestamp(uuidv7()) - now())) < 60
  and uuid_extract_timestamp(gen_random_uuid()) is null);
select lab.prove('1,000,000 uuidv7() calls in one session strictly increase, though thousands share a millisecond',
  (select bool_and(u > prev) and count(distinct uuid_extract_timestamp(u)) < count(*) / 10
   from (select u, lag(u) over (order by g) as prev
         from (select g, uuidv7() as u from generate_series(1, 1000000) g) s) x
   where prev is not null));

完整实验脚本

随机键写入的 WAL 几乎是四倍

三张除了键以外完全相同的表。我们先向每张表插入一百万行,再分十批插入另一百万行,每批前执行一次 checkpoint,模拟繁忙服务器的 5 分钟 checkpoint_timeout,并从 explain (analyze, wal, buffers) 中读取每批产生的 WAL。第二百万行的结果是:

第二组 1,000,000 行bigintUUIDv4UUIDv7
产生的 WAL130 MB551 MB143 MB
整页镜像4372,75340
脏缓冲区8,19984,05810,259
表 13-1 随机键写入的 WAL 几乎是四倍

每个 bigint 和 UUIDv7 批次大约写入 4 个整页镜像,也就是堆和索引的右边缘。每个 UUIDv4 批次则写入数千个:WAL 是 v7 的 3.8 倍,脏缓冲区是 8 倍。在服务器上还有其他工作时,我们测到了 590 到 630 MB。UUIDv7 的表现几乎和 bigint 完全一样。

对于 v4 列上的每个索引,代价都会重复,包括每个指向它的、已建立索引的外键。读取也会受影响:应用最常读取的最新行分散在整个索引中,而不是集中在少数几个缓存叶子上。

深入阅读:第一个百万、索引大小和会欺骗你的基准测试

三张表分别使用 id bigint generated always as identity、id uuid default gen_random_uuid() 和 id uuid default uuidv7(),每张表旁边还有一个 n int。在一次检查点之后,每张表用一条语句插入第一个百万行:

1,000,000 行bigintUUIDv4UUIDv7
主键索引大小21 MB38 MB30 MB
平均叶子密度90.0%72.0%90.0%
插入产生的 WAL130 MB157 MB143 MB
表 13-2 随机键写入的 WAL 几乎是四倍

在这里,WAL 差距并不大,而这正是基准测试欺骗你的方式:两次检查点之间只有一条语句,整个索引都在 128 MB 的共享缓冲区中,因此每个随机叶子最多只产生一个整页镜像。差异会在稳定状态下出现:索引变大、定期执行检查点、内存小于数据(60 秒的基准测试可能错过每个检查点)。在执行检查点的批次中,WAL: 行里的 fpi(整页镜像)对于 bigint 和 v7 每批都是 4 个,而随着索引变大,随机插入会命中更多页,v4 的这个数字从第一批的 4,818 上升到最后一批的 9,443。

两百万行之后,pgstatindex 给出的主键大小分别为 43、76 和 60 MB;叶子分别有 90%、71.6% 和 90% 的填充度;leaf_fragmentation 分别为 0%、50% 和 0%,这意味着 v4 有一半叶子在磁盘上不按顺序排列。对于相同的键宽,UUIDv4 仅仅因为半页拆分,就需要比 UUIDv7 多约 25% 的叶子页。实验会以五分之一的规模重跑全部内容并检查比例。

动手验证 · lab 12-keys
select lab.prove('with checkpoints in play, UUIDv4 writes more than 3 times the WAL of UUIDv7',
  (select wal from k2 where k = 'v4') > 3 * (select wal from k2 where k = 'v7'));
select lab.prove('UUIDv7 WAL is within 20 percent of bigint''s',
  (select (select wal from k2 where k = 'v7') / (select wal from k2 where k = 'bigint') between 1.0 and 1.2));
select lab.prove('UUIDv4 dirties more than 5 times the buffers of UUIDv7',
  (select dirtied from k2 where k = 'v4') > 5 * (select dirtied from k2 where k = 'v7'));
select lab.prove('bigint and UUIDv7 pack leaves about 90 percent full',
  (select bool_and(density between 88 and 92) from k_index1 where k in ('bigint', 'v7')));
select lab.prove('UUIDv4 leaves settle around 70 percent full (between 60 and 78)',
  (select density between 60 and 78 from k_index1 where k = 'v4'));
select lab.prove('UUIDv4 needs at least 20 percent more leaf pages than UUIDv7 for the same key width',
  (select (select leaf_pages from k_index1 where k = 'v4')::numeric
        / (select leaf_pages from k_index1 where k = 'v7') > 1.2));
select lab.prove('bigint and UUIDv7 batches write a handful of full-page images; UUIDv4 batches write hundreds or more',
  (select max(fpi) from k_res where phase = 2 and k in ('bigint', 'v7')) < 50
  and (select min(fpi) from k_res where phase = 2 and k = 'v4') > 500);

完整实验脚本

数据库不总能生成 ID

标识列之所以有效,是因为只有一个写入者负责计数:数据库,而且是在插入时计数。所有需要 ID 的东西都等待 returning id,而这大多数时候不需要付出代价。当某个东西必须在行到达数据库之前知道 ID 时,这种等待就不再免费:

  • 离线和本地优先客户端。 飞机上的手机创建一个项目和三个指向它的任务。落地之前没有数据库可以询问。
  • 乐观 UI。 请求返回之前,应用就显示新评论并链接到它。
  • 一次请求中的图。 一次导入创建父行和子行,而每个子行都需要父行的 ID。使用标识列时,每一层都要一次往返,或者通过 returning 来回匹配各层的行。
  • 重试。 生成 ID 的客户端可以安全地再次发送同一行,因为 ID 同时也是幂等键。
  • 多个数据库写入。 区域、分片或将要合并的两个数据库各自有一条序列,每个数据库都会发放 42(不同环境中的计数器会冲突)。

“UUID 很现代”不在列表中,“它能隐藏我们的行数”也不在。隐藏数量是公开 ID的职责,无论键是什么。

如果其中一种情况确实存在,你有两条路。先试便宜的那一条。

保留 bigint 键,在旁边接受一个客户端 ID。 客户端生成一个 uuid,表把它存为 client_id uuid not null,并建立 unique (account_id, client_id);服务器用 on conflict do nothing 插入,这样重试时什么也不会插入。连接仍然使用 8 字节。这适用于没有其他未同步对象会在客户端新行到达之前指向它的情况:评论、表单提交、设备发来的日志行。

当引用跨过边界时,把键设为 uuid。 如果离线子行指向离线父行,或者行在数据库之间移动且引用保持不变,那么在同步时把客户端 ID 转换为服务器 ID,会变成一张你要永远维护的映射表。让客户端的 ID 成为键。把它做成 UUIDv7,让插入表现得像序列(每百万行 143 MB WAL,而 bigint 是 130 MB),并接受每个指向它的外键都是 16 字节而不是 8 字节。对于这些应用,这是值得付出的价格。

动手验证 · lab 12-keys
select lab.prove('a retry with the same client id inserts nothing, and the first row stands',
  :retry_inserted = 0
  and (select count(*) = 1 and min(body) = 'first try' from client_rows));

完整实验脚本

需要 UUID 时,使用 UUIDv7

如果需要 UUID,PostgreSQL 18 已经能在数据库中生成正确的 ID:id uuid primary key default uuidv7()(在较早版本中,在应用中生成 v7)。有两个注意事项。UUIDv7 会向持有它的人泄露行的创建时间,精确到毫秒。它的顺序只在每个生成器内部成立,所以两台机器生成的 ID 不会给出精确的事件顺序。

把它存为 uuid,绝不要存为 text。一百万个 UUID 作为文本会让主键大 87%;而且文本会通过排序规则区分大小写,因此同一个 ID 的大写副本会成为一个新的“唯一”值。

深入阅读:同样的一百万个 UUID,作为 text 和 uuid

一百万个 UUIDv7 值,按排序顺序分别复制到 text 主键和 uuid 主键中,因此只有类型不同:

 text_idx | uuid_idx | text_heap | uuid_heap
----------+----------+-----------+-----------
 56 MB    | 30 MB    | 65 MB     | 42 MB

作为 uuid 时,大写 UUID 与小写形式相等;作为文本时则不相等。

动手验证 · lab 12-keys
select lab.prove('the text primary key index is more than 70 percent bigger than the uuid one',
  pg_relation_size('k_text_pkey') > 1.7 * pg_relation_size('k_uuid2_pkey'));
select lab.prove('the text table is more than 40 percent bigger',
  pg_relation_size('k_text') > 1.4 * pg_relation_size('k_uuid2'));

完整实验脚本

客户端的 UUIDv7 是输入,不是时钟

Postgres 保证一个会话生成的 uuidv7() 值不会倒退。对于客户端生成的 ID,它什么也不保证,因为 UUIDv7 携带的是生成设备自己的时钟,而设备时钟取决于拥有者如何设置。

一部快了五年的手机生成的 ID,会排序在服务器未来五年生成的所有 ID 之后。

一台笔记本同步一周的离线工作时,会把一周积累的旧 ID 插入索引中间,像随机键一样拆分页。在实验中,两个索引都从同一批分布在一周内的 100,000 个 UUIDv7 开始;然后一个索引获得了现在生成的 20,000 个 ID,另一个获得了在这一周中随机时刻生成的 20,000 个 ID,相当于离线客户端追赶进度。这 20,000 个迟到的 ID 让叶子填充度降到 54%,索引有 767 个叶子页;而同样的 ID 如果按时到达,叶子会保持 90% 的填充度,只占 460 页。少量迟到的同步只是噪声。如果一个应用的大多数写入都迟到,它会为这些写入付出 UUIDv4 的代价。

三条规则:

  • 保留服务器时间戳。 created_at timestamptz not null default now() 表示行何时到达。客户端 ID 中的时间只是一个声明。按 (created_at, id) 对信息流和键集游标排序,绝不要只按客户端生成的 ID 排序。
  • 像验证任何输入一样验证它。 接受格式正确的 UUID。拒绝不在允许范围内的版本,以及比你能容忍的时钟偏差更超前的时间戳。
  • 冲突就是冲突,绝不能覆盖。 ID 会出现在 URL 中,因此客户端可能发送一个并非自己生成的 ID。使用 on conflict (id) do update 会重写别人的行,而且是在别人的账户中重写。改用 on conflict (id) do nothing 插入;如果没有返回任何行,就带着调用者的 account_id 查询该 ID。找到意味着这是重试:返回那一行。找不到意味着 ID 被别人持有:拒绝,并且错误消息不要暴露它属于谁。
动手验证 · lab 12-keys
select lab.prove('a UUIDv7 minted on a clock five years fast sorts after every id minted today',
  uuidv7(interval '5 years') > uuidv7()
  and uuid_extract_timestamp(uuidv7(interval '5 years')) > now() + interval '4 years');
select lab.prove('ids synced a week late split pages mid-index: leaves end up at least 10 points less full',
  (select avg_leaf_density from pgstatindex('v7_late_pkey'))
    < (select avg_leaf_density from pgstatindex('v7_ontime_pkey')) - 10);

完整实验脚本

深入阅读:写入另一个账户的插入或更新(upsert)

账户 1 拥有一条笔记。账户 2 通过同步端点通常一开始就执行的插入或更新(upsert),发送了一行具有同一 ID 的数据;这个 ID 是它从 URL 中看到的:

insert into notes
values ('01a10f20-21b7-71bf-bbef-258ac7147265', 2, 'written by account 2')
on conflict (id) do update set body = excluded.body;

行中的 account_id = 1 仍然没有改变,但它的 body 已被账户 2 的内容覆盖。没有任何操作失败,因此也没有记录日志。使用 do nothing 时,插入不会返回行,笔记保持不变,而在账户 2 下进行的后续查询找不到这条笔记,这就是拒绝请求的信号。

安全的同步插入完整写法如下:

insert into notes (id, account_id, body) values ($1, $2, $3)
on conflict (id) do nothing
returning id;
-- no row back: select * from notes where id = $1 and account_id = $2
-- found: a retry, return it; not found: reject without saying whose it is
动手验证 · lab 12-keys
select lab.prove('on conflict do update with a client-sent id rewrites a row in another account',
  (select account_id = 1 and body = 'written by account 2' from notes));
select lab.prove('on conflict do nothing inserts nothing, and the caller''s account holds no row with that id',
  :note_inserted = 0
  and (select body = 'account 1''s note' from notes)
  and not exists (select 1 from notes
                  where id = '01a10f20-21b7-71bf-bbef-258ac7147265' and account_id = 2));

完整实验脚本

永远不要发放计数器

大多数脚手架都会把主键放进 URL。教程生成 /invoices/10442,这会告诉任何看到它的人一些你原本没打算透露的信息。顺序 ID 是一个计数器,而计数器会回答一些问题:有多少、增长多快、下一个是什么。

把计数器留给连接。给世界另外的东西。

计数器是在邀请攻击

把 URL 中的一位数字改掉,看看返回什么。这就是全部攻击,而且它有一个名字:不安全的直接对象引用(IDOR),也就是端点加载传入的任意 ID,却不检查调用者是否有权看到它。使用顺序 ID 时,攻击者不需要猜。他只需计数:10443、10444,然后循环遍历剩余 ID。

修复办法不是换一个 ID,而是每次查询都检查授权(where account_id = $1 and id = $2),或者使用行级安全替你加上检查。OWASP 的指导很直接:不可猜的 ID 是纵深防御,而无论如何都必须有访问控制。

那为什么还要做?因为纵深防御是真实存在的。两百个端点中漏掉一个检查,是普通的 bug。使用顺序 ID 时,这个 bug 到下午结束就能泄露整张表。使用不可猜的 ID 时,它只会泄露那些已经出现在日志和截图中的 ID。

ID 不是密码

ID 会进入浏览器历史、分析系统和支持工单。对于“拿到链接的任何人都能访问”的分享场景,发放一个带有作用域和过期时间的独立随机令牌,并像凭证一样检查它。

五个 ID 就能泄露总量

第二次世界大战期间,盟军统计学家根据缴获坦克上的序列号估算德国坦克产量。传统情报认为每月约 1,400 辆。序列号给出的数字是 246。战后找到的生产记录是 245(德国坦克问题)。

估算器只有一行:看到 k 个 ID,其中最大值是 m,就猜 m + m/k - 1。账户 42 收到带有事件 ID 的 webhook,并保留了五个:

with seen as (
  select id from events where account_id = 42 order by md5(id::text) limit 5
)
select array_agg(id order by id)                         as seen,
       round(max(id) + max(id)::numeric / count(*) - 1) as estimate,
       (select count(*) from events)                     as actual
from seen;
                  seen                  | estimate | actual
----------------------------------------+----------+---------
 {183289,377266,464367,1188068,1632355} |  1958825 | 2000000

来自一个客户的五个 ID,就能把整个服务平台的事件量估算到约 2% 以内(1,958,825 对 2,000,000)。如果拿到他们自己的全部 2,084 个 ID,误差会在 0.1% 以内。

动手验证 · lab 12-keys
select lab.prove('five event ids seen by one customer estimate the table''s 2,000,000 rows within 5 percent',
  (with seen as (select id from events where account_id = 42 order by md5(id::text) limit 5)
   select abs(max(id) + max(id)::numeric / count(*) - 1 - 2000000) / 2000000 < 0.05 from seen));
select lab.prove('all 2,084 of account 42''s event ids estimate it within 0.1 percent',
  (select count(*) = 2084
          and abs(max(id) + max(id)::numeric / count(*) - 1 - 2000000) / 2000000 < 0.001
   from events where account_id = 42));

完整实验脚本

两个 ID 就能泄露增长速度

一个 ID 是数量。两个相隔已知时间的 ID 就是增长速度:今天注册一个用户,下周再注册一个用户,减去用户 ID。在本书的事件表上,这个结果是精确的:

select (select min(id) from events where created_at >= '2026-09-08')
     - (select min(id) from events where created_at >= '2026-09-01') as id_gap,
       (select count(*) from events
        where created_at >= '2026-09-01' and created_at < '2026-09-08') as actual;
 id_gap | actual
--------+--------
  38356 |  38356

每月重复一次,你就有了别人的增长曲线。有时这无关紧要,有时这正是竞争对手想知道的事情。

动手验证 · lab 12-keys
select lab.prove('the gap between two event ids a week apart is exactly the number of events created that week',
  (select min(id) from events where created_at >= '2026-09-08')
  - (select min(id) from events where created_at >= '2026-09-01')
  = (select count(*) from events where created_at >= '2026-09-01' and created_at < '2026-09-08'));

完整实验脚本

计数器会在不同环境之间冲突

每个环境都有一个项目 1234,因此关于它的 bug 报告没有说明到底是哪一个。合并两个数据库意味着给每个键及其引用重新编号(按租户路由,永远不要按 ID)。离线客户端无法生成 ID。而且 42 既可以是项目 ID、用户 ID,也可以是发票 ID,因此错误的那个会返回错误的行,而不是报错。

每种 ID 格式都在顺序和泄露内容之间做权衡

格式按时间排序泄露内容存储为
标识列按插入顺序数量、速率bigint
UUIDv4否无uuid
UUIDv7是创建时间uuid
ULID是(毫秒)创建时间uuid
KSUID是(秒)创建时间bytea
Snowflake大致是时间、机器bigint
NanoID否无text
TypeID是创建时间uuid
Sqids否数量(如果解码)bigint
表 13-3 每种 ID 格式都在顺序和泄露内容之间做权衡

按时间排序的 ID,插入时表现得像序列;随机 ID,插入时表现得像 v4。根据你能承受泄露的内容来选择。

深入阅读:简述每种格式

截至 2026 年 10 月的详情。

UUIDv4 隐藏创建时间,但 WAL 是 3.8 倍

122 个随机位。作为主键,它就是上面测得的 3.8 倍 WAL;作为键旁边的公开 ID,它可以隐藏创建时间。URL 中占 36 个字符,base32 中占 26 个字符。

UUIDv7 是默认选择,而且会泄露创建时间

对于任何必须在一个数据库之外保持唯一的新 ID,这是默认选择。任何持有它的人都能读出创建时间,因此用户的 ID 会说明他何时注册。固定的 uuidv7(interval ...) 偏移什么也隐藏不了,而每行使用一个随机偏移,则会破坏你选择 v7 的顺序性。

ULID 与 uuid 列逐字节匹配

ULID spec 采用 v7 的形状(48 位的毫秒时间戳、80 个随机位),没有版本位,写成 26 个 Crockford base32 字符。它与 uuid 列逐字节匹配,而实验中的 200,000 个 ULID 形状值让叶子页保持 90% 的填充度。添加原生类型的扩展来自第三方:先审查它们。

KSUID 对 uuid 来说太宽

KSUID 是 160 位(32 位秒数,然后是 128 个随机位),对于 uuid 太宽:存为 bytea,或者存为在 C 排序规则下比较的文本,因为 base62 需要把大写排在小写之前。

Snowflake ID 需要每个写入者都有唯一的机器 ID

Twitter 的原始 Snowflake 把 41 位毫秒时间戳、10 位机器 ID 和 12 位序列打包进一个 bigint。每个写入者都需要唯一的机器 ID,而 JavaScript 在 2 的 53 次方以上会丢失精度,因此 API 会把这些值作为字符串发送。高位携带分片信息的变体见按租户路由,永远不要按 ID。

NanoID 的长度就是它的冲突预算

NanoID 是 21 个 URL 安全的随机字符,存为 text。长度就是你的冲突预算:根据生日界限,8 个字符在约 750 个 ID 后达到十亿分之一的碰撞概率,而 21 个字符要到 410 万亿个 ID。适合邀请代码和短链接,放在唯一索引后面;不适合作为键。

前缀让 ID 说明自己的类型

前缀会标出类型(cus_、prj_)。人可以看出 ID 是什么;把客户 ID 粘贴到账户 ID 应在的位置,会一眼被发现;扫描器也可以匹配 sk_live_,捕捉泄露的密钥(Stripe 的说明)。TypeID spec(0.3.0)对其进行了标准化:小写前缀、下划线,以及 26 个小写 Crockford base32 字符组成的 UUIDv7。

Sqids 和 Hashids 会解码回计数器

Sqids 把整数转换成短字符串,也能转换回来。该项目明确说明它不是加密;一旦解码,计数器就再次泄露。

用 bigint 连接,发布 uuid

两列:

  • 键是 bigint generated always as identity,紧凑,连接成本低。如果 ID 必须在数据库之外生成,而且其他行会在它到达之前指向它,就把键改成 uuidv7()(数据库不总能生成 ID)。
  • 公开 ID 是一个独立的 uuid,凡是其中的行会出现在 URL、API 或 webhook 中的表,都默认使用 uuidv7()。应用用类型前缀渲染它,例如 prj_01j6b7yh69fq2vyabwvmba4nr5,再把它解析回来。
create table projects (
  id          bigint generated always as identity primary key, -- joins
  public_id   uuid not null default uuidv7() unique,           -- URLs, APIs
  account_id  bigint not null references accounts (id),
  ...
);

连接仍然只需 8 字节,公开 ID 只需一个按顺序建立的索引,而且以后可以改变它的格式,不必触碰外键。创建时间敏感时,公开 ID 使用 v4。只有管理员使用的表不需要公开 ID;每个项目的 issue 编号则没问题:它们限定在租户范围内,只统计租户已经知道的内容。

在应用中编码;报告可以交给 SQL

在应用中编码,因为大多数语言都有 TypeID 库。对于视图或报告,可以用两个短 SQL 函数完成:b32_encode(uuid) 返回 26 个小写 base32 字符,b32_decode(text) 把它们转回 uuid;如果字符串格式错误,则返回 null。两者都是 immutable。

深入阅读:b32_encode 和 b32_decode

编码器先给 128 位前面加上两个零位,变成 130 位,然后每次读取 5 位:

create function b32_encode(u uuid) returns text
language sql immutable strict parallel safe as $$
  select string_agg(
           substr('0123456789abcdefghjkmnpqrstvwxyz',
                  substring(b from i * 5 + 1 for 5)::bit(5)::int + 1, 1),
           '' order by i)
  from (select B'00' || ('x' || replace(u::text, '-', ''))::bit(128) as b) s,
       generate_series(0, 25) as i
$$;

create function b32_decode(t text) returns uuid
language sql immutable strict parallel safe as $$
  select case when t ~ '^[0-7][0-9a-hjkmnp-tv-z]{25}$' then
    (select (lpad(to_hex(substring(b from 3 for 64)::bigint), 16, '0')
          || lpad(to_hex(substring(b from 67 for 64)::bigint), 16, '0'))::uuid
     from (select string_agg(
                    (strpos('0123456789abcdefghjkmnpqrstvwxyz',
                            substr(t, i, 1)) - 1)::bit(5)::text,
                    '' order by i)::bit(130) as b
           from generate_series(1, 26) as i) s)
  end
$$;

它符合 TypeID 规范的测试向量;使用升序字母表和固定长度时,字符串的排序顺序与 UUID 完全相同。格式错误的输入会解码为 null,因此损坏的 URL 会变成 404,而不是 500。这并非没有代价:在列默认值中使用 b32_encode 插入 200,000 行大约需要 6 秒,而使用普通 uuidv7() 不到 1 秒。在写入热点路径上,应在应用中编码。

动手验证 · lab 12-keys
select lab.prove('b32_encode matches the TypeID spec''s test vectors',
  b32_encode('01890a5d-ac96-774b-bcce-b302099a8057') = '01h455vb4pex5vsknk084sn02q'
  and b32_encode('ffffffff-ffff-ffff-ffff-ffffffffffff') = '7zzzzzzzzzzzzzzzzzzzzzzzzz'
  and b32_encode('00000000-0000-0000-0000-000000000020') = '00000000000000000000000010');
select lab.prove('the encoding preserves sort order: base32 strings compare like the uuids they encode',
  (select bool_and((u < v) = (b32_encode(u) < b32_encode(v)))
   from (select gen_random_uuid() as u, gen_random_uuid() as v
         from generate_series(1, 50000)) x));
select lab.prove('garbage, uppercase, and out-of-range strings decode to null, not an error',
  b32_decode('not-an-id') is null
  and b32_decode('01ARZ3NDEKTSV4RRFFQ69G5FAV') is null
  and b32_decode('8zzzzzzzzzzzzzzzzzzzzzzzzz') is null);

完整实验脚本

存储 uuid,打印前缀

把完整的 prj_... 字符串作为 text 存储,每个值占 31 字节,而 uuid 只占 16 字节,还让唯一索引平白大了 57%。存储 uuid。写入时,检查 cus_ 前缀是否匹配端点(这种 ID 发送给 /projects 应该返回 404),去掉前缀,解码,再执行查询:

select id, name from projects
where public_id = b32_decode(substr('prj_01j6b7yh69fq2vyabwvmba4nr5', 5));

这是一次 3 页的索引扫描:b32_decode 是不可变函数,因此规划器会把它折叠成常量。把租户也加入同一个 where 子句。公开 ID 让行难以猜测;account_id 检查让越权读取变得不可能。

深入阅读:实测 text 和 uuid 的公开 ID
create table pid_text (id bigint generated always as identity primary key,
  public_id text not null unique default 'prj_' || b32_encode(uuidv7()));
create table pid_uuid (id bigint generated always as identity primary key,
  public_id uuid not null unique default uuidv7());
 text_bytes | uuid_bytes | text_index | uuid_index | text_heap | uuid_heap
------------+------------+------------+------------+-----------+-----------
         31 |         16 | 9728 kB    | 6184 kB    | 13 MB     | 10192 kB

两个索引的叶子都保持大约 90% 的填充度,因为编码保留了顺序。代价纯粹来自宽度,以及通过排序规则进行的文本比较。查询计划如下:

 Index Scan using projects_public_id_key on projects (actual rows=1.00 loops=1)
   Index Cond: (public_id = '0191967f-44c9-7dc5-bf29-7cdd16a25705'::uuid)
   Buffers: shared hit=3
动手验证 · lab 12-keys
select lab.prove('prj_ plus 26 characters takes 31 bytes in the row; the uuid takes 16',
  (select pg_column_size(public_id) from pid_text limit 1) = 31
  and (select pg_column_size(public_id) from pid_uuid limit 1) = 16);
select lab.prove('the text public id index is more than 40 percent bigger than the uuid one',
  pg_relation_size('pid_text_public_id_key') > 1.4 * pg_relation_size('pid_uuid_public_id_key'));

完整实验脚本

接受两种形式,让 API 脱离整数 ID

/projects/4242 已经发布了吗?要摆脱它,就是一次普通的扩展与收缩迁移。先添加没有默认值的 public_id uuid,再设置默认值 set default uuidv7(),让每个新行都得到一个 ID。接着用 uuidv7(created_at - clock_timestamp()) 分批回填旧行,让每个 ID 都嵌入自己的创建时间。然后添加并发唯一索引和 not null:

alter table projects add column public_id uuid;
alter table projects alter column public_id set default uuidv7();
update projects set public_id = uuidv7(created_at - clock_timestamp())
where id > 0 and id <= 5000 and public_id is null;  -- and so on, batch by batch
create unique index concurrently projects_public_id_key on projects (public_id);

在一段对外公布的弃用期内,应用同时接受两种形式,但只发出新形式;按客户端统计旧形式的使用次数;当次数归零时,停止接受整数。在此之前,授权检查会像过去一样保护你。

深入阅读:一步一步完成迁移
alter table projects add column public_id uuid;
-- the default first, so rows inserted during the backfill get an id too
alter table projects alter column public_id set default uuidv7();

do $$
declare
  lo bigint := 0;
  hi bigint;
begin
  select max(id) into hi from projects;
  while lo < hi loop
    update projects
    set    public_id = uuidv7(created_at - clock_timestamp())
    where  id > lo and id <= lo + 5000 and public_id is null;
    lo := lo + 5000;
    commit;
  end loop;
end $$;

create unique index concurrently projects_public_id_key on projects (public_id);
-- then set not null, through a validated check constraint

如果随列添加一个易变的默认值,就会重写整张表,所以要分开执行;单独执行 set default 只会修改系统目录,而且要先执行它,这样回填期间插入的行就不会出现 null。批次遵循沿主键走短批次回填;索引在回填之后建立,因为回填按键顺序写入 ID,而不是按时间顺序;not null 则先通过 CHECK。项目 4242 创建于 01:00:08.77786,变成了 prj_01j6b7yh69fq2vyabwvmba4nr5,其中嵌入了 01:00:08.777。因此每个创建日期都能从 ID 中读出;如果日期敏感,就使用普通的 uuidv7()。在应用中,全数字的 ref 会增加 legacy_id 指标,并按 id 查询;其他任何形式都会被解析并按 public_id 查询,而且始终把 account_id 放进 where。

动手验证 · lab 12-keys
select lab.prove('after the batched backfill every project has a public id, and they are unique',
  (select count(*) = 20000 and count(distinct public_id) = 20000 from projects));
select lab.prove('each backfilled id embeds its row''s created_at, to within a few milliseconds',
  (select max(abs(extract(epoch from uuid_extract_timestamp(public_id) - created_at))) < 0.05
   from projects));
select 'prj_' || b32_encode(public_id) as pid from projects where id = 4242 \gset
select lab.prove('looking up a project by its prefixed public id is one index scan of a few pages',
  lab.nodes(format($$ select id, name from projects where public_id = b32_decode(substr(%L, 5)) $$, :'pid'))
    @> array['Index Scan']
  and lab.buffers(format($$ select id, name from projects where public_id = b32_decode(substr(%L, 5)) $$, :'pid')) <= 4);

完整实验脚本

把租户放进键里

在多租户应用中,无论模式是否这样写,租户都是每个键的一部分。把它明确写出来。

让租户无处不在

在每张租户拥有的表上都放 account_id,即使通过连接也能推导出它。每行的 8 字节可以换来无需连接的过滤条件、以 account_id 开头的索引(让一个租户的行挨在一起)、一行就能写出的行级安全策略,以及一个已经无处不在的分片键(从第一天就为未来留门)。

让跨租户引用不可能发生

运行示例中有一个隐蔽漏洞:没有任何东西阻止账户 1 的项目把属于账户 296 的用户 295 指定为自己的 owner_id。一个有 bug 的端点写入这个值,之后信任该值的查询就会泄露跨租户数据。把租户放进外键:

alter table users
  add constraint users_account_id_id_key unique (account_id, id);
alter table projects
  add constraint projects_owner_same_account
  foreign key (account_id, owner_id) references users (account_id, id);

insert into projects (account_id, owner_id, name) values (1, 295, 'cross-tenant');
ERROR:  insert or update on table "projects" violates foreign key constraint
"projects_owner_same_account"
动手验证 · lab 12-keys
select lab.prove('with the composite foreign key, the cross-tenant owner is refused',
  lab.try($$ insert into projects (account_id, owner_id, name) values (1, 295, 'cross-tenant') $$)
    = '23503: insert or update on table "projects" violates foreign key constraint "projects_owner_same_account"');

完整实验脚本

额外的唯一约束看起来多余,因为单独的 id 已经唯一,但正是它让外键能够检查两列。为每张被引用表保留一个索引,是多租户系统可以买到的最便宜的保险之一;即使你删除了表上的其他外键,也值得保留它(在客户能看到孤儿时保留外键)。

本章要点

  • 使用代理主键 bigint generated always as identity;自然键变成 unique 约束。绝不要依赖序列无间隔或按提交顺序排列。
  • 在定期检查点下,随机 UUIDv4 键产生的 WAL 是 UUIDv7 的 3.8 倍(每百万行 551 MB 对 143 MB),脏缓冲区是 8 倍。
  • 需要 UUID 时,使用 uuidv7(),并存为 uuid。它的插入表现得像序列,而且会泄露创建时间。
  • 当某些东西必须在数据库生成 ID 之前知道它时,标识列就不够用了:离线客户端、乐观 UI、一次请求中构建的图、多个写入者。可以在 bigint 键旁接受客户端 ID,或者在引用跨越边界时把键设为 UUIDv7。
  • 把客户端 UUIDv7 当作输入:保留服务器的 created_at,验证 ID,绝不让该 ID 上的冲突更新另一个账户的行。
  • 永远不要把计数器放进 URL:五个 ID 就能把 2,000,000 行的总量估算到约 2% 以内;两个相隔一周的 ID 能给出精确的周总量。
  • 用 bigint 连接;发布单独的 uuidv7() 公开 ID,以 prj_ 加 base32 的形式渲染,并存储为 uuid。这是纵深防御;每次查询上的授权检查仍然是修复办法。
  • 在每张租户表上放 account_id,让索引以它开头,并使用复合外键,让跨租户引用不可能发生,即使你删除了表上的其他外键。

延伸阅读

表格阅读