# Postgres 不是 MySQL
> 两个数据库对行存放在哪里、旧版本去哪里做了相反的选择。了解由此产生的差异,以及需要改掉的习惯。
---
LLMS 索引: [llms.txt](/llms.txt)
---
下面是一个包含四条语句的事务。它先插入一行,再插入一行违反唯一约束的重复行,然后插入另一行,最后提交。在 MySQL 和 Postgres 上分别运行它,再看看之后表里有什么。
```sql
begin; -- "start transaction" on MySQL
insert into users (account_id, email, name)
values (1, 'new1@example.com', 'New One');
insert into users (account_id, email, name)
values (1, 'user1000@example.com', 'Dup');
insert into users (account_id, email, name)
values (1, 'new2@example.com', 'New Two');
commit;
select id, email from users where email like 'new%' order by id;
```
MySQL 8.4 保留两行。PostgreSQL 18 一行也不保留。
```text
MySQL Postgres
+--------+------------------+ id | email
| id | email | ----+-------
+--------+------------------+ (0 rows)
| 131071 | new1@example.com |
| 131073 | new2@example.com |
+--------+------------------+
```
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> prove 'MySQL 8.4 keeps two rows (the duplicate rolled back only itself)' \
> [ "$(my -e "select count(*) from users where email like 'new%'")" = 2 ]
> prove 'Postgres turns the commit into a rollback' has "$pg_out" "ROLLBACK"
> prove 'PostgreSQL 18 keeps none' [ "$(pg -c "select count(*) from users where email like 'new%'")" = 0 ]
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
谁也没有错。它们是两台碰巧说着相似 SQL 的不同机器。MySQL(使用 InnoDB,这正是今天大家说 MySQL 时所指的东西)和 Postgres 对两个问题做了相反的选择:**一行存在哪里**,以及**修改一行时,旧版本要去哪里**。你感受到的几乎所有差异都由这两个选择推导而来;看懂另一种设计,是理解当前设计最快的方法。
每个例子都在 MySQL 8.4.11 和 PostgreSQL 18.6 上运行,两边使用默认设置,并加载了相同的数据。
## 行和旧版本存放在哪里决定了一切 {#where-rows-and-old-versions-live-decides-the-rest}
| 问题 | Postgres | MySQL(InnoDB) |
|---|---|---|
| 一行存在哪里? | 堆中:任何有空间的页 | 主键 B-树中,按键排序 |
| 索引指向什么? | 物理地址(`ctid`) | 主键值 |
| 旧版本去哪里? | 作为死元组留在表中 | 表外的撤销日志 |
| 谁来清理? | 清理 | 清理线程 |
| 页大小 | 8 KB | 16 KB |
**Table 11-1.** 行和旧版本存放在哪里决定了一切
主键选择、更新成本、膨胀,以及长事务会带来的后果,都源自表格的前四行。
## 在 InnoDB 中,表就是主键 {#the-table-is-the-primary-key-in-innodb}
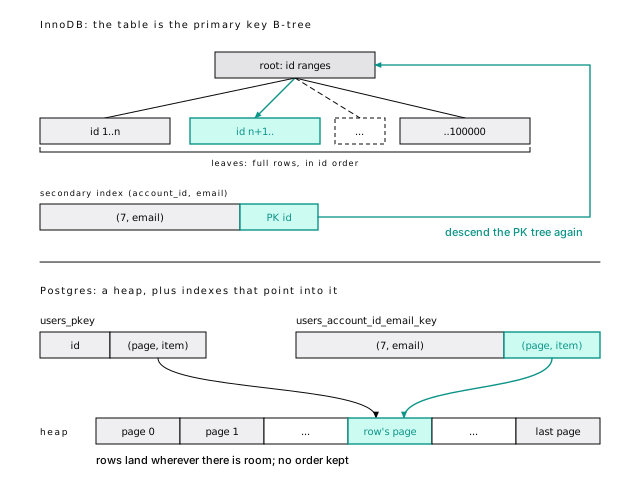
在 InnoDB 中,表**就是**一棵按主键排序的 B-树,完整的行存放在叶子中:这就是**聚簇索引**。可以把它想成一本字典:词条按顺序排列,词条本身就是这本书。Postgres 更像一座图书馆:书放到任何有空间的书架上(**堆**),而每个索引,包括主键索引在内,都是指向书架地址 `ctid` 的卡片目录([一切都从页说起](/04-storage/#basics-chapter-4))。
**图 11-1.** InnoDB 按键查找行,Postgres 按地址查找行。在 InnoDB 中,表就是主键 B\-树,因此二级索引条目保存主键,通过它找到的每一行都要再次沿着这棵树向下查找。在 Postgres 中,每个索引,包括主键索引在内,都直接指向堆中的一个页。
### 在 InnoDB 中,二级索引查找要下探两次 {#secondary-lookups-cost-two-descents-in-innodb}
InnoDB 的二级索引条目保存的是**主键值**,不是地址,因此通过它找到的每一行都要再次下探主键树。我们在 MySQL 上统计页请求(`Innodb_buffer_pool_read_requests`),在 Postgres 上统计缓冲区:
| 查询(100 行) | MySQL 页请求 | Postgres 缓冲区 |
|---|---|---|
| 主键范围,`id between 5000 and 5099` | 15 | 7 |
| 二级索引查找,`account_id = 7` | 307 | 106 |
**Table 11-2.** 在 InnoDB 中,二级索引查找要下探两次
**InnoDB 在通过二级索引读取时付出代价;Postgres 则如你马上会看到的,在写入时付出代价。** 而 Postgres 这次 7 个缓冲区的范围扫描,还是插入顺序带来的偶然结果:我们的行按 id 顺序插入(`pg_stats.correlation` 中 `id` 的值为 1)。在 InnoDB 中,相邻的键总是物理相邻;在 Postgres 中,只有你按这种方式插入时才是如此。
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> my_range=$(my_pages "select * from users where id between 5000 and 5099")
> my_sec=$(my_pages "select * from users where account_id = 7")
> pg_sec=$(pg -c "select lab.buffers('select * from users where account_id = 7')")
> prove 'InnoDB primary key range scan of 100 rows: about 15 page requests' between "$my_range" 8 30
> prove 'InnoDB secondary lookup of 100 rows: about 307 page requests, about 3 per row' between "$my_sec" 250 400
> prove 'Postgres pays roughly one buffer per row (about 106)' between "$pg_sec" 95 115
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
> [!DETAILS]- 深入阅读:CLUSTER 只做一次,而且会逐渐失效
>
> Postgres 有一个 `CLUSTER` 命令,它的名字会误导 MySQL 老用户。它会在 `ACCESS EXCLUSIVE` 锁下,按某个索引的顺序重写表一次,然后就不再管它。执行 `cluster users using users_account_id_email_key` 后,账户 7 的 100 个用户从 106 个缓冲区降到 6 个;主键范围扫描从 7 个变成 102 个(表只能按一种顺序排列);账户 7 的五个新用户则落在堆的末尾 `(1123,58)`,离第 6 页上的同伴很远。只在批量加载后、基本只读的表上偶尔使用它,绝不要把它安排成定期维护。
>
> > [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
> >
> > ```bash
> > prove 'after CLUSTER, account 7 costs a handful of buffers (from about 106)' between "$cl_after" 4 15
> > prove 'after CLUSTER, the primary key range scan costs about 102 buffers (from 7)' between "$cl_range" 95 115
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
>
> 在 MySQL 一侧,列类型会改变范围扫描数字:`name` 使用 `TEXT` 而不是 `varchar(255)` 时,同样的扫描大约需要 107 个页请求,因为 InnoDB 不再批量提取行。
### 在 InnoDB 中,覆盖索引几乎是免费得到的 {#covering-indexes-come-for-free-in-innodb-almost}
每个 InnoDB 二级索引都带有主键,因此 `select id, email from users where account_id = 7` 从不接触表:只需 15 个页请求。Postgres 的索引不带主键,所以同一查询会访问 100 个堆页。建立 `(account_id) include (id, email)` 索引,让清理把页标记为全可见,成本就会降到 7 个缓冲区([覆盖索引:覆盖热点查询,而不是每个查询](/17-btree/#covering-indexes-cover-the-hot-query-not-every-query))。
### 递增键仍然重要;短键大多不重要 {#increasing-keys-still-matter-short-ones-mostly-dont}
在 InnoDB 上,主键**就是**物理布局,所以 MySQL 团队会保持键短小且递增。在 Postgres 上,堆不在意这些,其他索引无论键多宽都只保存 6 字节的 `ctid`;只有主键索引会感受到随机键([慎选键,少后悔](/13-keys/#basics-chapter-13))。“递增”仍然重要;“短小”则没那么重要,其他表的外键列除外,因为它们会把键复制到每个引用行及其索引中。
> [!NOTE] 保留的习惯,舍弃的习惯
>
> 保留:递增键(identity 或 UUIDv7)。舍弃:“表按主键排序,所以对它做范围扫描很便宜”;请检查 `pg_stats.correlation`。还要舍弃:“只要列不变,额外索引就很便宜”。下一节会解释原因。
## 一次更新,要么写一行,要么写每个索引 {#an-update-writes-one-row-or-every-index}
Postgres 更新时会在新的 `ctid` 上写入一个完整的新行版本;除非这是 HOT 更新(没有索引列发生变化,而且页上有空间),否则每个索引都会得到一个新条目,包括没有发生变化的列上的索引([冷更新会为每个索引付出代价](/07-hot/#a-cold-update-pays-for-every-index))。InnoDB 会原地更新行,把更新前的镜像复制到撤销日志中,并且只触碰列发生变化的二级索引。其余索引指向没有移动的主键。
```text
UPDATE users SET email = ... WHERE id = 100000
Postgres InnoDB
-------- ------
heap: new full row version clustered leaf: row changed
at a new ctid; old one in place; trx id and
gets xmax roll pointer updated
users_pkey: NEW entry undo log: before-image of
(id did not change!) the changed column
unique (account_id, email): secondary (account_id, email):
NEW entry old entry delete-marked,
new entry inserted
any other index: NEW entry any other index: untouched
WAL: all of the above redo log: all of the above
binlog: row event, before
and after images
UPDATE users SET name = ... (no indexed column, page has room)
Postgres: HOT. New version on the InnoDB: in place plus undo;
same page, no index touched. no index touched.
```
回读 WAL 可以确认左栏内容:名称变化是一条 86 字节的 `HOT_UPDATE`,而电子邮件变化是一次堆 `UPDATE` 加两次索引插入,其中一次插入了 `users_pkey`。MySQL 会再写一份自己的副本:名称更新让二进制日志增长了 414 字节,电子邮件更新增长了 422 字节;这两次都包含完整的更新前和更新后镜像,而且还要叠加重做日志。
> [!DETAILS]- 深入阅读:图表背后的 WAL 记录
>
> ```text
> upd | resource_manager | record_type | record_length | fpi_length
> -------+------------------+-------------+---------------+------------
> name | Heap | HOT_UPDATE | 86 | 0
> email | Heap | UPDATE | 106 | 0
> email | Btree | INSERT_LEAF | 64 | 0
> email | Btree | INSERT_LEAF | 88 | 0
> ```
>
> 两行都位于表的最后一页,而那一页有空闲空间;刚加载完的表中其他每一页都已填满,因此其中的更新无法成为 HOT。二进制日志大小来自更新前后执行 `show binary log status` 的结果。
>
> > [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
> >
> > ```bash
> > prove 'the name change is one HOT_UPDATE record' [ "$(cut -d'|' -f1 <<<"$w_out")" = 1 ]
> > prove 'plus two index inserts: the unique index and users_pkey, whose column did not change' \
> > [ "$(cut -d'|' -f4 <<<"$w_out")" = 2 ]
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
### 两种设计都会在某处为写入付出代价 {#each-design-pays-for-writes-somewhere}
那么,哪种设计写得更少?这取决于你的负载;不问索引情况就给出答案的人,都是在推销某种东西。对于有很多索引、更新又无法使用 HOT 的表,Postgres 会在写入和清理时付出代价,因为死版本会一直留在表及其索引中,直到清理完成。InnoDB 会在通过二级索引读取时付出代价,并在每次更新时写撤销日志。对 Postgres 来说,实践上的教训是:保护 HOT([HOT 是一次性做出的设计决定](/07-hot/#hot-is-a-design-decision-you-make-once))。
### Uber 遇到了这种不对称,而双方都有道理 {#uber-hit-this-asymmetry-and-both-sides-were-right}
2016 年 7 月,Uber 发布了 [Why Uber Engineering Switched from Postgres to MySQL](https://www.uber.com/us/en/blog/postgres-to-mysql-migration/)。它的核心抱怨正是这种不对称:它们的更新触碰了索引列,因此每次更新都会在每个索引中写入条目;而且因为 Postgres 复制发送的是物理 WAL,所有这些内容都会跨网络传给每个副本。多年后的公平解读是:随后争论的双方针对不同负载都说对了一部分;在需要换数据库之前,你可以先重塑大多数遇到最坏情况的表。
> [!DETAILS]- 深入阅读:针对 Uber 的回应说对了什么
>
> 那篇文章还提到了副本查询取消、9.2 版本的复制 bug、痛苦的重大升级,以及每个连接一个进程。Markus Winand [指出](https://use-the-index-luke.com/blog/2016-07-29/on-ubers-choice-of-databases),InnoDB 把成本转移到了读取上,而 Uber 的负载(在数据库之上自建的一层键值层)很不寻常。长期担任 Postgres 提交者的 Robert Haas [承认](http://rhaas.blogspot.com/2016/08/ubers-move-away-from-postgresql.html),写放大确实存在,而且内置逻辑复制是必要的。Simon Riggs [指出](https://www.enterprisedb.com/blog/thoughts-ubers-list-postgres-limitations),逻辑复制在 PostgreSQL 10 中到来,事实也确实如此。
## 旧版本留在表中,或留在撤销日志里 {#old-versions-live-in-the-table-or-in-undo}
两个数据库都使用 MVCC,因此读取者看到的是快照时刻的行,而写入者可以同时修改它。Postgres 把旧版本作为死元组**留在表中**,这让回滚立即完成,却把账单留给[清理](/10-vacuum/#basics-chapter-10)。InnoDB 把当前版本保留在表中,把旧版本放进**撤销日志**;需要旧版本的读取者会沿着撤销链向回走,而后台的**清理**线程会在没有快照需要它们后丢弃撤销内容。
Purge(清理)是 InnoDB 对应的清理机制,而大多数 MySQL 用户从来不用思考它。把 Postgres 的清理也当成同一种东西,是 MySQL 团队在第一年使用 Postgres 时会犯的代价最高的错误。而且 Postgres 的清理还有一项 Purge 没有的工作:冻结旧行,让 32 位事务计数器安全回卷。InnoDB 的 48 位 ID 在实践中永远不会回卷,因此**回卷**没有对应的 MySQL 概念([回卷会在任何内容损坏前停止写入](/10-vacuum/#wraparound-stops-writes-before-anything-is-corrupted))。
### 长事务会伤害两者 {#long-transactions-hurt-both}
我们在一个会话中保持快照打开,同时让另一个会话执行 5,000 次单行更新。在 InnoDB 上,历史列表长度(等待清理的撤销日志)从 2 增长到 5,000;快照结束后,后台清理跟上进度,列表就排空了(每次运行可能从 1 秒到超过 1 分钟)。在 Postgres 上,清理报告有 5,000 个版本[“已死亡但尚不可移除”](/06-mvcc/#long-transactions-hold-everything-back)。InnoDB 的问题是撤销表空间增长,以及版本链越长读取越慢;Postgres 的问题是比事务活得更久的膨胀。解决办法相同:保持事务短小。(在 MySQL 上,历史列表长度来自 `information_schema.innodb_metrics`。)
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> prove 'with a snapshot open, 5,000 updates leave about 5,000 undo logs waiting for purge' between "$hll_open" 4900 5100
> prove 'once the snapshot ends, purge starts clearing them: under half are left within two minutes' [ "$hll_after" -lt $((hll_open / 2)) ]
> prove 'Postgres vacuum reports the 5,000 old versions as "dead but not yet removable"' \
> has "$v_out" "5000 are dead but not yet removable"
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
## MySQL 默认使用可重复读;Postgres 不是 {#mysql-defaults-to-repeatable-read-postgres-doesnt}
MySQL 默认是 `REPEATABLE-READ`,Postgres 默认是 `read committed`,在两者之间迁移的代码会悄悄改变含义。会话 A 读取用户 10,暂停,然后再次读取;与此同时会话 B 重命名用户并提交:
```text
first read second read
MySQL User 10 User 10
Postgres User 10 Changed
```
一个依赖 MySQL 稳定快照的多语句报表,在 Postgres 上会看到不断移动的目标;给它使用 `begin isolation level repeatable read`。反过来,读—改—写也会带来意外:读取一行,在应用中计算新值,再写回去。在可重复读隔离级别下,如果另一个会话在你的快照之后修改并提交了这一行,Postgres 会用串行化错误(`40001`)拒绝你的写入,你需要重试。InnoDB 的可重复读隔离级别则会在最新提交的版本之上写入,因此你根据旧快照计算出的值会悄悄覆盖另一个会话的提交。普通的 `update ... set n = n + 1` 在两者上都是安全的,因为 InnoDB 的更新会读取最新版本。[只有可串行化隔离能排除所有异常](/09-acid/#only-serializable-rules-out-every-anomaly)给出了完整矩阵,[Hermitage](https://github.com/ept/hermitage) 套件则记录了两种行为。
> [!DETAILS]- 深入阅读:InnoDB 丢掉更新,Postgres 拒绝更新
>
> 在 MySQL 的可重复读隔离级别下,会话 A 把用户 11 的姓名读入变量,暂停,然后把姓名追加 ` +A` 后写回。同时,会话 B 把用户重命名为 `B` 并提交。A 的写入成功且没有报错,行最后变成 `User 11 +A`,B 已提交的重命名消失了。在 Postgres 上采取同样的步骤(A 读取行,B 提交更新,A 更新行),A 的更新会失败,并提示 `could not serialize access due to concurrent update`。
>
> > [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
> >
> > ```bash
> > prove 'MySQL 8.4 defaults to REPEATABLE-READ' [ "$(my -e 'select @@transaction_isolation')" = REPEATABLE-READ ]
> > prove 'Postgres defaults to read committed' [ "$(pg -c 'show transaction_isolation')" = "read committed" ]
> > prove 'Postgres read committed: the second read sees the rename' [ "$(tr '\n' '|' <<<"$lk_out")" = "User 10|Changed|" ]
> > prove 'Postgres repeatable read: the second writer fails with a serialization error' \
> > has "$rr_out" "could not serialize access due to concurrent update"
> > prove "and B's committed update is lost (the row ends up 'User 11 +A')" \
> > [ "$(my -e 'select name from users where id = 11')" = "User 11 +A" ]
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
### 你只能锁住已经存在的行 {#you-can-only-lock-a-row-that-exists}
为了防止[幻读](/43-glossary/#anomaly),InnoDB 会锁住锁定读取所扫描的**索引条目之间的间隙**,而不只是它找到的行。会话 A 使用 `for update` 查询一个不存在的用户;会话 B 插入另一个*不存在的*用户,却超时并得到 `ERROR 1205`,因为被 A 的 `X,GAP` 锁阻塞。
在 Postgres 上,会话 B 的插入立即成功。行锁位于元组首部,因此你只能锁住已经存在的行。这样消除了一类 InnoDB 死锁,也意味着,要阻止两个会话创建同一个缺失的行,需要唯一约束、`on conflict` 或可串行化隔离。
> [!DETAILS]- 深入阅读:InnoDB 会锁住不存在的行
>
> `performance_schema.data_locks` 显示 A 的锁,就在下一个真实条目 `8, 'user10007@example.com', 10007` 之前。最后那个值是主键,存储在二级索引条目中,正如图中所示。
>
> ```sql
> -- MySQL 8.4, session A
> start transaction;
> select id from users where account_id = 7 and email = 'zzz@example.com' for update;
> -- session B
> insert into users (account_id, email, name) values (7, 'yyy@example.com', 'Gap');
> ```
>
> > [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
> >
> > ```bash
> > prove 'MySQL session B waits for a different, nonexistent row and times out (1205)' \
> > has "$gap_err" "ERROR 1205 (HY000)"
> > prove 'on Postgres the same insert succeeds at once: no gap locks' [ "$gap_pg" = 1 ]
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
### 错误会中止整个事务 {#errors-abort-the-whole-transaction}
回到开头。在 MySQL 中,失败的语句只回滚自己,事务继续进行。在 Postgres 中,**任何错误都会中止整个事务**:后续语句会得到 `current transaction is aborted, commands ignored until end of transaction block`,而 `commit` 会返回 `ROLLBACK`。
这会破坏最常见的迁移模式:“尝试插入,捕获重复错误,继续执行”。使用 `on conflict do nothing` 并检查是否返回了行,或者使用保存点([保存点可以把损失控制在局部](/25-concurrency/#savepoints-contain-the-damage))。
> [!TIP] 你的 ORM 可能已经在做这件事
>
> 有些框架会把每个请求或测试包在事务中。在 Postgres 上,其中被吞掉的一个错误会毒化后面的所有操作,而你最终看到的错误会指向错误的语句。要找事务中的第一个错误,不要只看最后一个。
## 进程比线程更早变得昂贵 {#processes-get-expensive-sooner-than-threads}
Postgres 为每个连接派生一个进程;MySQL 为每个连接运行一个线程。两者在连接数达到几千时都会变得昂贵,但 Postgres 更早:每个后端进程都保留自己的缓存,而且每个快照都会查看其他每个会话。如果你的集群向 MySQL 直接打开了 2,000 个连接,就应该在 Postgres 前面放一个连接池,并按 CPU 核心和磁盘数量来确定真实连接数([连接并非免费](/28-connections/#basics-chapter-28))。
## 一份日志,而不是两份 {#one-log-not-two}
Postgres 只有一份日志,即 WAL,负责崩溃恢复、副本和时间点恢复([先记日志,再写数据](/08-wal/#basics-chapter-8))。MySQL 有一份用于崩溃恢复的重做日志,以及一份用于复制的二进制日志,并通过内部两阶段提交保持两者一致。
更大的差异在于副本收到什么。MySQL 副本应用逻辑行事件,因此可以拥有额外的索引或更新的版本。Postgres 副本逐字节重放 WAL:它们是同一主版本上磁盘的副本,而不是数据的副本。重大升级要围绕 `pg_upgrade` 或[逻辑复制](/43-glossary/#logical-replication)规划,而不要通过提升一个更新版本的副本来完成。
## DDL 具有事务性 {#ddl-is-transactional}
在 Postgres 中,下面的操作不会留下痕迹:插入、表和列都会回滚。
```sql
begin;
insert into accounts (name) values ('Before DDL');
create table scratch (id int);
alter table users add column last_seen_at timestamptz;
rollback;
```
在 MySQL 中,DDL 以语句为单位具有原子性,但会隐式提交已经打开的事务。同样的序列会在表中留下账户 `1024 | Before DDL`:`create table` 提交了插入,而 `rollback` 没有任何东西可回滚。
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> prove 'Postgres rolls back the insert, the new table, and the new column' [ "$(tr '\n' '|' <<<"$ddl")" = "0|null|0|" ]
> prove "MySQL's create table committed the insert; rollback rolled back nothing (id 1024)" \
> [ "$(my -e "select id from accounts where name = 'Before DDL'")" = 1024 ]
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
两者的风险相同:模式变更会排在长查询后面,而后面的所有操作又会排在它后面。使用较短的 `lock_timeout` 并重试,迁移要保持小,因为事务性迁移会一直持有所有锁,直到提交([变更模式,服务照常](/26-migrations/#basics-chapter-26))。
## 小小的方言差异会不断累积 {#small-dialect-differences-add-up}
剩下的是 SQL 本身的一些小差异。它们加在一起,就是直接迁移的代码会在十几个地方无法通过测试的原因。
### 字符串按精确字符比较 {#strings-compare-exactly}
MySQL 8.4 的默认排序规则 `utf8mb4_0900_ai_ci` 不区分重音和大小写。Postgres 比较精确字符:`'abc' = 'ABC'`、`'Bob@x.com' = 'bob@x.com'` 和 `'resume' = 'résumé'` 在 MySQL 上都为真,在 Postgres 上都为假。这在唯一约束中影响最大。MySQL 会拒绝 `USER1000@Example.com`,认为它与 `user1000@example.com` 重复;Postgres 会接受它,于是一个账户有了两个“相同”电子邮件地址的用户。
在模式中为每一列决定相等意味着什么。对于电子邮件,通常的选择是对 `lower(email)` 建立唯一索引([索引恰好保存你交给它的东西](/17-btree/#an-index-stores-exactly-what-you-gave-it));`citext` 和 ICU 排序规则是替代方案([类型是一份契约](/12-types/#basics-chapter-12))。
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> prove "MySQL: 'abc' = 'ABC', 'Bob@x.com' = 'bob@x.com', 'resume' = 'résumé' are all true" \
> [ "$(my -e "select concat_ws(',', 'abc' = 'ABC', 'Bob@x.com' = 'bob@x.com', 'resume' = 'résumé')")" = "1,1,1" ]
> prove 'Postgres: all three are false' \
> [ "$(pg -c "select concat_ws(',', 'abc' = 'ABC', 'Bob@x.com' = 'bob@x.com', 'resume' = 'résumé')")" = "f,f,f" ]
> prove 'Postgres accepts it, and the opening transaction burned 100,001 and 100,002 (it gets 100,003)' \
> [ "$(pg -c "insert into users (account_id, email, name) values (1, 'USER1000@Example.com', 'Shouty') returning id")" = 100003 ]
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
### 是 identity,而不是 auto_increment {#identity-not-auto_increment}
`AUTO_INCREMENT` 对应 `generated always as identity`。两者都会在事务之外发放值,因此都会留下间隔。本章已经制造了一些间隔:MySQL 批量插入 100,000 个用户后,计数器到了 131,071(它会以不断增长的批次预留值),失败的重复插入消耗了 131,072;Postgres 回滚的事务消耗了 100,001 和 100,002。
永远不要用序列构造无间隔编号。`LAST_INSERT_ID()` 对应 `returning id`;批量加载显式 ID 后,使用 `setval` 重置序列([慎选键,少后悔](/13-keys/#basics-chapter-13))。
### 插入或更新(upsert)要指明冲突目标 {#upserts-name-their-conflict}
MySQL 的 `on duplicate key update` 会在与**任何**唯一索引发生冲突时触发;它自己的文档警告不要在拥有多个唯一索引的表上使用它。Postgres 要求你指明仲裁索引:
```sql
insert into users (account_id, email, name)
values (1, 'user1000@example.com', 'Renamed')
on conflict (account_id, email)
do update set name = excluded.name;
```
`excluded` 是你试图插入的行;省略冲突目标,Postgres 就会拒绝。`on conflict do nothing` 可以替代 `INSERT IGNORE`,又不会顺便忽略数据转换错误。Postgres 还有 SQL 标准的 `MERGE`(PostgreSQL 15+),MySQL 没有;但对单行“插入或更新”,优先使用 `on conflict`:它在并发下是原子的,而两个会话对同一个新键运行 `MERGE` 仍可能发生冲突([经得住数据增长的查询](/22-queries/#basics-chapter-22))。
### 整数除法会截断,NULL 排在最后 {#integer-division-truncates-and-nulls-sort-last}
| 表达式 | MySQL | Postgres |
|---|---|---|
| `7/2`、`3/5` | `3.5000`、`0.6000` | `3`、`0` |
| `1/0` | `NULL`,并给出警告 | 错误:`division by zero` |
| `'a' \|\| 'b'` | `0`(逻辑或) | `ab` |
| `order by x` 且 x 为 NULL | NULL 在前 | NULL 在后 |
**Table 11-3.** 整数除法会截断,NULL 排在最后
Postgres 中的整数除法会截断,因此在 MySQL 上为 0.6 的百分比在这里是 0;把一侧转换类型(`3::numeric / 5`)。
NULL 比所有值都大,因此按 `completed_at desc` 排序的“最新优先”列表会突然以所有未完成行开头。写上 `nulls last`,并在服务这个排序的任何索引中保持一致([sorting rows](https://www.postgresql.org/docs/18/queries-order.html))。
把 `concat()` 迁移为 `||` 时,有一条规则仍然成立:NULL 操作数会让整个结果变成 NULL,因此没有姓氏的人执行 `first_name || ' ' || last_name` 会得到 NULL。`concat_ws(' ', first_name, last_name)` 会跳过 NULL。反向迁移时也要小心:Postgres 自己的 `concat()` 会把 NULL 当作空字符串,这一点与 MySQL 不同。
> [!EXAMPLE]- 动手验证 · lab `10-not-mysql.sh`
>
> ```bash
> prove 'MySQL: 7/2 is 3.5000 and 3/5 is 0.6000' [ "$(my -e 'select concat_ws(",", 7/2, 3/5)')" = "3.5000,0.6000" ]
> prove 'Postgres: 7/2 is 3 and 3/5 is 0' [ "$(pg -c "select concat_ws(',', 7/2, 3/5)")" = "3,0" ]
> prove "MySQL: 'a' || 'b' is 0 (logical OR)" [ "$(head -1 <<<"$pipes")" = 0 ]
> prove 'MySQL sorts NULL first ascending' \
> [ "$(my -e 'select x from (select 1 as x union all select null union all select 3) t order by x' | tr '\n' ',')" = "NULL,1,3," ]
> prove 'Postgres sorts NULL last ascending' \
> [ "$(pg -c "select string_agg(coalesce(x::text, 'NULL'), ',' order by x) from (values (1), (null), (3)) t(x)")" = "1,3,NULL" ]
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/10-not-mysql.sh)
### 外键不会自动创建索引 {#foreign-keys-dont-index-themselves}
InnoDB 会为每个外键列创建索引。Postgres 在子表一侧什么也不创建:同一张 `projects` 表在 MySQL 上有 `account_id`、`owner_id` 和 `PRIMARY` 索引,在 Postgres 上却只有 `projects_pkey`。没有索引时,每次删除父行都会扫描子表([每次删除父行都会扫描整张子表](/14-relationships/#each-deleted-parent-scans-the-whole-child-table)),读取全部 2,000,000 个事件。除非你已经测量过并确认不需要,否则要为外键列建立索引。
### Postgres 修正估算,而不是采纳提示 {#postgres-fixes-estimates-instead-of-taking-hints}
MySQL 有 `/*+ ... */` 提示和 `FORCE INDEX`。核心 Postgres 遵循长期政策,不提供这些东西。规划器选错时,原因几乎总是估算错误;修复方法是提供更好的信息:`analyze`、更高的统计目标、扩展统计信息或重写查询([规划器也在估算](/20-planner/#basics-chapter-20))。`pg_hint_plan` 扩展可以在紧急情况下使用。
### 还有一些习惯不能迁移 {#a-few-more-habits-dont-transfer}
- **标识符会折叠为小写。** 双引号使其区分大小写(MySQL 使用反引号,并把双引号当作字符串)。创建为 `"Users"` 的表必须永远加引号。使用不加引号的 snake_case,并在第一次迁移前设置 ORM 的命名策略([identifiers](https://www.postgresql.org/docs/18/sql-syntax-lexical.html#SQL-SYNTAX-IDENTIFIERS))。
- **GROUP BY 就是它字面表达的含义,**和 MySQL 的 `ONLY_FULL_GROUP_BY` 一样:每个选出的列都必须被分组、聚合,或依赖于已分组的主键。若要“取组中的任意值”,PostgreSQL 16 增加了 `any_value()`。
- **用 jsonb,不用 json。** `jsonb` 是 MySQL 用户期待的二进制类型。Postgres 用[GIN](/43-glossary/#gin)为整个文档建立索引,并且每次更新都会重写整个行版本,因此要把快速变化的字段从大文档中移出去。
- **没有 `UPDATE ... LIMIT`。** 在子查询中先选出键。
- **类型。** 没有 `UNSIGNED`,有真正的 `boolean`,而 `DATETIME` 对应 `timestamptz`([类型是一份契约](/12-types/#basics-chapter-12))。
## 大多数 MySQL 惯用法都有直接的 Postgres 对应物 {#most-mysql-idioms-have-a-direct-postgres-equivalent}
| MySQL | Postgres |
|---|---|
| `AUTO_INCREMENT` | `generated always as identity` |
| `LAST_INSERT_ID()` | `insert ... returning id` |
| `INSERT ... ON DUPLICATE KEY UPDATE` | `insert ... on conflict (cols) do update` |
| `INSERT IGNORE` | `insert ... on conflict do nothing` |
| `` `backticks` `` | 不加引号(或使用 `"double quotes"`) |
| `IFNULL(a, b)` | `coalesce(a, b)` |
| `GROUP_CONCAT(x)` | `string_agg(x, ',')` |
| `TINYINT(1)` | `boolean` |
| `DATETIME` | `timestamptz` |
| `JSON` | `jsonb` |
| `utf8mb4_0900_ai_ci` equality | `lower(col)` 索引、`citext` 或 ICU 排序规则 |
| `FORCE INDEX`、`/*+ ... */` | 修复统计信息 |
| `SHOW PROCESSLIST` | `select * from pg_stat_activity` |
| `OPTIMIZE TABLE` | `vacuum`,或在线重建以缩小空间 |
| 清理、历史列表长度 | vacuum、`n_dead_tup` |
| `mysqldump` | `pg_dump` |
**Table 11-4.** 大多数 MySQL 惯用法都有直接的 Postgres 对应物
## 本章要点 {#the-short-version}
- InnoDB 按主键顺序存储表,并让二级索引指向主键。Postgres 把行存储在堆中,让每个索引指向物理地址。
- Postgres 的主键范围扫描只有在行按键顺序插入时才便宜(检查 `pg_stats.correlation`)。
- 不属于 HOT 的 Postgres 更新会在每个索引中写入一个条目。频繁更新的列要少建索引。
- 旧版本会留在 Postgres 表中,直到清理移除它们。要把清理当作一等工作,并了解回卷。
- Postgres 默认是读已提交,没有间隙锁;它的可重复读会抛出错误,而不是丢失更新。
- Postgres 中任何错误都会中止整个事务。用 `on conflict` 替代“插入并捕获重复”。
- 字符串按精确字符比较,整数除法会截断,NULL 排在最后,外键也不会自动为你建立索引。
- DDL 具有事务性,但迁移要保持短小,并设置 `lock_timeout`。
## 延伸阅读 {#further-reading}
- [Concurrency control](https://www.postgresql.org/docs/18/mvcc.html),PostgreSQL 文档。Postgres 的隔离级别与锁,可以和下面的 MySQL 页面对照阅读。
- [Clustered and Secondary Indexes](https://dev.mysql.com/doc/refman/8.4/en/innodb-index-types.html),MySQL 8.4 手册。聚簇索引、隐藏行 ID,以及二级索引为什么携带主键。
- [InnoDB Multi-Versioning](https://dev.mysql.com/doc/refman/8.4/en/innodb-multi-versioning.html),MySQL 8.4 手册。隐藏列、撤销日志、清理,以及二级索引条目如何被标记删除。
- [Transaction Isolation Levels](https://dev.mysql.com/doc/refman/8.4/en/innodb-transaction-isolation-levels.html),MySQL 8.4 手册。InnoDB 的可重复读隔离级别做什么,以及 next-key 锁从哪里来。
- [Hermitage](https://github.com/ept/hermitage),Martin Kleppmann 和贡献者。一个精确展示每个数据库的“可重复读”允许哪些异常的测试套件。
- [Why Uber Engineering Switched from Postgres to MySQL](https://www.uber.com/us/en/blog/postgres-to-mysql-migration/),Evan Klitzke,Uber,2016 年。完整的写放大论证;与上面链接的回应一起阅读。