8 先记日志,再写数据
在一台磁盘刷新需要 7.7 ms 的笔记本虚拟机上,每个事务插入一行的循环每秒大约只能提交 130 次。改一个会话设置,同一个循环就能达到 16,500 次。保持原来的设置,并行运行八份循环时,它们不会互相拖慢,合计大约能做到 1,240 次。
这些都与行本身无关。插入一行真正做的工作只有几百字节。全部差异来自一个文件:预写式日志,以及 Postgres 等待它到达磁盘的那个时刻。
了解这个文件里写入什么、什么时候必须落盘,以及为什么检查点之后它会膨胀,你就能在不牺牲安全性的情况下让写入变便宜。
先写日志,而不是写数据页
Postgres 在 shared_buffers 中修改页。被修改的页是脏页,迟早必须回到磁盘(不该由你的查询来写脏页)。
每次提交都写入所有脏页会很慢:文件位置分散,20 字节的变化也要完整写入 8 KB,热点页还会被一遍遍写回。因此 Postgres 做的事,就像商店收银台的做法:先把每笔交易记入账簿,打烊后再给货架补货。每次变化都会进入一条紧凑记录,追加到一份连续日志中,这就是预写式日志(WAL)。提交只需等待日志到达磁盘;数据页稍后批量写回。如果服务器先崩溃,日志中包含重做这些变化所需的一切信息。
名字本身就是规则:描述某个页的日志记录,必须在该页到达磁盘之前到达磁盘。
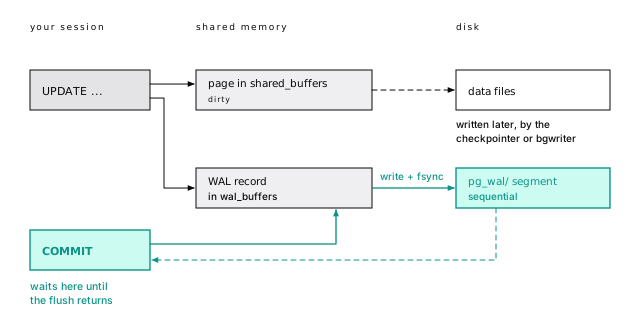
顺序追加是代价最低的持久化写入方式,而并发事务可以共享一次刷新。后一项事实解释了开头那些数字。
ACID 的四项承诺中,WAL 保证的是持久性:一旦提交记录安全地进入日志,事务就算提交了(如实看待 ACID会把这四个字母逐一拆开)。
WAL 记录很小,页镜像却不是
一条 WAL 记录会说“在关系 R 的 N 号块上执行这个操作”,它本身很小。更新 wal_demo 中的一行——这张表是含有 200,000 行的 events 副本——日志就会得到两条记录:一条携带完整行变化、150 字节的 HOT_UPDATE,以及一条 34 字节的 COMMIT,你的 COMMIT 等待的就是后者。
这是安静时的情况。如果该页自上次检查点以来还没有记录过(检查点会定期写出每个脏页,见下文),同一次更新还会带来一份 8 KB 的页镜像。在大多数写入负载中,WAL 的主要来源不是记录,而是镜像。
深入阅读:用 pg_walinspect 读回记录
LSN 是字节偏移量
每条 WAL 记录都有一个地址,即日志序列号(log sequence number,LSN):它是无尽数据流中的字节偏移量,写作 2/8BE4C8B0。将两个 LSN 相减(pg_wal_lsn_diff()),就能得到 WAL 字节数,这正是我们测量 WAL 的方式。
LSN 也会强制执行预写规则。每个数据页都会记住最后一条修改它的记录的 LSN,Postgres 不会在 WAL 刷新到那个位置之前写出该页。在磁盘上,这条数据流被切成位于 pg_wal/ 中、每个 16 MB 的 WAL 段文件。
深入阅读:WAL 文件名同时包含时间线和 LSN
三个十六进制字段分别是:时间线(00000001,故障切换或时间点恢复后会改变)、LSN 的高半部(00000002),以及其中的段(00000060,即 0x60C91650 除以 16 MB)。Postgres 随附的 pg_waldump 可以在命令行中打印这些文件里的记录,每个块显示为 rel tablespace/database/relfilenode blk N。
pg_current_wal_lsn() 是当前位置。在一个批处理作业前后各读一次再相减,就测出了这一时间窗口内整个集簇写入的 WAL:下面的 10,000 行插入在我们空闲的实验机器上“测得” 1,901 KB,而其他数据库繁忙时曾达到 5 MB。
动手验证 · lab 07-wal
EXPLAIN 会显示一条语句写入的 WAL
explain (analyze, wal)(PostgreSQL 13+)会运行一条语句,并报告它生成的 WAL。与 LSN 差值不同,它只统计这条语句,因此其他会话不会干扰结果:
10,000 行、20,027 条记录:每行一条堆插入和一条主键插入,外加几条用于新页的记录。约每行 193 字节,这是只有一个索引的表在稳定状态下的价格。每增加一个索引,每行就会多一条记录。explain analyze 确实会运行语句,所以要把写入包在 begin; ... rollback; 中。
对于整个批处理作业,或者生产环境的 60 秒样本,则改为相减两次 LSN 读数。它测量的是整个集簇,而不是一条语句;这就是你的 WAL 速率:用于确定副本带宽、备份存储和 max_wal_size 大小的数字。
深入阅读:WAL 行还能告诉你什么
检查点为恢复设定上限
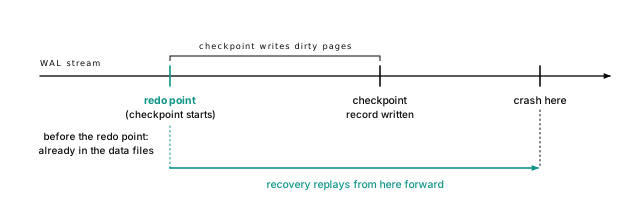
如果没有检查点,崩溃恢复就必须从最初的起点重放 WAL。一次检查点会把所有脏缓冲区写入数据文件,并对这些文件执行 fsync。检查点开始的位置称为重做点(redo point)。检查点完成后,这个位置之前的所有变化都已安全地写入磁盘,因此恢复可以从那里开始:
checkpoint_timeout 到期时会开始检查点(默认 5 分钟);如果 WAL 堆积得太多,也会更早开始。max_wal_size(默认 1 GB)是 Postgres 尝试让两次检查点之间保持的 WAL 大小。由于检查点的写入会分散进行,同时还会有更多 WAL 到达,所以它在略高于该值一半时就会请求下一次检查点:默认约为 540 MB。
pg_stat_checkpointer(PostgreSQL 17+)把第一类计为 num_timed,其他全部计为 num_requested,其中包括由 WAL 触发的检查点和每一条手动 CHECKPOINT 命令(本章实验会运行多次)。开启 log_checkpoints 后,服务器日志会为每次检查点写出原因:time、wal,或者手动检查点的 immediate force wait。健康系统中,定时检查点占主导。批量加载期间出现 wal 检查点是预期行为。在稳定的生产负载上,提高 max_wal_size,直到这种检查点变得罕见。
检查点进程会在间隔的 90% 时间内分散写入(checkpoint_completion_target,默认 0.9),这样不会猛击磁盘。保持这个值不变。
深入阅读:上一个检查点在哪里,以及它为什么发生
这是我们的实验服务器在一轮批量加载和手动 CHECKPOINT 之后的状态;它从未运行足够长的时间来触发定时检查点。num_timed 还会统计因为没有任何变化而跳过的定时检查点;PostgreSQL 18 的 num_done 则只统计实际运行的检查点。
重做点早于检查点记录,因为检查点需要一段时间:它从重做点开始,写出脏页,最后才记录完成。PostgreSQL 17 之前,这些计数器位于 pg_stat_bgwriter。从 PostgreSQL 15 起,log_checkpoints 默认开启;当由 WAL 触发的检查点间隔短于 checkpoint_warning(30 秒)时,日志中会出现“checkpoints are occurring too frequently”(检查点发生得过于频繁)的提示。
检查点后的第一次变化会记录整页
Postgres 的页大小是 8 KB,但存储通常只保证 4 KB 的原子写入。断电发生在写入中途时,一个页可能只留下半个新版本和半个旧版本:这就是撕裂页(torn page),任何“把这个元组放到偏移量 46”的小记录都无法修复它。
因此 Postgres 采取了简单而可靠的做法:检查点之后,页第一次发生变化时,它的 WAL 记录会包含该页的完整镜像。恢复会先还原这份整页镜像(FPI),再在其上应用后续记录。这由 full_page_writes 控制,默认开启。保持开启。
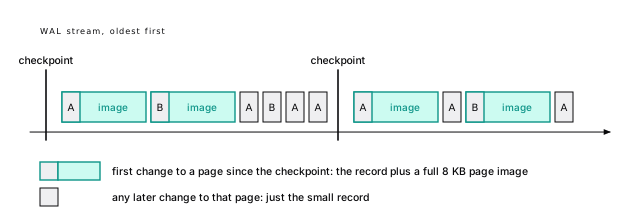
一个实验展示了这项代价:先执行检查点,在 wal_demo 的 3,759 个页上分散更新 1,100 行,然后再次运行同一更新:
同样的行,同样类型的变化。刚执行完检查点时:17.1 MB WAL,几乎全部来自 2,204 个页镜像。第二次运行时,每个页都已经有镜像:384 KB。
同样的工作,WAL 只有原来的四十五分之一。
动手验证 · lab 07-wal
在线上系统中,这会形成锯齿形:每次检查点之后,热点页开始写入第一份镜像,WAL 随之跳升,然后逐渐下降。由此得到三条规则:
- **检查点越频繁,WAL 越多。**每次检查点都会重置每个页“已经有镜像”的状态。把间隔减半,可能让随机更新负载的 WAL 接近翻倍,这也是写入繁忙的系统应该提高
max_wal_size和checkpoint_timeout的主要原因。 - **分散写入比集中写入更贵。**在 1,000 个页上执行 1,000 次更新,可能意味着 1,000 个镜像;在 20 个页上执行,则是 20 个。随机 UUIDv4 键(慎选键,少后悔)以及冷更新中的每个索引(冷更新要为每个索引付费)都会付出这项代价。
- **检查点越少,崩溃恢复越久。**这就是下文要说的取舍。
启用校验和后,连读取也会写 WAL
页甚至不必发生普通意义上的变化也可能被写入镜像。读取者会在页上设置提示位,缓存它们从某行事务中了解到的信息(读取可以写入)。启用数据校验和后(从 PostgreSQL 18 起默认开启),检查点后第一次改变页上提示位时,会被记录为整页镜像,否则撕裂页会导致校验和失败。(wal_log_hints = on 在没有校验和时也会做同样的事。)
因此读取也可能写 WAL:刚加载完一张 1,667 页的表后,第一次 count(*) 写入了 1,667 个页镜像,约 13 MB。承担这项代价,因为校验和能捕获静默损坏;但可以安排好这次突发写入的时间(开门营业前先清理并分析)。
深入阅读:一次写入 13 MB 的读取
插入操作让每一行的提交状态在页上都处于未知状态。select 会查明每一行的提交状态,设置提示位;由于这是检查点之后每个页的第一次变化,它会为每个页记录一份镜像。
动手验证 · lab 07-wal
wal_compression 花小代价就能见效
如果页镜像占了 WAL 的大头,就把它们缩小。wal_compression 会在整页镜像进入日志前压缩它们(不会压缩普通记录)。它默认关闭。我们在检查点之后运行同一条会产生大量镜像的更新语句,每种设置各运行一次。每次运行前都先做一次预热,使表每次都处于相同布局;这个布局触及的页少于上面的第一次运行,所以镜像也更少:
| wal_compression | fpi | WAL 字节数 | 相对于 off |
|---|---|---|---|
| off | 621 | 4,990,834 | 100% |
| lz4 | 619 | 2,927,214 | 59% |
| zstd | 620 | 1,723,491 | 35% |
镜像数量相同,只是每个镜像更小。代价是写入端压缩以及副本和恢复过程解压缩所需的 CPU。在任何有真实写入流量的服务器上,都打开其中一个:更少的 WAL I/O、更少的副本网络流量、更小的归档。页能压缩到什么程度取决于其中的内容,所以测量自己的数据。
深入阅读:我们如何测量压缩
取值可以是 off、pglz(也接受 on),以及 lz4 和 zstd(PostgreSQL 15+,前提是服务器构建时包含它们)。超级用户可以按会话设置它,所以你可以在一个会话中尝试每个值。先运行一次预热,让每次运行都从相同的表布局开始:
动手验证 · lab 07-wal
提交意味着刷新
现在回到开头的数字。默认 synchronous_commit = on 时,COMMIT 只有在截至其提交记录的 WAL 全部写出并执行了 fsync 后才会返回。这次刷新就是每个写事务的延迟下限。以下是 pgbench 中每次插入一行的循环,每次运行十秒:
| synchronous_commit | 客户端数 | 每秒提交数 | 平均延迟 |
|---|---|---|---|
| on | 1 | 130 | 7.7 ms |
| on | 8 | 1,243 | 6.4 ms |
| off | 1 | 16,507 | 0.06 ms |
| off | 8 | 91,740 | 0.09 ms |
这些数字来自那台 7.7 ms 的虚拟机;优秀服务器的存储刷新时间远低于一毫秒(时间都花在哪里)。但整体形状到处都成立:
- 只有一个客户端时,每秒提交数大致等于 1 除以 fsync 时间。CPU 工作只是噪声。
- 八个客户端时,吞吐量增至近十倍,而延迟没有上升。这就是组提交(group commit)。
- 不等待刷新时,一个客户端就快一百多倍。
动手验证 · lab 07-wal
许多提交可以共享一次刷新
一个后端进程等待 fsync 时,其他进程会把自己的提交记录排在它后面;下一次刷新就会覆盖所有这些记录。一次 fsync,许多次提交,不需要打开任何开关。
对你的代码而言,提交次数比行数更重要。10,000 次自动提交插入要付出 10,000 次刷新;放在一个事务中只需一次(每次提交都等待磁盘)。因此 ORM 导入可以在用事务包住它之后,从二十分钟降到二十秒(每批提交一次,而不是每行提交一次)。
synchronous_commit = off 可能丢失约 600 ms 内的提交
设置 synchronous_commit = off 时,COMMIT 会在提交记录进入 WAL 缓冲区后立即返回,WAL 写进程会在最多 wal_writer_delay 的三倍时间内刷新它:默认 200 ms 时约为 600 ms。如果机器崩溃,这个时间窗口内报告成功的提交可能消失(一次真实崩溃带走了三个已确认的提交会观察其中三个提交消失)。数据库会一致地恢复到稍早一点的状态,不会因此损坏。
这个设置可以按事务调整:支付事务保持开启,记录分析事件的事务则可以关闭:
适合的候选包括:遥测、在别处留有副本的日志、缓存、心跳。凡是已经告诉用户“完成”的事情,都不要这样做。也不要把它和 fsync = off 混淆,后者可能损坏整个集簇(fsync = off 和 full_page_writes = off 只能用于 CI)。
深入阅读:synchronous_commit 不只有两个值,组提交也有上限
有副本时,synchronous_commit 还接受 local(不等待任何同步备库)、remote_write、on 和 remote_apply;它们分别等待同步备库到达更进一步的阶段。没有同步备库时,它们的行为都像 local(同步提交要付出一次往返)。
组提交能帮上多大忙取决于磁盘:在一台繁忙的共享服务器上,我们见过的提升更接近 2.5 倍,而不是 10 倍。commit_delay 和 commit_siblings 试图让每次刷新聚集更多提交;在现代硬件上它们很少有帮助。
恢复只做重做
假设机器断电。启动时,Postgres 找到上一个检查点的重做点(上面的图),然后从那里向前重放 WAL。页镜像会被直接恢复,从而修复撕裂写入。提交记录成功落盘的事务会被视为已提交;其余事务算作已中止,它们的行版本保持不可见,留待清理。
恢复不会撤销任何东西。它只做重做,这也是它可靠的部分原因。
恢复时间取决于重做点到崩溃之间的 WAL 量,而这段 WAL 的量大致受 max_wal_size 限制。重放 1 GB 通常只需几秒;几十 GB 则需要几分钟。这就是取舍:检查点越少,页镜像越少,重启越久。每 15 到 30 分钟一次检查点适合大多数系统。
深入阅读:恢复逐步做什么
- 读取
pg_control,找到上一个检查点及其重做点。 - 从重做点读取 WAL。用每份整页镜像覆盖磁盘上的现有内容。对于其他记录,如果页的 LSN 已经比该记录更新,则跳过;否则应用该记录。
- 在有效 WAL 末尾停止;每条记录上的校验和会识别这个位置,即使最后一次写入只完成了一部分。
- 把重放过提交记录的事务视为已提交,其余视为已中止。
- 运行一次检查点,然后接受连接。
WAL 是其他一切的基础
一份记录每个变化的有序日志,几乎不增加额外成本就能给你:
- **流复制。**副本是一台永久处于崩溃恢复状态的服务器,随着主库写入 WAL 而重放它(权威数据的副本)。
- **时间点恢复。**基础备份加上其后的每个归档段,就能恢复到任意时刻(未经验证的备份只是传闻)。
- **逻辑解码。**设置
wal_level = logical后,WAL 携带足够的信息,可以为其他数据库或队列解码行变化。更改wal_level需要重启,所以要尽早决定。
MySQL 有重做日志、二进制日志和双写缓冲区。Postgres 用一份日志承担这三项工作;整页镜像发挥了双写缓冲区的作用(Postgres 不是 MySQL)。
三件事会让旧 WAL 留到磁盘塞满
有三件事会让 Postgres 保留旧段,而且每一件都曾填满生产环境的磁盘:
- **归档失败。**如果
archive_command持续失败,段文件就会堆积。 - **无人消费的复制槽。**复制槽会一直保留 WAL,直到消费者收到它;废弃的复制槽会永远保留 WAL(复制槽是保留 WAL 的承诺)。
max_slot_wal_keep_size可以限制它;默认无限制。 - 有意设置得很高的
wal_keep_size。
一个不活跃且 retained_wal 不断增长的复制槽,就是正在发生的磁盘耗尽事故。复制槽也会阻止清理(清理无法移除旧快照可能需要的内容)。
当 WAL 填满磁盘时,不要从 pg_wal 删除旧文件。如果其中有文件仍是恢复所需,数据库将无法再启动。修复原因(修好归档命令、删除废弃的复制槽或增加磁盘),Postgres 会在下一个检查点自行移除这些段。
先找出 WAL 的来源,再削减它
当 WAL 量成为瓶颈(副本延迟、归档增长、pg_wal 填满磁盘)时,先测量:pg_stat_wal 提供包括 wal_fpi 在内的集簇总量。如果页镜像占主导,就修检查点和压缩;否则就检查索引和更新。大致按影响排序,手段如下:
- 用更大的
max_wal_size拉开检查点间隔。 - 打开
wal_compression。 - 删除未使用的索引(idx_scan 为零是嫌疑,不是判决)。
- 让更新保持 HOT(让更新保持 HOT)。
- **使用具有局部性的键:**用 bigint identity 或 UUIDv7,不要用随机 UUID。
- **不要更新没有变化的行。**无操作更新仍然会写入一个行版本。
- 可丢弃的数据使用不记日志表(unlogged table),它们跳过 WAL,并在崩溃后被清空(先不记日志,再 SET LOGGED,只是转移 WAL 的写入时机)。
深入阅读:测量不记日志表和无操作更新
同样插入 10,000 行到 wal_demo 的不记日志副本中,写入的 WAL 不到记日志表的 1%。而 update wal_demo set kind = kind where id <= 1000 什么都没有改变,却仍然写入了超过 50,000 字节:每行一个新版本,并且写入了日志。
动手验证 · lab 07-wal
本章要点
- 每次变化都会先进入 WAL,再写入数据页。提交记录刷新后,提交就具有持久性;这次刷新是每次写入的延迟下限。
- 用
explain (analyze, wal)测量一条语句的 WAL;LSN 差值测量的是整个集簇。 - 检查点后的第一次页变化会写入完整的 8 KB 镜像:同一个更新 1,100 行的操作,刚过检查点时花费 17.1 MB,片刻后只花费 384 KB。
- 使用数据校验和(PostgreSQL 18 默认开启)时,设置提示位也可能写入页镜像,所以连读取也可能生成 WAL。
- 优先使用定时检查点:提高
max_wal_size,直到 WAL 触发的检查点变得罕见,并接受更长的崩溃恢复时间。 - 打开
wal_compression = lz4或zstd;在这里它把镜像密集型 WAL 降到了 59% 和 35%。 - 减少提交次数,而不是减少行数。对可丢弃的写入,按事务设置
synchronous_commit = off是合理取舍:可能丢失最近约 600 ms 的提交,但不会失去一致性。 - 监控复制槽和归档,永远不要手动删除
pg_wal中的文件。
延伸阅读
- Write-Ahead Logging (WAL),PostgreSQL 文档。关于预写规则及其作用的官方说明。
- WAL configuration,PostgreSQL 文档。检查点如何触发和调度,以及检查点日志行的含义。
- Write Ahead Log settings,PostgreSQL 文档。本章中的每个开关:
full_page_writes、wal_compression、synchronous_commit和检查点。 - Asynchronous commit,PostgreSQL 文档。准确说明
synchronous_commit = off可能丢失什么,以及它与fsync = off的区别。 - src/backend/access/transam/README,PostgreSQL 源码。开发者对 WAL、检查点和预写规则的自述。
- ARIES: A Transaction Recovery Method,Mohan 等,ACM TODS,1992 年。关于预写式恢复的经典论文;Postgres 选择了它所描述的设计空间中“只做重做”的一角。