7 让更新保持 HOT
复制一份带有六个索引的 users,更新其中 5,000 行,并递增一个没有任何索引覆盖的计数器。Postgres 写入 438 KB 的 WAL。再递增同一个计数器,同时更新 updated_at(它有索引),就像大多数 ORM 每次保存时做的那样;同样的 5,000 行会写入 2.96 MB,几乎是七倍。逐行更新时差距还会扩大:一次更新分别是 127 字节和 15,327 字节,因为其中两张被触及的索引页必须整页记录。区别就在于这次更新是不是 HOT。
每次更新都会把一份完整的新行版本写到新地址(更新会写入完整的新行),而索引指向地址。如果不做任何特殊处理,每次更新都会在每个索引中写入一个新条目。HOT 是 heap-only tuple(堆内元组)的缩写,是一条逃生通道:新版本留在同一页,索引完全不用知道它的存在。
你从来不用打开 HOT。它一直处于启用状态,而模式决定它能多常发挥作用:你给哪些列建索引、页填得有多满,以及事务保持打开的时间。把这三点做好,几乎每次更新都能跳过索引。
冷更新要为每个索引付费
把不是 HOT 的更新称为冷更新。它会写入一个新元组(完整的一行),在每个索引中新增一个条目,即使那些索引覆盖的列没有变化,还要为这一切写入 WAL。HOT 更新只写元组及其 WAL。就这些。
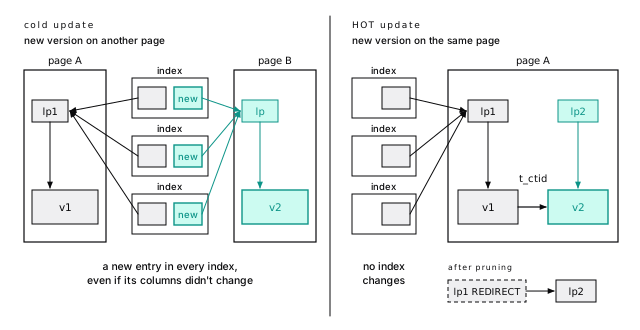
下面是完整的开场实验。我们复制了一份 users,让每一页留下 10% 的空闲空间(下面会讲 fillfactor 90),然后用两种方式更新其中的 5,000 行;表上分别有一个、三个和六个索引,并避开任何检查点。HOT 更新递增 login_count,没有索引覆盖它。冷更新还更新了有索引的 updated_at(只有一个索引时,该索引就是建在 updated_at 上的):
| 索引数 | HOT WAL | 冷更新 WAL | 冷更新 / HOT | HOT 缓冲区 | 冷更新缓冲区 |
|---|---|---|---|---|---|
| 1 | 438 KB | 999 KB | 2.3x | 11,370 | 21,504 |
| 3 | 438 KB | 1.91 MB | 4.5x | 11,370 | 46,906 |
| 6 | 438 KB | 2.96 MB | 6.9x | 11,370 | 87,026 |
先看 HOT 那几列:无论索引数量是多少,都是 438 KB 和 11,370 个缓冲区。HOT 更新看不见你的索引。每增加一个索引,冷更新一侧就大约多出一次 HOT 更新量的 WAL;索引数为六时,冷批次触及的缓冲区是 HOT 的 7.7 倍。
账单还会继续。HOT 更新之后的清理,没有索引条目需要移除;冷更新之后的清理则读取了全部六个索引的每一页。每个副本也都要重放同一份 WAL(Uber 遇到了这种不对称,而且双方都有道理)。
动手验证 · lab 06-hot
深入阅读:检查点之后,每个索引条目都是一张彩票
pg_walinspect 扩展(PostgreSQL 15+)会从日志中读回记录。我们在检查点之后,对这张六索引表运行了四次单行更新,交替执行 HOT 和冷更新:
- **更新 1,HOT:**一条记录携带两份整页镜像(堆和可见性映射),因为自上次检查点以来,这两个页都是第一次被触及(检查点后的第一次变化会记录整页)。
- **更新 2,冷更新:**七条记录,一条堆记录和每个索引各一条,每条都有自己的 8 KB 镜像。共 52,359 字节,约 51 KB。
- **更新 3,HOT:**71 字节,加上一条 56 字节的剪枝记录,共 127 字节。
- **更新 4,冷更新:**七条记录,加上剪枝记录。其中四次索引插入命中了已经有镜像的叶页(64 到 80 字节);另外两次没有命中,每次都付出了 7,400 字节。共 15,327 字节。
冷更新每个索引多出一条记录,而每条记录都有机会带来一份 8 KB 镜像。在检查点后的第一个 5,000 行批次中,镜像主导了两种更新:HOT 写入 10.0 MB,六个索引的冷更新在 35,250 条记录中写入 24.3 MB(每行一条堆记录、每个索引一条记录,此外还有 250 次去重遍历)。每个副本都要接收这 24.3 MB。
动手验证 · lab 06-hot
HOT 需要一次未被索引覆盖的变化,以及页上的空间
更新因为两个原因之一而无法成为 HOT,修复方式取决于具体是哪一个。我们先给它们命名,后面整章都会使用这些名称:
- 更新没有改变任何索引列时,我们称它为 HOT-safe(对 HOT 而言是安全的)。(从 PostgreSQL 16 起,只被BRIN索引覆盖的列不计入。)
- 更新同时满足 HOT-safe,且新版本能和旧版本放在同一页上时,它才是 HOT。
索引提到的每一列都算作已索引
“已索引”指的是出现在任何索引定义中的任何位置,而不只是键列。我们给一份 projects 副本建立了五种索引:
然后一次只运行一项更新,并观察 n_tup_hot_upd 在 pg_stat_user_tables 中的变化:
| 更新 | 你可能期待它成为 HOT 的原因 | HOT? |
|---|---|---|
set archived_at = now() | 没有索引存储 archived_at | 否 |
set name = name || ' (old)' | name 只在 INCLUDE 中 | 否 |
set slug = upper(slug) | lower(upper(slug)) 的值相同 | 否 |
set created_at = created_at - interval '1 day' | 只有 BRIN 索引覆盖它 | 是 |
set budget = 1.00(原为 1.0) | 作为数字相等 | 否 |
set name = name, account_id = account_id, budget = budget | 没有任何变化 | 是 |
把这些“否”当作警告。部分索引的谓词也算,所以在部分索引中使用软删除列,会让每次归档和恢复都变成冷更新。INCLUDE 列也算:覆盖索引会让它所携带的列失去 HOT。表达式索引算的是列本身,不是结果。BRIN 指向页范围而不是行,因此不需要新的指针。
发生变化意味着字节不同
“变化”不是 SET 列表,也不是 SQL 相等性:Postgres 会比较每个索引列的新旧字节。因此 set name = name 满足 HOT-safe,这对每次都把所有列写回去的 ORM 是个好消息。而 1.0 变成 1.00 虽然数值相等,却是冷更新,因为字节不同。
HOT 版本永远不会离开它所在的页
第二个条件是物理条件。HOT 版本永远不会离开它所在的页,所以落到该页的查找就能在那里找到它。如果新版本放不下,它就会去别的地方,并在每个索引中取得一个条目。你可以用下面要讲的 fillfactor 控制这部分空间。
深入阅读:索引尚未建完,就已经开始让 HOT 付出代价
HOT 查找会沿着版本链走,不离开所在页
HOT 更新就像贴在旧公寓门上的转交便签。索引保留着旧地址;旧版本写着“搬到了同一栋楼的槽位 3”,查找顺着这张便签走,不必离开这一页。通过 t_ctid 字段连接起来的各个版本,组成一条 HOT 链。lp 编号就是行指针,即页顶端编号的槽位(行指针让元组移动而不改变地址):
- **索引永远不会移动。**查找落到
lp1,然后沿着版本链走到快照可见的版本:无论链有多长,都只需一张索引页和一张堆页。 - **页内剪枝会把版本链变成重定向。**一旦旧版本对每个快照都已死亡,下一个访问者就会剪枝(只有没有快照能看到的版本才是死版本),让
lp1成为指向最新版本的重定向,不触碰索引。这就是 HOT 价值的一半:空间会在正常流量中回来。 - **只有清理才能完成工作。**整条链都死亡后,
lp1仍会作为死存根留下,直到清理移除索引条目。
深入阅读:没有索引指向堆内元组
一张带有 128 行短记录的 counters 表,会把一页填到只剩 488 字节。我们让另一个会话保持可重复读快照,然后把第 1 行更新了三次:
HEAP_HOT_UPDATED 表示“我的后继版本是堆内元组,沿着我的 t_ctid 跟过去”;HEAP_ONLY_TUPLE 表示“没有索引指向我”。bt_page_items 显示键 1 只有一个索引条目,仍指向 (0,1);索引扫描读取两个缓冲区。沿着链接走时,扫描会检查下一个版本的 xmin 是否与前一个版本的 xmax 匹配,因为两次访问之间槽位可能已经被释放并复用:ctid 是地址,不是身份。
另一个会话提交后,同一个 select 打印出 WAL: records=1 bytes=64。一次读取剪枝了这一页:槽位 1 现在是指向 131 的重定向(lp_flags 2),129 和 130 未使用(lp_flags 0)。一页最多容纳 291 个行指针,这可以防止小行用存根把页填满。
动手验证 · lab 06-hot
页接近填满时才进行页内剪枝
同时满足两个条件时,任何触及这张页的查询都会进行剪枝,包括 select。页上带有由更新或删除设置的提示,表示页中可能有死版本。并且页上的空闲空间小于其 fillfactor 预留空间和页大小 10%(819 字节)两者中的较大值。空间充裕的页不会在访问时剪枝;清理最终会处理它。
剪枝会记录 WAL,所以读取会写入。只读负载产生 WAL 不必惊讶(启用校验和后,连读取也会写 WAL讲的是另一个原因)。
深入阅读:空间充裕的页会被留下
三行数据,对第 1 行更新两次,然后执行一次索引扫描:没有 WAL,page_header() 显示有 7,988 字节空闲空间,并且已经设置了剪枝提示。五个版本全部留下。counters 页一开始有 488 字节空闲空间,低于 819 字节的界线,所以第一次访问时就剪枝了。源码中的规则是 heap_page_prune_opt。
还有两个细节。剪枝需要清理锁(不能有其他人钉住该页),并且不会等待清理锁;因此非常繁忙的页可能跳过剪枝,让一次原本 HOT-safe 的更新转移到其他地方。另外,update 当时不能剪枝它正在更新的行所在的页,所以下一次 HOT 更新所需的空间,通常来自更早的一次访问。
动手验证 · lab 06-hot
给页留下空间,否则每次更新都会移动
刚加载的表是挤满的。填充因子是每页在继续使用下一页之前允许插入填满的百分比;剩余空间留给更新。它默认是 100,因此刚加载的页没有多余空间,第一次更新无论是否 HOT-safe,都会变成冷更新。你可以按表设置它:
我们制作了三份 users 副本,都带有 login_count 列,各有两个索引,分别将 fillfactor 设为 100、90 和 70;然后从四个 pgbench 客户端随机更新用户,合计执行 200,000 次单行更新(pgbench 是随 Postgres 提供的负载生成器),并保持自动清理开启:
| 填充因子 | HOT | 移到新页 | 更新前 / 后页数 | 更新后索引大小 |
|---|---|---|---|---|
| 100 | 92.2% | 15,542 | 1,137 / 1,311 | 8,336 KB 到 8,624 KB |
| 90 | 100% | 0 | 1,266 / 1,266 | 8,336 KB,不变 |
| 70 | 100% | 0 | 1,613 / 1,613 | 8,336 KB,不变 |
填充因子为 100 时,有 15,542 次更新变成冷更新;挤满的表最终比填充因子为 90 的表还大,索引也随之增长。它最终还是付出了预留空间的代价,只不过使用了最糟糕的货币。批处理更严苛:在填充因子为 100 的表上,一条更新 10% 行的 update 中 10,000 次更新没有一次是 HOT,写入的 WAL 是同一语句在 90 时的五倍。
动手验证 · lab 06-hot
深入阅读:五个批次后,挤满的表终究也长到了同样大小
在 pgbench 运行中,填充因子为 100 的表现比你预期的好,这是因为第一次更新把一行移走后,剪枝会在每页释放一两个槽位。并发和自动清理的时机都会改变这些数字,所以实验运行了一个可重复的版本:单个会话随机执行 50,000 次单行更新。填充因子为 90 时 HOT 比例保持 100%;填充因子为 100 时约为 95%,并开始增长。批次无法依赖剪枝,因为一条语句会先更新一页上的多行,之后才有机会剪枝。
批处理运行的是在新副本上的 update ... set login_count = login_count + 1 where id % 10 = 0:
| 填充因子 | HOT | WAL 记录数 | WAL | 触及的缓冲区 |
|---|---|---|---|---|
| 100 | 10,000 次中 0 次 | 40,471 | 3.5 MB | 103,024 |
| 90 | 10,000 次中 10,000 次 | 10,000 | 703 KB | 22,532 |
五个这样的批次之后,填充因子为 100 的表 HOT 比例提高到了 77%,页数恰好达到 1,266,也就是填充因子为 90 的表的大小;为此它付出了 11,365 次冷更新和额外的 43 个索引页。
动手验证 · lab 06-hot
预留空间要先付出代价,之后才会回本
第一天这些预留空间是空的:填充因子为 90 让表大了 11%,为 70 让表大了 42%,而膨胀估算器会把这些预留空间也算作膨胀。像 events 这样的只追加表保持 100。更新很多的表从 90 开始;如果行有几百字节,或者 n_tup_newpage_upd 一直上升,可以降到 70 或 80。
之后再设置只会作用于新页。已有页会保持挤满,直到发生重写(不加锁重建膨胀的表);对于一张正在使用的大表,跳过重写,让新页采用这个设置。
填充因子只帮助 HOT-safe 更新。如果索引覆盖了你更新的列,再多的空闲空间也不能让这些更新成为 HOT。在调整表大小之前,先检查你违反的是哪一半规则。
忙碌的表 HOT 比例应高于 90%
Postgres 会替你统计这些数据。pg_stat_user_tables 有 n_tup_upd(所有更新)、n_tup_hot_upd(HOT 更新)和 n_tup_newpage_upd(PostgreSQL 16+:新版本去了另一页,因此这是冷更新)。留在原页的冷更新说明页上有空间,所以改变了索引列;移动了的冷更新则说明没有空间:
index_changed 高:索引覆盖了更新会改变的列,填充因子帮不上忙。no_room 高:页太满了;降低填充因子,或者查找长事务(下一节)。两者都高:先修索引,因为即使索引列发生了变化,只要发生移动,也会计入 no_room。
按一天的变化来观察,而不是看全生命周期累计值。在有真实更新流量的表上,超过 90% 是健康的;忙碌表上的低比例是最应该先修的事情。
深入阅读:本章各表的分类,以及读出零值的计数器
在实验数据库中:
churn 每次更新都会改变索引列,其中 127,233 次还发生了页移动,这就是“先修索引”的原因。后端进程会在事务结束后约一秒内刷新统计信息。在脚本中,先调用 select pg_stat_force_next_flush();,或者在事务内部读取 pg_stat_xact_user_tables。对于一条语句,在随后会回滚的事务中执行 explain (analyze, buffers, wal),可以看到 HOT 大约每行一条 WAL 记录,冷更新则是每行一条再加每个索引一条;在整个负载范围内,pg_stat_statements 会按 wal_bytes 给语句排序。
动手验证 · lab 06-hot
长事务会关闭 HOT
页内剪枝只能移除对每个快照都已死亡的版本。数据库中任何地方的一个旧快照,都会让比该快照更新的版本无法被剪枝。旧版本堆积,页被填满,原本 HOT-safe 的更新开始移动,并写入索引条目。
我们在一张全新的填充因子为 90 的表上重复了五个批次,同时让另一个会话停留在一个打开的可重复读事务中:
| 50,000 次更新,填充因子 90 | HOT | 堆页 | 索引页 |
|---|---|---|---|
| 没有打开的事务 | 100% | 1,266 到 1,266 | 1,042 到 1,042 |
| 另一个会话持有快照 | 22.8% | 1,266 到 1,755 | 1,042 到 1,429 |
另一个会话从未碰过这张表。它只持有快照几秒钟,HOT 比例就降到了 23%,表和索引却永久增长了三分之一以上。同一个快照也会阻塞清理(清理无法移除旧快照可能需要的内容)。保持事务短小,并设置 idle_in_transaction_session_timeout。
动手验证 · lab 06-hot
HOT 是一次性做出的设计决定
本章中的每次冷更新都来自某个索引或某个已填满的页。两者都是模式选择,所以一次修好即可。
不要给 updated_at 建索引
几乎每个 ORM 都会在每次保存时设置 updated_at。给它建索引后,这张表的每次更新都会在每个索引上变成冷更新。在给任何大多数更新都会改变的列(updated_at、last_seen_at、status、计数器、locked_by)建索引前,先说清楚是哪条查询需要它:
- **“自上次同步以来发生了什么变化?”**更适合用只追加的变更日志或 outbox 表来服务。
updated_at上的 BRIN 索引是 HOT-safe 的(PostgreSQL 16+),但 HOT 会把行留在原处,因此这些值很快就会偏离物理顺序。先测量。- 很少运行的管理员查询可以直接扫描。每天十秒钟,总好过让数百万次更新都变成冷更新。
把热点计数器移到窄表
宽行上的计数器每次递增都会复制整行,并为了这 8 个字节把整行拖过缓存。我们把一个 view_count 放到 profiles 表上;这张表包含 416 字节的 bio,共 6,667 页。我们又把同一个计数器放进一张两列的旁表(599 页)。两边的 HOT 比例都保持 100%,但检查点之后立刻递增 10,000 次时,宽表写入 49.3 MB WAL,窄表写入 4.9 MB:页镜像只有十分之一,而且计数器能够留在缓存中。
last_seen_at、login_count、速率限制、心跳都可以这样处理:凡是写入频率远高于所在行的内容都适用。非常频繁的递增要合并成批量更新。也不要在繁忙的表上用触发器维护计数(计数器触发器会让写者串行)。
深入阅读:窄表不会让 HOT 更容易发生
在稳定状态下,WAL 差距会缩小(第二个批次为 1.06 MB 对 764 KB),因为只要更新留在原页,记录的就只有发生变化的字节,除非 wal_level 是 logical。而且 10% 的预留空间由数量为原来十倍的窄行共享:一条每五行递增一行的语句,在宽表上保持了 67% 的 HOT,在窄表上保持了 54%。
动手验证 · lab 06-hot
让 ORM 少写一些
无条件更新 updated_at 会产生一个新的行版本;如果 updated_at 有索引,这就是冷更新。一次没有真实变化的保存虽然是 HOT-safe,仍然会写入版本和 WAL,并增加未来的清理工作。使用脏检查;在普通 SQL 中则加上保护条件:
自底向上的索引删除是安全网
从 PostgreSQL 14 开始,如果 B-树的键没有变化,它会在冷更新之后自行清理:分裂叶页之前,删除其中指向死版本的条目。这是一张安全网,不能代替 HOT。每次冷更新仍然写入并记录了这些条目,而键发生变化的索引要一直等到清理才会处理自己的垃圾。
深入阅读:数一数自底向上删除
churn 表(id、email 和 updated_at 都有索引;不运行清理)分 30 个批次执行了 300,000 次冷更新,每次都改变 updated_at:
| 索引 | 键是否改变? | 持有的堆指针 | 更新前 / 后页数 |
|---|---|---|---|
churn_updated_at_idx | 是 | 400,000 | 276 / 1,098 |
churn_pkey | 否 | 196,685 | 276 / 551 |
churn_email_idx | 否 | 189,244 | 499 / 975 |
updated_at 索引保留了每个活跃条目和过期条目。另外两个索引在运行过程中分别删除了 68% 和 70% 的过期条目。
动手验证 · lab 06-hot
这就是 Postgres 做出的取舍
Postgres 索引指向物理地址:查找直接,但每次冷更新都会写入每个索引。MySQL 的 InnoDB 做了相反的选择:那里的更新只触及发生变化的列所属的索引,所以给 updated_at 建索引,每次更新只需写一个索引,而在这里可能要写每一个索引(一次更新写一行,或者写每个索引)。HOT 缩小了这道差距,所以代价如此依赖你的模式。几乎总能重新塑造造成问题的表。在责怪数据库之前,先做这个。
本章要点
- 冷更新会在每个索引中写入条目,还要付出 WAL、清理以及每个副本上的同等代价:六个索引时,WAL 是 HOT 更新的 6.9 倍。
- HOT-safe 表示没有索引列发生变化;HOT 还要求页上有空间。要知道自己违反的是哪一半。
- 已索引表示出现在索引的任何位置:键、
INCLUDE、表达式或部分谓词(仅被 BRIN 索引覆盖的列例外,PostgreSQL 16+)。 - 不要在没有明确查询需求的情况下给
updated_at或其他大多数更新都会改变的列建索引。 - 更新很多的表设置
fillfactor = 90(宽行使用更低的值);只追加表保持 100。 - 用
n_tup_hot_upd和n_tup_newpage_upd对照n_tup_upd,判断应该修索引还是增加页内空间。 - 一个被持有的快照把我们的 HOT 比例从 100% 降到 23%,并让每个索引都增长。保持事务短小。
- 把不断变化的计数器移到窄表,并且不要写入没有变化的行。
延伸阅读
- src/backend/access/heap/README.HOT,PGDG 源码。设计文档:版本链、重定向、剪枝,以及
CREATE INDEX如何处理已有版本链。 - Heap-Only Tuples (HOT),PostgreSQL 文档。两个官方条件,包括汇总索引例外。
- B-tree bottom-up index deletion,PostgreSQL 文档。PostgreSQL 14+ 如何限制冷更新造成的索引膨胀。
- HOT updates in PostgreSQL for better performance,Laurenz Albe,CYBERTEC。简洁的实践者视角,讲解条件和填充因子。
- The Part of PostgreSQL We Hate the Most,Andy Pavlo 和 Bohan Zhang。研究者对追加式版本机制的批评,以及关于更新有多大比例是 HOT 的集群数据。