# 更新就是插入
> 看清 UPDATE 和 DELETE 究竟如何改变页,为什么表会膨胀,以及一个长事务为何会拖累整个数据库。
---
LLMS 索引: [llms.txt](/llms.txt)
---
示例数据库中的 `users` 表有 9 MB。对它运行一条语句:
```sql
update users set name = upper(name);
```
现在它有 18 MB,索引也从 8 MB 增长到 12 MB。你没有改变任何一行的大小,也没有增加任何行,但表却翻了一倍。运行 `vacuum` 后,它仍然是 18 MB。
这都不是 bug。这是 Postgres 让许多事务在不让读者等待写者的情况下读写同一份数据的方式。这项技术叫作**多版本并发控制**(MVCC),它的核心规则只有三个词:**更新就是插入**。一旦你在页中看到了这一点,膨胀、缓慢的更新、跟不上趟的清理,以及事务 ID 回卷,就都不再神秘了。
## 读者永远不用等待写者 {#readers-never-wait-for-writers}
想象一份汇总每个账户余额的报表,它需要运行十秒。运行到一半时,另一个事务把钱从报表还没读到的账户转移到它已经统计过的账户。如果报表每到一页就读取当时页上的内容,这笔钱就会从总数中消失。
一种解决办法是加锁:报表锁住它读到的内容,写者等待。结果正确,却很难受。Postgres 采取了另一条路:它从不原地覆盖一行。更新会写入这一行的一个**新版本**,并把旧版本留在原处,标记是谁替换了它。在更新之前开始的读者继续看到旧版本;之后开始的读者看到新版本。谁也不用等待。
代价会晚些时候出现:旧版本会不断堆积,直到再也没有人需要它们,然后由清理把它们收走。那堆东西就是膨胀。
## 每次写入都会取得一个事务 ID {#every-write-gets-a-transaction-id}
每一行首部的两个数字,是本书后面膨胀、清理工作和回卷问题的起点。它们背后牵连着后面所有这些问题。
每个改变数据的事务,都会在第一次写入时从服务器级计数器取得一个**事务 ID**(XID);只读事务永远不会取得事务 ID。每个行版本的首部都带着两个事务 ID([一行的成本不止它的列](/04-storage/#a-row-costs-more-than-its-columns)):**xmin** 是插入它的事务,**xmax** 是删除、替换或锁住它的事务(没有则为 0)。每一行 `events` 的 xmin 都是 766,也就是种子数据事务,xmax 都是 0;对任何表运行 `select xmin, xmax, * from events` 都能看到它们。
(运行本章实验时服务器比较忙,所以下面的 XID 很大,而且会在步骤之间跳跃。你的值会不同。)
## 更新会写入完整的新行 {#an-update-writes-a-whole-new-row}
要观察版本如何产生,我们需要一张小到可以完整读出的页。一项按账户统计使用量的计数器很合适,这正是应用会不断更新的那类行:
```sql
create table account_usage (
account_id bigint primary key references accounts (id),
events_today int not null default 0,
updated_at timestamptz not null default now()
);
insert into account_usage (account_id) values (1), (2), (3);
```
三行位于第 0 页的第 1 至第 3 个槽位,由事务 869572 插入。现在递增账户 1 的计数器。`RETURNING` 配合 `old` 和 `new`(PostgreSQL 18+)可以显示两个版本的地址:
```sql
update account_usage
set events_today = events_today + 1
where account_id = 1
returning old.events_today, new.events_today,
old.ctid as old_ctid, new.ctid as new_ctid;
```
```text
events_today | events_today | old_ctid | new_ctid
--------------+--------------+----------+----------
0 | 1 | (0,1) | (0,4)
```
这一行移到了新的槽位。现在这一页为三行保留了四个元组:旧版本仍然逐字节位于槽位 1,被更新事务的 XID 标记,并指向 `(0,4)`;槽位 4 中则有一份完整的新副本:
**图 6-1.** 更新就是插入并加上标记。旧版本留在槽位 1,被更新事务的 XID 标记,并带有指向 \(0\,4\) 的 ctid;新版本是槽位 4 中的一份完整副本。现在四个元组承载着三行。
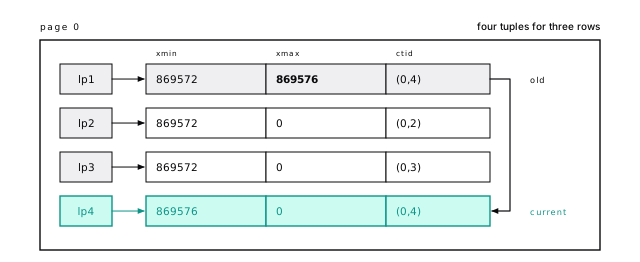
整个机制就是这样:更新插入一个新版本,并在旧版本上盖章:“已被 869576 替换,见 `(0,4)`”。
每次更新都会写入一份完整的新副本,无论实际改变了多少内容。在一行 1 KB 的记录中递增一个 4 字节的计数器,页上也会落下一条新的 1 KB 元组。这就是为什么宽而且频繁更新的行在 Postgres 中代价高昂,也解释了为什么应该像 `account_usage` 这样,把热点计数器放进单独的窄表。
> [!DETAILS]- 深入阅读:一次更新后的页,以及 4 字节变化的代价
>
> ```sql
> select lp, t_xmin, t_xmax, t_ctid, raw_flags
> from heap_page_items(get_raw_page('account_usage', 0)),
> heap_tuple_infomask_flags(t_infomask, t_infomask2);
> ```
>
> ```text
> lp | t_xmin | t_xmax | t_ctid | raw_flags
> ----+--------+--------+--------+--------------------------------------------------
> 1 | 869572 | 869576 | (0,4) | {HEAP_XMIN_COMMITTED,HEAP_HOT_UPDATED}
> 2 | 869572 | 0 | (0,2) | {HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}
> 3 | 869572 | 0 | (0,3) | {HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}
> 4 | 869576 | 0 | (0,4) | {HEAP_XMAX_INVALID,HEAP_UPDATED,HEAP_ONLY_TUPLE}
> ```
>
> 槽位 1 上的 `HEAP_HOT_UPDATED` 和槽位 4 上的 `HEAP_ONLY_TUPLE` 表明这是一次 HOT 更新;下面的 HOT 一节会解释这种更新。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'the old version is still there, stamped with the updater''s xid and pointing at (0,4)',
> > (select t_xmax from page0 where lp = 1) = (select t_xmin from page0 where lp = 4)
> > and (select t_ctid from page0 where lp = 1) = '(0,4)');
> >
> > select lab.prove(
> > 'HEAP_HOT_UPDATED on the old version and HEAP_ONLY_TUPLE on the new: a HOT update',
> > 'HEAP_HOT_UPDATED' = any((select raw_flags from page0 where lp = 1)::text[])
> > and 'HEAP_ONLY_TUPLE' = any((select raw_flags from page0 where lp = 4)::text[]));
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
>
> 实验还会更新一条约 1 KB 的行中的计数器,并从页上读取新元组的长度:超过 1,000 字节。预写式日志则更节省。当新版本落在同一页上时,Postgres 只记录发生变化的字节;在我们的测试中少于 100 字节,除非记录带有整页镜像,或者服务器运行时 `wal_level = logical`([先记日志,再写数据](/08-wal/#basics-chapter-8))。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'incrementing a 4-byte counter in a 1 KB row writes a whole new 1 KB tuple',
> > lp_len > 1000)
> > from heap_page_items(get_raw_page('wide_counter', (:'wide_ctid'::text::point)[0]::int))
> > where lp = (:'wide_ctid'::text::point)[1]::int;
> >
> > select lab.prove(
> > 'but the WAL record for a same-page update logs only the changed bytes (under 100)',
> > bytes < 100) from wide_wal;
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## 只有没有快照能看到的版本才是死版本 {#a-version-is-dead-only-when-no-snapshot-can-see-it}
再更新账户 1 两次,它的版本链就会依次串起 `(0,1)`、`(0,4)`、`(0,5)`、`(0,6)`:三行对应六个元组,其中三个已经成了无用的死版本。
任何事务都再也看不到的版本,就是一个**死元组**。“再也”很重要:一个被替换的版本,只有在所有可能仍然读取它的事务都结束后才算死亡。仍在运行的最老快照(它是一个固定的、记录了哪些事务已经提交的视图,见[下文](#a-snapshot-picks-one-version))会设置 **xmin 清理界限(xmin horizon)**:在它之前死亡的版本可以移除;其余版本必须留下。清理能清掉多少,就由这条界线决定;长事务一节会说明这一点。
死元组有两种清除方式。**页内剪枝**会在查询读取一张几乎填满的页时顺手发生:成本低,一次处理一页,也不需要处理索引。**清理**则做完整的工作,包括索引条目([清理不可省](/10-vacuum/#basics-chapter-10))。
运行 `vacuum account_usage` 后,账户 1 的三个死版本消失了,槽位 1 变成指向槽位 6 的**重定向**,因为主键索引仍然指向 `(0,1)`。元组会移动,地址不会。这正是[行指针让元组移动而不改变地址](/04-storage/#a-line-pointer-lets-a-tuple-move-without-changing-its-address)所说明的事情。
> [!DETAILS]- 深入阅读:清理如何把版本链变成重定向
>
> 在此之前,这一页保存着完整的版本链:
>
> ```text
> lp | lp_flags | t_xmin | t_xmax | t_ctid
> ----+----------+--------+--------+--------
> 1 | 1 | 869572 | 869576 | (0,4)
> 2 | 1 | 869572 | 0 | (0,2)
> 3 | 1 | 869572 | 0 | (0,3)
> 4 | 1 | 869576 | 869578 | (0,5)
> 5 | 1 | 869578 | 869580 | (0,6)
> 6 | 1 | 869580 | 0 | (0,6)
> ```
>
> 运行 `vacuum account_usage` 后再次查看页,额外列出 `lp_off` 和 `lp_len`:
>
> ```text
> lp | lp_off | lp_flags | lp_len | t_xmin | t_xmax | t_ctid
> ----+--------+----------+--------+--------+--------+--------
> 1 | 6 | 2 | 0 | | |
> 2 | 8144 | 1 | 48 | 869572 | 0 | (0,2)
> 3 | 8096 | 1 | 48 | 869572 | 0 | (0,3)
> 4 | 0 | 0 | 0 | | |
> 5 | 0 | 0 | 0 | | |
> 6 | 8048 | 1 | 48 | 869580 | 0 | (0,6)
> ```
>
> 槽位 1 的 `lp_flags` 是 2,即重定向;它的偏移字段中存着目标槽位 6。槽位 4 和 5 的值是 0,即未使用:由于它们是堆内元组,没有索引条目指向它们,所以可以直接释放。槽位 6 移到了偏移 8048。第四种状态 `lp_flags` 3 是**死**:元组已经消失,但某个索引仍可能指向这个槽位。它会一直保留,直到清理移除索引条目,之后才会变成未使用。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'after vacuum, lp 1 is a redirect (lp_flags 2) to slot 6',
> > lp_flags = 2 and lp_off = 6) from page0 where lp = 1;
> >
> > select lab.prove(
> > 'lp 4 and 5 are unused (lp_flags 0), free for the next insert or update',
> > count(*) = 2 and bool_and(lp_flags = 0)) from page0 where lp in (4, 5);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## HOT 更新会跳过索引 {#hot-updates-skip-the-indexes}
索引指向地址,因此一个位于新地址的新版本,通常需要在表的**每一个**索引中新增条目。我们的账户 1 更新却没有这样做:它们是 **HOT**(heap-only tuple,堆内元组)更新,留在同一页中,不改动索引。只有同时满足以下条件才行:**没有索引列发生变化**,并且**新版本能放进同一页**。
违反第一个条件,更新就会变成普通更新。给 `account_usage.updated_at` 建索引,然后更新账户 2 的 `updated_at`;账户 2 的主键索引会新增第二个条目,指向新版本的槽位,而账户 1 在三次 HOT 更新后仍只有一个条目。
页填得太满则会违反第二个条件。我们加载了两份 `users` 副本,一份使用默认的 100 fillfactor,另一份使用 85([填充因子为更新留下空间](/04-storage/#fillfactor-leaves-room-for-updates)),然后分别更新每十行中的一行。在 100 时,10,000 次更新没有一次是 HOT,表从 1,126 页增长到 1,239 页。在 85 时,10,000 次更新全部是 HOT,表一页也没有增长。[让更新保持 HOT](/07-hot/#basics-chapter-7)会继续讲解。
> [!EXAMPLE]- 动手验证 · lab `05-mvcc`
>
> ```sql
> select lab.prove(
> 'account 2 now has two primary key entries: the update changed an indexed column, so it was not HOT',
> array_agg(ctid::text order by itemoffset) = '{"(0,2)","(0,4)"}')
> from bt_page_items('account_usage_pkey', 1)
> where data = '02 00 00 00 00 00 00 00';
>
> select lab.prove(
> 'fillfactor 100: 0 of 10,000 updates were HOT, and the table grew from 1,126 to 1,239 pages',
> s.n_tup_upd = 10000 and s.n_tup_hot_upd = 0
> and pg_relation_size('users_ff100') / 8192 between 1200 and 1280)
> from pg_stat_user_tables s where relname = 'users_ff100';
> select lab.prove(
> 'fillfactor 85: all 10,000 updates were HOT, and the table did not grow (1,322 pages)',
> s.n_tup_upd = 10000 and s.n_tup_hot_upd = 10000
> and pg_relation_size('users_ff85') / 8192 = 1322)
> from pg_stat_user_tables s where relname = 'users_ff85';
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## 一个快照选择一个版本 {#a-snapshot-picks-one-version}
当一行在页上有多个版本时,查询如何选出其中一个?它依据的是一个**快照**:在语句(或事务)开始时拍下的、记录哪些事务已经提交的照片。如果一个版本在照片拍下之前出生,并且在那时还没有死亡,你就能看到它。一个版本链中最多只有一个版本通过这项检查。
我们从两个会话中观察它。会话 A 使用事务 869588 更新账户 3,并让事务保持打开:
```sql
-- session A
begin;
update account_usage set events_today = 100 where account_id = 3;
-- (not committed yet)
```
会话 B 读取同一行:
```sql
-- session B
select ctid, xmin, xmax, account_id, events_today
from account_usage where account_id = 3;
```
```text
ctid | xmin | xmax | account_id | events_today
-------+--------+--------+------------+--------------
(0,3) | 869572 | 869588 | 3 | 0
```
B 看到的是旧版本,尽管 A 的 XID 已经出现在它的 xmax 中。B 拍下快照时 A 还没有提交,所以在 B 看来,旧行还没有死亡,新行也还没有出生。B 没有等待,也没有阻塞 A。
A 提交后,B 的下一条语句就会看到 `events_today = 100`。如果 A 回滚,页上的内容不会改变:它的版本会带着一个已中止的 xmin,对所有人都不可见([原子性:任何事情都不会被撤销](/09-acid/#atomicity-nothing-is-ever-undone))。
> [!NOTE] 来自 MySQL
>
> InnoDB 原地更新行,并把旧版本保存在撤销日志中。Postgres 则把旧版本保存在表本身:回滚立即完成,读取当前数据的成本很低,但每次更新都会写入完整的一行,并留下一个死元组等待清理([Postgres 不是 MySQL](/11-not-mysql/#basics-chapter-11))。
> [!DETAILS]- 深入阅读:快照是什么样的,以及会话 A 期间的页
>
> ```sql
> select pg_current_snapshot();
> ```
>
> ```text
> pg_current_snapshot
> ----------------------------------------------------------------
> 868807:869587:868807,868917,868951,868974,869184,869185,869537
> ```
>
> 格式是 `xmin:xmax:in-progress list`。所有小于 **868807** 的事务都已经结束。**869587** 是最近结束事务的下一个事务 ID;大于等于它的任何事务,无论后来发生什么,都会被视为仍在运行、不可见。列表保存了中间那些仍在运行的事务(服务器空闲时通常很短,或者为空)。会话 B 在 A 保持打开时取得了这个快照,所以 A 的 869588 对它不可见。更精确地说:当一个版本的 xmin 在快照之前已经提交(或者它是你自己的事务更早写入的内容),并且它的 xmax 为空、已中止、在快照看来尚未提交,或者只代表一个锁时,这个版本才可见。
>
> 那一刻,账户 3 的两个版本都在页上,而 `pg_xact_status('869588')` 报告的是 `in progress`:
>
> ```text
> lp | t_xmin | t_xmax | t_ctid
> ----+--------+--------+--------
> 3 | 869572 | 869588 | (0,5)
> 5 | 869588 | 0 | (0,5)
> ```
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'session B still sees the old version at (0,3), with A''s xid already in its xmax',
> > ctid = '(0,3)' and xmax::text = :'a_xid' and events_today = 0)
> > from account_usage where account_id = 3;
> >
> > select lab.prove(
> > 'pg_xact_status says A is in progress',
> > pg_xact_status(:'a_xid'::xid8) = 'in progress');
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
### 读取也可能写入 {#a-read-can-write}
读者如何知道事务 869588 是否提交?它会查询**提交日志**(`pg_xact`),每个事务占两个 bit;第一个查到结果的读者,会把答案缓存到元组本身的**提示位**中。
这意味着读取也可能写入。第一次对刚加载的行执行 `select` 时,会在它读取的每个元组上设置提示位,把这些页标记为脏页,之后再写回磁盘。批量加载后,运行 `vacuum analyze`,让这阵写入按你的安排发生,而不是在用户访问时发生([在打开大门前清理并分析](/27-loading/#vacuum-and-analyze-before-you-open-the-doors))。
> [!DETAILS]- 深入阅读:抓住一次 select 正在写入的瞬间
>
> ```sql
> create table hint_demo2 (id int, v text);
> insert into hint_demo2 select g, md5(g::text) from generate_series(1, 200000) g;
>
> select raw_flags
> from heap_page_items(get_raw_page('hint_demo2', 100)),
> heap_tuple_infomask_flags(t_infomask, t_infomask2)
> where lp = 1;
> ```
>
> ```text
> raw_flags
> --------------------------------------
> {HEAP_HASVARWIDTH,HEAP_XMAX_INVALID}
> ```
>
> 执行普通的 `select count(*) from hint_demo2` 后,同一个元组读出的内容变成 `{HEAP_HASVARWIDTH,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}`:`select` 查询了提交日志,并把答案写入它读到的每个元组。开启数据校验和后,这次写入还可能在 WAL 中产生一份整页镜像([启用校验和后,连读取也会写 WAL](/08-wal/#with-checksums-even-a-read-writes-wal))。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'a freshly loaded tuple has no HEAP_XMIN_COMMITTED hint yet',
> > not ('HEAP_XMIN_COMMITTED' = any(raw_flags)))
> > from heap_page_items(get_raw_page('hint_demo2', 100)),
> > heap_tuple_infomask_flags(t_infomask, t_infomask2)
> > where lp = 1;
> >
> > select lab.prove(
> > 'after a plain count(*), the tuple carries HEAP_XMIN_COMMITTED: a read modified the page',
> > 'HEAP_XMIN_COMMITTED' = any(raw_flags))
> > from heap_page_items(get_raw_page('hint_demo2', 100)),
> > heap_tuple_infomask_flags(t_infomask, t_infomask2)
> > where lp = 1;
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## 删除只给行盖章 {#a-delete-only-stamps-the-row}
删除比更新简单:它只设置 xmax,除此之外什么也不做。删除一行后,它仍以完整大小留在页上,xmax 中带着删除者的 XID。它从所有新快照中消失,却仍然占用空间。删除一百万行不会缩小表;它只会产生一百万个死元组,等待清理将其变成可复用的空间。
`truncate` 是例外。它什么也不盖章:它换入一个新的空文件,所以快照早于它的事务看到的也是空表,而不是原来的内容([TRUNCATE](https://www.postgresql.org/docs/18/sql-truncate.html))。不要截断一张仍可能被长时间运行的读者读取的表,例如报表或逻辑备份正在读取的表。
> [!DETAILS]- 深入阅读:事务何时取得 XID,以及为什么 xmax 不总是表示已删除
>
> 账户 4 的行是在删除之前刚刚插入的,执行插入的这个事务展示了 XID 在何时分配:
>
> ```sql
> begin;
> select pg_current_xact_id_if_assigned(); -- nothing yet
> select count(*) from accounts;
> -- still nothing: reads don't need an xid
> select pg_current_xact_id_if_assigned();
> insert into account_usage (account_id) values (4);
> select pg_current_xact_id_if_assigned(); -- 869595, assigned by the first write
> commit;
> ```
>
> 删除本身:
>
> ```sql
> delete from account_usage where account_id = 4 returning ctid, xmin, xmax;
> ```
>
> ```text
> ctid | xmin | xmax
> -------+--------+--------
> (0,7) | 869595 | 869597
> ```
>
> 槽位 7 仍以完整大小处于使用状态,`t_ctid` 指向自身(因为没有更新版本),标志位为 `HEAP_KEYS_UPDATED`;每次删除都会设置它,行锁也会关注它。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove('still no xid after a read: reads don''t need one',
> > pg_current_xact_id_if_assigned() is null);
> >
> > select lab.prove(
> > 'the deleted row stays on the page at full size, with an xmax and HEAP_KEYS_UPDATED',
> > lp_flags = 1 and lp_len > 0 and t_xmax::text <> '0'
> > and t_ctid = :'deleted_ctid'::tid and 'HEAP_KEYS_UPDATED' = any(raw_flags))
> > from page0 where lp = (:'deleted_ctid'::tid::text::point)[1]::int;
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
>
> xmax 不总是表示删除。没有人动过的 `accounts` 第 42 行,其 xmax 是插入种子事件数据的事务 766,标志位是 `HEAP_XMAX_KEYSHR_LOCK` 和 `HEAP_XMAX_LOCK_ONLY`。每个事件都通过外键引用 `accounts`;为了防止账户在插入过程中被删除,Postgres 在它上面取得了一个轻量级的 `for key share` 行锁。行锁存放在 xmax 中,因此即使是在插入时执行外键检查,也会写入被引用行所在的页。当多个事务同时锁住一行时,xmax 会改为保存一个**多事务 ID(MultiXact)**,指向 `pg_multixact` 中的一个列表;MultiXact 也有自己的回卷限制,[清理一章](/10-vacuum/#basics-chapter-10)也会监视它。关于行锁的一般内容见[大家都得排队](/25-concurrency/#basics-chapter-25)。
> [!DETAILS]- 深入阅读:TRUNCATE 也会把旧快照看到的表清空
>
> 一个可重复读会话先取得自己的快照。另一个会话运行 `truncate imports` 和 `delete from deletes_demo`(每张表各有 500 行)并提交。第一个会话再次查看:
>
> ```text
> imports_seen
> --------------
> 0
>
> deletes_seen
> --------------
> 500
> ```
>
> `delete` 遵守快照。`truncate` 在 ACCESS EXCLUSIVE 锁下换入了一个新的空文件,而旧文件对所有人都消失了。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'an older REPEATABLE READ snapshot sees the truncated table as empty',
> > (select n from dblink('session_a', 'select count(*) from imports') as t(n bigint)) = 0);
> > select lab.prove(
> > 'but still sees all 500 deleted rows',
> > (select n from dblink('session_a', 'select count(*) from deletes_demo') as t(n bigint)) = 500);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## 清理释放表内空间,而不是磁盘空间 {#vacuum-frees-space-inside-the-table-not-on-disk}
现在来测量本章开头的实验。`pgstattuple` 扩展会读取表的每一页,并报告空间的使用情况:
```sql
select table_len, tuple_count, dead_tuple_count, free_percent
from pgstattuple('users');
```
先对刚加载的种子数据运行这项查询,执行 `update users set name = upper(name)` 后再查一次,执行 `vacuum users` 后再查一次:
```text
| table_len | tuple_count | dead_tuple_count | free_percent
--------------+-----------+-------------+------------------+--------------
fresh | 9224192 | 100000 | 0 | 0.84
after update | 18448384 | 100000 | 100000 | 0.84
after vacuum | 18448384 | 100000 | 0 | 50.25
```
更新使表翻了一倍。由于没有一次更新是 HOT(页原本已经填满),两个索引也各自新增了 100,000 个条目。清理移除了死元组,留下一个 18 MB、空闲空间占一半的表。清理产生的是**页内的空闲空间**,而不是磁盘上的空间:它只能把文件末尾的空页交还出去,而这里旧版本填满了前半部分。
这些空间并没有浪费;第二次完整更新复用了它,表仍然是 18 MB,而不是 27 MB。批量更新后的表,会稳定在活跃行加上两次清理之间堆积的死元组所需的大小。多出来的部分就是**膨胀**。少量膨胀很正常,甚至有用。一张表如果膨胀到活跃数据的 5 倍大小,就有问题:每次扫描都要读取 5 倍的页,缓存中能容纳的有用行也减至原来的五分之一。而它就来自应用代码中看起来无害的一件事:一次触及每一行的回填。
> [!DETAILS]- 深入阅读:翻倍背后的检查,以及为什么第二次更新几乎没有 HOT
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'after updating every row: about 18 MB, 100,000 live and 100,000 dead tuples',
> > table_len between 18000000 and 19000000 and tuple_count = 100000 and dead_tuple_count = 100000)
> > from pgstattuple('users');
> >
> > select lab.prove(
> > 'after vacuum: no dead tuples, still about 18 MB, about half of it free space',
> > dead_tuple_count = 0 and table_len between 18000000 and 19000000 and free_percent between 45 and 55)
> > from pgstattuple('users');
> >
> > select lab.prove(
> > 'the next full update reuses the space: still about 18 MB, not 27',
> > pg_relation_size('users') between 18000000 and 19000000);
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
>
> 第二次完整更新几乎没有 HOT:`pg_stat_user_tables` 统计出 100,000 次更新中只有 50 次是 HOT。活跃行被压在表的后半部分,而所有空闲空间都位于其他页上。
> [!TIP] 分批回填
>
> 如果必须更新一张大表中的大多数行,就用每批几千行的方式进行,并在批次之间运行一次清理(或者确保有足够的 [autovacuum](/43-glossary/#autovacuum)),这样后面的批次就能复用前面批次释放的空间。[沿主键分批短距离回填](/26-migrations/#backfill-in-short-batches-that-walk-the-primary-key)给出了这种模式。收缩一张已经膨胀的表需要重写,[清理一章](/10-vacuum/#basics-chapter-10)会介绍。
## 长事务会把一切都拖住 {#long-transactions-hold-everything-back}
清理只有在没有任何快照可能仍然看到一个死元组时,才能移除它。所以数据库中任何地方的一个旧快照,都会拖住每张表的清理。这是失控膨胀最常见的原因之一,而且你可以看着它发生。
会话 A 开启一个[可重复读](/43-glossary/#isolation-level)事务(所以它的快照在事务结束前固定不变),读取一些内容,然后停在那里。`pg_stat_activity` 将它的快照界线显示为 `backend_xmin`,值为 868917:这是 A 取得快照时仍在运行的最老事务。与此同时,会话 B 删除表的一半数据并执行清理:
```sql
-- session B
delete from users_ff100 where id % 2 = 0;
vacuum (verbose) users_ff100;
```
```text
...
tuples: 0 removed, 110000 remain, 60000 are dead but not yet removable
removable cutoff: 868917, which was 2038 XIDs old when operation ended
...
```
**60,000 个死元组尚不能移除**:其中 50,000 个是刚刚删除的,另外 10,000 个来自 fillfactor 实验。截止点恰好是会话 A 的 `backend_xmin`。A 从未碰过 `users_ff100`,这也无关紧要:它的快照早于这次删除,因此它仍可能请求这些行。A 一提交,同样的清理就会移除全部 60,000 个元组,并把表从 1,239 页截断到 1,126 页。
> [!EXAMPLE]- 动手验证 · lab `05-mvcc`
>
> ```sql
> select lab.prove(
> 'vacuum removes nothing: the 50,000 deleted rows are still there, dead but not yet removable',
> dead_tuple_count = 50000) from pgstattuple('users_ff100');
>
> select lab.prove(
> 'once A commits, the same vacuum removes them',
> dead_tuple_count = 0) from pgstattuple('users_ff100');
>
> select lab.prove(
> 'and truncates the table from 1,239 to 1,126 pages',
> pg_relation_size('users_ff100') / 8192 = 1126);
> ```
>
> [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
在生产环境中,阻塞者可能是因为漏掉提交而处于[`idle in transaction`](/43-glossary/#idle-in-transaction)状态的连接,运行了六个小时的分析查询,或者某人在午饭前于 `psql` 中启动后就忘记了的迁移。常见嫌疑包括:长事务(包括打开了 `hot_standby_feedback` 的副本上的事务)、处于 idle-in-transaction 状态的会话(设置 `idle_in_transaction_session_timeout`)、未消费的[复制槽](/43-glossary/#replication-slot),以及被遗忘的预备事务。当任意事务打开超过几分钟时就发出告警;[清理无法移除旧快照可能需要的内容](/10-vacuum/#vacuum-cant-remove-what-an-old-snapshot-might-need)给出了找出这些对象的查询。
## 旧行必须在 XID 计数器回卷前被冻结 {#old-rows-must-be-frozen-before-the-xid-counter-wraps}
磁盘上的 XID 是 32 位的,Postgres 会在一个圆环上比较它们,因此如果某一行的 xmin 落后超过大约 21 亿个事务,它突然就会看起来像来自未来,然后消失。清理通过**冻结**旧行来防止这种情况:把它们标记为永远对所有人可见;如果一页上的所有行都已冻结,后续每次清理都会跳过这一页。如果冻结落后了,通常是因为某些东西把 xmin 界线拖住,Postgres 就会停止接受写入;[回卷会在任何内容损坏前停止写入](/10-vacuum/#wraparound-stops-writes-before-anything-is-corrupted)会介绍设置、监控和恢复。
> [!DETAILS]- 深入阅读:冻结是两个本来不可能共存的提示位
>
> `relfrozenxid` 是表对“没有未冻结元组比这更老”的保证;`account_usage` 的值是 869572,比当前事务老 27 个。显式冻结它(账户 4 的已删除行也会在这次清理中移除):
>
> ```sql
> vacuum (freeze) account_usage;
>
> select lp, combined_flags,
> 'HEAP_XMIN_COMMITTED' = any(raw_flags) as committed,
> 'HEAP_XMIN_INVALID' = any(raw_flags) as invalid
> from heap_page_items(get_raw_page('account_usage', 0)),
> heap_tuple_infomask_flags(t_infomask, t_infomask2)
> where lp_flags = 1;
> ```
>
> ```text
> lp | combined_flags | committed | invalid
> ----+--------------------+-----------+---------
> 4 | {HEAP_XMIN_FROZEN} | t | t
> 5 | {HEAP_XMIN_FROZEN} | t | t
> 6 | {HEAP_XMIN_FROZEN} | t | t
> ```
>
> 冻结会同时设置“已提交”和“无效”两个提示位;其他情况下这组组合没有意义。两者同时出现就表示已冻结。原始 xmin 仍然保留,便于调试,但之后不再查询它。`relfrozenxid` 跳到当前值(年龄为 1),可见性映射把第 0 页标记为全可见和全冻结。正常运行时你永远不需要手动执行 `vacuum freeze`;autovacuum 会在常规工作中完成冻结。
>
> > [!EXAMPLE]- 动手验证 · lab `05-mvcc`
> >
> > ```sql
> > select lab.prove(
> > 'after vacuum (freeze), every live tuple is HEAP_XMIN_FROZEN: committed and invalid together',
> > count(*) = 3 and bool_and('HEAP_XMIN_FROZEN' = any(combined_flags))
> > and bool_and('HEAP_XMIN_COMMITTED' = any(raw_flags) and 'HEAP_XMIN_INVALID' = any(raw_flags)))
> > from page0 where lp_flags = 1;
> >
> > select lab.prove(
> > 'the visibility map marks the page all-visible and all-frozen',
> > all_visible and all_frozen) from pg_visibility_map('account_usage') where blkno = 0;
> > ```
> >
> > [完整实验脚本](https://www.flagon.io/books/eight-kilobytes/lab/05-mvcc.sql)
## 隔离级别主要决定何时取得快照 {#isolation-levels-mostly-decide-when-the-snapshot-is-taken}
快照也解释了隔离级别:一个级别改变的主要是**取得快照的时机**。读已提交是默认级别,每条语句取得一个快照,所以同一事务中的两次 `select` 可能看到不同的数据。可重复读和可串行化则每个事务取得一个快照,因此更新一行时,如果它在取得快照之后被别人修改过,更新就会因串行化错误而失败,并且应用必须重试([只有可串行化能排除所有异常](/09-acid/#only-serializable-rules-out-every-anomaly)和[大家都得排队](/25-concurrency/#basics-chapter-25)会继续介绍)。无论处于哪个级别,打开的事务都会让其快照拖住清理。让事务尽量短。
## 本章要点 {#the-short-version}
- Postgres 从不原地更新一行。`update` 写入一个完整的新版本,并用更新者的 XID 标记旧版本;`delete` 只做标记。两者都会留下死元组。
- 快照决定查询看到每一行的哪个版本,因此读者和写者不会互相阻塞。
- 当没有索引列发生变化且新版本能放入同一页时,HOT 更新会跳过所有索引。对于每次更新都会变化的列,不要在没有权衡代价的情况下给它们建索引。
- 清理会把死元组变成表内可复用的空间,很少缩小文件。大型更新要分批执行。
- 一个长时间运行或处于 idle-in-transaction 状态的会话,会阻塞整个数据库的清理。要按事务年龄告警。
- 旧行必须在其 XID 落后大约 20 亿个事务之前被冻结;清理一章会介绍如何监视这一点。
- 第一次读取刚加载的行时会写入提示位;批量加载后,在用户访问数据前运行 `vacuum analyze`。
## 延伸阅读 {#further-reading}
- [Concurrency control: introduction](https://www.postgresql.org/docs/18/mvcc-intro.html)和[transaction isolation](https://www.postgresql.org/docs/18/transaction-iso.html),PGDG。官方模型,以及每个隔离级别究竟保证什么。
- [Preventing transaction ID wraparound failures](https://www.postgresql.org/docs/18/routine-vacuuming.html#VACUUM-FOR-WRAPAROUND),PGDG。冻结、年龄设置,以及接近限制时会发生什么。
- [src/backend/access/heap/README.tuplock](https://github.com/postgres/postgres/blob/master/src/backend/access/heap/README.tuplock),PostgreSQL 源码。行锁和 MultiXact 如何存放在 `xmax` 中。
- [Hint Bits](https://wiki.postgresql.org/wiki/Hint_Bits),PostgreSQL Wiki。进一步了解为什么读取也可能写入。
- [Concurrency control](https://www.interdb.jp/pg/pgsql05.html),Hironobu Suzuki,《The Internals of PostgreSQL》。通过图示逐步讲解可见性规则。