跳转到主要内容

5 缓冲区缓存决定哪些页留下

介绍 shared_buffers 如何查找、保留、驱逐和写出页,如何查看缓存内容并在重启后预热,以及每个后端的私有内存去了哪里。

读一遍一张九页的表,Postgres 会给它的每个页一个点。再读一遍:两个点。到第五次读取时,每个页都有五个点,计数也就到此为止。那些点,以及一只在缓存中转圈、不断扣除点数的手,决定哪些页留在内存中、哪些页离开。这就是整个驱逐策略,可以用一句话说清。

一个页的读取成本取决于它在哪里,可能是几微秒,也可能是几毫秒(一个页有三种位置)。本章讲的就是决定它位于何处的机制。之后还会讲每个连接为自己保留的内存;真正让服务器耗尽 RAM 的就是这部分。下面的所有内容都运行在实验套件默认的 128 MB shared_buffers 上,并通过 pg_buffercache 扩展检查。

shared_buffers 是一个页数组

shared_buffers 是一个由 8 KB 槽位组成的大数组,这些槽位称为缓冲区,在启动时分配到共享内存中。每个进程都通过它读取和写入页。默认的 128 MB 对应 16,384 个缓冲区。

把它想成存包处:一排编号的挂钩,每个挂钩都有一张票。每个缓冲区的票是一份 64 字节的描述符,其中包含标记它所保存页面的标签(文件、分支文件和块号)、当前正在使用它的进程数、使用计数,以及它是否已经在内存中变更但还没有写出(即是否为脏页)。pg_buffercache 会为每个缓冲区显示一行,并解码这些字段;下面的例子通过 cached 读取它。这是一个建立在 pg_buffercache 上的小视图,只保留当前数据库的表,并给它们标上名称。

深入阅读:共享内存中的缓冲池是什么样的

pg_shmem_allocations(PostgreSQL 13+)会列出其中的组成部分:

select name, pg_size_pretty(size) as size
from pg_shmem_allocations
where name in ('Buffer Blocks', 'Buffer Descriptors');
        name        |  size
--------------------+---------
 Buffer Blocks      | 128 MB
 Buffer Descriptors | 1024 kB

Buffer Blocks 是 128 MB 的页(外加 4 KB 的对齐空间)。Buffer Descriptors 正好是 1 MB:16,384 个描述符各占 64 字节,并按一个 CPU 缓存行对齐;这样,两个进程更新相邻描述符时就不会争用同一缓存行。

cached 视图把 pg_buffercache 连接到 pg_class。它除了文件编号,还会按数据库过滤,因为从同一个模板克隆出来的数据库会从相同的文件编号开始:

create view cached as
select c.relname, b.bufferid, b.relblocknumber,
       b.usagecount, b.isdirty, b.pinning_backends
from pg_buffercache b
join pg_class c
  on b.relfilenode = pg_relation_filenode(c.oid)
 and b.reldatabase = (select oid from pg_database
                      where datname = current_database())
 and b.relforknumber = 0;   -- the main fork: the table's own pages

整个服务器都在使用共享内存:除了 shared_buffers,还有 WAL 缓冲区、锁表和其他部分。show shared_memory_size 在实验套件上报告 152 MB;规划 RAM 和 Linux 大页时要围绕这个数字进行(内存:先做预算,再调参数;PostgreSQL 15+ 的 shared_memory_size_in_huge_pages 在这里报告 76)。

动手验证 · lab 04-buffers
select lab.prove(
  'the buffer pool is one 128 MB block of shared memory (plus 4 KB of alignment)',
  (select size from pg_shmem_allocations where name = 'Buffer Blocks') = 16384 * 8192 + 4096);

select lab.prove(
  'each buffer has a 64-byte descriptor: 16,384 of them take exactly 1 MB',
  (select size from pg_shmem_allocations where name = 'Buffer Descriptors') = 16384 * 64);

select lab.prove(
  'pg_buffercache shows one row per buffer',
  (select count(*) from pg_buffercache) = 16384);

完整实验脚本

找到一个页只需要一次哈希查找

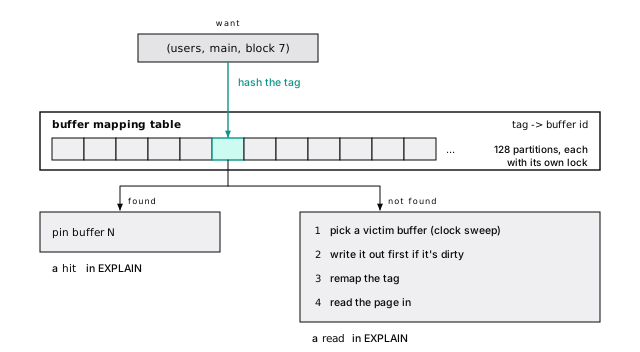
想要访问 users 的 7 号块的后端进程,不会搜索 16,384 个描述符。它会对标签进行哈希,然后在缓冲区映射表中查找;这是一张把标签映射到缓冲区的共享哈希表:

找到一个页只需要一次哈希查找。标签会落入 128 个分别加锁的分区之一。命中后钉住缓冲区即可完成;未命中则必须驱逐一个受害者,必要时先把它写出,再读入目标页。
图 5-1 找到一个页只需要一次哈希查找。标签会落入 128 个分别加锁的分区之一。命中后钉住缓冲区即可完成;未命中则必须驱逐一个受害者,必要时先把它写出,再读入目标页。

命中只是在 128 个分别加锁的分区之一中快速查找,因此后端进程很少互相等待。未命中则要做真正的工作。当许多会话都在等待 BufferMapping(没有等待事件的活动会话正在 CPU 上运行)时,它们是在同时未命中:这说明工作集装不进缓存,而不是需要调节某把锁。

钉住意味着“正在使用”

后端进程接触一个页之前,会先钉住这个缓冲区。被钉住的缓冲区不能被驱逐,所以在读取期间页会留在原处。钉住的时间通常很短,但只要查询还停留在某个页上,它就会持续存在:打开的游标,或读到一半就停止接收数据的慢客户端,都会让它所在的页保持钉住。这会影响清理。清理只能处理没有被任何人钉住的页,因此一个停放的游标会让清理跳过该页,或在 BufferPin 事件上等待(清理不可省)。

深入阅读:打开的游标会钉住什么

在 accounts 上打开一个游标,取出一行,cached 会显示 0、1、2 号块分别被一个后端进程钉住。游标持有 0 号块,因为它取出的行来自那里。1、2 号块也会被钉住:从 PostgreSQL 17 开始,顺序扫描会通过“读取流”读取数据,提前钉住后面的几个页,让它们的 I/O 可以先行进行。在这些钉住存在期间,pg_buffercache_evict()(PostgreSQL 17+,超级用户专用,仅用于测试)会拒绝驱逐这些缓冲区。提交事务后,同一个调用就会成功。

动手验证 · lab 04-buffers
begin;
declare c cursor for select * from accounts;
fetch 1 from c \g /dev/null

select lab.prove(
  'an open cursor holds a pin on the page it is reading (and PostgreSQL 18 pins a few pages ahead)',
  :pinned between 1 and 9);

select lab.prove(
  'a pinned buffer cannot be evicted',
  not (select buffer_evicted from pg_buffercache_evict(:pinned_buf)));
commit;

完整实验脚本

每次读取都会增加使用计数

每次钉住还会增加缓冲区的使用计数,最高为 5:这是缓存记住一个页有多热门的方式。驱逐 accounts(九个页),扫描它,然后计数:

 after 1 scan            after 2 scans           after 5 scans
 usagecount | buffers    usagecount | buffers    usagecount | buffers
------------+--------   ------------+--------   ------------+--------
          1 |       9             2 |       9             5 |       9

扫描一次,每个页得到一个点。扫描五次,得到五个点,此后就保持不变。

动手验证 · lab 04-buffers
select count(*) from accounts \g /dev/null
select lab.prove(
  'one scan: all 9 pages cached, each with usage count 1',
  (select count(*) from cached where relname = 'accounts' and usagecount = 1) = 9);

select count(*) from accounts \g /dev/null
select lab.prove(
  'five scans: usage count 5, the maximum',
  (select count(*) from cached where relname = 'accounts' and usagecount = 5) = 9);

完整实验脚本

时钟扫描挑选受害者

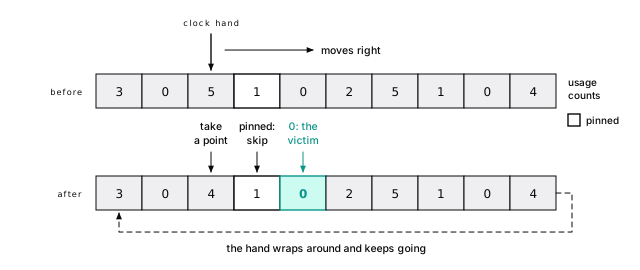
当后端未命中且所有缓冲区都已被占用时,总得有东西离开。Postgres 不维护一个最近最少使用列表(每次命中都维护它,需要一把全局锁)。它运行的是时钟扫描:

指针经过每个缓冲区时都会扣除一个点。它会跳过被钉住的缓冲区,并驱逐找到的第一个计数为零的缓冲区。一个不断读取的页在指针转回来前早已恢复到 5,因此永远不会走到这一步。
图 5-2 指针经过每个缓冲区时都会扣除一个点。它会跳过被钉住的缓冲区,并驱逐找到的第一个计数为零的缓冲区。一个不断读取的页在指针转回来前早已恢复到 5,因此永远不会走到这一步。

一个页只读取一次,可以撑过指针的一轮经过。持续读取的页早在指针转回来之前就恢复到 5,因此不会降到零。这里有两个后果:

  • 冷数据的一次扫描不会挤出热点集合。 冷页进入时计数为 1,最先离开;如果是严格的最近最少使用缓存,所有更早的页都会被驱逐。
  • 热门程度取决于更换速度。 指针移动得和后端未命中的速度一样快。未命中很多时,它就会旋转得很快,连热门页也会在两次访问之间掉出去。未命中会造成更多未命中;工作集超过缓存时,就是这样突然跌落的。

深入阅读:观察时钟扫描驱逐洪流

从空缓存开始:pg_buffercache_evict_all()(PostgreSQL 18,仅用于测试;永远不要在你在意的服务器上运行)会丢弃所有未钉住的页。读取 accounts 五次,让它的页都处于 5。然后向缓存中灌入数据:pg_prewarm 通过正常路径读取 events 的前 20,000 个页,超过缓存中的 16,384 个缓冲区。

select * from pg_buffercache_evict_all();
select count(*) from accounts;   -- five times
select pg_prewarm('events', 'buffer', 'main', 0, 19999);

select relname, count(*) as buffers,
       min(relblocknumber) as first_block, max(relblocknumber) as last_block,
       min(usagecount) as min_usage, max(usagecount) as max_usage
from cached
where relname in ('accounts', 'events')
group by relname;
 relname  | buffers | first_block | last_block | min_usage | max_usage
----------+---------+-------------+------------+-----------+-----------
 accounts |       9 |           0 |          8 |         3 |         3
 events   |   16335 |        1352 |      19999 |         0 |         1

洪流自身已经有 3,600 多个页消失,被后来读入的新页驱逐了;而 accounts 的九个页都存活下来,只是在指针每轮经过时少了一个点。哪些较早的洪流页会消失,取决于指针当时停在哪里(在我们的运行中,有时最前面的一千个全消失,有时一个也没有)。整体形状不会改变。

pg_buffercache_usage_counts()(PostgreSQL 16+)会给出全服务器的分布。在共享实验服务器上,十几个实验同时运行时,16,384 个缓冲区中有 13,578 个处于 0 或 1,只有 295 个处于 5:这说明缓存太小,或者正在被一次性读取全部数据的工作不断扫过。稳定负载下、真正发挥作用的缓存,在 4 和 5 处会有一条较厚的尾部。

动手验证 · lab 04-buffers
select * from pg_buffercache_evict_all() \g /dev/null
-- ... five scans of accounts ...
select pg_prewarm('events', 'buffer', 'main', 0, 19999) as prewarmed \gset

select lab.prove(
  'the flood evicted thousands of its own pages; its newest 2,000 are all still cached',
  (select count(*) from cached where relname = 'events') < 20000 - 3000
  and (select count(*) from cached where relname = 'events' and relblocknumber >= 18000) = 2000);

select lab.prove(
  'the 9 accounts pages at usage count 5 survived the flood, losing a point per pass',
  (select count(*) from cached where relname = 'accounts') = 9
  and (select max(usagecount) from cached where relname = 'accounts') < 5);

完整实验脚本

你的查询不该负责写出脏页

update 会改变缓冲区中的页,并将它标记为脏页;数据文件并没有被触碰。变更已经记录在预写式日志中,而日志必须先到达磁盘,数据页才能写出(检查点限制恢复时间)。之后,页会由三类进程之一写入文件:

谁何时理想占比
检查点进程每个检查点写出所有脏缓冲区大部分写入
后台写入器持续运行,在时钟指针到达之前提前写出一部分
任意后端进程它选中的受害缓冲区为脏时少量
表 5-1 你的查询不该负责写出脏页

留意最后一行。后端进程选中一个脏受害者后,必须在重新使用缓冲区之前先把它写出,于是查询会等待。如果后端进程持续承担稳定比例的页写入,说明 shared_buffers 对写入负载来说太小了。pg_stat_io(PostgreSQL 16+)会按进程类型统计写入(pg_stat_io 会发现后端写出脏页(PostgreSQL 16+))。

深入阅读:脏页、后台写入器,以及一个替别人买单的后端进程

更新 50 个账户后,cached 在我们的运行中显示两个脏页:一个保存旧的行版本,另一个接收新的行版本(更新就是插入解释了为什么会有两个)。

检查点进程会写出检查点开始时所有处于脏状态的缓冲区,这样恢复就可以从那里开始。后台写入器每 200 ms(bgwriter_delay)唤醒一次,找出时钟指针即将到达的脏缓冲区,并写出其中最多 100 个:使用默认值时每秒最多 4 MB。后端进程在别无选择时才写出;pg_buffercache_evict() 展示了这条规则:驱逐脏缓冲区之前,先将它刷新出去:

 buffer_evicted | buffer_flushed
----------------+----------------
 t              | t

在我们的共享测试服务器上,其他实验批量加载数据时,一个只运行了一次扫描的后端进程不得不写出其他会话留下的 2,909 个脏页,才能腾出空间。

动手验证 · lab 04-buffers
update accounts set name = name where id <= 50;

select lab.prove(
  'an update dirties the pages it changes in memory; nothing is written to the table file yet',
  (select count(*) from cached where relname = 'accounts' and isdirty) >= 1);

select bufferid as dirty_buf from cached where relname = 'accounts' and isdirty limit 1 \gset
select lab.prove(
  'to reuse a dirty buffer, the evicting process must write the page out first',
  (select buffer_evicted and buffer_flushed from pg_buffercache_evict(:dirty_buf)));

完整实验脚本

大型操作会使用环

一个每晚通过 128 MB 缓存读取 275 MB 的报告,如果没有任何限制,就会把缓存冲垮。确实有一个限制。访问大量页、但每页只访问一次的操作会得到一个缓冲区环:一小组由操作私有、可以循环使用的缓冲区;操作会从这里反复取用缓冲区,而不是从时钟指针那里拿新的,所以驱逐的是自己的页,而不是你的页。

操作环默认大小
大于 shared_buffers / 4 的表的顺序扫描bulkread256 KB,外加容纳在途 I/O 的空间:PostgreSQL 18 中为 2,304 KB
VACUUM 和 ANALYZEvacuumvacuum_buffer_usage_limit,2 MB(该设置从 PostgreSQL 16+ 开始;17 将默认值从 256 KB 提高了)
COPY FROM 和 CREATE TABLE ASbulkwrite16 MB
表 5-2 大型操作会使用环

扫描阈值是 shared_buffers 的四分之一,也就是这里的 4,096 个页。在空缓存中分别扫描一次 events(35,173 个页)和 users(1,126 个页),并关闭并行工作进程:

 relname | pages | cached after one scan
---------+-------+-----------------------
 events  | 35173 |                     94
 users   |  1126 |                   1126

小表会完整留在缓存中。大表通过自己的环,只留下不到 288 个缓冲区;这就是 2,304 KB 环的大小(确切数量会随运行而变化)。

写入会带来一个意外:insert ... select 没有环。用两种方式分别加载同样的两百万个整数;COPY 会在缓存中留下一个 16 MB 的环,即 2,048 个页,并在过程中写出自己的页。insert ... select 则会把全部 8,850 个页留在 shared_buffers 中,占 128 MB 缓存中的 69 MB,并把脏缓冲区留给别人写出。要向新表回填数据,使用 COPY 或 create table as 才是礼貌的做法。

环保护缓存,不保护磁盘

环会阻止一个操作驱逐其他人的页,但对 I/O 毫无帮助:报告仍然要读取全部 35,173 个页,而且因为这些页不会留下来,下一次运行仍然要全部读取。如果大型扫描频繁到值得关注,它需要索引或汇总表,而不是更大的缓存。

深入阅读:2,304 KB 环从何而来,以及 COPY 实验

环的大小不会超过 shared_buffers 的八分之一。PostgreSQL 18 的批量读取环之所以大于经典的 256 KB,是因为异步读取需要有缓冲区承接数据:在 256 KB 之外,再加上 8 KB 乘以 io_combine_limit(16)乘以 effective_io_concurrency(16)的空间,总共是 288 个缓冲区。后端进程自己的 I/O 计数器 pg_stat_get_backend_io()(PostgreSQL 18)显示,上面的全表扫描在 bulkread 上下文中重复使用了超过 35,000 次缓冲区。开启并行工作进程后,每个工作进程都有自己的环。

写入实验:

create table copied (n bigint);
copy copied from program 'seq 1 2000000';

create table inserted (n bigint);
insert into inserted select generate_series(1, 2000000);
 relname  | pages | cached
----------+-------+--------
 copied   |  8912 |   2048
 inserted |  8850 |   8850

copied 多出 62 个页:COPY 一次扩展文件很多个页,最后一批仍然是空的。因为装满新行的环缓冲区是脏的,COPY 会在循环复用缓冲区时写出自己的页。这是有意的:批量加载会自己承担写出成本,而不是把它交给后台写入器和其他后端进程的驱逐操作。

动手验证 · lab 04-buffers
select * from pg_buffercache_evict_relation('events') \g /dev/null
select count(kind) from events \g /dev/null
select count(*) as events_cached from cached where relname = 'events' \gset

select lab.prove(
  'a full scan of events leaves at most one ring (288 buffers) of it in shared_buffers',
  :events_cached <= 288);

select lab.prove(
  'COPY leaves at most its 16 MB ring (2,048 buffers) of its pages in the cache',
  :copy_pages between 8850 and 8850 + 64 and :copy_cached <= 2048 + 64);

select lab.prove(
  'INSERT ... SELECT gets no ring: it extends the table through the normal buffer pool',
  (:'bw3'::jsonb ->> 'extends')::bigint = (:'bw2'::jsonb ->> 'extends')::bigint
  and (:'nw3'::jsonb ->> 'extends')::bigint - (:'nw2'::jsonb ->> 'extends')::bigint > 0);

完整实验脚本

临时表使用本地缓冲区

临时表永远不会进入 shared_buffers。每个会话会把它们缓存在私有的本地缓冲区中,默认 temp_buffers 为 8 MB;更大的临时表在每次扫描时都会从自己的文件读取。这个设置只能在会话第一次接触临时表之前提高,所以如果应用会创建大型临时表(报表、导入、暂存),请按角色设置:alter role reporting set temp_buffers = '64MB'。

深入阅读:大于本地缓冲区的临时表
create temp table recent as select * from events where id <= 100000;
explain (analyze, costs off, timing off, summary off)
select count(kind) from recent;
 Aggregate (actual rows=1.00 loops=1)
   Buffers: local read=1792 dirtied=1759 written=1759
...

通过 8 MB 的缓冲区读取 14 MB:之后的每次扫描都会再次读取全部 1,792 个页,因为顺序扫描总会驱逐它接下来需要的页。(第一次扫描还设置了提示位,并将页写回。)现在再提高设置会失败:

ERROR:  invalid value for parameter "temp_buffers": 8192
DETAIL:  "temp_buffers" cannot be changed after any temporary tables have been
accessed in the session.

在一个先执行 set temp_buffers = '32MB' 的新会话中,同样的扫描会显示 Buffers: local hit=1792。

动手验证 · lab 04-buffers
select lab.plan($$ select count(kind) from recent $$) as tp \gset
select lab.prove(
  'every scan of it reads all 1,792 pages again: local buffers are per session and too small',
  (:'tp'::jsonb -> 'Plan' ->> 'Local Read Blocks')::int = 1792
  and coalesce((:'tp'::jsonb -> 'Plan' ->> 'Shared Hit Blocks')::int, 0)
    + coalesce((:'tp'::jsonb -> 'Plan' ->> 'Shared Read Blocks')::int, 0) = 0);

select lab.prove(
  'temp_buffers cannot be changed once the session has used a temp table',
  pg_temp.try_set_temp_buffers() like 'invalid value for parameter "temp_buffers"%');

select lab.prove(
  'with temp_buffers = 32MB set first, the same table is read entirely from local buffers',
  (:'t_p'::jsonb ->> 'Local Hit Blocks')::int = 1792
  and coalesce((:'t_p'::jsonb ->> 'Local Read Blocks')::int, 0) = 0);

完整实验脚本

操作系统页缓存是第二层

在 shared_buffers 中未命中,仍有可能命中内核的页缓存。环使大型扫描每次运行时都要到这一层查找页,因此第二层缓存能让重复运行的报告撑得住;这也是建议把 shared_buffers 保持在 RAM 的四分之一左右,而不是占大多数的原因之一(shared_buffers 从 RAM 的 25% 起步,而不是 80%)。

使用计数为 1 的大表需要索引,而不是内存

SQL 可以观察到上面的一切。下面的查询会按当前数据库各表和索引占用的缓存大小排序:

select c.relname,
       count(*)                                            as buffers,
       pg_size_pretty(count(*) * 8192)                     as cached,
       round(100.0 * count(*) / greatest(c.relpages, 1), 1) as pct_of_rel,
       round(avg(b.usagecount), 1)                         as avg_usage,
       count(*) filter (where b.isdirty)                   as dirty
from pg_buffercache b
join pg_class c
  on b.relfilenode = pg_relation_filenode(c.oid)
 and b.reldatabase = (select oid from pg_database
                      where datname = current_database())
group by c.relname, c.relpages
order by buffers desc
limit 10;

结合时钟指针来读这个查询。大部分页已被缓存、平均使用计数接近 5 的表就是热点集合,值得占据缓存。一个大表占据了缓存的很大比例,但使用计数只有 1,说明它只被读取了一次就被替换;这时需要的是索引,而不是更多内存。这个查询会遍历每个缓冲区,因此按需运行;pg_buffercache_usage_counts()(PostgreSQL 16+)是便宜的全服务器检查,而大多数缓冲区都在 0 或 1,说明缓存正在不断周转。

重启后预热缓存

重启会清空 shared_buffers,故障切换到缓存了不同页的副本也会如此。在接下来的一个小时里,原本命中内存的每个查询都会转向操作系统缓存或磁盘;在网络存储上,这可能是一周中最慢的一个小时。pg_prewarm(一个 contrib 扩展)按需加载关系:select pg_prewarm('users') 加载了全部 1,126 个页,随后的一次全表扫描全部命中。

autoprewarm 恢复上一次缓存

手工选择表只是猜测。autoprewarm 是同一扩展的一部分,它会记录缓存中的内容,并在重启后将其放回去:

shared_preload_libraries = 'pg_stat_statements,pg_prewarm'   # restart required
pg_prewarm.autoprewarm = on              # the default once the library is loaded
pg_prewarm.autoprewarm_interval = 300s   # how often to save the list (default)

后台工作进程每 5 分钟保存一次缓存块列表,并在关机时保存;服务器接受连接的同时,它会在启动时将这些块重新加载。备库上也会运行它,因此故障切换后,新的主库可以从自己的热缓存列表开始。它每隔几分钟只需写入一个小文件;把它打开吧(托管服务可能不允许你这样做:扩展来自允许列表)。

深入阅读:pg_prewarm 的模式,以及 autoprewarm 写下了什么
create extension pg_prewarm;

select * from pg_buffercache_evict_relation('users');
select pg_prewarm('users');
 pg_prewarm
------------
       1126

它也适用于索引(users_pkey 有 276 个页),并接受一个分支文件和块范围。预热的页没有特殊待遇:它们从使用计数 1 开始;预热一张大于 shared_buffers 的表,就是前面所说的洪流。另有两种模式会绕过 shared_buffers:'read' 和 'prefetch',适用于大到装不进它、但仍能放进 RAM 的关系。autoprewarm 的列表是一个小型文本文件 autoprewarm.blocks,每个块占一行;select autoprewarm_dump_now() 可以按需保存它。

动手验证 · lab 04-buffers
select * from pg_buffercache_evict_relation('users') \g /dev/null
select pg_prewarm('users') as users_prewarmed \gset

select lab.prove(
  'pg_prewarm(''users'') loads all 1,126 pages and says so',
  :users_prewarmed = 1126
  and (select count(*) from cached where relname = 'users') >= 1100);

select lab.prove(
  'after prewarming, a full scan of users is all hits',
  (lab.plan($$ select count(email) from users $$) -> 'Plan' ->> 'Shared Read Blocks')::int = 0);

完整实验脚本

effective_cache_size 是提示,不是内存

effective_cache_size 不分配任何东西。它告诉规划器两层缓存中可能已有多少数据,数值越大,索引扫描看起来就越便宜。把它设置为机器 RAM 的 50% 到 75%(effective_cache_size 是一个提示:设置为 RAM 的 50% 到 75%)。

深入阅读:一个设置就能改变计划,却不分配一个字节
set effective_cache_size = '1MB';
explain select * from users order by account_id, email limit 30000;

reset effective_cache_size;   -- the default, 4GB
explain select * from users order by account_id, email limit 30000;
 Limit  (cost=10062.34..10137.34 rows=30000 width=55)
   ->  Sort  (cost=10062.34..10312.34 rows=100000 width=55)
         Sort Key: account_id, email
         ->  Seq Scan on users  (cost=0.00..2126.00 rows=100000 width=55)

 Limit  (cost=0.42..2720.65 rows=30000 width=55)
   ->  Index Scan using users_account_id_email_key on users  (cost=...)

1 MB 时,规划器假设通过索引获取的几乎每个页都是一次新的随机读取,于是改为对顺序扫描排序。4 GB 时,它会遍历索引。内存没有任何变化;任何会话都可以设置这个值。代价模型本身位于规划器也在估算中。

后端内存是私有的

到这里讲的都是共享部分。每个后端进程还有私有内存,随着工作分配,其他进程看不见:空闲时一两 MB,执行查询时达到一百 MB 或更多(内存:空闲 1.5 MB,排序中 109 MB同时测量了两种情况)。其中大部分由两件事决定:查询的工作内存,以及系统目录的缓存。

最大的内存上下文会指出罪魁祸首

Postgres 会在内存上下文中分配内存;这些上下文是按树排列的内存区域,工作结束时会释放整个上下文,例如查询结束时释放该查询的上下文。pg_backend_memory_contexts(PostgreSQL 14+)会显示当前后端进程自己的树;如果要查看另一个后端,比如一个已经增长到 2 GB 的连接池连接,pg_log_backend_memory_contexts(pid) 会把它的树写入服务器日志。最大的上下文会指出罪魁祸首。

work_mem 是按节点计算的,而且可以看到

work_mem(默认 4 MB)限制的是计划中的每个排序或哈希步骤,而不是每个查询。一个归并连接同时包含两个排序,就会同时持有两份额度:我们捕获过一个查询,其中两个 Sort 节点各持有刚刚超过 4 MB。再加一个哈希连接,就是第三份额度,大小是 work_mem 的两倍(使用默认的 hash_mem_multiplier)。乘以连接数,你就知道为什么我们让全局 work_mem 保持适度,并按角色或按事务提高它(work_mem:提高之前先乘一遍)。

深入阅读:同时捕获内存中的两个排序

把这个连接查询声明为游标并取出一行,这样两个排序都会完成并保留在内存中:

set enable_hashjoin = off;
set enable_nestloop = off;
begin;
declare two_sorts cursor for
  select *
  from (select user_id, created_at from events where id <= 300000) a
  join (select user_id, created_at from events where id > 1700000) b
    using (user_id);
fetch 1 from two_sorts;

select name, level, total_bytes
from pg_backend_memory_contexts
where name like 'TupleSort%';
      name      | level | total_bytes
----------------+-------+-------------
 TupleSort main |     5 |        8192
 TupleSort sort |     6 |     4202856
 TupleSort main |     5 |        8192
 TupleSort sort |     6 |     4202856

每个排序都达到自己的 work_mem 上限;每个 300,000 行输入的其余部分都溢出到了临时文件。

动手验证 · lab 04-buffers
select lab.prove(
  'one query, two Sort nodes, two work_mem allowances: each sort holds about 4 MB',
  :sorts = 2
  and :smallest between 3.5 * 1024 * 1024 and 4.5 * 1024 * 1024
  and :largest between 3.5 * 1024 * 1024 and 4.5 * 1024 * 1024);

完整实验脚本

目录缓存只会增长

为了规划查询,后端进程需要表的定义;它会把从系统目录读取的内容缓存起来,并一直保留到连接结束。下面是一条连接在 1,000 张小表上分别运行一个简单查询后的情况:

 CacheMemoryContext and its children
 -----------------------------------
 fresh connection            731 kB
 after touching 1,000 tables  10 MB
 after DISCARD ALL            10 MB
 new connection              731 kB

每张表及其索引在每个访问过它们的后端进程中约占 9 KB;连接池在客户端之间运行的 discard all 并不会把这些内存还回来。10,000 个分区和 200 个连接池连接,就会产生几 GB 的 RAM,而这些内存不会出现在任何计划中。

回收连接:给连接池中的服务器连接设置最长生命周期(PgBouncer的 server_lifetime 默认是 3,600 秒)。一个小时的增长是有上限的,一个月则不是。还有,如果租户映射到模式,不要让每个租户都经过每个连接(不要信任任何租户会介绍共享表租户模型)。

深入阅读:我们怎样把一个连接增长到 10 MB
create schema tenants;
-- create tenants.t1 .. tenants.t1000, each:
--   (id bigint primary key, account_id bigint not null,
--    body text, created_at timestamptz)

do $$ begin
  for i in 1..1000 loop
    execute format('select count(*) from tenants.t%s where id = 1', i);
  end loop;
end $$;

内存上下文的源码 README 说,CacheMemoryContext 从不重置或删除:它持有关系缓存(每个打开的表或索引一个条目)和目录缓存(目录本身的行)。

动手验证 · lab 04-buffers
select lab.prove(
  'touching 1,000 small tables grows them by more than 5 MB',
  :touched - :fresh > 5 * 1024 * 1024);

select lab.prove(
  'DISCARD ALL gives none of it back',
  :discarded >= :touched * 0.95);

select lab.prove(
  'a new connection starts small again',
  :reconnected < 2 * 1024 * 1024);

完整实验脚本

本章要点

  • shared_buffers 是一个由 8 KB 缓冲区组成的数组。时钟扫描会驱逐它遇到的第一个未钉住且使用计数为 0 的缓冲区,并从经过的每个缓冲区扣除一个点:热点页会不断得分,只读一次的页一轮之后就会离开。
  • 变更会让内存中的缓冲区变脏。检查点进程应该写出其中大多数;写出自己选中的受害者的后端进程是在等待 I/O。检查 pg_stat_io。
  • 大型扫描、VACUUM 以及 COPY 或 create table as 会使用小环,不会冲刷你的缓存。insert ... select 不会,所以批量加载时优先使用 COPY 或 create table as。
  • 临时表使用每个会话自己的 temp_buffers;如果会创建大型临时表,请按角色设置。
  • 用 pg_buffercache 查看缓存内容;打开 autoprewarm,重启或故障切换后就能恢复热缓存。
  • effective_cache_size 是一个可能改变计划的规划器提示;它不分配内存。
  • work_mem 按每个排序或哈希节点计算;连接接触的每张表都会让目录缓存增长,而且不会缩小。在连接池中限制连接生命周期。

延伸阅读

  • src/backend/storage/buffer/README,PostgreSQL 源码。缓冲区管理器自己的设计说明:钉住、内容锁、映射分区、时钟扫描和缓冲区环。
  • pg_buffercache,PGDG。每个字段和函数,包括摘要、使用计数、驱逐函数及其版本说明。
  • pg_prewarm,PGDG。预热模式和 autoprewarm 设置。
  • Resource consumption settings,PGDG。shared_buffers、temp_buffers、work_mem、vacuum_buffer_usage_limit 和后台写入器设置。
  • src/backend/utils/mmgr/README,PostgreSQL 源码。内存上下文的工作方式,以及它们各自会存活多久。

表格阅读