跳转到主要内容

4 一切都从页说起

打开表背后的文件和页,逐字节读取行头,并设计能在每个 8 KB 页中容纳更多行的表。

下面是两张拥有同样六列、保存同样一百万行的表:

 relname | size  | pages
---------+-------+-------
 padded  | 73 MB |  9346
 packed  | 57 MB |  7353

唯一的区别是声明列的顺序。其中一张比另一张大 27%:要永久扫描、缓存、备份和复制的页也多 27%。

Postgres 实际上并不存储表。它存储页,而表就是能放进这些页里的东西。想象一下页的样子,你就能说清任意一行占多少字节,以及怎样让它占得更少。我们会从外向内展开,主要通过 pageinspect 这个可以从 SQL 读取页原始内容的扩展。

表是由页组成的文件

服务器数据目录中的每张表和每个索引,都是一个或多个普通文件。你可以查询它们的路径:

select pg_relation_filepath('events');
 pg_relation_filepath
----------------------
 base/16764/16644

16764 是数据库 ID,16644 是表的关系文件节点(relfilenode),也就是它的文件名(你的值会不同)。在容器中的 shell 里(先运行 docker compose exec postgres bash,再执行 cd /var/lib/postgresql/18/docker):

-rw------- 1 postgres postgres 288137216 Oct  6 04:07 base/16764/16644
-rw------- 1 postgres postgres     90112 Oct  6 04:07 base/16764/16644_fsm
-rw------- 1 postgres postgres     16384 Oct  6 04:07 base/16764/16644_vm

正如先认识这些基本概念所展示的那样,288,137,216 除以 8,192 恰好是 35,173。这个文件除了页什么都没有,页从 0 开始依次编号。(超过 1 GB 后,表会继续写入 16644.1、16644.2 等文件。)

动手验证 · lab 03-storage
select lab.prove(
  'the events file is nothing but 8 KB pages: 288,137,216 bytes is exactly 35,173 pages',
  pg_relation_size('events') = 288137216
  and pg_relation_size('events') % 8192 = 0
  and pg_relation_size('events') / 8192 = 35173);

完整实验脚本

任何会重写整张表的操作(truncate、vacuum full、某些 alter table)都会用新名字写出一个新文件,所以永远不要假设文件名稳定不变。

表不只有主文件

events 有三个文件,而不是一个。每个文件都是一个有自己用途的分支文件:main 保存行,_fsm 是空闲空间映射,_vm 是可见性映射;下面会分别介绍这两个映射。未记录表还会增加一个空的 _init 分支文件,崩溃后会把它复制到其他分支文件上。

因此,对于“这张表有多大?”这个问题,诚实的答案很少只是主文件的大小:

select pg_size_pretty(pg_relation_size('events'))       as main,
       pg_size_pretty(pg_total_relation_size('events')) as total;
  main  | total
--------+--------
 275 MB | 318 MB

pg_relation_size 只统计主分支文件。pg_table_size 会加上其他分支文件和表的 TOAST 存储(见下文),pg_total_relation_size 还会加上每个索引。请使用总大小。

每个页都有相同的布局

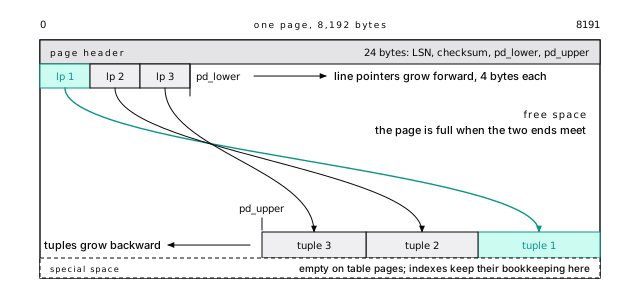
这 35,173 个页中的每一个都按下面的方式布局。这是本书最重要的一张图:

行指针从前端开始,元组从后端开始。两者向彼此靠近,碰到一起时页就满了。
图 4-1 行指针从前端开始,元组从后端开始。两者向彼此靠近,碰到一起时页就满了。

它就像一本笔记本:目录从顶部开始写,条目则从底部向上写。

一个 24 字节的页头记录页最后一次变更、校验和,以及空闲空间的起止位置。每个 4 字节的行指针从前端向后增长;每个行指针都指向一个元组。元组从后端向前增长;元组就是存储在页上的一份行版本。两者碰到一起时,页就满了。(索引会在末尾的特殊空间中保存簿记信息;表页则把这部分留空。)

深入阅读:检查真实页头的计算
select lsn, checksum, flags, lower, upper, special, pagesize
from page_header(get_raw_page('events', 0));
    lsn     | checksum | flags | lower | upper | special | pagesize
------------+----------+-------+-------+-------+---------+----------
 0/AF5BFA50 |    27634 |     4 |   248 |   384 |    8192 |     8192

这个页有 56 行。24 字节的页头加上 56 个、每个 4 字节的行指针,正好到 248:这就是 lower。元组从 384(upper)开始,因此还剩 136 个字节的空闲空间,不足以再放一行。special 是 8192,表示没有特殊空间。flags 是 4,也就是之后介绍可见性映射时会遇到的“全可见”标志。

动手验证 · lab 03-storage
select lab.prove(
  'lower = 24-byte header + 56 line pointers x 4 bytes = 248; upper = 384; 136 bytes free',
  lower = 24 + 4 * 56 and lower = 248 and upper = 384 and upper - lower = 136)
from page_header(get_raw_page('events', 0));

select lab.prove(
  '136 free bytes is too few for another events row (136 to 144 bytes, plus a line pointer)',
  (select upper - lower from page_header(get_raw_page('events', 0)))
    < (select min(lp_len) + 4 from heap_page_items(get_raw_page('events', 0))));

完整实验脚本

行指针让元组移动而不改变地址

行指针允许 Postgres 在页内移动元组,以压缩空闲空间,同时不改变元组的地址。这个地址就是行的 ctid,由页号和行指针编号组成;每张表都有这个隐藏列:

select ctid, id, kind from events order by id limit 3;
 ctid  | id |  kind
-------+----+---------
 (0,1) |  1 | build
 (0,2) |  2 | deploy
 (0,3) |  3 | comment

(0,1) 表示第 0 页、第 1 个行指针。索引会存储 ctid:当索引查找到 id = 2 时,它找到的其实是“第 0 页、第 2 个槽位”。沿着 ctid 找到它所在的表页,就是查询就是页和往返中四页查找的第四次读取。

ctid 不是标识符

行的 ctid 会在行每次更新时改变(更新就是插入会解释原因),表被重写时也会改变。请用它来检查,但永远不要保存它,也不要把它交给应用程序。

从 MySQL 转来

在 InnoDB 中,表本身就是主键 B-树。Postgres 表是一个堆:行会放到有空间的地方,每个索引(包括主键)都指向一个 ctid(Postgres 不是 MySQL)。

8 KB 是编译时选择,应当保持不变

八千字节不是自然法则。它是常量 BLCKSZ,在编译 Postgres 时固定(./configure --with-blocksize,取值为 1 到 32 KB 之间的 2 的幂),数据目录中的每个文件都会按它写入。用 16 KB 页构建的服务器无法打开用 8 KB 页创建的数据目录,pg_upgrade 也不能在两者之间跨越。运行中的服务器可以告诉你它是用什么构建的,而且没有任何设置能改变它:

show block_size;
 block_size
------------
 8192

更大的页听起来像是需要数更少的页,而且对于某些工作确实如此。顺序扫描会进行更少次、更大的读取;每个索引页可以容纳更多键,因此树会稍微更浅;宽行也能更久地保持在行内,因为压缩和移出大值的阈值(见下文的 TOAST)会随页大小变化。

但 Postgres 会读取并缓存整页,有时还会整页记录日志,所以其他方面都会变差。在 32 KB 页上,只需要一行的查找会把四倍的字节加载到内存中。同样大小的 shared_buffers 只能容纳四分之一的页,因此你的热点行会和多四倍的冷邻居共享缓存。而检查点之后第一次修改一个页时,会记录整个页,所以每个整页镜像的大小都可能达到四倍。

所以我们保留 8 KB,你也应该这样做。托管服务反正不让你选择页大小。本书中的每个调节手段都可以在不自定义构建的情况下改变一页能容纳多少行:列顺序、更窄的类型、fillfactor、TOAST 和正确的索引。更大的页主要适合在自己编译的服务器上运行、以扫描为主的分析负载,而这种负载无论如何都更适合列存储(Postgres 不擅长什么)。

动手验证 · lab 03-storage
select lab.prove('the page size is fixed when Postgres is built: block_size is 8192, and no setting can change it',
  current_setting('block_size') = '8192'
  and (select context from pg_settings where name = 'block_size') = 'internal');

完整实验脚本

深入阅读:还有什么会随页大小变化

我们没有为本书构建 32 KB 服务器,所以这一框是在根据页的使用方式推理,而不是实验运行结果。会随 BLCKSZ 变化的限制包括:

  • TOAST 会在行达到约四分之一页时开始压缩,这里约为 2 KB(大值会先压缩,再移出行外)。
  • 索引条目不能超过约三分之一页,这就是为长文本列建立索引时会遇到的错误。
  • 可见性映射为每页保留两位,因此每一位覆盖更多行;一个被修改的行会清除其邻居中更多行对应的位。
  • WAL 中的整页镜像每个占一页,因此页越大,每次检查点之后的突发写入就越大。

另外两个相关但彼此独立的编译时常量是 wal_block_size(同样是 8 KB)和 1 GB 的文件段大小,这就是大表会继续写入 16644.1 的原因。pg_controldata 会打印数据目录的这三个值,而读取原始页的工具(例如 pageinspect)会从服务器获取它们的大小。

动手验证 · lab 03-storage
select lab.prove('WAL blocks are a separate compile-time constant, also 8 KB here',
  current_setting('wal_block_size') = '8192'
  and (select context from pg_settings where name = 'wal_block_size') = 'internal');

完整实验脚本

一行的成本高于它的列

打开一个页,数一数每行实际存储了什么。heap_page_items 会解码页上的每个元组:

select lp, lp_off, lp_len, t_xmin, t_xmax, t_ctid, t_hoff
from heap_page_items(get_raw_page('events', 0))
limit 3;
 lp | lp_off | lp_len | t_xmin | t_xmax | t_ctid | t_hoff
----+--------+--------+--------+--------+--------+--------
  1 |   8048 |    144 |    766 |      0 | (0,1)  |     24
  2 |   7904 |    144 |    766 |      0 | (0,2)  |     24
  3 |   7760 |    144 |    766 |      0 | (0,3)  |     24

元组 1 在偏移量 8048 处,占 144 字节,正好延伸到页尾;元组 2 紧接在它下面。每个元组都从 23 字节的元组头开始。

头部中最重要的两个字段是 t_xmin,即插入这一版本的事务;以及 t_xmax,即删除或锁定它的事务(如果没有则为 0)。它们是 Postgres 并发控制的核心,会在更新就是插入中单独介绍。这里每一行都是由事务 766(种子事务)插入的,没有一行被删除。t_ctid 是元组自己的地址,或者它的新版本的地址。t_hoff 表示列值从第 24 个字节开始,也就是头部和一个用于对齐的字节之后;列值按声明顺序首尾相接。

每行都有 24 字节头部和一个 4 字节行指针。一行如果只有两个整数,大部分空间都是开销。

深入阅读:逐字节读取一行

完整的头部如下:

字段大小含义
t_xmin4 字节插入此版本的事务 ID
t_xmax4 字节删除或锁定它的事务 ID,或 0
t_cid4 字节事务中的命令编号
t_ctid6 字节此元组的地址,或其新版本的地址
t_infomask22 字节列数及少数标志
t_infomask2 字节状态标志
t_hoff1 字节列数据开始的偏移量
表 4-1 一行的成本高于它的列

第 1 行的 t_infomask 是 2306,pageinspect(PostgreSQL 13+)会对它进行解码:

select raw_flags
from heap_page_items(get_raw_page('events', 0)),
     heap_tuple_infomask_flags(t_infomask, t_infomask2)
where lp = 1;
                        raw_flags
----------------------------------------------------------
 {HEAP_HASVARWIDTH,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}

这行包含可变宽度列,插入它的事务已知已经提交,而且没有有效的删除事务。后两项是提示位,也就是缓存下来的答案;读操作可以写入会解释它们。

接下来是数据。前八个字节是 id,整数 1,最低有效字节在前;任何 x86 或 64 位 ARM 机器都是如此:

select substr(t_data, 1, 16)
from heap_page_items(get_raw_page('events', 0))
where lp = 1;
               substr
------------------------------------
 \x0100000000000000a903000000000000

接下来的八个字节 a903... 是 account_id:0x03a9 是 937,正好是 select account_id from events where id = 1 返回的值。

动手验证 · lab 03-storage
select lab.prove(
  'pageinspect decodes t_infomask 2306 as HASVARWIDTH, XMIN_COMMITTED, XMAX_INVALID',
  t_infomask = 2306
  and raw_flags = '{HEAP_HASVARWIDTH,HEAP_XMIN_COMMITTED,HEAP_XMAX_INVALID}')
from heap_page_items(get_raw_page('events', 0)),
     heap_tuple_infomask_flags(t_infomask, t_infomask2)
where lp = 1;

select lab.prove(
  'the next 8 bytes are account_id: 0x03a9 = 937',
  substr(t_data, 9, 8) = '\xa903000000000000'::bytea
  and (select account_id from events where id = 1) = 937
  and x'03a9'::int = 937)
from heap_page_items(get_raw_page('events', 0)) where lp = 1;

完整实验脚本

NULL 只占一位

NULL 在数据区不占空间。包含任何 NULL 的行会在头部带有空值位图:每列一位,NULL 对应 0。在 projects 中,未归档项目的 archived_at 是 NULL:

 lp |  t_bits  | lp_len
----+----------+--------
  1 | 11110100 |     72
  2 |          |     80
  3 | 11110100 |     72

第 1 行和第 3 行没有归档:它们的第五位是 0,比第 2 行短 8 字节,因为第 2 行保存了时间戳。一位换八个字节。(最多 8 列时,位图可以放进头部多出来的一个字节。超过 8 列后,只要行中有 NULL,就需要更长的位图,这可能把数据起点从第 24 个字节推到第 32 个字节。)

深入阅读:未归档项目确实短 8 个字节
select lp, t_bits, lp_len
from heap_page_items(get_raw_page('projects', 0))
limit 3;
动手验证 · lab 03-storage
select lab.prove(
  'projects rows 1 and 3 (not archived) carry a null bitmap 11110100; row 2 (archived) has none',
  array_agg(coalesce(t_bits, '') order by lp) = '{11110100,"",11110100}')
from heap_page_items(get_raw_page('projects', 0)) where lp <= 3;

select lab.prove(
  'row 2 is archived and 8 bytes longer, because it stores the timestamp',
  (select lp_len from heap_page_items(get_raw_page('projects', 0)) where lp = 2)
    = (select lp_len from heap_page_items(get_raw_page('projects', 0)) where lp = 1) + 8
  and (select archived_at is not null from projects where ctid = '(0,2)')
  and (select archived_at is null from projects where ctid = '(0,1)'));

完整实验脚本

列顺序就是空闲空间

现在回到本章开头的谜题。CPU 在地址为自身大小整数倍的位置读取值最快,所以 Postgres 会让值按这种方式排列:bigint 或 timestamptz 从 8 字节倍数开始,integer 或 date 从 4 字节倍数开始,smallint 从 2 字节倍数开始,而 boolean 可以从任意位置开始。当一个 8 字节列紧跟在结束于奇数偏移的位置之后时,Postgres 会填充中间的空隙。想象一个停车场:卡车只能停在每第八条车位线上;如果让一辆摩托车先占用第一个位置,后面七个位置就会空着。

下面逐列展示本章开头的两张表。pg_column_size 表明 padded 的一行是 72 字节,而 packed 的一行是 52 字节:

padded (72 bytes)              packed (52 bytes, 56 on the page)
offset  contents               offset  contents
   0    header (24)               0    header (24)
  24    is_active (1)            24    id (8)
  25    padding (7)              32    created_at (8)
  32    id (8)                   40    score (8)
  40    is_admin (1)             48    flags (2)
  41    padding (7)              50    is_active (1)
  48    created_at (8)           51    is_admin (1)
  56    flags (2)                52    end
  58    padding (6)
  64    score (8)
  72    end

这种差异会叠加:每个元组在页上也从 8 的倍数开始(所以 packed 的 52 个字节在页上占 56 个字节),而且每行还需要一个行指针。结果是每页只能放 107 行,而不是 136 行;需要 9,346 个页,而不是 7,353 个页。

由此得到的规则是:

  1. 先放固定宽度的 8 字节列:bigint、timestamptz、double precision。
  2. 然后放 4 字节列:integer、real、date。
  3. 再放 2 字节列,最后放 1 字节列:smallint、boolean。
  4. 可变长度列(text、jsonb、numeric)放在最后。短值不需要对齐,因此可以在末尾紧密排列。
需要多在意这件事?

几千行时,完全不用在意。对于将要达到数亿行的窄表(事件、日志、连接表、指标),在写 create table 时花五分钟考虑一下;之后再排序就意味着重写表。

深入阅读:页的计算,以及 events 的表现

两张表使用同样的一百万行数据加载:

create table padded (
  is_active  boolean,
  id         bigint,
  is_admin   boolean,
  created_at timestamptz,
  flags      smallint,
  score      bigint
);

create table packed (
  id         bigint,
  created_at timestamptz,
  score      bigint,
  flags      smallint,
  is_active  boolean,
  is_admin   boolean
);
insert into padded
  select true, g, false, now(), 1, g from generate_series(1, 1000000) g;
insert into packed
  select g, now(), g, 1, true, false from generate_series(1, 1000000) g;

每页在扣除页头后有 8,168 个可用字节,每行还要有一个 4 字节行指针:

padded: 8168 usable bytes / (72 + 4) per row  =  107 rows per page
packed: 8168 usable bytes / (56 + 4) per row  =  136 rows per page
动手验证 · lab 03-storage
select lab.prove(
  'a padded row is 72 bytes; the same columns packed take 52',
  (select pg_column_size(p.*) from padded p limit 1) = 72
  and (select pg_column_size(p.*) from packed p limit 1) = 52);

select lab.prove(
  'page 0 of padded holds 107 tuples, page 0 of packed holds 136',
  (select count(*) from heap_page_items(get_raw_page('padded', 0))) = 107
  and (select count(*) from heap_page_items(get_raw_page('packed', 0))) = 136
  and 8168 / (72 + 4) = 107 and 8168 / (56 + 4) = 136);

select lab.prove(
  '9,346 pages versus 7,353: padded is about 27% bigger',
  pg_relation_size('padded') / 8192 = 9346
  and pg_relation_size('packed') / 8192 = 7353
  and pg_relation_size('padded')::numeric / pg_relation_size('packed') between 1.26 and 1.28);

完整实验脚本

每种类型的对齐方式都在 pg_type.typalign 中:c(任意字节)、s(2)、i(4)或 d(8)。uuid 很特别:它占 16 字节,但对齐方式是 c,所以不需要填充。

示例模式表现良好。events 的一行包括页头、四个没有填充的 8 字节 ID、短文本形式的 kind、小型 jsonb 形式的 payload,以及 created_at;两个可变长度列之后可能会产生几个字节的填充。实测行大小为 136 到 144 字节,其中约 66 字节来自 JSON。真正值得关注的是 JSON 的成本;类型是一份契约会讨论什么时候应该把字段从 jsonb 提升为真正的列。

大值会先压缩,再移出行外

一行必须放进 8 KB 的页中,但一个 text 值最多可以有 1 GB。TOAST(The Oversized-Attribute Storage Technique,超长属性存储技术)解决了这两者之间的矛盾。当即将存储的行大于约 2 KB(8 KB 页下为 2,032 字节,因此一页至少能放四行)时,Postgres 会从最大的可变长度列开始处理:

  1. 在原处压缩这个值。
  2. 如果行仍然太大,就把这个值移入表自己的 TOAST 表中,切成略小于 2 KB 的块,并在原处留下一个 18 字节的指针。

在一张测试表中,100,000 个重复字符被压缩为 1,156 字节,始终没有离开行。32,000 个随机十六进制字符无法压缩,因此被移出并切成 17 个块,行中只留下一个 50 字节的元组。读回这个值意味着要在 TOAST 表中进行一次索引查找,再读取 17 个元组;这些操作在你的 SQL 中是看不见的。

这对查询意味着:

  • 宽表上的 select * 不是免费的。 不显示文档正文的列表页不应该读取它,而大多数 ORM 除非你明确告诉它们,否则会读取每一列。
  • 修改经过 TOAST 处理的值会重写整个值。 修改一个大型 jsonb 文档中的一个键,Postgres 也会再次存储整个文档。把经常更新的计数器移出文档;更好的办法是给它单独建一张窄表(把热点计数器移到窄表)。
  • 中等大小的值最棘手。 1 到 2 KB 的值不会经过 TOAST 处理,却会让每行都变大,所以每页只能放下少数几行。

深入阅读:观察 TOAST 如何压缩、移出和分块

一张只有一个 text 列的表,其中填入短字符串、重复字符(非常容易压缩)和随机十六进制字符串(几乎无法压缩):

create table docs (
  id   bigint generated always as identity primary key,
  body text
);
insert into docs (body) values (repeat('a', 1000));
insert into docs (body) values (repeat('a', 3000));
insert into docs (body) values (repeat('a', 100000));
insert into docs (body)
  select string_agg(md5(random()::text), '') from generate_series(1, 100);
insert into docs (body)
  select string_agg(md5(random()::text), '') from generate_series(1, 1000);

select id, length(body) as chars, pg_column_size(body) as stored,
       pg_column_compression(body) as compression
from docs order by id;
 id | chars  | stored | compression
----+--------+--------+-------------
  1 |   1000 |   1004 |
  2 |   3000 |     44 | pglz
  3 | 100000 |   1156 | pglz
  4 |   3200 |   3200 |
  5 |  32000 |  32000 |

第 4、5 行在表页上留下了 50 字节的元组(24 字节头部、id 占 8 字节,以及 18 字节的指针)。它们的块是 TOAST 表中的行,reltoastrelid 在 pg_class 中指向这张表:

 chunk_id | chunks | bytes | max_chunk
----------+--------+-------+-----------
    17446 |      2 |  3200 |      1996
    17447 |     17 | 32000 |      1996

这个阈值是精确的:2,028 字节的行会原样存储,2,038 字节的行会被压缩。而 pg_column_toast_chunk_id(PostgreSQL 17+)展示了更新规则:更新另一个列会保留同一个 TOAST 指针,不复制任何内容;修改这个值则会再次存储全部 17 个块。

动手验证 · lab 03-storage
create table toast_edge (body text);
insert into toast_edge values (repeat('a', 2000)), (repeat('a', 2010));
select lab.prove(
  'a 2,028-byte row is stored as is; a 2,038-byte one crosses 2,032 bytes and is compressed',
  (array_agg(lp_len order by lp))[1] = 2028
  and (array_agg(lp_len order by lp))[2] < 100
  and (select array_agg(pg_column_compression(body) is not null order by length(body))
       from toast_edge) = '{f,t}')
from heap_page_items(get_raw_page('toast_edge', 0));

完整实验脚本

动手验证 · lab 03-storage
select lab.prove(
  'random hex doesn''t compress, so rows 4 and 5 move out of line',
  bool_and(pg_column_compression(body) is null)
  and bool_and(pg_column_toast_chunk_id(body) is not null)
  and array_agg(pg_column_size(body) order by id) = '{3200,32000}')
from docs where id in (4, 5);

select reltoastrelid::regclass as toast_table from pg_class where relname = 'docs' \gset
select lab.prove(
  'out-of-line values are cut into chunks of at most 1,996 bytes: 2 chunks for row 4, 17 for row 5',
  (select array_agg(n order by n) from
     (select count(*) as n from :toast_table group by chunk_id) c) = '{2,17}'
  and (select max(length(chunk_data)) from :toast_table) = 1996);

完整实验脚本

动手验证 · lab 03-storage
alter table docs add column title text;
select pg_column_toast_chunk_id(body) as chunk_before from docs where id = 5 \gset
update docs set title = 'renamed' where id = 5;
select lab.prove(
  'an update that doesn''t change a toasted value keeps the same TOAST pointer',
  pg_column_toast_chunk_id(body) = :chunk_before)
from docs where id = 5;

update docs set body = body || 'x' where id = 5;
select lab.prove(
  'an update that changes a toasted value stores the whole new value, every chunk',
  pg_column_toast_chunk_id(body) <> :chunk_before
  and (select count(*) from :toast_table t
       where t.chunk_id = pg_column_toast_chunk_id(d.body)) = 17)
from docs d where id = 5;

完整实验脚本

深入阅读:lz4、存储策略,以及 toast_tuple_target 的真实作用

压缩按列进行。默认算法是 pglz;从 PostgreSQL 14 起可以选择 lz4(前提是服务器编译时启用了它,大多数打包版本都启用了),通常速度快得多,而压缩比相近:

alter table docs alter column body set compression lz4;
insert into docs (body) values (repeat('a', 100000));
select id, pg_column_size(body), pg_column_compression(body)
from docs where id = 6;
 id | pg_column_size | pg_column_compression
----+----------------+-----------------------
  6 |            411 | lz4

同样的 100,000 个字符,pglz 存储时占 1,156 字节,使用这种算法只占 411 字节。这个设置只适用于之后新存储的值;如果你要存储大量可压缩文本或 JSON,在服务器级别将 default_toast_compression = lz4 作为默认值是合理的选择。

每一列还有一个存储策略(plain、main、external、extended;text 和 jsonb 默认使用 extended,先压缩再移出)。对于已经压缩的数据(例如图像),可以设置为 external,使用 alter table ... alter column ... set storage:再次压缩只会浪费 CPU,而且子串操作可以只读取所需的块。

toast_tuple_target 存储参数决定开始 TOAST 处理后,Postgres 会尝试把一行缩小到多小。它不会改变触发阈值:在 PostgreSQL 18 中,无论该参数是什么,行超过约 2 KB 时仍然会开始 TOAST。(CREATE TABLE 参考手册把它描述为触发 TOAST 的最小长度,但服务器代码检查的是固定阈值。)因此,更低的目标值不会触碰 1.5 KB 的行;一旦行确实超过 2 KB,就会把更多中等大小的列移出行外,用更多 TOAST 查找换取更小的行。

动手验证 · lab 03-storage
create table ttt_256 (a text, b text) with (toast_tuple_target = 256);
insert into ttt_256 values (repeat('a', 1500), null);
select lab.prove(
  'toast_tuple_target = 256 does not touch a 1.5 KB row: toasting still starts at about 2 KB',
  (select pg_column_compression(a) from ttt_256) is null
  and (select pg_column_size(a) from ttt_256) = 1504);

完整实验脚本

填充因子为更新留下空间

默认情况下,Postgres 会把表页填满;fillfactor 存储参数让插入更早停止,为每个页留下空间。这些空间是给更新用的:更新会写出行的新版本,如果新版本能放在同一个页上,成本就会低得多,因此选择这个值也是为页留下空间,否则每次更新都会移动的一部分。

插入无需扫描表也能找到空间

插入是怎样找到有空间的页的?不是扫描整张表。_fsm 分支文件大致记录每个页有多少空闲空间,每页一个字节,以 32 字节为步长:events 的第 0 页有 136 个字节空闲,记录值为 128(预留 4 个字节放行指针后)。找到有空间的页只需要几次读取。清理会更新这个映射,这时删除行释放的空间才会重新可用。如果没有页有空间,表就会在末尾增长。

动手验证 · lab 03-storage
select lab.prove(
  'the FSM stores one byte per page in 32-byte steps: events page 0 (136 free) is recorded as 128',
  avail = 128 and avail % 32 = 0)
from pg_freespace('events') where blkno = 0;

完整实验脚本

每页两位让扫描和清理跳过工作

正因为每页有两位,仅索引扫描才能跳过表,而清理一张很大但大部分静态的表也会很便宜。最后一个分支文件 _vm 是可见性映射:表中的每个页有两位。

  • 全可见(all-visible):页上的每一行现在以及将来都对每个事务可见。
  • 全冻结(all-frozen):页上的每一行都已冻结,可以永久免受事务 ID 回卷影响(旧行必须在 XID 计数器回卷前冻结)。

pg_visibility 扩展可以汇总这些信息:

create extension pg_visibility;
select * from pg_visibility_map_summary('events');
 all_visible | all_frozen
-------------+------------
       35173 |          0

每个页都是全可见的,因为种子加载最后执行了 vacuum analyze。Postgres 有两个部分会依赖这张映射。仅索引扫描在页全可见时跳过表页,只从索引回答问题(B-树挑起大梁)。清理会跳过全可见的页(清理不可省)。对页的任何修改都会清除对应的位;等到每个事务都能看到这次修改后,清理会再次设置它。

深入阅读:观察变更清除全可见位

这个位存在于两个地方:映射中,以及页头中的标志 4。

动手验证 · lab 03-storage
update accounts set name = name where id = 1;
select lab.prove(
  'any change to a page clears its all-visible bit',
  (select all_visible from pg_visibility_map('accounts', 0)) = false
  and (select flags & 4 from page_header(get_raw_page('accounts', 0))) = 0);

vacuum accounts;
select lab.prove(
  'vacuum sets it again once every transaction can see the change',
  (select all_visible from pg_visibility_map('accounts', 0)) = true
  and (select flags & 4 from page_header(get_raw_page('accounts', 0))) = 4);

完整实验脚本

建表前先数页

把这些部分放在一起,你就能在表还不存在时预测它的大小:

row size      = 24 (header) + column data + padding, rounded up to 8
bytes per row = row size + 4 (line pointer)
rows per page = floor(8168 x fillfactor / 100 / bytes per row)
pages         = rows / rows per page

8,168 是页的 8,192 字节减去 24 字节页头。events 的行平均约 139 字节,因此每页大约能放 57 行,两百万行需要约 35,100 个页。真实的表有 35,173 个页。下次有人提议建一张每月增长五千万行的表时,在脑中算一算:需要多少页,有多少是热点页,能否放进内存?

页数支配着后面的一切,首先决定哪些页能留在内存中。而且每个 update 和 delete 都会改变它,只是第一次观察时,大多数人都不会想到这些变化。

本章要点

  • 表是由 8 KB 页组成的文件,外加保存空闲空间映射和可见性映射的分支文件。用 pg_total_relation_size 查看它真正有多大。
  • 8 KB 在构建 Postgres 时固定(block_size 只读)。通过模式而不是自定义构建改变一页能容纳多少行。
  • 每行都有一个 24 字节头部和一个 4 字节行指针。小行的大部分空间都是开销。
  • ctid 是一个物理地址(页、槽位),每次更新都会改变。永远不要保存它。
  • NULL 只占一位,而不是占用列的宽度。
  • 把列按 8 字节固定宽度类型到 1 字节类型的顺序排列,可变长度列放最后。本例中错误的顺序多占了 27% 的空间。
  • 超过约 2 KB 的值会先压缩,再移到 TOAST 表中。不要对不需要的宽列执行 select *。
  • 填充因子为每个页的更新留下空间;HOT 章节会讲如何选择它。

延伸阅读

  • Database page layout,PGDG。8 KB 页、行指针和每个元组头字段的权威来源。
  • TOAST,PGDG。阈值、存储策略和压缩选项。
  • Free space map 和 visibility map,PGDG。让插入和清理变快的两个小分支文件。
  • pageinspect,PGDG。本章使用的每个函数,以及更多内容。
  • Heap table structure,Hironobu Suzuki,《The Internals of PostgreSQL》。用图解方式补充说明同一种布局。

表格阅读