3 时间都花在哪里
生产环境中,一个列出团队项目的端点需要 180 ms。你从日志中复制查询,在 psql 里运行,结果 0.4 ms 就完成了。再来一次:0.3 ms。数据库显然没问题。
然后你开始计数。这个端点并不只运行一个查询。它运行一个查询来获取 100 个项目,为每个项目运行一个查询来获取所有者,再为每个项目运行一个查询来获取最近的部署。总共是 201 个查询,每个查询在服务器上都很快,但每个查询都要经过网络再回来。每次往返只需半毫秒,网络本身却会在数据库开始工作之前就花掉 100 ms。
这个故事中没有什么东西真的慢。只是数错了。大致知道每种操作的成本,你就可以在测量之前估算一个查询、一种访问模式或代码中的一个循环。
内存很便宜,其他一切都很贵
在知道各个部分的成本之前,你无法估算一个查询。下面是数据库的延迟阶梯。标为“实测”的行来自我们笔记本上的实验套件;其余数值只是数量级,不是保证。
| 操作 | 典型延迟 |
|---|---|
| CPU L1 缓存引用 | 约 1 ns |
| 主内存(RAM)引用 | 约 100 ns |
| 从操作系统页缓存读取一个 8 KB 页 | 4 到 5 µs(实测) |
| 从本地 NVMe 随机读取 | 几十 µs |
| 一个可用区内的往返 | 100 到 500 µs |
| 从网络块存储随机读取 | 低于 0.5 ms 到数 ms |
| 跨可用区往返 | 约 0.5 到 2 ms |
| 我们笔记本 SSD 上的持久写入(fsync) | 空闲时 0.65 ms,繁忙时 18 ms(实测) |
| 跨区域往返 | 30 到 150 ms |
三个教训几乎支配着每个数据库决策。内存很便宜,其他一切都很贵,所以面对任何查询时,第一个问题都应该是它访问了多少个页,以及这些页在哪里。网络并非免费,即使距离很近也一样:同一可用区内的一次往返,成本大约和读取一次网络磁盘相当。还有,持久性是每次写入中最慢的部分,这就是预写式日志存在的原因。
深入阅读:未实测的那些行从哪里来
CPU、内存、SSD 和网络这些行遵循 Numbers Every Programmer Should Know By Year 中的经典阶梯(1 ns L1、100 ns RAM、16 µs SSD 随机读取、500 µs 数据中心往返、加利福尼亚到荷兰再返回 150 ms)。网络存储这一行来自 AWS 自己的卷类型文档:io2 Block Express 卷每次 I/O 平均低于 500 µs,通用型 gp3 卷承诺“个位数毫秒”的延迟。跨可用区往返取决于服务商和可用区;AWS 只说它的可用区彼此相距不超过 100 km,所以请测量你自己的环境。单块磁盘的延迟也会随负载大幅波动:我们笔记本的 fsync 空闲时测得 0.65 ms,而其他容器猛烈读写同一块磁盘时测得 18 ms。
查询就是页和往返
一个足够应付大多数决策的粗略模型:
对于典型的应用查询,CPU 项很小,前两项占主导。要观察页这一项,拿序言中的两个查询,让 Postgres 报告它做了什么:
这就是查询的执行计划,本书里你会读到数百份执行计划。先掌握四条规则,就足以读懂它们,直到读执行计划,别只看耗时讲完其余内容。每一行都是一个步骤,即一个节点;缩进最深的节点先运行,然后把结果提供给上方节点。actual rows 是某个节点每轮产生的行数。Buffers: 统计它访问的 8 KB 页:hit 表示该页已经在 Postgres 的内存中,read 表示 Postgres 必须向操作系统请求它。还要先读这一行:耗时会随缓存和负载波动,页数不会。(PostgreSQL 18 默认会显示它;18 之前需要写 explain (analyze, buffers)。)
四个页,全都在内存中:三个属于主键索引(B-树章节会展示它的形状),另一个属于保存这行数据的表。
动手验证 · lab 02-latency
现在再看一个针对没有索引的列的过滤:
为了找到 85 行,读取了 35,173 个页:也就是表的每一个页。它仍然只花了约 30 ms,因为三个进程分担了工作,而且那些“read”页来自操作系统内存,而不是磁盘。
四个页对 35,173 个页,两者都“很简单”。报表每小时运行一次时,30 ms 没问题。每次页面加载都运行一次时,它就是数据库中最昂贵的操作。这里的本领在于注意这个比例。
深入阅读:4 个页和 35,173 个页背后的检查
一页可能位于三种位置之一
Postgres 需要一个页时,会在三个地方查找,而每个地方都比前一个慢得多:书桌、房间另一边的文件柜、城市另一头的仓库。
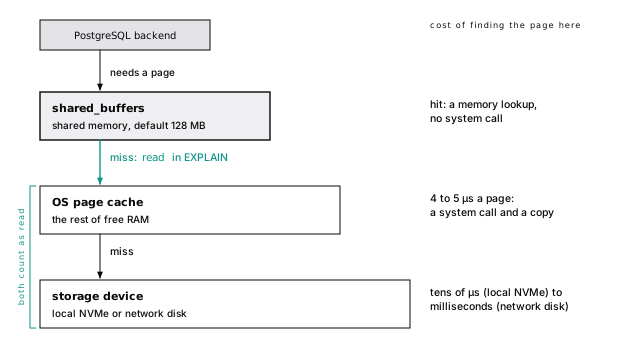
shared_buffers 是 Postgres 自己的页缓存,由每个服务器进程共享。默认值是 128 MB,故意设得很小;生产环境通常从 RAM 的约 25% 开始(真正重要的配置)。缓冲区缓存决定哪些页留下会展示它如何选择要保留的内容。
操作系统页缓存是内核对文件内容的缓存,使用其他地方没有占用的 RAM。Postgres 读取的每个页也会落在那里,所以一个热点页可能同时存在于两个缓存中。这种双重缓冲就是 shared_buffers 不会被设置为 RAM 90% 的原因。
“Read”不等于“来自磁盘”
在执行计划中,read 表示“不在 shared_buffers 中,所以 Postgres 向内核请求了它”。内核是否访问了设备,Postgres 看不见。时钟可以告诉你:实验套件打开了 track_io_timing,它会添加一行 I/O Timings。下面是散布在整张表中的 2,000 次主键查找:
读取 3,139 个页用了 15.0 ms:每页约 5 µs(我们多次运行得到的范围是 4 到 5 µs)。没有任何存储设备能把随机读取做得这么快;这些页来自操作系统页缓存。每页几十 µs 或更久,就意味着访问了设备。
深入阅读:为什么测量随机查找,而不是大型扫描
生成这些数字的查询:
不要直接用顺序扫描的数字去除。PostgreSQL 18 中,顺序扫描会通过异步 I/O 预读,并把相邻页合并成更大的读取(默认最大为 io_combine_limit,128 KB),所以大部分 I/O 耗时会与其他工作重叠,平均到每页的数字没有多少意义。随机读取一次只读一个页,才是诚实的测试。
动手验证 · lab 02-latency
大型扫描不会冲掉缓存
你可能会以为,对 275 MB 的 events 表做一次全表扫描,就会把其他内容全部挤出 128 MB 的缓存。事实并非如此。大型顺序扫描会循环使用一小块私有缓冲区环(PostgreSQL 18 默认设置下为 2,304 KB),所以一份报表不会把应用正在使用的页赶出去(大型操作会使用环形缓冲区)。
每次提交都要等待磁盘
读取可以缓存。提交不行,前提是提交必须在崩溃后仍然存在。执行 commit 时,Postgres 会向预写式日志写入一条记录,并等待磁盘确认它已经持久化。这个等待就是一次 fsync,硬件决定它的价格:我们安静的笔记本 SSD 上约 0.65 ms,其他容器向同一磁盘写入时为 18 ms,而优质服务器存储上远低于 1 ms。
客户端每次只提交一行,就要为每一行刷新一次。0.65 ms 意味着理论上最多约每秒 1,500 次提交;18 ms 则约为 55 次。因此,10,000 行分成 10,000 个事务,就要刷新 10,000 次;放在一个事务中,则只需一次。
批量写入(快速加载数据),对于写入密集型系统,在购买快速读取的存储之前,先购买 fsync 快的存储。提交意味着刷新会测量提交速率,以及绕过等待的两种方式:多个会话共享一次刷新,或者完全不等待。
Postgres 有一个名为 fsync 的服务器设置。把它设为 off 会让基准测试看起来非常漂亮,却会让任何崩溃或断电都有可能悄悄损坏整个集簇,而不只是最后几次事务。synchronous_commit = off 是这个想法的安全版本,你可以按会话或事务设置它:崩溃可能丢失最近几分之一秒内提交的事务(最多是 wal_writer_delay 的三倍,默认 600 ms),但数据库仍然保持一致。
深入阅读:持久性需要三个数量级的代价
pg_test_fsync 随 Postgres 一起提供。在保存数据的卷上运行它;在实验套件中,先用 docker compose exec postgres bash 打开 shell:
在 Linux 上,fdatasync 是服务器的 wal_sync_method:这里是 0.65 ms。我们多次运行中,未同步写入的速度为每秒 260 万到 290 万次。这三个数量级的差距,就是持久性的代价。
IOPS 受在途读取限制,而不是由你付费购买的数量决定
每次同时未命中两个缓存的读取,以及每次提交,都会落到存储上。如果你使用托管服务,数据很可能位于网络块存储中:这种存储看起来像本地磁盘,实际上位于走廊另一头的服务器上,因此每次缓存未命中都是一次网络请求。这种存储用三个很容易混淆的数字来销售:延迟(一次 I/O 需要多久)、IOPS(每秒 I/O 次数)和吞吐量(每秒字节数)。
队列深度,也就是在途 I/O 的数量,把它们联系起来:达到的 IOPS = 在途 I/O 数量 / 延迟。一个进程一次等待一个 1 ms 的读取,无论你付费购买了多少 IOPS,得到的都只有 1,000 IOPS。(这就是 Little 定律;邮局排队也遵循它。)大型扫描可以让许多读取同时在途;一次错过缓存的索引查找,则只是到存储服务器的一次往返。
算一算。AWS gp3 的起点是 3,000 IOPS 和 125 MiB/s:对所有连接合计来说,大约是每秒 3,000 次随机冷页读取。只有在测量确认自己受 I/O 限制时,才购买更快的卷,永远不要用它替代索引。在托管服务上,这通常是你遇到的第一个上限(现在瓶颈是存储卷)。
深入阅读:基线卷能做什么、不能做什么
在 gp3 的基线 3,000 IOPS 和 125 MiB/s 下:
- 随机页读取:3,000 IOPS 乘以 8 KB,约为 24 MB/s。对装不进内存的大表做索引查找时,所有连接合计最多约每秒 3,000 个冷页。
- 顺序扫描:275 MB 的
events表冷读时速度为 125 MiB/s,需要约 2.2 秒。100 GB 的表需要超过 13 分钟,而每晚运行一次的报表会让其他所有人都遇到存储卷饱和。
预置 IOPS 卷(io1/io2 风格)以更高价格提供更多 IOPS 和更低、更稳定的延迟。
突发额度也有精确数字。小于 1 TiB 的 gp2 卷可以在一笔至少能以满突发速度维持 30 分钟的余额上突发到 3,000 IOPS;许多较小的实例类型还可以在回落到低几倍的基线之前,将 EBS 最大性能维持至少每 24 小时一次、每次 30 分钟。gp3 卷不会突发,而是保持预置数值。
突发额度会在任务中途用完
gp2 卷和许多较小的实例类型依赖突发额度运行:一开始很快,额度用完后就回到低得多的基线。测试运行正常,繁重任务的前半小时也正常;然后流量没有变化,延迟却开始上升。如果 I/O 悬崖与负载持续时间相吻合,而不是与负载大小相吻合,请先检查突发余额,再检查查询。
本地 NVMe 很快,但主机没了它也没了
本地 NVMe 的读取延迟只有几十 µs,但主机没了它也就没了。只有在配套使用权威数据的副本和未经验证的备份只是传闻,并且它们能应对节点随时丢失时,才使用本地 NVMe(本地 NVMe:快,但主机没了它也没了)。网络卷可以在主机丢失后继续存在,但每次缓存未命中都会让你付出延迟。
根据工作集配置 RAM
对 Postgres 来说,最有效的硬件决策是为你的工作集准备足够的 RAM:比如一个小时内负载会访问的页。不是整个数据库,而是实际会用到的那部分。
events 加上索引后一共是 318 MB。但假设应用主要展示最近一周的数据。事件按时间顺序到达,所以最近 7 天的数据集中在表的末尾:675 个页,约 5 MB,比 users 还小。这是常见的形状:一个很少读取的大尾部,以及一个持续读取的热头部。你的工作集就是每张表的热头部、用于找到它的索引页,以及任何周期性任务会访问的内容。
如果工作集能放进 RAM(shared_buffers 加上操作系统页缓存),几乎每次读取都只需几微秒。如果放不下,每个查询都会变成存储延迟查询,再多 IOPS 也无法让它有内存访问的感觉。RAM 通常比 IOPS 便宜,也远比工程时间便宜。
深入阅读:测量表大小和最近 7 天数据占用的页
查看堆和索引的整体大小:
一行的 ctid 是它的物理地址,由页号和槽位组成(行指针让元组移动而不改变地址会将其拆开);把它转换为 point 就能取出页号。示例数据截至 2026 年 10 月 6 日,因此我们从最新事件向前测量,而不是从 now() 开始:
动手验证 · lab 02-latency
观察数据库运行会展示如何测量缓存正在提供的内容。
往返比查询更贵
回到开头的端点。用随 Postgres 提供的负载生成器 pgbench 做端到端计时(pgbench 已经安装),一次主键查找耗时78 µs,包括往返,客户端和服务器位于同一台笔记本上。同一可用区中的另一台主机会为每个查询增加约 100 到 500 µs;另一个可用区最多增加几 ms;另一个区域则增加 30 ms 或更多。
现在来算N+1。一个页面展示 100 个项目,并分别加载每个项目的所有者,就会运行 101 个查询:
| 应用运行位置 | 往返 | 101 个查询 | 2 个查询 |
|---|---|---|---|
| 同一主机 | 0.08 ms | 8 ms | 0.2 ms |
| 同一可用区 | 0.5 ms | 51 ms | 1 ms |
| 其他可用区 | 1.5 ms | 152 ms | 3 ms |
| 其他区域 | 60 ms | 6 s | 120 ms |
查询并没有变慢。变的只有距离。这就是为什么 N+1 bug 在笔记本上看不出来,在生产环境中却很痛苦;也是为什么把数据库搬到“更好的区域”却不搬应用,会让一切都变慢。
ORM 版本看起来很无害:
改为一次查询获取它们,可以使用连接或数组参数:
用这种方式按主键获取 100 行,只需一次往返,耗时约一毫秒。大多数 ORM 都能请求这种行为(“eager loading”“includes”“preload”);经得住数据增长的查询会讲 SQL 方面的内容。
深入阅读:服务器上一次获取 100 行的查询需要多少成本,以及其他往返
100 行,213 个页,一次往返。(written 统计的是在一个被其他实验占用的服务器上,此后端为了复用缓冲区而必须写出的脏页;不要让你的查询负责写脏页会解释这一点。)
动手验证 · lab 02-latency
每个查询的数字来自一个两行脚本 lookup.sql(繁忙运行时每个查询 100 µs):
新建一个连接要付出几次往返的成本,之后才会真正运行任何内容,所以请使用连接池(连接并非免费)。事务也会增加往返:begin、每条语句和 commit 都是独立的,除非驱动程序对它们进行流水线处理,因此一个包含五条语句的事务至少需要七次往返。流水线处理会在等待每个结果之前发送多个查询(libpq 从 PostgreSQL 14 起支持它,多个驱动程序也暴露了这个能力),对于频繁交互的负载,它可以在不重构查询的情况下减少延迟。
先估算,再测量
现在,你已经可以不运行查询就估算大多数查询了。三个同可用区往返、访问 50 个缓存页:约 1.5 ms,几乎全是网络成本。网络卷上的 2,000 个未缓存页:2 秒,而且增加 CPU 也没有帮助。在一块 fsync 需要 2 ms 的磁盘上,每行提交一次的批处理任务:每秒 500 行,最多如此。
出现慢操作时,问问哪个项很大:往返次数、页数,还是这些页来自哪里。本书其余内容会逐一缩小它们,从页本身开始。
本章要点
- 查询耗时大致等于往返次数乘以网络延迟,再加上访问页所在位置的每页成本:内存中是几微秒,网络卷上则可能达到数毫秒。
- 先读执行计划的
Buffers:行;页数会重复出现,耗时不会。read表示“没有命中 shared_buffers”,不表示“来自磁盘”。 - 一次提交要等待一次 WAL 刷新,无论事务包含什么内容。把行批量放进事务,并用
pg_test_fsync测量你的 fsync。 - RAM 应按工作集配置,而不是按整个数据库配置。在云卷上,达到的 IOPS 等于在途 I/O 数量除以延迟;要关注突发额度。
- N+1 查询消耗的是往返次数,不是服务器时间。用一次查询获取相关行,并让应用和数据库处在同一个区域、同一个可用区。
延伸阅读
- Resource consumption settings,PGDG。
shared_buffers、work_mem和 I/O 设置(包括io_method)的主要参考资料。 - WAL reliability,PGDG。持久提交要求磁盘做什么,以及写缓存可能如何撒谎。
- pg_test_fsync,PGDG。在选择存储前,测量你自己的 fsync 延迟。
- Amazon EBS volume types,AWS。网络块存储的实际 IOPS、吞吐量和延迟数字;General Purpose SSD page 记录了 gp3 基线和 gp2 突发额度。
- Numbers Every Programmer Should Know By Year,Colin Scott。可以按年份调整的延迟阶梯。