2 先认识这些基本概念
本书会讨论页、执行计划和锁。这些讨论假设你了解一些 SQL 和少数几个 Postgres 术语。如果你曾经对 Postgres 写过 select、insert 和 update,也知道什么是模式,可以扫一眼下面的标题,然后继续往后读;你不会漏掉什么。如果你还不了解,这一章就是你的速成课:后面每一章都至少需要这些知识。
先提醒你接下来会遇到什么:本书其余部分都会假设你掌握这里的内容,并且很快深入到磁盘上的字节,因为“为什么这么慢?”的答案就在那里。本章的每个结论都在实验服务器上运行验证,和本书其他章节一样,所以连基础知识也有证据。
表由共享相同列的行组成
Postgres 把你的数据放在表中。表有命名且带类型的列,每一行为每一列保存一个值,也可以保存 NULL,它表示“没有值”(不是零,也不是空字符串)。下面是本书最大的表 events:
逐行读一遍,你就认识了模式定义中的大多数内容。bigint 是大整数,text 是长度不限的字符串,jsonb 是 JSON 文档,timestamptz 是一个时间点。not null 禁止 NULL,default 则在你没有提供值时填入默认值。id 是主键:没有其他行与它共享的值,Postgres 会替你为它编号,因此可以通过它找到任意一行。每一条 references 定义都是一个外键:account_id 必须指向 accounts 中已经存在的一行。
events 保存两百万行,每一行都有同样的七列。表是形状,行是数据。
动手验证 · lab 01-basics
SELECT 用来提问,而且什么也不改变
用 select 读取数据。写出你需要的列,写明它们来自 from 后面的表,再用只保留目标行的 where 子句;order by 会排序,limit 会提前停止:
再掌握两个词,就能覆盖大多数报表。count(*) 统计行数,group by 按值分别统计:
select 从不改变任何东西。它甚至不会取得事务 ID(XID),也就是 Postgres 为每次变更分配的编号。但这不代表它没有代价。整本书都在讨论:一个 select 为了回答你的问题,必须读取多少页。
动手验证 · lab 01-basics
INSERT 添加一行,在 Postgres 中 UPDATE 也是如此
有三条语句会改变数据。insert 添加行,update 修改行,delete 删除行。下面是在 notes 上执行的例子;这是一张带有 id 和 body 的试验表:
总要为 update 和 delete 写上 where。没有它们,这两条语句会作用于表中的每一行,而 Postgres 不会问你是不是写错了。
这就是让 Postgres 成为 Postgres 的第一个事实。update 不会修改它所在位置的那一行。它会写出一份完整的新行副本;如果页中有空间,新副本就放在同一个页上,并把旧副本标记为已替换。delete 会把行标记为已死亡,但仍然留在原处。两个旧副本都会留在页上,直到后台清理将它们清除。在一张只有一行的表上,一次 update 会让页上留下两份副本;执行 delete 后,表中已经没有这行了,页上却仍然有两份。
这一个事实解释了表为什么会变大、清理为什么存在,以及繁忙的表为什么可能达到数据大小的两倍。本书把它称为更新就是插入,几乎每一章都会回到它。
动手验证 · lab 01-basics
JOIN 把表重新拼在一起
好的模式会让每项事实只存一次:用户的电子邮件地址放在 users 中,账户的计划放在 accounts 中。连接通过匹配不同表中的行,把它们重新组合起来,而且几乎总是通过外键完成:
u 和 a 是表的短名称,on 说明哪些行相匹配:这里指的是 id 等于用户 account_id 的那个账户。用户 295 属于账户 296。普通的 join 只保留两侧都匹配的行;left join 保留左侧的每一行,对于没有匹配项的行则填入 NULL。
动手验证 · lab 01-basics
索引让一次读取变便宜,让每次写入更贵
按电子邮件地址查找一个用户时,如果没有额外帮助,Postgres 必须读取整张 users 表才能找到它:为了找一行,要读取 1,126 个页。(unique (account_id, email) 约束有一个索引,但它先按账户排序,因此通过它查找电子邮件就意味着每个账户都要搜索一次,规划器最终还是直接读取了表。)索引是一种独立的有序结构,指向各行,就像书末的索引。为 email 建一个索引,同样的查找就只读取 4 个页:
索引不是免费的。每次 insert,以及每次修改了索引列的 update,都必须同时更新每个索引。因此,只为查询实际会搜索的列建索引,不要为你拥有的每一列都建索引。B-树挑起大梁会展示索引如何只用几个页找到一行。
动手验证 · lab 01-basics
掌握这些 SQL 就足以读懂本书了。本章其余部分讲的是支撑这些 SQL 的服务器。
一台服务器运行多个数据库,而它们不共享表
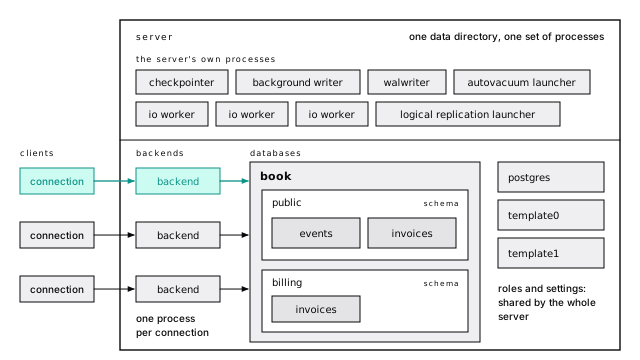
Postgres 服务器由一个数据目录和运行其中的进程组成。文档把它称为一个集簇,这和多台机器没有关系;它就是一台服务器。一个服务器中可以有很多数据库。实验服务器有四个:
一次连接只选择一个数据库,也只能看到那个数据库。试图读取另一个数据库时,Postgres 会拒绝:
这是设计决定,而不是缺少功能:每个数据库都有自己的表、自己的目录和自己的扩展。角色、表空间和服务器配置文件是例外,它们由整个服务器共享。如果应用的两个部分需要连接各自的数据,它们就应该位于同一个数据库的两个模式中。
除非你指定其他模板,否则 create database 会复制 template1;template0 是一份未经修改的备用模板。实验套件也把 book 标记为模板,所以 create database scratch template book 比再次加载数据便宜得多。
动手验证 · lab 01-basics
每个连接都是一个独立进程
应用连接时,服务器会启动一个新的操作系统进程来为它提供服务,这个后端进程会一直存在到连接关闭。十个连接就是十个进程,每个进程都有自己的内存。这个事实解释了连接为什么昂贵、max_connections 为什么是上限而不是容量,也解释了为什么每个生产应用最后都要放在连接池代理之后(连接并非免费)。
服务器自己也会运行进程。在实验服务器上,除了一个客户端进程外,还有:
本书的大部分内容都在讲这些进程做什么:WAL 写入器在后台刷新预写式日志;检查点进程和后台写入器把变更后的页写回各自的文件;自动清理启动器启动清理工作进程;而 I/O 工作进程(PostgreSQL 18+)则代表后端进程执行读取。
动手验证 · lab 01-basics
模式是文件夹,search_path 选择你想要的那个
在数据库内部,表位于模式中:模式是命名的文件夹,只有一层。每个新数据库都有一个名为 public 的模式;如果你从未创建过其他模式,那么你拥有的一切都在这里。public.invoices 和 billing.invoices 是两张不同的表。
当你写下不带模式名的 invoices 时,Postgres 会按顺序检查 search_path 中列出的模式,并使用第一个匹配项。把 billing 放在首位,同一个查询就会读取另一张表。这对组织大型模式很方便。它也可能让某个函数最终调用你没有编写的对象,所以安全章节会要求每个以提升权限运行的函数都固定 search_path。
动手验证 · lab 01-basics
角色既是用户,也是组,或者两者皆是
Postgres 只有一种身份主体,就是角色。带有 LOGIN 属性的角色就是通常所说的用户;没有该属性的角色就是组;任何角色都可以成为另一个角色的成员,并继承它的权限。每张表都有一个所有者角色,它可以对表做任何事情;其他角色只能使用授予自己的权限。
现在就养成一个习惯:应用应当以一个不拥有任何对象、也不是超级用户的角色进行连接,这样应用中的 bug 就不能删除一张表。不要信任任何租户会展示这种设置。
动手验证 · lab 01-basics
每条语句都在事务中运行
Postgres 从不在事务之外运行语句。单独发送一条 update 时,Postgres 会把它包装在一个事务中,并在语句结束时提交;这就是自动提交,除非你执行 begin,否则驱动程序就会这样做。以这种方式发送两条语句,就会得到两个事务,并分别为自己的提交付出代价。
在 begin 和 commit 之间,所有内容要么一起生效,要么一起不生效;在 Postgres 中,“所有内容”还包括模式变更。回滚的 create table 会消失,因此在一个事务中运行、最终失败的迁移不会留下半完成状态(如实看待 ACID)。这也意味着,长事务会一直持有它接触过的所有东西,包括锁,直到事务结束。在本书中,你会一次又一次遇到这种打开的事务。
动手验证 · lab 01-basics
服务器在表中描述自己
Postgres 了解的关于你的模式的一切,都存在于可以查询的普通表中,这些表就是系统目录。pg_class 列出每张表和每个索引,pg_attribute 列出它们的列,pg_roles 列出角色,pg_settings 列出每个设置。pg_stat_ 视图会统计服务器一直在做什么。psql 的反斜杠命令(例如 \d events)其实就是对这些表发起查询。
目录已经替你统计了页数:
这是规划器眼中的 events:35,173 个页和约两百万行,由 vacuum 和 analyze 更新。这个页数正是整本书不断回到的那个数字。
动手验证 · lab 01-basics
一个设置有值、来源和作用域
Postgres 有几百个设置,例如 work_mem,它是一次排序可以使用的内存(默认 4 MB)。每个设置都有一个值、一个来源和一个作用域。配置文件设置服务器默认值。alter database 和 alter role 可以针对某个数据库或某个角色覆盖它。set 修改当前会话的值,set local 则只在一个事务中修改,事务结束后便恢复原值。
你最常用的是最窄的作用域。某个报表需要更多内存来完成一次大型排序时,应当在自己的事务中执行 set local work_mem,而不是为服务器上的每个连接调高它。show work_mem 读取当前值,pg_settings 则告诉你这个值来自哪里(真正重要的配置)。
动手验证 · lab 01-basics
一条命令就能添加扩展
扩展通过 create extension 为一个数据库添加类型、函数、运算符或索引方法。有些扩展随 Postgres 一起提供(即“contrib”模块);另一些则需要先安装到服务器上。实验数据库有本书依赖的五个扩展:pg_stat_statements 用于为查询排名,pageinspect 用于读取页的原始内容,pgstattuple 和 pg_buffercache 用于测量表和缓存,pg_trgm 用于文本搜索。
托管服务只允许使用固定列表,所以在围绕某个扩展设计之前,先检查这个列表(值得了解的扩展)。
动手验证 · lab 01-basics
你的数据是你永远不会碰的文件
归根结底,服务器数据目录中的每张表和每个索引都是一个文件,文件名使用数字,而不是你的表名:
288,137,216 字节就是 35,173 个、每个 8,192 字节的页,和目录给出的数量相同。Postgres 一次读写一个页,本书的其余内容也从这里开始。一切都从页说起会把其中一个页打开给你看。
永远不要手动编辑、复制或删除数据目录中的任何内容,尤其是 pg_wal。只有服务器理解这些文件,而从正在运行的服务器中直接复制出来的内容并不是备份。
动手验证 · lab 01-basics
几条 psql 命令覆盖本书所需
本书的每个示例都在 psql 中运行,它是随 Postgres 提供的命令行客户端。图形化客户端当然也没问题,但有几条反斜杠命令值得背下来:
| 命令 | 作用 |
|---|---|
\d name | 描述一张表:列、索引、约束 |
\dt、\di、\dn、\du | 列出表、索引、模式、角色 |
\x | 以纵向形式打印宽行,每列一行 |
\timing | 打印每条语句的耗时 |
\e | 在编辑器中打开上一条查询 |
想看其余命令,加上 \?。反斜杠命令显示出有用信息时,执行 \set ECHO_HIDDEN on 会打印它背后的目录查询,这是学习系统目录最快的方法。
本章要点
- 表由共享类型化列的行组成。主键可以找到一行;外键指向另一张表中的一行。
select只读取,不改变任何东西。在 Postgres 中,update会写出一份新的行副本,而delete会把旧行留在原处,直到清理将其清除。- 一个索引把一次查找从 1,126 个页降到了 4 个页,而每次写入都要付出让它保持最新的代价。
- 一台服务器容纳多个不能互相查询的数据库;在一个数据库内部,模式是文件夹,
search_path在其中选择目标。角色由整个服务器共享,应用应当以一个不拥有任何对象的角色连接。 - 每个连接都是一个拥有独立内存的进程,这就是连接成本高的原因。
- 每条语句都运行在事务中。模式变更也会回滚,打开的事务会持有它接触过的内容。
- 系统目录是可查询的表,设置有作用域(使用最窄的那个),表则是由 8 KB 页组成、不能手动碰触的文件。
延伸阅读
- The SQL Language,PostgreSQL 文档。手册自带的教程:表、查询、连接和更新,每项都用一页简短介绍。
- Architectural Fundamentals,PostgreSQL 文档。教程中用两页介绍进程模型。
- Schemas,PostgreSQL 文档。模式、
search_path以及手册建议的使用方式。 - Database Roles,PostgreSQL 文档。角色、属性和成员关系。
- System Catalogs,PostgreSQL 文档。每张目录表的每一列,供
\d不够用时查阅。 - psql,PostgreSQL 文档。每条反斜杠命令和每个变量。